Co to jest trafność w psychometrii?
Trafność (ang. validity) to stopień, w jakim dowody empiryczne i teoria uzasadniają określoną interpretację wyników testu w określonym zastosowaniu. Prościej: czy wysoki wynik w skali lęku naprawdę oznacza wysoki lęk – i czy można na tej podstawie podejmować decyzje, do których test ma służyć.
Z tej definicji wynikają dwie rzeczy, o których często się zapomina. Po pierwsze, trafna jest interpretacja wyniku, a nie test sam w sobie. Ta sama skala może trafnie różnicować osoby studiujące pod względem lęku przed egzaminem, a zawodzić jako narzędzie przesiewowe w poradni. Po drugie, trafność to kwestia stopnia i gromadzonych dowodów, a nie jednej liczby czy jednego badania. Zdanie „skala jest trafna” zastąp zdaniem „zebrano dowody trafności X, Y i Z dla takiej interpretacji w takiej populacji”.
Trafność to jedna z pięciu cech testu psychometrycznego, obok standaryzacji, obiektywności, rzetelności i normalizacji. Nie myl jej z trafnością badania: trafność wewnętrzna dotyczy wniosków przyczynowych z eksperymentu, a trafność zewnętrzna – uogólniania wyników na inne osoby i sytuacje.
Od „rodzajów trafności” do źródeł dowodów
W podręcznikach nadal spotkasz podział na rodzaje trafności. Cronbach i Meehl (1955) wyróżnili cztery: predykcyjną, równoczesną, treściową i teoretyczną. Messick (1995) uznał taki podział za fragmentaryczny i zaproponował jednolite pojęcie trafności teoretycznej z sześcioma aspektami: treściowym, substantywnym (procesy odpowiadania), strukturalnym, uogólnialności, zewnętrznym i konsekwencyjnym, czyli dotyczącym społecznych skutków użycia wyników. Dawne „rodzaje” stają się w tym ujęciu źródłami dowodów na rzecz jednej interpretacji.
| Tradycyjna nazwa | Pytanie | Typowe dowody |
|---|---|---|
| Trafność treściowa | Czy pozycje reprezentują całą treść konstruktu? | Definicja konstruktu, oceny sędziów kompetentnych, wywiady poznawcze |
| Trafność czynnikowa (strukturalna) | Czy wewnętrzna struktura wyników zgadza się z teorią? | CFA, EFA, inwariancja pomiaru |
| Trafność zbieżna | Czy wynik koreluje z innymi miarami tego samego konstruktu? | Korelacje z uznanymi narzędziami, macierz MTMM |
| Trafność różnicowa | Czy wynik da się odróżnić od miar innych konstruktów? | Korelacje czynników, HTMT, słabe związki z konstruktami odległymi |
| Trafność kryterialna | Czy wynik przewiduje lub odtwarza zewnętrzne kryterium? | Korelacja lub regresja z kryterium mierzonym później lub równocześnie |
| Trafność teoretyczna | Czy cały wzorzec związków odpowiada teorii? | Sieć nomologiczna, eksperymenty, różnice między grupami |
Inną perspektywę proponują Borsboom i in. (2004): test jest trafny, jeśli mierzona cecha istnieje, a jej zmienność przyczynowo wywołuje zmienność wyników. Według nich walidacja powinna badać przede wszystkim procesy, przez które cecha wpływa na odpowiedzi, a nie tylko korelacje z innymi zmiennymi. Obie perspektywy zgadzają się co do jednego: korelacja z czymkolwiek nie wystarczy, jeśli nie wiadomo, dlaczego powinna wystąpić.
Przykład: argument walidacyjny dla nowej skali
Zespół zbudował 8-pozycyjną Skalę Prokrastynacji Akademickiej (SPA, odpowiedzi 1–5) i zbadał 250 osób studiujących (dane symulowane). Przed zebraniem danych zapisał przewidywania wynikające z teorii. Tak wygląda ich zestawienie z wynikami:
| Źródło dowodu | Przewidywanie | Wynik | Ocena |
|---|---|---|---|
| Struktura wewnętrzna | Jeden czynnik, dobre dopasowanie | CFI = .993, TLI = .990, RMSEA = .048, SRMR = .036; α = .87 | Zgodne |
| Zbieżność | Silna dodatnia korelacja z uznaną skalą prokrastynacji | r = .82, 95% CI [.77, .86] | Zgodne |
| Teoria | Umiarkowana ujemna korelacja z sumiennością | r = −.47, 95% CI [−.56, −.37] | Zgodne |
| Różnicowanie | Związek z aprobatą społeczną bliski zera | r = .14, 95% CI [.02, .26], p = .027 | Słaby, ale niezerowy – do wyjaśnienia |
| Kryterium | Dodatnia korelacja z liczbą spóźnionych prac w semestrze | r = .50, 95% CI [.40, .58] | Zgodne |
Model czynnikowy oszacowano metodą WLSMV, bo odpowiedzi są porządkowe. Większość przewidywań się potwierdziła, ale wiersz z aprobatą społeczną pokazuje, po co zapisuje się je z góry. Korelacja .14 jest mała, jednak przewidywano „bliską zera”. Uczciwy argument walidacyjny odnotowuje tę rozbieżność – np. jako sygnał, że część pozycji skłania do autoprezentacji (zob. aprobata społeczna). Nie ogłasza się sukcesu na podstawie samych istotnych wyników. Korelacja .82 z uznaną skalą jest z kolei na tyle wysoka, że warto zapytać, co nowe narzędzie wnosi ponad istniejące. Clark i Watson (2019) zalecają, by pulę pozycji już na etapie budowy sprawdzać względem bliskich konstruktów, a nie dopiero po fakcie.
Rzetelność ogranicza trafność
Korelacja testu z kryterium nie może być dowolnie wysoka. Losowy błąd pomiaru w obu zmiennych ją obniża, a górną granicę wyznacza wzór:
W przykładzie rzetelność SPA wynosi .87, a rzetelność kryterium (liczby spóźnionych prac w jednym semestrze) przyjęto na .70. Nawet przy idealnym związku konstruktów obserwowana korelacja nie przekroczyłaby więc √(.87 × .70) = .78. Obserwowane r = .50 po korekcie na nierzetelność odpowiada korelacji konstruktów ok. .64.
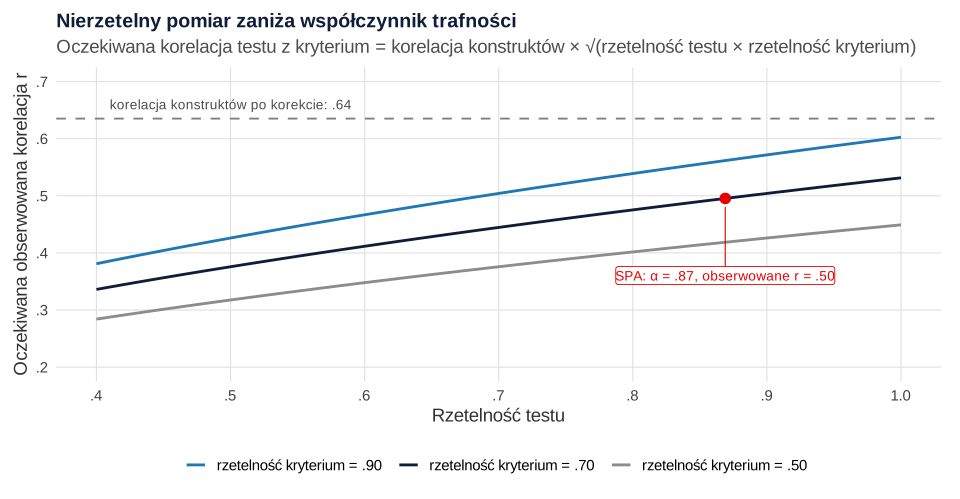
Rysunek prowadzi do dwóch praktycznych wniosków. Słaby współczynnik trafności może wynikać z nierzetelnego kryterium, a nie ze złego testu – dlatego oceny z jednego kolokwium są kiepskim kryterium. Wynik po korekcie opisuje z kolei związek konstruktów, a nie przewidywanie w praktyce. Do decyzji o konkretnych osobach liczy się korelacja obserwowana, bo w praktyce zawsze pracuje się na wynikach obarczonych błędem.
Jak opisać trafność w pracy (APA)
Gdy używasz gotowego narzędzia, w podrozdziale „Narzędzia” wystarczy jedno–dwa zdania o dowodach trafności z literatury, z odwołaniem do badań walidacyjnych. Gdy sam budujesz lub adaptujesz skalę, opisz każde źródło dowodów osobno: przewidywanie, wynik z przedziałem ufności i ocenę. Nie pisz „skala ma wysoką trafność” bez wskazania, o jakie dowody chodzi.
Pełną procedurę – od pisania pozycji po zestawienie dowodów trafności – opisuje wpis Jak zbudować i zwalidować skalę psychometryczną?, a ocenę struktury czynnikowej – Analiza czynnikowa EFA i CFA.
Przykład w R
Kod symuluje dane dla nowej skali i zbiera dowody trafności z dwóch źródeł: struktury wewnętrznej (CFA dla danych porządkowych) i związków z innymi zmiennymi. Na końcu liczy górną granicę współczynnika trafności i korelację skorygowaną na nierzetelność. Liczby w tekście pochodzą z tego kodu.
Argument walidacyjny: CFA, korelacje i korekta na nierzetelność
R
# R160 – trafność: argument walidacyjny dla nowej skali (dane symulowane)
# Skala Prokrastynacji Akademickiej (SPA): 8 pozycji 1–5, N = 250 osób studiujących
suppressPackageStartupMessages({library(lavaan); library(psych)})
set.seed(160)
N <- 250
prok <- rnorm(N)                                   # prawdziwy poziom prokrastynacji
sumienn <- -0.55 * prok + rnorm(N, 0, sqrt(1 - 0.55^2))
aprob <- rnorm(N)                                  # aprobata społeczna – niezwiązana z konstruktem
lad <- c(.72, .68, .75, .60, .70, .65, .58, .74)
pozycje <- sapply(lad, function(l) {
  y <- l * prok + 0.12 * aprob + rnorm(N, 0, sqrt(1 - l^2))
  findInterval(y, c(-1.5, -0.5, 0.5, 1.5)) + 1
})
colnames(pozycje) <- paste0("spa", 1:8)
dane <- as.data.frame(pozycje)
dane$SPA <- rowMeans(pozycje)
dane$znana_skala <- round(3 + 0.75 * (0.85 * prok + rnorm(N, 0, 0.53)), 2)   # uznana miara prokrastynacji
dane$sumiennosc <- round(3.4 + 0.6 * sumienn + rnorm(N, 0, 0.3), 2)
dane$aprobata <- round(10 + 3 * aprob + rnorm(N, 0, 1.2))
dane$spoznione_prace <- rpois(N, exp(0.6 + 0.45 * prok))                  # kryterium: liczba spóźnionych prac w semestrze

# 1. Struktura wewnętrzna: jednoczynnikowa CFA
m <- cfa(paste("Prok =~", paste(colnames(pozycje), collapse = " + ")), data = dane, ordered = colnames(pozycje))
round(fitMeasures(m, c("cfi.scaled", "tli.scaled", "rmsea.scaled", "srmr")), 3)
alfa <- psych::alpha(dane[, 1:8], warnings = FALSE)$total$raw_alpha
round(alfa, 2)

# 2. Związki z innymi zmiennymi (przewidywania zapisane przed analizą)
zw <- sapply(c("znana_skala", "sumiennosc", "aprobata", "spoznione_prace"), function(v) {
  t <- cor.test(dane$SPA, dane[[v]]); c(r = unname(t$estimate), dolna = t$conf.int[1], gorna = t$conf.int[2], p = t$p.value)
})
round(t(zw), 3)

# 3. Rzetelność ogranicza trafność: korelacja z kryterium a jej górna granica
r_xy <- zw["r", "spoznione_prace"]
r_yy <- 0.70                                     # założona rzetelność kryterium
c(granica = sqrt(alfa * r_yy), r_skorygowane = r_xy / sqrt(alfa * r_yy)) |> round(2)
Wynik w R
  cfi.scaled   tli.scaled rmsea.scaled         srmr
       0.993        0.990        0.048        0.036
[1] 0.87
                     r  dolna  gorna     p
znana_skala      0.819  0.773  0.856 0.000
sumiennosc      -0.471 -0.562 -0.368 0.000
aprobata         0.140  0.016  0.259 0.027
spoznione_prace  0.495  0.396  0.584 0.000
      granica r_skorygowane
         0.78          0.64
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; CFA oszacowano w pakiecie lavaan (estymator WLSMV dla zmiennych porządkowych), α w pakiecie psych, a rysunek przygotowano w ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Test jest trafny” bez dopowiedzenia, do czego. Trafność dotyczy konkretnej interpretacji w konkretnej populacji. Skala zwalidowana na dorosłych nie musi działać u nastolatków.
- Rzetelność zamiast trafności. Wysokie α oznacza spójność pozycji, ale nie mówi, co one mierzą. Skala może być bardzo spójna i mierzyć nie to, co trzeba.
- Trafność „fasadowa” jako dowód. To, że pozycje wyglądają sensownie dla laika, nie jest dowodem trafności – najwyżej argumentem za akceptacją narzędzia przez badanych.
- Dobieranie przewidywań po wynikach. Jeśli dopiero po obejrzeniu korelacji decydujesz, które miały być wysokie, a które niskie, argument walidacyjny traci wartość. Zapisz przewidywania wcześniej, np. w prerejestracji.
- Jedna korelacja jako cała walidacja. Związek z jedną skalą to jeden dowód. Pełny obraz wymaga kilku źródeł: treści, struktury, związków zbieżnych i różnicowych oraz kryterium.
- Korekta na nierzetelność bez komentarza. Skorygowany współczynnik zawsze podawaj obok obserwowanego i podaj przyjęte wartości rzetelności.
Najczęstsze pytania
Jakie są rodzaje trafności testu?
Tradycyjnie wyróżnia się trafność treściową, kryterialną (predykcyjną i równoczesną) i teoretyczną, a w praktyce także czynnikową, zbieżną i różnicową. Współczesne ujęcie traktuje je nie jako odrębne „trafności”, lecz jako źródła dowodów na rzecz jednej interpretacji wyniku. Dobra walidacja łączy kilka takich źródeł.
Czym różni się trafność od rzetelności?
Rzetelność mówi, jak dokładny jest pomiar, czyli ile w wyniku jest błędu losowego. Trafność mówi, czy wynik mierzy to, co ma mierzyć, i czy wolno go interpretować w zamierzony sposób. Test może być rzetelny i nietrafny, ale nierzetelny test nie może być trafny, bo błąd pomiaru ogranicza jego związki z innymi zmiennymi.
Czy test może mieć trafność wyższą niż rzetelność?
Obserwowana korelacja testu z kryterium nie może przekroczyć √(rxx × ryy), czyli pierwiastka z iloczynu rzetelności testu i kryterium. Przy rzetelności .87 i .70 górna granica wynosi .78. Współczynnik trafności może więc być wyższy od samej rzetelności testu, ale nie od tej granicy.
Jak napisać o trafności skali w pracy magisterskiej?
Jeśli używasz gotowego narzędzia, podaj jednym–dwoma zdaniami, jakie dowody trafności przedstawili autorzy, i powołaj się na badania walidacyjne. Jeśli budujesz lub adaptujesz skalę, opisz każde źródło dowodów osobno: przewidywanie, wynik z 95% CI i ocenę. Unikaj ogólnika „skala ma wysoką trafność”.
Czy trafność można wyrazić jedną liczbą?
Nie. Pojedyncze współczynniki, np. korelacja z kryterium, opisują tylko jeden dowód trafności dla jednej interpretacji. Ocena trafności to argument złożony z wielu dowodów: treści pozycji, struktury czynnikowej, związków zbieżnych i różnicowych, przewidywania kryterium i skutków stosowania testu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Borsboom, D., Mellenbergh, G. J., & van Heerden, J. (2004). The concept of validity. Psychological Review, 111(4), 1061–1071. https://doi.org/10.1037/0033-295x.111.4.1061
- Clark, L. A., & Watson, D. (2019). Constructing validity: New developments in creating objective measuring instruments. Psychological Assessment, 31(12), 1412–1427. https://doi.org/10.1037/pas0000626 ● Otwarty dostęp
- Cronbach, L. J., & Meehl, P. E. (1955). Construct validity in psychological tests. Psychological Bulletin, 52(4), 281–302. https://doi.org/10.1037/h0040957 ● Otwarty dostęp: pełny tekst
- Messick, S. (1995). Validity of psychological assessment: Validation of inferences from persons’ responses and performances as scientific inquiry into score meaning. American Psychologist, 50(9), 741–749. https://doi.org/10.1037/0003-066x.50.9.741
Cytowania BibTeX
@article{borsboom2004concept, author={Borsboom, Denny and Mellenbergh, Gideon J. and van Heerden, Jaap}, title={{The concept of validity}}, journal={Psychological Review}, year={2004}, volume={111}, number={4}, pages={1061--1071}, doi={10.1037/0033-295x.111.4.1061}}@article{clark2019constructing, author={Clark, Lee Anna and Watson, David}, title={{Constructing validity: New developments in creating objective measuring instruments}}, journal={Psychological Assessment}, year={2019}, volume={31}, number={12}, pages={1412--1427}, doi={10.1037/pas0000626}}@article{cronbach1955construct, author={Cronbach, Lee J. and Meehl, Paul E.}, title={{Construct validity in psychological tests}}, journal={Psychological Bulletin}, year={1955}, volume={52}, number={4}, pages={281--302}, doi={10.1037/h0040957}}@article{messick1995validity, author={Messick, Samuel}, title={{Validity of psychological assessment: Validation of inferences from persons’ responses and performances as scientific inquiry into score meaning}}, journal={American Psychologist}, year={1995}, volume={50}, number={9}, pages={741--749}, doi={10.1037/0003-066x.50.9.741}}