Co to jest trafność kryterialna?
Trafność kryterialna (ang. criterion validity, criterion-related validity) to stopień, w jakim wynik testu pozwala przewidzieć lub odtworzyć wynik w zewnętrznym kryterium – zmiennej, której naprawdę dotyczą decyzje: diagnozie klinicznej, ocenom na studiach, efektywności w pracy, zachowaniu. Jej podstawową miarą jest współczynnik trafności, czyli korelacja wyniku testu z wynikiem w kryterium.
Nazwa pochodzi z klasycznego podziału Cronbacha i Meehla (1955), którzy wyróżnili trafność predykcyjną, równoczesną, treściową i teoretyczną, a dwie pierwsze zaliczyli do procedur opartych na kryterium. Współczesne Standards for Educational and Psychological Testing (American Educational Research Association i in., 2014) traktują trafność jako jedno pojęcie: stopień, w jakim dowody i teoria wspierają interpretację wyników w zamierzonym zastosowaniu. Związek z kryterium jest w nich jednym z rodzajów dowodów opartych na relacjach z innymi zmiennymi – obok dowodów z treści testu, procesu odpowiadania, struktury wewnętrznej i konsekwencji stosowania. Standardy podkreślają, że kryterium musi być miarą operacyjnie odrębną od testu, a podstawowe pytanie brzmi: jak dokładnie wyniki testu przewidują wyniki w kryterium.
W polskich podręcznikach psychometrii trafność równoczesną nazywa się też diagnostyczną, a predykcyjną – prognostyczną. W procesie tworzenia skali ocena trafności należy do ostatniej fazy, razem z oceną wymiarowości i rzetelności (Boateng i in., 2018); cały proces opisuje poradnik jak zbudować i zwalidować skalę psychometryczną.
Trafność równoczesna i predykcyjna
Oba rodzaje różnią się tym, kiedy mierzysz kryterium. W badaniu predykcyjnym kryterium mierzy się później niż test, a w badaniu równoczesnym – mniej więcej w tym samym czasie (American Educational Research Association i in., 2014).
| Cecha | Trafność równoczesna (diagnostyczna) | Trafność predykcyjna (prognostyczna) |
|---|---|---|
| Pomiar kryterium | W tym samym czasie co test | Po tygodniach, miesiącach lub latach |
| Pytanie | Czy test odtwarza obecny stan osoby? | Czy test przewiduje przyszły wynik? |
| Przykład z psychologii | Krótka skala przesiewowa depresji a diagnoza postawiona w ustrukturyzowanym wywiadzie klinicznym | Test zdolności w rekrutacji a średnia ocen po pierwszym roku studiów |
| Typowe zastosowanie | Diagnoza, zastąpienie dłuższej lub droższej procedury | Selekcja, rekrutacja, prognoza ryzyka |
Według Standardów badanie predykcyjne zachowuje odstęp czasu i inne cechy rzeczywistej sytuacji decyzyjnej, dlatego jest właściwe tam, gdzie test ma służyć prognozie (rekrutacja, zatrudnienie). Badanie równoczesne przydaje się zwłaszcza przy testach psychodiagnostycznych i przy poszukiwaniu alternatywy dla uznanej procedury pomiaru. Wysoka korelacja równoczesna nie dowodzi jeszcze, że test dobrze przewiduje przyszłość.
Dobre kryterium: trafne, rzetelne i niezależne od testu
Wiarygodność badania trafności kryterialnej zależy od tego, czy samo kryterium jest istotne dla celu testu, rzetelne i trafnie interpretowane (American Educational Research Association i in., 2014). Słabe kryterium – np. jedna ogólna ocena przełożonego – zaniży współczynnik nawet dla dobrego testu. Gdy kryterium to oceny ekspertów, sprawdź ich zgodność, np. współczynnikiem ICC albo kappą Cohena.
Drugim zagrożeniem jest skażenie kryterium (ang. criterion contamination): ocena w kryterium zależy od wyniku testu. Dzieje się tak, gdy klinicysta zna wynik kwestionariusza przed postawieniem diagnozy, wykładowca zna wynik testu przy wystawianiu oceny albo kryterium zawiera te same pytania co test. Współczynnik trafności jest wtedy sztucznie zawyżony. Dlatego osoby oceniające kryterium nie powinny znać wyników testu, a wynik testu w badaniu walidacyjnym nie powinien wpływać na decyzje wobec osób badanych.
Uważaj też na nazewnictwo. Korelacja nowego kwestionariusza lęku z innym kwestionariuszem lęku to przede wszystkim dowód trafności zbieżnej: obie miary są samoopisem tego samego konstruktu i dzielą błąd metody. O trafności kryterialnej mówimy, gdy kryterium jest tym, co test ma przewidywać lub diagnozować. Słabe związki z miarami innych konstruktów to z kolei dowód trafności różnicowej.
Współczynnik trafności i inne miary
Przy kryterium ilościowym współczynnikiem trafności jest zwykle korelacja Pearsona rxy między testem a kryterium. Jej kwadrat (R²) mówi, jaką część wariancji kryterium wyjaśnia test, a regresja liniowa pozwala przewidzieć wynik konkretnej osoby. Gdy kryterium jest dychotomiczne (diagnoza: jest albo nie ma), stosuje się krzywą ROC z polem pod krzywą (AUC) oraz czułość i swoistość przy wybranym punkcie odcięcia, odczytane z macierzy pomyłek. Jeżeli pytasz, czy nowy test poprawia prognozę ponad to, co już wiadomo, porównaj modele w regresji hierarchicznej i podaj przyrost ΔR² (trafność przyrostowa).
Przykład: test rozumowania a egzamin ze statystyki
W październiku 220 studentów pierwszego roku psychologii rozwiązało nowy test rozumowania ilościowego (30 zadań, M = 16.95, SD = 5.00; dane symulowane). Kryterium stanowił wynik egzaminu ze statystyki w czerwcu (0–100 pkt, M = 61.77, SD = 14.48). Wynik testu nie wpływał na żadne decyzje, a egzaminatorzy go nie znali – to chroni przed skażeniem kryterium.
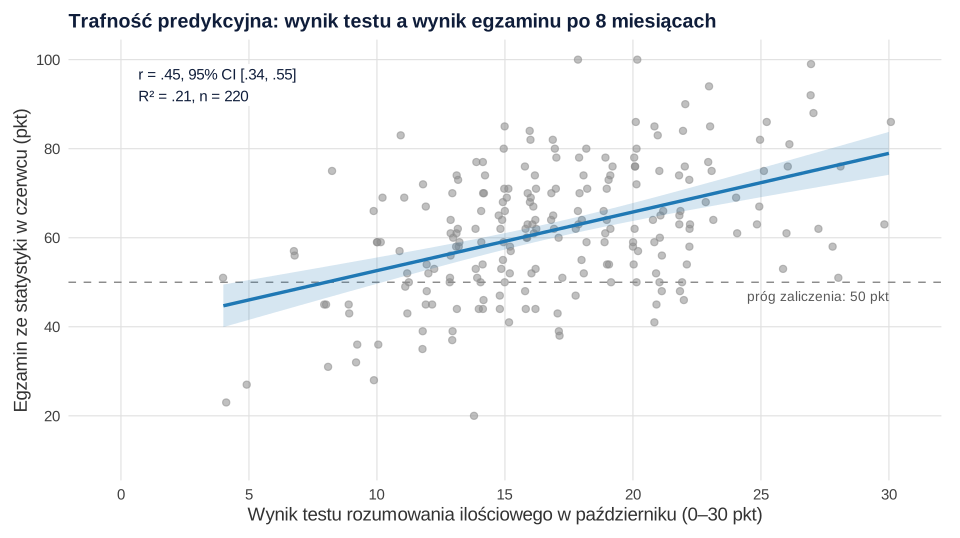
Współczynnik trafności wyniósł r(218) = .45, 95% CI [.34, .55], p < .001. Test wyjaśnia więc około 21% wariancji wyników egzaminu (R² = .21). Równanie regresji ma postać Ŷ = 39.44 + 1.32 × test: student z 12 punktami w teście uzyskuje przeciętnie 55.2 pkt na egzaminie, a student z 22 punktami – 68.4 pkt. Błąd standardowy estymacji wynosi jednak 12.93 pkt (przy SD egzaminu 14.48), więc prognoza dla pojedynczej osoby jest mało precyzyjna, choć dla grup bywa bardzo użyteczna.
Praktyczne znaczenie współczynnika najlepiej pokazuje tabela oczekiwań: odsetek osób, które zdały egzamin (co najmniej 50 pkt), w przedziałach wyniku testu.
| Wynik testu (pkt) | n | Zdany egzamin |
|---|---|---|
| 4–13 | 54 | 61.1% |
| 14–17 | 71 | 81.7% |
| 18–21 | 54 | 92.6% |
| 22–30 | 41 | 95.1% |
Ogółem egzamin zdało 81.8% studentów. W najniższym przedziale testu egzaminu nie zdało 38.9% osób, a w najwyższym – 4.9%. Taki wynik uzasadnia na przykład zaproponowanie dodatkowych zajęć osobom z niskim wynikiem testu.
Co zaniża współczynnik trafności?
Ograniczenie zakresu
Korelacja zależy od zakresu wartości obu zmiennych. Gdy kryterium znasz tylko dla osób wybranych na podstawie testu (przyjętych na studia, zatrudnionych), zakres wyników jest węższy niż w całej grupie kandydatów, a korelacja – niższa (American Educational Research Association i in., 2014). Rysunek 2 pokazuje to na danych z przykładu.
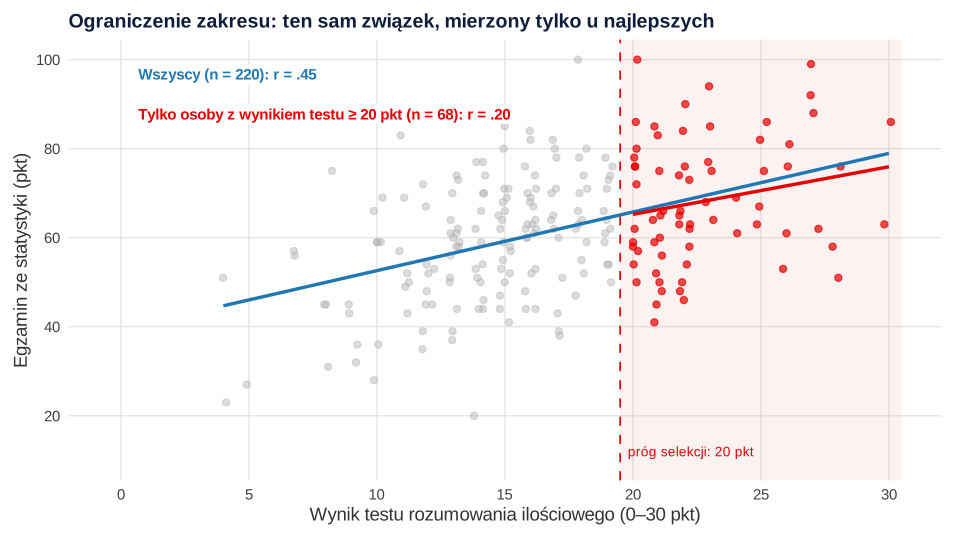
Wśród 68 osób z wynikiem testu co najmniej 20 pkt odchylenie standardowe testu spadło z 5.00 do 2.68, a korelacja – z .45 do .20 (95% CI [−.04, .42], p = .095). Nachylenie linii regresji zmieniło się znacznie mniej (1.07 wobec 1.32 pkt egzaminu na punkt testu): związek jest podobny, ale w wąskim zakresie testu ginie w rozrzucie wyników. Standardy dopuszczają statystyczne korekty na ograniczenie zakresu, ale wymagają podania współczynnika skorygowanego i nieskorygowanego, procedury i wszystkich użytych statystyk. Korekty mogą też przesadzić: Sackett i in. (2022) wykazali, że w metaanalizach trafności metod selekcji korekty na ograniczenie zakresu były często nadmierne, a po ich poprawieniu średnie współczynniki trafności spadają o .10–.20.
Nierzetelność testu i kryterium
Błąd pomiaru w teście i w kryterium osłabia (atenuuje) obserwowaną korelację. W symulacji związek wyników prawdziwych wynosił .50, a zmieniała się tylko rzetelność obu miar:
| Rzetelność testu | Rzetelność kryterium | Obserwowane r (symulacja, N = 100 000) |
|---|---|---|
| 1.00 | 1.00 | .50 |
| .90 | .80 | .43 |
| .80 | .60 | .35 |
| .60 | .40 | .24 |
Obserwowana korelacja jest w przybliżeniu równa korelacji wyników prawdziwych pomnożonej przez √(rxx × ryy). Problem dotyczy nie tylko kwestionariuszy: Hedge i in. (2018) stwierdzili, że rzetelność test–retest siedmiu klasycznych zadań poznawczych, m.in. Stroopa i flankerów, wynosiła od 0 do .82. Dlatego w raporcie podawaj rzetelność obu miar, np. omegę McDonalda dla testu.
Korekta na atenuację odwraca ten wzór:
Przy rzetelności egzaminu .70 korekta tylko na nierzetelność kryterium daje .45/√.70 = .54, a na obie miary (rzetelność testu .85) – .59. Skorygowana wartość opisuje związek wyników prawdziwych, a nie trafność testu w realnym użyciu, gdzie decyzje zapadają na podstawie wyniku obarczonego błędem. Standardy wymagają, by takie oszacowania wyraźnie oznaczać jako skorygowane i podawać obok wartości nieskorygowanej.
Mała próba
Standardy zalecają podawać niepewność współczynnika, najlepiej jako przedział ufności. Przy r = .45 i 50 osobach 95% CI wynosi [.20, .65], a przy 220 osobach – [.34, .55]. Do wykrycia korelacji .30 z mocą 80% (α = .05, test dwustronny) potrzeba około 85 osób, a korelacji .20 – około 194 (zob. dobór liczebności próby).
Jak opisać trafność kryterialną w pracy (APA)
Opisz kryterium i jego rzetelność, odstęp czasu, liczebność, współczynnik z 95% CI oraz to, czy oceniający kryterium znali wynik testu. Wzór dla danych z przykładu:
Jeżeli stosujesz korektę na ograniczenie zakresu lub atenuację, podaj obie wartości, wzór i użyte rzetelności. Wynik możesz też umieścić w tabeli korelacji w stylu APA razem z innymi dowodami trafności. Gdy wyniki testu mają być interpretowane względem populacji, potrzebne są też aktualne normy testowe.
Przykład w R
Kod tworzy dane z przykładu, liczy współczynnik trafności z 95% CI, równanie regresji, błąd standardowy estymacji, tabelę oczekiwań i korelację w grupie o ograniczonym zakresie.
Współczynnik trafności i tabela oczekiwań
R
set.seed(26)
n <- 220
Z <- MASS::mvrnorm(n, mu = c(0, 0), Sigma = matrix(c(1, .45, .45, 1), 2))
dane <- data.frame(test    = pmin(pmax(round(17 + 5 * Z[, 1]), 0), 30),    # październik, 0–30 pkt
                   egzamin = pmin(pmax(round(62 + 15 * Z[, 2]), 0), 100))  # czerwiec, 0–100 pkt
cor.test(dane$test, dane$egzamin)              # współczynnik trafności z 95% CI
model <- lm(egzamin ~ test, data = dane)
round(c(coef(model), R2 = summary(model)$r.squared, blad_estymacji = sigma(model)), 3)
# tabela oczekiwań: odsetek zdanych egzaminów (>= 50 pkt) w przedziałach wyniku testu
dane$przedzial <- cut(dane$test, breaks = c(-Inf, 13, 17, 21, Inf), labels = c("4-13", "14-17", "18-21", "22-30"))
round(100 * tapply(dane$egzamin >= 50, dane$przedzial, mean), 1)
# ograniczenie zakresu: korelacja tylko wśród osób z wynikiem testu >= 20 pkt
wybrani <- subset(dane, test >= 20)
round(c(n = nrow(wybrani), r = cor(wybrani$test, wybrani$egzamin)), 3)
Wynik w R
	Pearson's product-moment correlation

data:  dane$test and dane$egzamin
t = 7.5294, df = 218, p-value = 1.334e-12
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.3426099 0.5533164
sample estimates:
      cor
0.4542938

   (Intercept)           test             R2 blad_estymacji
        39.445          1.317          0.206         12.931
 4-13 14-17 18-21 22-30
 61.1  81.7  92.6  95.1
     n      r
68.000  0.204
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; dane wygenerowano funkcją mvrnorm() z pakietu MASS, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Nazywanie trafnością kryterialną korelacji z innym kwestionariuszem tego samego konstruktu – to przede wszystkim dowód trafności zbieżnej; kryterium ma być tym, co test ma przewidywać lub diagnozować.
- Skażenie kryterium – oceniający znają wynik testu albo kryterium zawiera pytania z testu; współczynnik wychodzi zawyżony.
- Wnioski o prognozie z badania równoczesnego – trafność predykcyjna wymaga pomiaru kryterium później niż testu.
- Pomijanie ograniczenia zakresu – współczynnik policzony tylko wśród przyjętych lub zatrudnionych zaniża trafność; opisz sposób selekcji.
- Podawanie tylko skorygowanych współczynników – korekty na atenuację i zakres raportuj zawsze obok wartości nieskorygowanych (American Educational Research Association i in., 2014).
- „Trafność testu” bez kontekstu – współczynnik dotyczy konkretnego kryterium, populacji i zastosowania; w innej grupie lub przy innym kryterium może być inny.
Najczęstsze pytania
Co to jest trafność kryterialna?
To stopień, w jakim wynik testu pozwala przewidzieć lub odtworzyć wynik w zewnętrznym kryterium – np. diagnozie klinicznej, ocenach na studiach albo efektywności w pracy. Ocenia się ją współczynnikiem trafności, najczęściej korelacją wyniku testu z wynikiem w kryterium, podawaną z 95% przedziałem ufności.
Czym różni się trafność predykcyjna od równoczesnej?
Różnią się momentem pomiaru kryterium. W trafności predykcyjnej (prognostycznej) kryterium mierzy się później niż test, np. średnią ocen po roku studiów. W trafności równoczesnej (diagnostycznej) test i kryterium mierzy się w tym samym czasie, np. wynik skali przesiewowej i diagnozę z wywiadu klinicznego.
Jaki współczynnik trafności kryterialnej jest dobry?
Nie ma jednego progu. Współczynnik zależy od rzetelności testu i kryterium, zakresu wyników w próbie i samego kryterium, dlatego oceniaj go w kontekście zastosowania i z 95% przedziałem ufności. Nawet umiarkowana korelacja, np. r = .45, może wyraźnie różnicować odsetki sukcesów w tabeli oczekiwań, choć prognoza dla pojedynczej osoby pozostaje mało precyzyjna.
Czym różni się trafność kryterialna od trafności zbieżnej?
Trafność zbieżna dotyczy związku z inną miarą tego samego lub bliskiego konstruktu, np. dwóch kwestionariuszy lęku. Trafność kryterialna dotyczy związku z kryterium, które test ma przewidywać lub diagnozować – zachowaniem, diagnozą czy osiągnięciem. Oba rodzaje to dowody oparte na relacjach z innymi zmiennymi.
Ile osób potrzeba do badania trafności kryterialnej?
To zależy od oczekiwanej korelacji i wymaganej precyzji. Do wykrycia r = .30 z mocą 80% (α = .05, test dwustronny) potrzeba około 85 osób, a r = .20 – około 194. Przy 50 osobach 95% przedział ufności dla r = .45 rozciąga się od .20 do .65, więc do precyzyjnego oszacowania zaplanuj większą próbę.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Boateng, G. O., Neilands, T. B., Frongillo, E. A., Melgar-Quiñonez, H. R., & Young, S. L. (2018). Best practices for developing and validating scales for health, social, and behavioral research: A primer. Frontiers in Public Health, 6, Article 149. https://doi.org/10.3389/fpubh.2018.00149 ● Otwarty dostęp
- Cronbach, L. J., & Meehl, P. E. (1955). Construct validity in psychological tests. Psychological Bulletin, 52(4), 281–302. https://doi.org/10.1037/h0040957 ● Otwarty dostęp: pełny tekst
- Hedge, C., Powell, G., & Sumner, P. (2018). The reliability paradox: Why robust cognitive tasks do not produce reliable individual differences. Behavior Research Methods, 50(3), 1166–1186. https://doi.org/10.3758/s13428-017-0935-1 ● Otwarty dostęp
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology, 107(11), 2040–2068. https://doi.org/10.1037/apl0000994
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{boateng2018best, author={Boateng, Godfred O. and Neilands, Torsten B. and Frongillo, Edward A. and Melgar-Quiñonez, Hugo R. and Young, Sera L.}, title={{Best practices for developing and validating scales for health, social, and behavioral research: A primer}}, journal={Frontiers in Public Health}, year={2018}, volume={6}, eid={149}, doi={10.3389/fpubh.2018.00149}}@article{cronbach1955construct, author={Cronbach, Lee J. and Meehl, Paul E.}, title={{Construct validity in psychological tests}}, journal={Psychological Bulletin}, year={1955}, volume={52}, number={4}, pages={281--302}, doi={10.1037/h0040957}}@article{hedge2018reliability, author={Hedge, Craig and Powell, Georgina and Sumner, Petroc}, title={{The reliability paradox: Why robust cognitive tasks do not produce reliable individual differences}}, journal={Behavior Research Methods}, year={2018}, volume={50}, number={3}, pages={1166--1186}, doi={10.3758/s13428-017-0935-1}}@article{sackett2022revisiting, author={Sackett, Paul R. and Zhang, Charlene and Berry, Christopher M. and Lievens, Filip}, title={{Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range}}, journal={Journal of Applied Psychology}, year={2022}, volume={107}, number={11}, pages={2040--2068}, doi={10.1037/apl0000994}}