Co to jest macierz pomyłek?
Macierz pomyłek (tablica pomyłek, macierz błędów) to tabela krzyżowa zestawiająca klasy przewidziane przez model z klasami rzeczywistymi. W klasyfikacji binarnej jedną klasę nazywa się dodatnią (zwykle tę, którą chcemy wykryć: chorobę, rezygnację, oszustwo), a drugą ujemną.
| Rzeczywiście: klasa dodatnia | Rzeczywiście: klasa ujemna | |
|---|---|---|
| Prognoza: klasa dodatnia | TP — prawdziwie dodatnie (trafienie) | FP — fałszywie dodatnie (fałszywy alarm, błąd I rodzaju) |
| Prognoza: klasa ujemna | FN — fałszywie ujemne (przeoczenie, błąd II rodzaju) | TN — prawdziwie ujemne (poprawne odrzucenie) |
Fałszywie dodatnie wyniki odpowiadają błędowi pierwszego rodzaju, a fałszywie ujemne — błędowi drugiego rodzaju. Macierz pomyłek jest punktem wyjścia do oceny każdego klasyfikatora: regresji logistycznej, testu przesiewowego, drzewa decyzyjnego czy sieci neuronowej (Trevethan, 2017).
Miary jakości klasyfikacji
| Miara | Wzór | Pytanie, na które odpowiada |
|---|---|---|
| Trafność (accuracy) | (TP + TN) / N | Jaki odsetek wszystkich przypadków sklasyfikowano poprawnie? |
| Czułość (sensitivity, recall, TPR) | TP / (TP + FN) | Jaki odsetek rzeczywistych przypadków dodatnich wykryto? |
| Swoistość (specificity, TNR) | TN / (TN + FP) | Jaki odsetek rzeczywistych przypadków ujemnych poprawnie odrzucono? |
| Precyzja, PPV | TP / (TP + FP) | Jaki odsetek prognoz „dodatnich” jest trafny? |
| NPV | TN / (TN + FN) | Jaki odsetek prognoz „ujemnych” jest trafny? |
| F1 | 2TP / (2TP + FP + FN) | Średnia harmoniczna precyzji i czułości |
| Zrównoważona trafność | (czułość + swoistość) / 2 | Trafność odporna na nierówne klasy |
| MCC (Matthewsa) | (TP·TN − FP·FN) / √[(TP+FP)(TP+FN)(TN+FP)(TN+FN)] | Korelacja prognoz z rzeczywistością (od −1 do 1) |
| Kappa Cohena | (trafność − zgodność losowa) / (1 − zgodność losowa) | O ile model jest lepszy od zgadywania z częstościami klas? |
Czułość i swoistość opisują sam klasyfikator i nie zależą od tego, jak często występuje klasa dodatnia. PPV i NPV zależą od tej częstości (prewalencji): ten sam test ma niższą precyzję w populacji, w której zjawisko jest rzadkie (Trevethan, 2017). Przy niezrównoważonych klasach trafność i F1 bywają zbyt optymistyczne, dlatego Chicco i Jurman (2020) zalecają współczynnik korelacji Matthewsa (MCC), który jest wysoki tylko wtedy, gdy dobrze wypadają wszystkie cztery komórki macierzy.
Przykład: macierz pomyłek dla regresji logistycznej
Uczelnia chce przewidzieć, którzy studenci zrezygnują ze studiów po pierwszym roku. W przykładowych danych (N = 600) rezygnację zgłosiło 17,8% osób. Predyktorami są frekwencja na zajęciach (%), średnia ocen i motywacja (10–50 punktów). Dane podzielono losowo na zbiór uczący (n = 400) i testowy (n = 200), bo ocena modelu na tych samych danych, na których go oszacowano, zawyża jego jakość.
Wszystkie predyktory obniżały szanse rezygnacji: każdy punkt procentowy frekwencji zmniejszał szanse o 6,7% (OR = 0,933), każdy punkt średniej — o 78,6% (OR = 0,214), a każdy punkt motywacji — o 10,3% (OR = 0,897); wszystkie p < 0,001. Model przewiduje jednak prawdopodobieństwa, a nie decyzje — macierz pomyłek powstaje dopiero po wybraniu progu.
Próg 0,5: wysoka trafność, mała użyteczność
| Prognoza / rzeczywistość | Rezygnacja | Kontynuacja | Razem |
|---|---|---|---|
| Rezygnacja | TP = 9 | FP = 5 | 14 |
| Kontynuacja | FN = 29 | TN = 157 | 186 |
| Razem | 38 | 162 | 200 |
- Trafność = (9 + 157) / 200 = 0,830, 95% CI [0,772; 0,876]. Brzmi dobrze, ale model, który każdemu przewidziałby „kontynuację”, miałby trafność 0,810.
- Czułość = 9 / 38 = 0,237, 95% CI [0,130; 0,392] — model wykrył tylko co czwartą osobę, która faktycznie zrezygnowała.
- Swoistość = 157 / 162 = 0,969, 95% CI [0,930; 0,987] — prawie wszyscy kontynuujący zostali poprawnie rozpoznani.
- PPV = 0,643, NPV = 0,844, F1 = 0,346, MCC = 0,317, kappa = 0,272.
Przy rzadkiej klasie dodatniej (19% w zbiorze testowym) przewidywane prawdopodobieństwa rzadko przekraczają 0,5, więc model „ostrożnie” prognozuje rezygnację. Jeśli uczelnia chce dotrzeć z pomocą do zagrożonych studentów, taki model przeocza 29 z 38 osób.
Próg równy odsetkowi rezygnacji
Prostą alternatywą jest próg równy częstości klasy dodatniej w zbiorze uczącym (0,172). Ten sam model, te same prawdopodobieństwa — tylko inna granica decyzji:
| Miara | Próg 0,50 | Próg 0,172 |
|---|---|---|
| TP / FP / FN / TN | 9 / 5 / 29 / 157 | 26 / 40 / 12 / 122 |
| Trafność | 0,830 | 0,740 |
| Czułość | 0,237 | 0,684 |
| Swoistość | 0,969 | 0,753 |
| PPV (precyzja) | 0,643 | 0,394 |
| NPV | 0,844 | 0,910 |
| F1 | 0,346 | 0,500 |
| Zrównoważona trafność | 0,603 | 0,719 |
| MCC | 0,317 | 0,365 |
| Kappa Cohena | 0,272 | 0,341 |
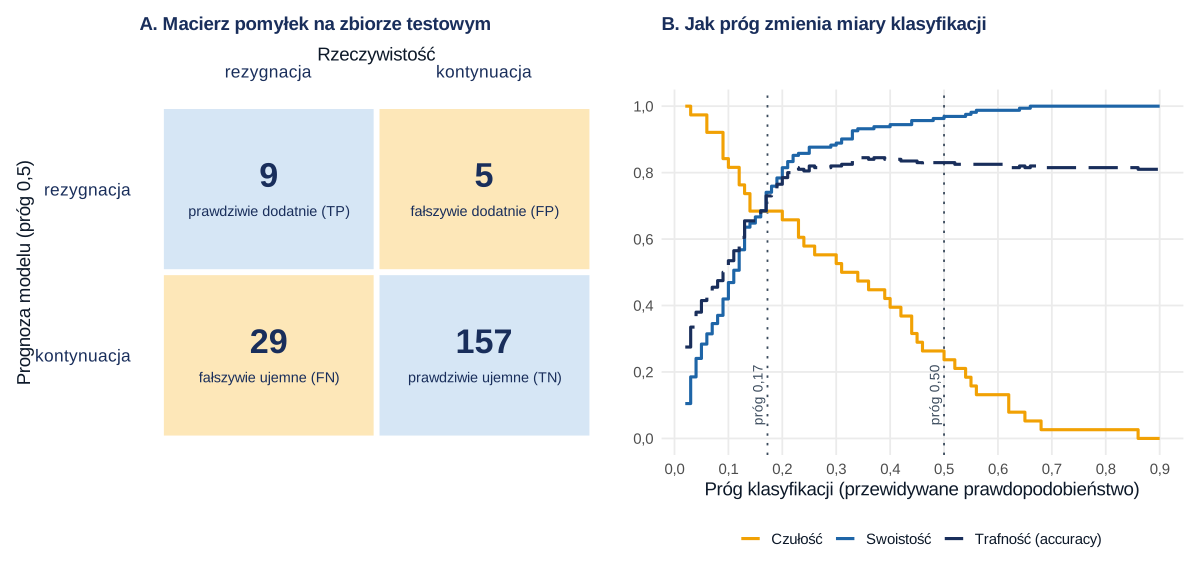
Obniżenie progu podniosło czułość z 0,24 do 0,68 kosztem swoistości (z 0,97 do 0,75). Trafność spadła z 0,83 do 0,74, ale zrównoważona trafność, F1 i MCC wzrosły — model stał się bardziej użyteczny do wykrywania zagrożonych osób. Który próg jest lepszy, zależy od kosztów: ile kosztuje rozmowa z osobą, która i tak by została (FP), a ile utrata studenta (FN).
Zdolność modelu do rozróżniania klas niezależnie od progu opisuje krzywa ROC i pole pod nią: AUC = 0,778, 95% CI [0,691; 0,865]. Przy silnie niezrównoważonych klasach bardziej informatywny bywa wykres precyzji i czułości (Saito i Rehmsmeier, 2015). Pełna ocena modelu predykcyjnego obejmuje też kalibrację, czyli zgodność przewidywanych prawdopodobieństw z rzeczywistymi częstościami (Steyerberg i in., 2010; Van Calster i in., 2019).
Kalkulator macierzy pomyłek
Wpisz cztery liczby z macierzy pomyłek
Wpisz liczby i kliknij „Policz miary”. Kalkulator wymaga włączonej obsługi JavaScriptu.
Kalkulator liczy trafność, czułość, swoistość, PPV i NPV z 95% przedziałami ufności Wilsona (jak prop.test(x, n, correct = FALSE) w R), a także F1, zrównoważoną trafność, MCC i kappę Cohena (McHugh, 2012). Domyślne liczby pochodzą z przykładu; wyniki są zgodne z R.
Przykład w R
Pierwszy fragment generuje przykładowe dane, dzieli je na zbiór uczący i testowy, szacuje regresję logistyczną i tworzy macierz pomyłek. Drugi liczy miary klasyfikacji dla dwóch progów.
Regresja logistyczna i macierz pomyłek
R
# Czy student zrezygnuje ze studiów po 1. roku? Przykładowe dane, N = 600
set.seed(2027)
n <- 600
frekwencja <- round(pmin(100, rnorm(n, 78, 12)))          # % obecności na zajęciach
srednia    <- round(pmin(5, pmax(2, rnorm(n, 3.8, 0.5))), 2)
motywacja  <- round(rnorm(n, 30, 6))                     # wynik w skali 10–50
logit <- 9.5 - 0.06 * frekwencja - 1.1 * srednia - 0.08 * motywacja
rezygnacja <- rbinom(n, 1, plogis(logit))
dane <- data.frame(rezygnacja, frekwencja, srednia, motywacja)
# Podział: 400 osób do budowy modelu, 200 do sprawdzenia
uczacy <- sample(n, 400)
model <- glm(rezygnacja ~ frekwencja + srednia + motywacja, family = binomial, data = dane[uczacy, ])
summary(model)
test <- dane[-uczacy, ]
p_hat <- predict(model, newdata = test, type = "response")   # przewidywane prawdopodobieństwo rezygnacji
prognoza <- ifelse(p_hat >= 0.5, 1, 0)                       # próg klasyfikacji 0,5
macierz <- table(Prognoza = factor(prognoza, levels = c(1, 0), labels = c("rezygnacja", "kontynuacja")),
                 Rzeczywistość = factor(test$rezygnacja, levels = c(1, 0), labels = c("rezygnacja", "kontynuacja")))
macierz
Wynik w R
Call:
glm(formula = rezygnacja ~ frekwencja + srednia + motywacja,
    family = binomial, data = dane[uczacy, ])

Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept) 12.48927    1.87648   6.656 2.82e-11 ***
frekwencja  -0.06956    0.01379  -5.042 4.60e-07 ***
srednia     -1.53962    0.30823  -4.995 5.88e-07 ***
motywacja   -0.10866    0.02583  -4.206 2.60e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 367.86  on 399  degrees of freedom
Residual deviance: 294.73  on 396  degrees of freedom
AIC: 302.73

Number of Fisher Scoring iterations: 5

             Rzeczywistość
Prognoza      rezygnacja kontynuacja
  rezygnacja           9           5
  kontynuacja         29         157
Miary klasyfikacji dla dwóch progów
R
miary <- function(TP, FN, FP, TN) {
  N <- TP + FN + FP + TN
  dokl <- (TP + TN) / N
  oczek <- ((TP + FP) * (TP + FN) + (FN + TN) * (FP + TN)) / N^2    # zgodność przypadkowa do kappy
  c(trafnosc = dokl, czulosc = TP / (TP + FN), swoistosc = TN / (TN + FP),
    PPV = TP / (TP + FP), NPV = TN / (TN + FN),
    F1 = 2 * TP / (2 * TP + FP + FN),
    MCC = (TP * TN - FP * FN) / sqrt((TP + FP) * (TP + FN) * (TN + FP) * (TN + FN)),
    kappa = (dokl - oczek) / (1 - oczek),
    zrownowazona_trafnosc = (TP / (TP + FN) + TN / (TN + FP)) / 2)
}
TP <- macierz[1, 1]; FP <- macierz[1, 2]; FN <- macierz[2, 1]; TN <- macierz[2, 2]
round(miary(TP, FN, FP, TN), 3)
# Ten sam model z progiem równym odsetkowi rezygnacji w zbiorze uczącym
prog <- mean(dane$rezygnacja[uczacy])
prognoza2 <- ifelse(p_hat >= prog, 1, 0)
m2 <- table(factor(prognoza2, levels = c(1, 0)), factor(test$rezygnacja, levels = c(1, 0)))
m2
round(miary(m2[1, 1], m2[2, 1], m2[1, 2], m2[2, 2]), 3)
Wynik w R
             trafnosc               czulosc             swoistosc
                0.830                 0.237                 0.969
                  PPV                   NPV                    F1
                0.643                 0.844                 0.346
                  MCC                 kappa zrownowazona_trafnosc
                0.317                 0.272                 0.603

[1] 0.1725

      1   0
  1  26  40
  0  12 122
             trafnosc               czulosc             swoistosc
                0.740                 0.684                 0.753
                  PPV                   NPV                    F1
                0.394                 0.910                 0.500
                  MCC                 kappa zrownowazona_trafnosc
                0.365                 0.341                 0.719
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Jak opisać macierz pomyłek w pracy
Więcej o samym modelu, założeniach i interpretacji ilorazów szans znajdziesz w poradniku regresja logistyczna — założenia i interpretacja (zob. też Sperandei, 2014).
Najczęstsze błędy
- Ocena modelu na danych uczących. Macierz pomyłek z tych samych danych, na których szacowano model, jest zbyt optymistyczna. Używaj zbioru testowego lub walidacji krzyżowej.
- Raportowanie samej trafności przy niezrównoważonych klasach — zawsze podaj trafność „najliczniejszej klasy” jako punkt odniesienia oraz czułość i swoistość.
- Bezrefleksyjny próg 0,5 bez uzasadnienia kosztami błędów.
- Wybór progu na zbiorze testowym — wtedy testowe wyniki przestają być niezależną oceną.
- Pomylenie czułości z precyzją albo nieopisanie, która klasa jest „dodatnia”.
- Brak przedziałów ufności — przy małej liczbie przypadków dodatnich czułość jest bardzo niepewna (w przykładzie od 0,13 do 0,39).
Najczęstsze pytania
Co to jest macierz pomyłek?
Macierz pomyłek (ang. confusion matrix, tablica pomyłek) to tabela, która zestawia prognozy modelu klasyfikacyjnego z rzeczywistymi klasami. W klasyfikacji binarnej ma cztery komórki: prawdziwie dodatnie (TP), fałszywie dodatnie (FP), fałszywie ujemne (FN) i prawdziwie ujemne (TN). Z tych liczb oblicza się trafność, czułość, swoistość, precyzję, F1 i inne miary.
Jak zrobić macierz pomyłek dla regresji logistycznej?
Model zwraca przewidywane prawdopodobieństwa. Wybierasz próg (np. 0,5), zamieniasz prawdopodobieństwa na prognozy 0/1 i zestawiasz je z rzeczywistymi wartościami w tabeli krzyżowej — w R wystarczy table(prognoza, rzeczywistosc). Najlepiej robić to na danych, których nie użyto do oszacowania modelu.
Dlaczego wysoka trafność może być myląca?
Bo przy niezrównoważonych klasach model, który zawsze przewiduje klasę liczniejszą, ma wysoką trafność, choć niczego nie wykrywa. W przykładzie trafność 0,83 była tylko nieznacznie wyższa od 0,81, jaką dałoby przewidywanie „wszyscy kontynuują”. Dlatego podaje się też czułość, swoistość, zrównoważoną trafność lub MCC.
Jaki próg klasyfikacji wybrać?
Próg 0,5 jest domyślny, ale rzadko optymalny. Wybór zależy od kosztów błędów: jeśli przeoczenie przypadku jest kosztowne (np. w badaniu przesiewowym), obniża się próg, by zwiększyć czułość kosztem swoistości. Próg wybiera się na danych uczących lub walidacyjnych, nie na zbiorze testowym.
Czym różni się czułość od precyzji?
Czułość to odsetek rzeczywistych przypadków dodatnich, które model wykrył (TP / (TP + FN)). Precyzja to odsetek prognoz dodatnich, które okazały się trafne (TP / (TP + FP)). Model może mieć wysoką czułość i niską precyzję, gdy „wykrywa” wiele przypadków, ale z dużą liczbą fałszywych alarmów.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja logistyczna: założenia, interpretacja i raportowanie modelu
Regresja logistyczna w praktyce: założenia, iloraz szans, diagnostyka, kalibracja, AUC oraz zasady rzetelnego raportowania modelu.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikPo co statystyka jest potrzebna lekarzowi?
Od trafności testu diagnostycznego po bezwzględną korzyść z leczenia — statystyka jest językiem ryzyka i niepewności decyzji klinicznych.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Trevethan, R. (2017). Sensitivity, specificity, and predictive values: Foundations, pliabilities, and pitfalls in research and practice. Frontiers in Public Health, 5, Article 307. https://doi.org/10.3389/fpubh.2017.00307 ● Otwarty dostęp
- Chicco, D., & Jurman, G. (2020). The advantages of the Matthews correlation coefficient (MCC) over F1 score and accuracy in binary classification evaluation. BMC Genomics, 21, Article 6. https://doi.org/10.1186/s12864-019-6413-7 ● Otwarty dostęp
- Saito, T., & Rehmsmeier, M. (2015). The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets. PLOS ONE, 10(3), Article e0118432. https://doi.org/10.1371/journal.pone.0118432 ● Otwarty dostęp
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/EDE.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
- Van Calster, B., McLernon, D. J., van Smeden, M., Wynants, L., Steyerberg, E. W., & Topic Group 'Evaluating diagnostic tests and prediction models' of the STRATOS initiative. (2019). Calibration: The Achilles heel of predictive analytics. BMC Medicine, 17, Article 230. https://doi.org/10.1186/s12916-019-1466-7 ● Otwarty dostęp
- Sperandei, S. (2014). Understanding logistic regression analysis. Biochemia Medica, 24(1), 12–18. https://doi.org/10.11613/BM.2014.003 ● Otwarty dostęp
- McHugh, M. L. (2012). Interrater reliability: The kappa statistic. Biochemia Medica, 22(3), 276–282. https://doi.org/10.11613/BM.2012.031 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{trevethan2017sensitivity, author={Trevethan, Robert}, title={Sensitivity, specificity, and predictive values: Foundations, pliabilities, and pitfalls in research and practice}, journal={Frontiers in Public Health}, year={2017}, volume={5}, eid={307}, doi={10.3389/fpubh.2017.00307}}@article{chicco2020the, author={Chicco, Davide and Jurman, Giuseppe}, title={The advantages of the Matthews correlation coefficient (MCC) over F1 score and accuracy in binary classification evaluation}, journal={BMC Genomics}, year={2020}, volume={21}, eid={6}, doi={10.1186/s12864-019-6413-7}}@article{saito2015the, author={Saito, Takaya and Rehmsmeier, Marc}, title={The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets}, journal={PLOS ONE}, year={2015}, volume={10}, number={3}, eid={e0118432}, doi={10.1371/journal.pone.0118432}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={Assessing the performance of prediction models: A framework for traditional and novel measures}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/EDE.0b013e3181c30fb2}}@article{vancalster2019calibration, author={Van Calster, Ben and McLernon, David J. and van Smeden, Maarten and Wynants, Laure and Steyerberg, Ewout W. and {Topic Group Evaluating diagnostic tests and prediction models of the STRATOS initiative}}, title={Calibration: The Achilles heel of predictive analytics}, journal={BMC Medicine}, year={2019}, volume={17}, eid={230}, doi={10.1186/s12916-019-1466-7}}@article{sperandei2014understanding, author={Sperandei, Sandro}, title={Understanding logistic regression analysis}, journal={Biochemia Medica}, year={2014}, volume={24}, number={1}, pages={12--18}, doi={10.11613/BM.2014.003}}@article{mchugh2012interrater, author={McHugh, Mary L.}, title={Interrater reliability: The kappa statistic}, journal={Biochemia Medica}, year={2012}, volume={22}, number={3}, pages={276--282}, doi={10.11613/BM.2012.031}}