Co to jest moc testu?
Moc testu (ang. statistical power) to prawdopodobieństwo, że test odrzuci hipotezę zerową, gdy w populacji naprawdę istnieje efekt o określonej wielkości. Jest dopełnieniem prawdopodobieństwa błędu II rodzaju (β), czyli przeoczenia prawdziwego efektu:
Moc nie jest więc jedną liczbą przypisaną badaniu – zawsze dotyczy konkretnej wielkości efektu, liczebności próby, poziomu istotności α i testu. Najprościej rozumieć ją jako odsetek powtórzeń badania, w których wartość p byłaby mniejsza niż α, gdyby efekt istniał. Konwencjonalnym celem jest moc .80: na taką wartość Cohen (1992) przygotował tabele potrzebnych liczebności dla ośmiu standardowych testów, m.in. różnicy średnich, korelacji, χ² i jednoczynnikowej ANOVA.
Od czego zależy moc?
- Wielkość efektu – większy efekt łatwiej wykryć. Planując badanie, korzysta się zwykle z miar standaryzowanych, np. d Cohena (zob. wielkość efektu i interpretacja d Cohena).
- Liczebność próby – moc rośnie wraz z n, ale coraz wolniej (rysunek 1).
- Poziom istotności – niższe α to niższa moc: przy 64 osobach w grupie i d = 0.5 moc spada z .80 przy α = .05 do .49 przy α = .005.
- Kierunek testu – test jednostronny ma większą moc (w tym samym przykładzie .88 zamiast .80), ale tylko jeśli kierunek ustalono przed badaniem.
- Szum w danych i schemat badania – rzetelne narzędzia, plan wewnątrzobiektowy albo kontrola zmiennych towarzyszących (ANCOVA) zmniejszają wariancję błędu. Sommet i in. (2023) wymieniają takie sposoby zwiększania mocy bez powiększania próby (np. plan mieszany, prerejestrowane testy jednostronne) i pokazują, że mediana mocy wykrycia interakcji typowej wielkości w 159 badaniach wynosiła zaledwie .18.
Krzywe mocy: ile osób potrzeba?
Rysunek 1 pokazuje moc testu t dla dwóch niezależnych grup przy trzech konwencjonalnych wielkościach efektu Cohena (1992): małym (d = 0.2), średnim (0.5) i dużym (0.8).
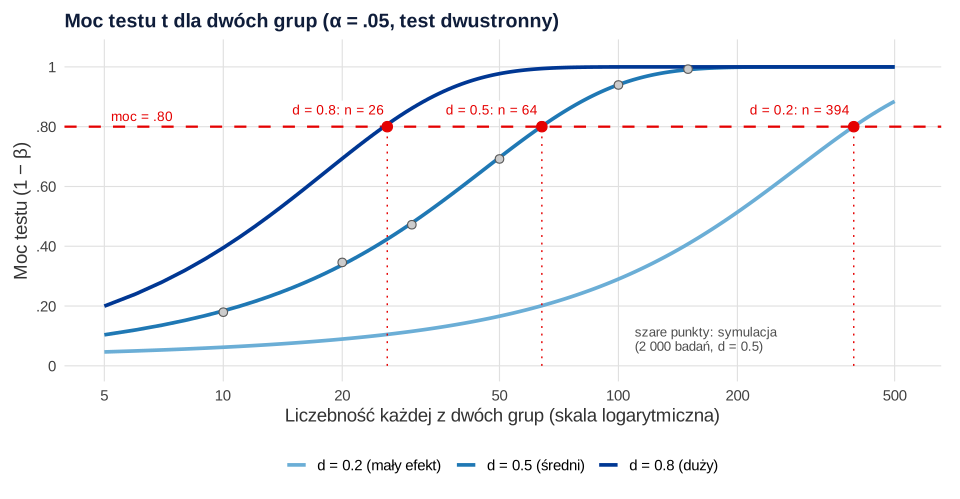
power.t.test() (dane symulowane).Aby z mocą .80 wykryć efekt duży, wystarczy 26 osób w grupie; średni wymaga 64 osób, a mały – aż 394 osób w każdej grupie. Przy mocy .90 te liczby rosną do 34, 86 i 527. Szare punkty z symulacji leżą na teoretycznej krzywej: przy 64 osobach w grupie p < .05 dało 80.2% z 2 000 symulowanych badań, przy 20 osobach – 34.6%.
Jaki efekt przyjąć? Brysbaert (2019) proponuje d = 0.4 jako rozsądne pierwsze oszacowanie najmniejszego interesującego efektu w psychologii. Z jego tabel wynika, że do porównania dwóch warunków wewnątrzobiektowych z mocą 80% potrzeba ponad 50 osób, a przy zmiennej międzygrupowej lub interakcji – 100, 200 i więcej.
Przykład: planowanie badania z treningiem uważności
Planujesz porównać poziom stresu po czterotygodniowym treningu uważności z grupą kontrolną. Zakładasz efekt średni (d = 0.5), α = .05 i test dwustronny. Analiza mocy a priori daje 63.77, czyli po zaokrągleniu w górę 64 osoby w każdej grupie (N = 128). To samo policzysz w darmowym programie G*Power, który obsługuje analizy mocy dla testów z rodzin t, F i χ² (Faul i in., 2007).
Co, jeśli uda się zrekrutować tylko 40 osób (20 w grupie)? Moc wykrycia efektu d = 0.5 wynosi wtedy .34 – dwie na trzy szanse, że prawdziwy efekt przejdzie niezauważony. Analiza wrażliwości pokazuje, że przy 20 osobach w grupie moc .80 masz tylko dla efektów d ≥ 0.91. Więcej o uzasadnianiu liczebności przeczytasz w poradniku Dobór liczebności próby: moc, precyzja i uzasadnienie badania.
Skutki niskiej mocy
Button i in. (2013) pokazują, że niska moc zmniejsza nie tylko szansę wykrycia prawdziwego efektu, ale też prawdopodobieństwo, że wynik istotny odzwierciedla prawdziwy efekt, a do tego prowadzi do zawyżonych oszacowań wielkości efektu i niskiej replikowalności. Nasza symulacja (10 000 badań na wariant, prawdziwy efekt d = 0.5) pokazuje mechanizm zawyżania:
| Osób w grupie | Wyniki istotne | Średnie d – wszystkie badania | Średnie d – tylko istotne |
|---|---|---|---|
| 20 (moc .34) | 33.4% | 0.51 | 0.87 |
| 64 (moc .80) | 80.7% | 0.50 | 0.56 |
W małych badaniach istotne wychodzą tylko te, w których efekt z próby przypadkowo okazał się duży – średnio d = 0.87 zamiast 0.50. Jeśli publikuje się głównie wyniki istotne, literatura przecenia efekty, a kolejne badania planowane na tej podstawie mają za małą moc. To jeden z mechanizmów kryzysu replikacyjnego. Spada też wiarygodność wyników istotnych: gdyby prawdziwa była co czwarta testowana hipoteza, przy mocy .80 prawdziwym efektom odpowiadałoby 84% wyników istotnych, a przy mocy .34 – 69%.
Moc „po fakcie” i wynik nieistotny
Częsty błąd to liczenie mocy po badaniu z efektu zaobserwowanego w próbie (tzw. moc obserwowana). Taka moc jest prostą funkcją wartości p: w badaniu z 30 osobami w grupie wynik p = .05 odpowiada efektowi d = 0.52, a moc „obliczona” z tego efektu wynosi .50 – niezależnie od tego, jaki efekt istnieje naprawdę. Jarmakowska-Kostrzanowska (2021) zwraca uwagę, że moc i istotność pochodzą z dwóch różnych szkół statystyki połączonych w paradygmat NHST, co utrudnia interpretację wyniku nieistotnego przy dużej mocy i istotnego przy małej mocy: moc nie uprawdopodabnia wyniku istotnego ani nie obala hipotezy zerowej przy wyniku nieistotnym. Po badaniu zamiast mocy obserwowanej podaj przedział ufności dla efektu albo analizę wrażliwości (jaki efekt badanie mogło wykryć).
Jak opisać analizę mocy w pracy (APA)
Analizę mocy opisz w podrozdziale o osobach badanych lub o planie badania: podaj zakładaną wielkość efektu i jej źródło, α, moc, rodzaj testu i program.
Przykład w R
Kod liczy liczebność potrzebną do mocy .80 (pakiet stats, bez instalowania dodatkowych pakietów), moc badania z 20 osobami w grupie, najmniejszy wykrywalny efekt i sprawdza wyniki symulacją z rysunku 1.
Analiza mocy a priori i symulacja mocy
R
# Analiza mocy a priori: test t dla dwóch grup, α = .05, test dwustronny
power.t.test(delta = 0.5, sd = 1, sig.level = .05, power = .80)
sapply(c(0.2, 0.5, 0.8), function(d) ceiling(power.t.test(delta = d, power = .80)$n))

# Moc badania z 20 osobami w grupie i najmniejszy efekt wykrywalny z mocą .80
power.t.test(n = 20, delta = 0.5)$power
power.t.test(n = 20, power = .80)$delta

# Symulacja: odsetek wyników p < .05 przy d = 0.5 (2 000 badań dla każdego n)
set.seed(2026)
n_sym <- c(10, 20, 30, 50, 64, 100, 150)
moc_sym <- sapply(n_sym, function(n)
  mean(replicate(2000, t.test(rnorm(n), rnorm(n, mean = 0.5), var.equal = TRUE)$p.value < .05)))
setNames(moc_sym, n_sym)
Wynik w R
     Two-sample t test power calculation

              n = 63.76576
          delta = 0.5
             sd = 1
      sig.level = 0.05
          power = 0.8
    alternative = two.sided

NOTE: n is number in *each* group

[1] 394  64  26
[1] 0.3377084
[1] 0.9091306
    10     20     30     50     64    100    150
0.1795 0.3460 0.4720 0.6920 0.8025 0.9395 0.9925
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Wielkość efektu z jednego małego badania lub pilotażu – takie efekty bywają zawyżone (zob. tabelę wyżej), więc badanie zaplanowane na ich podstawie ma za małą moc. Pilotaż służy raczej do sprawdzenia procedury (zob. badanie pilotażowe).
- „Średni efekt” bez uzasadnienia – konwencje Cohena to punkt wyjścia, a nie argument. Napisz, skąd bierzesz zakładany efekt.
- Analiza mocy dla prostego testu, a w pracy – interakcja – wykrycie interakcji wymaga zwykle wielokrotnie większej próby niż efektu głównego.
- Pominięcie braków danych – jeśli spodziewasz się, że 15% osób nie dokończy badania, zrekrutuj odpowiednio więcej.
- „Wynik nieistotny, więc efektu nie ma” – przy niskiej mocy brak istotności niewiele mówi (zob. dlaczego nie „przyjmujemy” H0).
Najczęstsze pytania
Co to jest moc testu?
Moc testu to prawdopodobieństwo, że test wykaże istotny wynik, jeśli w populacji naprawdę istnieje efekt o założonej wielkości. Oblicza się ją jako 1 − β, gdzie β to prawdopodobieństwo błędu II rodzaju, czyli przeoczenia efektu. Najczęściej dąży się do mocy co najmniej .80.
Od czego zależy moc testu?
Od wielkości efektu, liczebności próby, poziomu istotności α, kierunku testu (jednostronny ma większą moc) oraz ilości szumu w danych – rzetelności pomiaru i schematu badania. Większy efekt, większa próba, wyższe α i mniej szumu dają wyższą moc.
Ile osób potrzeba do badania z mocą 80%?
Dla testu t z dwiema grupami przy α = .05 (test dwustronny): 26 osób w grupie dla efektu dużego (d = 0.8), 64 dla średniego (d = 0.5) i 394 dla małego (d = 0.2). Dla innych testów policz to w R lub w G*Power – zob. analiza mocy a priori.
Jak obliczyć moc testu w R?
W pakiecie stats użyj funkcji power.t.test(): power.t.test(delta = 0.5, power = .80) zwraca liczebność w każdej grupie (63.77, czyli 64), a power.t.test(n = 20, delta = 0.5) – moc przy 20 osobach w grupie (.34). Dla ANOVA jest funkcja power.anova.test().
Czy liczyć moc po przeprowadzeniu badania?
Nie z zaobserwowanego efektu – taka „moc obserwowana” jest prostą funkcją wartości p i nie wnosi nowej informacji (przy p = .05 wynosi około .50). Po badaniu lepiej podać przedział ufności dla efektu albo analizę wrażliwości: jaki efekt badanie mogło wykryć z mocą .80.
Jaka jest różnica między mocą testu a poziomem istotności?
Poziom istotności α kontroluje ryzyko fałszywego alarmu, gdy H0 jest prawdziwa. Moc to szansa wykrycia efektu, gdy H0 jest fałszywa. Przy tej samej próbie obniżenie α zmniejsza moc – dlatego oba parametry planuje się razem.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Moc testu w obrazkach
Pola α, β i mocy na dwóch rozkładach, krzywe mocy z symulacją, klątwa zwycięzcy przy niskiej mocy i moc po fakcie – pięć rysunków z kodem R.
Czytaj →PoradnikAnaliza mocy w jamovi (jpower)
Moduł jpower: N, moc albo najmniejszy efekt dla testu t, tabele i wykresy mocy, δ w próbach zależnych i czego moduł nie liczy – z kontrolą w R.
Czytaj →PoradnikLiczebność próby w eksperymencie ankietowym
Ile osób na warunek przy małych efektach, ile daje kowariata przed bodźcem i plan wewnątrzosobowy, ile kosztują dodatkowe warunki i ubytek.
Czytaj →PoradnikMoc testu i liczebność próby – zadania
Dziesięć zadań: liczebność dla testu t, proporcji i korelacji, moc przy danym n, minimalny efekt, ubytek, efekt schematu, α i moc po fakcie.
Czytaj →PoradnikMoc testu dla interakcji
Dlaczego test interakcji wymaga 4–16 razy większej próby: kształt interakcji, rzetelność iloczynu, symulacja w R i opis analizy mocy.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikStatystyka do pracy magisterskiej
Plan analiz, CFA i omega, regresja hierarchiczna, moderacja i mediacja z bootstrapem, wzory opisu APA i pytania na obronie – z danymi i kodem R.
Czytaj →PoradnikAnaliza mocy dla modelu mieszanego
Własna pętla symulacyjna w lme4: parametry z pilotażu, siatka osób i prób, krzywa mocy, błąd Monte Carlo i analiza wrażliwości.
Czytaj →PoradnikPytania ze statystyki na obronę magisterską
Pytania promotora i recenzenta ułożone według analizy – od testu t i chi-kwadrat po regresję, ANOVA i alfę Cronbacha – z krótkimi odpowiedziami na liczbach.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Brysbaert, M. (2019). How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables. Journal of Cognition, 2(1), Article 16. https://doi.org/10.5334/joc.72 ● Otwarty dostęp
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475 ● Otwarty dostęp
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146 ● Otwarty dostęp
- Jarmakowska-Kostrzanowska, L. (2021). Istotnie statystyczna moc testu – analiza mocy i jej miejsce w przyborniku badacza oraz interpretacja (nie)istotności statystycznej przy małej (dużej) mocy testu. Przegląd Psychologiczny, 64(4), 83–99. https://doi.org/10.31648/pp.7359 ● Otwarty dostęp
- Sommet, N., Weissman, D. L., Cheutin, N., & Elliot, A. J. (2023). How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction. Advances in Methods and Practices in Psychological Science, 6(3), Article 25152459231178728. https://doi.org/10.1177/25152459231178728 ● Otwarty dostęp
Cytowania BibTeX
@article{brysbaert2019how, author={Brysbaert, Marc}, title={{How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables}}, journal={Journal of Cognition}, year={2019}, volume={2}, number={1}, eid={16}, doi={10.5334/joc.72}}@article{button2013power, author={Button, Katherine S. and Ioannidis, John P. A. and Mokrysz, Claire and Nosek, Brian A. and Flint, Jonathan and Robinson, Emma S. J. and Munafò, Marcus R.}, title={{Power failure: Why small sample size undermines the reliability of neuroscience}}, journal={Nature Reviews Neuroscience}, year={2013}, volume={14}, number={5}, pages={365--376}, doi={10.1038/nrn3475}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{faul2007gpower, author={Faul, Franz and Erdfelder, Edgar and Lang, Albert-Georg and Buchner, Axel}, title={{G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences}}, journal={Behavior Research Methods}, year={2007}, volume={39}, number={2}, pages={175--191}, doi={10.3758/bf03193146}}@article{jarmakowska2021istotnie, author={Jarmakowska-Kostrzanowska, Lilianna}, title={{Istotnie statystyczna moc testu – analiza mocy i jej miejsce w przyborniku badacza oraz interpretacja (nie)istotności statystycznej przy małej (dużej) mocy testu}}, journal={Przegląd Psychologiczny}, year={2021}, volume={64}, number={4}, pages={83--99}, doi={10.31648/pp.7359}}@article{sommet2023how, author={Sommet, Nicolas and Weissman, David L. and Cheutin, Nicolas and Elliot, Andrew J.}, title={{How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction}}, journal={Advances in Methods and Practices in Psychological Science}, year={2023}, volume={6}, number={3}, eid={25152459231178728}, doi={10.1177/25152459231178728}}