Co to jest próba?
Próba (próba badawcza, ang. sample) to podzbiór jednostek wybranych z populacji, które faktycznie badamy, żeby na ich podstawie wnioskować o całej populacji. Jednostkami są zwykle osoby, ale mogą być też klasy, szkoły, sesje terapeutyczne czy wpisy w mediach społecznościowych. Liczby obliczone w próbie, np. średnia M czy odchylenie SD, to statystyki. Odpowiadające im nieznane wartości w populacji, np. μ i σ, to parametry. Statystyka z próby jest oszacowaniem parametru – punktowym albo, z przedziałem ufności, przedziałowym.
Z próbą wiążą się dwa różne problemy: błąd losowy i obciążenie. Błąd losowy wynika z tego, że różne próby z tej samej populacji dają różne wyniki. Maleje wraz z liczebnością i da się go oszacować. Obciążenie wynika ze sposobu, w jaki próba powstała. Z liczebnością nie maleje, a z samych danych zwykle nie da się go zmierzyć. Dlatego ocena próby zaczyna się od pytania, jak powstała, a dopiero potem – ile liczy osób.
Od populacji do próby zrealizowanej
W opisie badania warto rozróżnić kilka poziomów. Każde przejście między nimi to miejsce, w którym może pojawić się obciążenie:
| Poziom | Przykład | Co może pójść źle |
|---|---|---|
| Populacja docelowa | Studenci w Polsce | Zbyt szeroko zdefiniowana względem możliwości dotarcia |
| Operat losowania (lista, z której dobieramy) | Lista studentów jednej uczelni | Niedopokrycie: części populacji nie ma w operacie |
| Próba zaproszona | 1000 osób wylosowanych lub zaproszonych | Dobór nielosowy (np. tylko aktywni w grupach na Facebooku) |
| Próba zrealizowana | 312 osób, które wypełniły ankietę | Brak odpowiedzi zależny od badanej cechy |
| Próba analizowana | 287 osób po wykluczeniach | Wykluczenia, np. braki danych czy nieuważne odpowiedzi, zmieniające skład próby |
Sposób przejścia z populacji do próby zaproszonej to dobór próby. W doborze probabilistycznym każda osoba z operatu ma znane, niezerowe prawdopodobieństwo wyboru (zob. próba losowa). W doborze nieprobabilistycznym tego prawdopodobieństwa nie znamy. Należą tu próba kwotowa oraz dobór celowy, wygodny i kula śnieżna. O tym, czy wynik przenosi się na populację, mówi hasło reprezentatywność próby.
Liczebność zmniejsza błąd losowy, nie obciążenie
Rozrzut średnich z wielu prób losowych to błąd standardowy średniej:
Czterokrotne zwiększenie próby zmniejsza więc błąd standardowy o połowę. Ten wzór zakłada jednak, że próba jest losowa. Meng (2018) pokazał, że błąd średniej z dowolnego zbioru danych zależy od trzech czynników: od korelacji między wartością cechy a faktem znalezienia się w danych, od liczebności i od zmienności cechy. Dobór losowy utrzymuje tę korelację na znikomym poziomie. Bez niego nawet ogromna próba bywa mało warta. W analizie wyborów w USA próba samozgłoszeń licząca około 2.3 mln osób miała taki błąd średniokwadratowy jak próba losowa z około 400 osób.
Podobny wniosek dotyczy ankiet internetowych. Bethlehem (2010) uznaje samoselekcję respondentów za źródło niewiarygodnych wyników, którego nie usuwają w pełni ani ważenie, ani duża liczebność.
Przykład: dobrostan studentów jednej uczelni
Symulowana populacja liczy 20 000 studentów. Ich średni dobrostan (WEMWBS, 14–70) wynosi μ = 46.95, a σ = 9.00. Badacz zwykle widzi tylko jedną próbę. Losowa próba 120 osób dała M = 46.31, SD = 8.87, SE = 0.81, 95% CI [44.70, 47.91] – przedział obejmuje prawdziwą średnią.
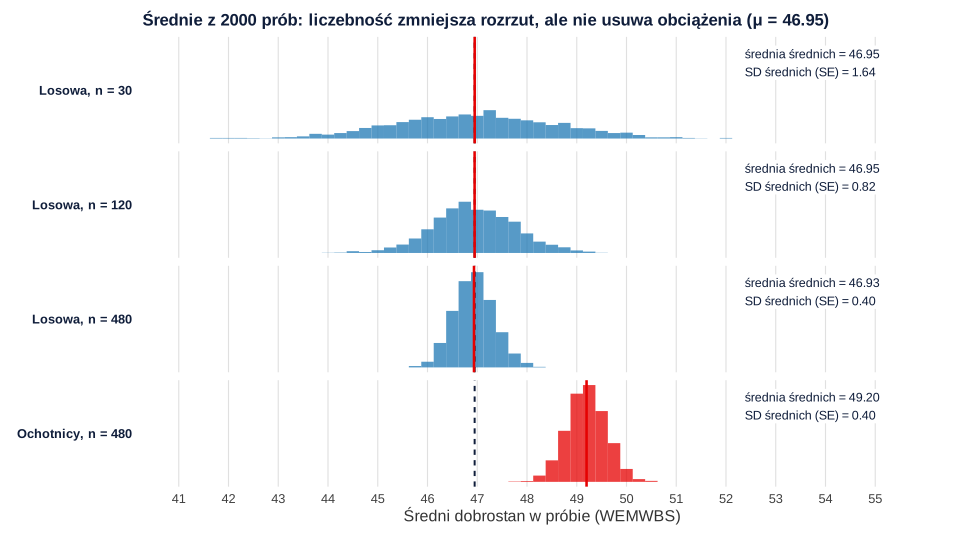
Gdyby powtórzyć losowanie 2000 razy, średnie z prób miałyby rozrzut 1.64 przy n = 30, 0.82 przy n = 120 i 0.40 przy n = 480, zgodnie ze wzorem na SE. Teraz zamiast losowania zbieramy 480 osób z samozgłoszenia. Ankietę chętniej wypełniają osoby z wyższym dobrostanem, a średnie prawdopodobieństwo udziału wynosi 4.9%. Średnia z takich prób wynosi 49.20, czyli jest zawyżona o 2.25 punktu. Rozrzut jest równie mały jak w próbie losowej (0.40), ale wokół złej wartości. W 1000 powtórzeń 95% przedział ufności objął prawdziwą średnią w 94.6% prób losowych i w 0% prób ochotników (rysunek 1).
Do kogo odnosi się wynik z próby
Większość badań psychologicznych prowadzi się na studentach i ochotnikach z internetu, więc pytanie o zasięg wniosków jest stale aktualne. Henrich i in. (2010) pokazali, że szerokie twierdzenia o ludzkiej psychologii opierają się zwykle na próbach z zachodnich, wykształconych, uprzemysłowionych, bogatych i demokratycznych społeczeństw (WEIRD). W wielu dziedzinach takie osoby są przy tym nietypowe na tle reszty ludzkości. Wniosek dla pracy dyplomowej: opisz populację, z której naprawdę pochodzi próba, i nie rozszerzaj wyniku dalej bez uzasadnienia. Ile osób zbadać, to osobna decyzja. Lakens (2022) opisuje sześć sposobów jej uzasadnienia, od ograniczeń zasobów po analizę mocy (zob. poradnik dobór liczebności próby).
„Próba” w nazwach testów
W statystyce słowo „próba” ma też drugie, węższe znaczenie: grupy obserwacji porównywanej w teście. Test t dla prób niezależnych porównuje dwie różne grupy osób, np. kobiety i mężczyzn z tej samej próby badawczej. Test t dla prób zależnych porównuje dwa pomiary tych samych osób. Tutaj „próby” to więc podzbiory danych, a nie osobne badania. Z kolei „podwójnie ślepa próba” to nazwa planu badania klinicznego (ang. trial), niezwiązana z doborem uczestników. W rozdziale metodologicznym używaj słowa „próba” dla całej grupy badanych, a podzbiory nazywaj „grupami” albo „podgrupami”, żeby uniknąć dwuznaczności.
Jak opisać próbę w pracy
Podaj populację docelową, sposób doboru, miejsce i czas rekrutacji, liczbę osób zaproszonych, zrealizowanych i analizowanych (z powodami wykluczeń) oraz podstawowe cechy próby. Gotowe tabele i zdania znajdziesz we wzorze charakterystyki próby, a rekrutację omawia poradnik gdzie znaleźć respondentów.
Przykład w R
Kod tworzy populację 20 000 studentów, losuje jedną próbę i liczy statystyki z przedziałem ufności, a następnie powtarza losowanie 2000 razy dla trzech liczebności i dla próby ochotników, porównując rozrzut, obciążenie i pokrycie przedziałów ufności. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Statystyki z próby, błąd próbkowania i obciążenie doboru
R
# Dane symulowane: populacja 20 000 studentów jednej uczelni i ich dobrostan psychiczny (WEMWBS, 14–70).
set.seed(196)
N <- 20000
populacja <- round(pmin(pmax(rnorm(N, 47, 9), 14), 70))
round(c(parametr_mu = mean(populacja), parametr_sigma = sd(populacja)), 2)

# 1. Jedna próba losowa n = 120: statystyki z próby szacują parametry populacji
proba <- sample(populacja, 120)
M <- mean(proba); SD <- sd(proba); SE <- SD / sqrt(120)
round(c(M = M, SD = SD, SE = SE, dolna_95 = M - qt(.975, 119) * SE, gorna_95 = M + qt(.975, 119) * SE), 2)

# 2. Błąd próbkowania: 2000 prób losowych o różnej liczebności
rozklad <- sapply(c(30, 120, 480), function(n) replicate(2000, mean(sample(populacja, n))))
colnames(rozklad) <- c("n30", "n120", "n480")
round(rbind(srednia_srednich = colMeans(rozklad), SD_srednich = apply(rozklad, 2, sd),
            teoretyczny_SE = sd(populacja) / sqrt(c(30, 120, 480))), 2)

# 3. Duża próba z samozgłoszenia: osoby z wyższym dobrostanem chętniej wypełniają ankietę
p_udzialu <- plogis(-3 + 0.03 * (populacja - 47))
round(c(sredni_p_udzialu = mean(p_udzialu)), 3)
ochotnicy <- replicate(2000, mean(sample(populacja, 480, prob = p_udzialu)))
round(c(srednia_srednich = mean(ochotnicy), SD_srednich = sd(ochotnicy), obciazenie = mean(ochotnicy) - mean(populacja)), 2)
# odsetek prób, w których 95% CI obejmuje prawdziwą średnią populacji
pokrycie <- function(los) mean(replicate(1000, { x <- los(); ci <- t.test(x)$conf.int; ci[1] <= mean(populacja) & mean(populacja) <= ci[2] }))
round(c(losowa_480 = pokrycie(function() sample(populacja, 480)),
        ochotnicy_480 = pokrycie(function() sample(populacja, 480, prob = p_udzialu))), 3)
Wynik w R
   parametr_mu parametr_sigma
         46.95           9.00
       M       SD       SE dolna_95 gorna_95
   46.31     8.87     0.81    44.70    47.91
                   n30  n120  n480
srednia_srednich 46.95 46.95 46.93
SD_srednich       1.64  0.82  0.40
teoretyczny_SE    1.64  0.82  0.41
sredni_p_udzialu
           0.049
srednia_srednich      SD_srednich       obciazenie
           49.20             0.40             2.25
   losowa_480 ochotnicy_480
        0.946         0.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Duża próba, więc reprezentatywna”. Liczebność zmniejsza błąd losowy, ale nie obciążenie. Tysiąc ochotników z jednej grupy na Facebooku nadal reprezentuje głównie tę grupę.
- Mylenie statystyki z parametrem, np. „średni dobrostan studentów wynosi 46.31” zamiast „w próbie wyniósł 46.31”.
- Raportowanie tylko próby analizowanej, bez liczby osób zaproszonych i wykluczonych. Czytelnik nie oceni wtedy, czy brak odpowiedzi lub wykluczenia mogły zmienić wynik.
- Przedział ufności jako ochrona przed złym doborem. Przedział ufności opisuje tylko błąd losowy; w przykładzie przy próbie ochotników nie obejmował prawdziwej średniej ani razu.
- Wnioski o populacji szerszej niż operat, np. o „Polakach” na podstawie studentów jednej uczelni.
- Nazywanie „próbą” jednej osoby lub jednego pomiaru. W statystyce próba to cały zbiór badanych jednostek, a jej liczebność oznacza się literą n (N zwykle dla populacji lub całej próby).
Najczęstsze pytania
Czym różni się próba od populacji?
Populacja to cały zbiór jednostek, o którym chcemy wnioskować, np. wszyscy studenci danej uczelni. Próba to ta jej część, którą faktycznie zbadano. Wartości w populacji (parametry) są zwykle nieznane i szacuje się je na podstawie statystyk z próby.
Co to jest operat losowania?
To lista lub inny wykaz jednostek, z którego dobiera się próbę, np. lista studentów uczelni czy rejestr szkół. Jeśli część populacji nie występuje w operacie, powstaje niedopokrycie i nawet losowy dobór nie zapewni reprezentatywności względem całej populacji docelowej.
Czym różni się błąd losowy od obciążenia próby?
Błąd losowy to naturalna różnica między wynikami kolejnych prób z tej samej populacji; maleje wraz z liczebnością i opisuje go błąd standardowy. Obciążenie to systematyczne przesunięcie wynikające ze sposobu doboru lub braku odpowiedzi; nie maleje z liczebnością i nie widać go w przedziale ufności.
Czy duża próba zawsze daje lepsze wyniki?
Daje precyzyjniejsze oszacowanie, ale tylko wokół tej wartości, którą mierzy dany sposób doboru. Jeśli udział w badaniu zależy od badanej cechy, duża próba daje wąski przedział ufności wokół błędnej wartości. Dobór i odsetek odpowiedzi są często ważniejsze niż sama liczebność.
Co to jest próba zrealizowana?
To osoby, które faktycznie wzięły udział w badaniu, w odróżnieniu od osób wylosowanych lub zaproszonych. Różnica między nimi (brak odpowiedzi) może zmieniać skład próby, dlatego w pracy podaje się obie liczby i odsetek realizacji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →PoradnikWzór przedstawienia charakterystyki próby w badaniach naukowych
Gotowy układ tabeli i akapitu: przepływ uczestników, demografia, zmienne kliniczne, braki danych i informacje potrzebne do oceny możliwości uogólniania.
Czytaj →PoradnikGdzie znaleźć respondentów do ankiety?
Uczelnia, grupy tematyczne, kula śnieżna, panele i wymiana ankiet – porównanie kanałów, wzór zaproszenia, liczba zaproszeń i opis próby w pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x ● Otwarty dostęp
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/s0140525x0999152x
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Meng, X.-L. (2018). Statistical paradises and paradoxes in big data (I): Law of large populations, big data paradox, and the 2016 US presidential election. The Annals of Applied Statistics, 12(2), 685–726. https://doi.org/10.1214/18-aoas1161sf ● Otwarty dostęp
Cytowania BibTeX
@article{bethlehem2010selection, author={Bethlehem, Jelke}, title={{Selection bias in web surveys}}, journal={International Statistical Review}, year={2010}, volume={78}, number={2}, pages={161--188}, doi={10.1111/j.1751-5823.2010.00112.x}}@article{henrich2010weirdest, author={Henrich, Joseph and Heine, Steven J. and Norenzayan, Ara}, title={{The weirdest people in the world?}}, journal={Behavioral and Brain Sciences}, year={2010}, volume={33}, number={2–3}, pages={61--83}, doi={10.1017/s0140525x0999152x}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{meng2018statistical, author={Meng, Xiao-Li}, title={{Statistical paradises and paradoxes in big data (I): Law of large populations, big data paradox, and the 2016 US presidential election}}, journal={The Annals of Applied Statistics}, year={2018}, volume={12}, number={2}, pages={685--726}, doi={10.1214/18-aoas1161sf}}