Co to jest próba losowa?
Próba losowa (próba probabilistyczna, ang. probability sample) to próba wybrana z operatu losowania tak, że każda jednostka populacji ma znane i niezerowe prawdopodobieństwo znalezienia się w próbie. Najprostsza odmiana to prosta próba losowa (ang. simple random sample). W niej każda osoba ma to samo prawdopodobieństwo wyboru, a każdy podzbiór o danej liczebności ma tę samą szansę, by stać się próbą. Elliott i Valliant (2017) przypominają, że w takiej sytuacji wnioskowanie opiera się na samym mechanizmie losowania (ang. design-based inference). Rozkład możliwych wyników wynika z tego, jakie próby mogły zostać wylosowane, a nie z założeń o populacji.
Losowy dobór próby to coś innego niż losowy przydział do warunków eksperymentu. Dobór losowy decyduje, kogo badamy, i służy uogólnianiu na populację. Przydział losowy decyduje, do której grupy trafia już zbadana osoba, i służy wnioskowaniu przyczynowemu. Badanie może mieć jedno bez drugiego. Eksperyment na ochotnikach ma randomizację bez losowej próby, a sondaż z losowej listy – losową próbę bez randomizacji.
Schematy losowania
| Schemat | Jak przebiega | Precyzja względem losowania prostego |
|---|---|---|
| Losowanie proste | Losujemy n osób z pełnej listy | Punkt odniesienia |
| Losowanie systematyczne | Losowy start, potem co k-ta osoba z listy | Zwykle podobna; gorsza, gdy lista ma cykliczny układ |
| Losowanie warstwowe | Populację dzielimy na warstwy (np. wydziały) i losujemy osobno w każdej | Lepsza, gdy warstwy różnią się średnimi |
| Losowanie zespołowe (grupowe) | Losujemy całe grupy (klasy, grupy dziekańskie) i badamy wszystkich w nich | Gorsza, gdy osoby w grupie są do siebie podobne |
| Losowanie wielostopniowe | Najpierw losujemy szkoły, potem klasy, potem uczniów | Zależy od podobieństwa na każdym poziomie |
Berndt (2020) zestawia te techniki z ich zaletami i wadami. W praktyce o wyborze decydują dwie rzeczy: czy istnieje lista osób (operat) i ile kosztuje dotarcie do rozproszonych respondentów. Losowanie zespołowe jest często jedynym wykonalnym rozwiązaniem w szkołach, ale płaci się za nie precyzją. Ile, zależy od tego, jak bardzo osoby z jednej grupy są do siebie podobne – pokazuje to poniższy przykład.
Losowanie warstwowe może być proporcjonalne, gdy każda warstwa ma w próbie taki udział jak w populacji, albo nieproporcjonalne, gdy z małych warstw losuje się więcej osób, żeby dało się je analizować osobno. Przykładem jest 50 osób z wydziału liczącego 200 studentów i 50 z wydziału liczącego 2000. Prawdopodobieństwa wyboru są wtedy różne, ale nadal znane. Przy szacowaniu średniej dla całej populacji trzeba więc nadać osobom wagi odwrotnie proporcjonalne do prawdopodobieństwa wyboru: 200/50 = 4 dla małego wydziału i 2000/50 = 40 dla dużego. Bez wag wynik przechyla się w stronę nadreprezentowanych warstw.
Przykład: trzy sposoby wylosowania 200 studentów
Symulowany operat to lista 2400 studentów z czterech wydziałów, po 600 osób, podzielonych na 96 grup dziekańskich po 25 osób. Cel badania: oszacować średni lęk egzaminacyjny (skala 10–40). W populacji średnia wynosi 24.52 (σ = 5.00). Wydziały się różnią: lekarski ma średnią 27.08, prawa 25.52, humanistyczny 23.77, a informatyki 21.72. Osoby z tej samej grupy dziekańskiej są do siebie podobne – korelacja wewnątrzklasowa (ICC) wynosi .221. We wszystkich trzech schematach każda osoba ma tę samą szansę wyboru: 200/2400.
- Losowanie proste – 200 osób z całej listy.
- Losowanie warstwowe proporcjonalne – po 50 osób z każdego wydziału.
- Losowanie zespołowe – 8 losowych grup dziekańskich po 25 osób.
W 2000 powtórzeń wszystkie trzy schematy dały średnio poprawny wynik (24.52–24.53). Różniły się jednak precyzją. Empiryczny błąd standardowy wyniósł 0.33 przy losowaniu prostym, 0.31 przy warstwowym i 0.84 przy zespołowym. Iloraz wariancji względem losowania prostego to efekt schematu: 0.85 dla warstw i 6.35 dla zespołów. Próba zespołowa 200 osób daje więc tyle informacji co prosta próba losowa z około 31 osób, a warstwowa – co próba z 234 osób (rysunek 1). Efekt schematu dla zespołów zgadza się z przybliżeniem 1 + (25 − 1) × ICC = 6.3.
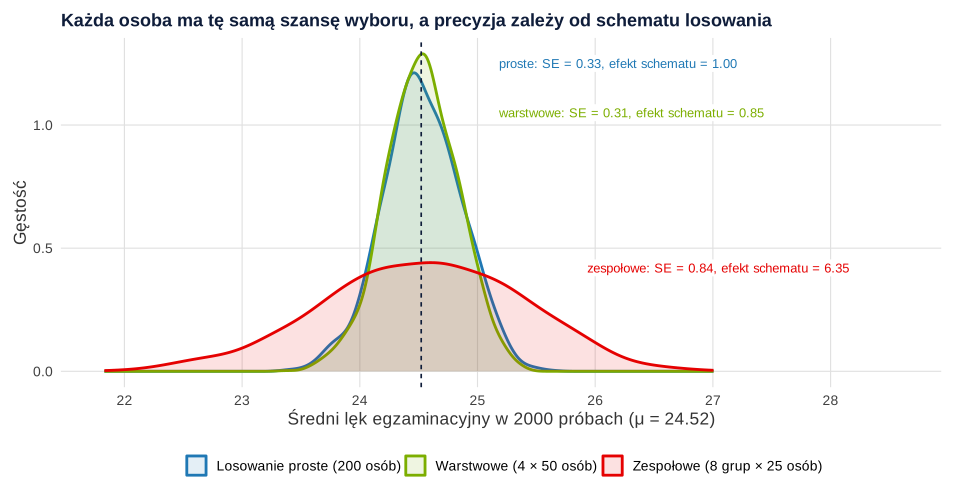
Wniosek: przy losowaniu zespołowym nie wolno analizować danych tak, jakby pochodziły z losowania prostego. Błędy standardowe będą wtedy zaniżone, a wyniki zbyt często istotne. Trzeba uwzględnić zagnieżdżenie, np. modelem wielopoziomowym albo poprawką na efekt schematu. Lai i Kwok (2015) pokazali, że popularna reguła „efekt schematu poniżej 2 pozwala pominąć zagnieżdżenie” zawodzi, gdy interesują nas predyktory z poziomu grup albo gdy grupy liczą mniej niż 10 osób.
Próba losowa w badaniu psychologicznym
W pracach dyplomowych prawdziwa próba losowa jest rzadkością, bo rzadko istnieje dostępna lista populacji. Jeśli uczelnia, szkoła czy firma udostępni listę, losowanie jest proste (sample() w R). Wtedy jednak pojawia się drugi problem: część wylosowanych osób nie odpowie. Próba zrealizowana jest losowa tylko wtedy, gdy brak odpowiedzi nie zależy od badanej cechy. Dlatego podaj odsetek realizacji i porównaj osoby, które odpowiedziały, z resztą operatu pod względem znanych cech. Cornesse i in. (2020) przypominają, że zaufanie do prób probabilistycznych wynika z teorii statystycznej, a trafność prób nieprobabilistycznych zależy całkowicie od modeli. Przy niskim odsetku realizacji ta przewaga słabnie. Gdy listy brak, uczciwszy jest otwarty opis doboru kwotowego lub wygodnego niż nazywanie próby „losową”.
Jak opisać losowanie w pracy
Podaj operat (skąd lista, ile osób), schemat losowania (z warstwami lub zespołami), liczebność w każdej warstwie, sposób losowania (np. generator liczb losowych w R z podanym ziarnem), liczbę osób wylosowanych i zrealizowanych oraz to, jak analiza uwzględnia schemat. Charakterystykę zrealizowanej próby przedstawisz według poradnika jak opisać charakterystykę próby.
Przykład w R
Kod tworzy operat 2400 studentów z wydziałami i grupami dziekańskimi, liczy ICC, pokazuje funkcje losujące próbę trzema schematami i porównuje je w 2000 powtórzeniach (średnia oszacowań, błąd standardowy, efekt schematu, efektywna liczebność). Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Losowanie proste, warstwowe i zespołowe z operatu
R
# Dane symulowane: operat losowania = lista 2400 studentów z 4 wydziałów, podzielonych na 96 grup dziekańskich po 25 osób.
# Cel: oszacować średni lęk egzaminacyjny (skala 10–40) na podstawie próby 200 osób.
set.seed(198)
wydzialy <- c(lekarski = 600, prawa = 600, humanistyczny = 600, informatyki = 600)
operat <- data.frame(id = 1:2400, wydzial = rep(names(wydzialy), wydzialy), grupa = rep(1:96, each = 25))
srednie_wydz <- c(lekarski = 27, prawa = 25.5, humanistyczny = 24, informatyki = 22)
efekt_grupy <- rnorm(96, 0, 1.3)                                   # podobieństwo osób z tej samej grupy dziekańskiej
operat$lek <- round(srednie_wydz[operat$wydzial] + efekt_grupy[operat$grupa] + rnorm(2400, 0, 4.5))
round(c(mu = mean(operat$lek), sigma = sd(operat$lek)), 2)
round(tapply(operat$lek, operat$wydzial, mean), 2)[names(wydzialy)]
# korelacja wewnątrzklasowa w grupach dziekańskich (z jednoczynnikowej ANOVA)
ms <- summary(aov(lek ~ factor(grupa), data = operat))[[1]][["Mean Sq"]]
round((ms[1] - ms[2]) / (ms[1] + 24 * ms[2]), 3)

# Trzy sposoby losowania 200 osób (każda osoba ma to samo prawdopodobieństwo wyboru: 200/2400)
prosta    <- function() sample(operat$id, 200)                                        # losowanie proste
warstwowa <- function() unlist(lapply(split(operat$id, operat$wydzial), sample, 50))  # 50 osób z każdego wydziału
zespolowa <- function() operat$id[operat$grupa %in% sample(1:96, 8)]                  # 8 całych grup dziekańskich

# Jedna próba warstwowa: średnia i liczebności w warstwach
set.seed(1980)
i <- warstwowa(); table(operat$wydzial[i]); round(mean(operat$lek[i]), 2)

# 2000 powtórzeń każdego schematu: rozrzut średnich (empiryczny błąd standardowy) i efekt schematu
set.seed(2198)
oszac <- sapply(list(prosta = prosta, warstwowa = warstwowa, zespolowa = zespolowa),
                function(f) replicate(2000, mean(operat$lek[f()])))
se <- apply(oszac, 2, sd)
# efekt schematu = wariancja oszacowań / wariancja przy losowaniu prostym
round(rbind(srednia_oszacowan = colMeans(oszac), SE = se, efekt_schematu = se^2 / se[["prosta"]]^2,
            n_efektywne = 200 * se[["prosta"]]^2 / se^2), 2)
Wynik w R
   mu sigma
24.52  5.00
     lekarski         prawa humanistyczny   informatyki
        27.08         25.52         23.77         21.72
[1] 0.221

humanistyczny   informatyki      lekarski         prawa
           50            50            50            50
[1] 24.66
                  prosta warstwowa zespolowa
srednia_oszacowan  24.53     24.52     24.53
SE                  0.33      0.31      0.84
efekt_schematu      1.00      0.85      6.35
n_efektywne       200.00    234.37     31.49
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Nazywanie „losową” próby z ogłoszenia w internecie. Losowość to cecha mechanizmu doboru, a nie wrażenie, że respondenci są „przypadkowi”.
- Mylenie losowego doboru z losowym przydziałem. Randomizacja w eksperymencie nie czyni próby losową, a losowa próba nie czyni badania eksperymentem.
- Analiza próby zespołowej jak prostej. Zaniżone błędy standardowe i zbyt wiele fałszywie istotnych wyników; uwzględnij zagnieżdżenie.
- Losowanie warstwowe nieproporcjonalne bez wag. Jeśli z małego wydziału wylosowano tyle samo osób co z dużego, średnia ogólna bez wag będzie obciążona.
- Pominięcie braku odpowiedzi. Wylosowanie 500 osób przy realizacji 20% nie daje próby losowej 100 osób, tylko próbę osób chętnych spośród wylosowanych.
- Przekonanie, że próba losowa jest zawsze reprezentatywna. Pojedyncza mała próba losowa może przypadkiem odbiegać od populacji; losowanie gwarantuje brak obciążenia w średniej i znany błąd, a nie idealne odwzorowanie (zob. reprezentatywność próby).
Najczęstsze pytania
Jak wylosować próbę do badania?
Potrzebna jest lista populacji (operat), np. lista studentów. Każdej osobie nadaj numer i wylosuj potrzebną liczbę numerów generatorem liczb losowych, np. funkcją sample() w R z zapisanym ziarnem (set.seed). Przy losowaniu warstwowym zrób to osobno w każdej warstwie.
Czym różni się losowanie warstwowe od zespołowego?
W losowaniu warstwowym losuje się osoby z każdej warstwy (np. z każdego wydziału), co zwykle zwiększa precyzję. W losowaniu zespołowym losuje się całe grupy (np. klasy) i bada wszystkich ich członków, co jest tańsze, ale zmniejsza precyzję, bo osoby z jednej grupy są do siebie podobne.
Czy próba z ankiety internetowej może być losowa?
Tylko wtedy, gdy zaproszenia rozesłano do osób wylosowanych z listy populacji, np. z bazy adresów uczelni. Ankieta udostępniona publicznie w mediach społecznościowych daje próbę z samozgłoszenia, niezależnie od tego, ile osób odpowie.
Co to jest losowanie systematyczne?
To wybór co k-tej osoby z listy, począwszy od losowo wybranego miejsca, np. co 12. osoby przy próbie 200 z listy 2400. Daje zwykle podobną precyzję jak losowanie proste, ale zawodzi, gdy lista ma powtarzający się układ zbieżny z krokiem losowania.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Schematy losowania w obrazkach
Sześć schematów losowania na mapach jednej populacji, 1000 symulowanych badań, efekt schematu i efektywna liczebność – pięć rysunków z kodem R.
Czytaj →PoradnikJak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikRodzaje badań ankietowych
Czas, dobór, kanał i cel badania ankietowego oraz ich konsekwencje dla wniosków – z symulacją autoselekcji w R i wzorem opisu schematu.
Czytaj →PoradnikCałkowity błąd badania sondażowego (TSE)
Pokrycie, brak odpowiedzi, pomiar i ważenie w jednym rachunku MSE: symulacja czterech planów za ten sam budżet i opis ograniczeń.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Berndt, A. E. (2020). Sampling methods. Journal of Human Lactation, 36(2), 224–226. https://doi.org/10.1177/0890334420906850
- Cornesse, C., Blom, A. G., Dutwin, D., Krosnick, J. A., De Leeuw, E. D., Legleye, S., Pasek, J., Pennay, D., Phillips, B., Sakshaug, J. W., Struminskaya, B., & Wenz, A. (2020). A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research. Journal of Survey Statistics and Methodology, 8(1), 4–36. https://doi.org/10.1093/jssam/smz041 ● Otwarty dostęp
- Elliott, M. R., & Valliant, R. (2017). Inference for nonprobability samples. Statistical Science, 32(2), 249–264. https://doi.org/10.1214/16-sts598 ● Otwarty dostęp
- Lai, M. H. C., & Kwok, O. (2015). Examining the rule of thumb of not using multilevel modeling: The “design effect smaller than two” rule. The Journal of Experimental Education, 83(3), 423–438. https://doi.org/10.1080/00220973.2014.907229
Cytowania BibTeX
@article{berndt2020sampling, author={Berndt, Andrea E.}, title={{Sampling methods}}, journal={Journal of Human Lactation}, year={2020}, volume={36}, number={2}, pages={224--226}, doi={10.1177/0890334420906850}}@article{cornesse2020review, author={Cornesse, Carina and Blom, Annelies G. and Dutwin, David and Krosnick, Jon A. and De Leeuw, Edith D. and Legleye, Stéphane and Pasek, Josh and Pennay, Darren and Phillips, Benjamin and Sakshaug, Joseph W. and Struminskaya, Bella and Wenz, Alexander}, title={{A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={1}, pages={4--36}, doi={10.1093/jssam/smz041}}@article{elliott2017inference, author={Elliott, Michael R. and Valliant, Richard}, title={{Inference for nonprobability samples}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={249--264}, doi={10.1214/16-sts598}}@article{lai2015examining, author={Lai, Mark H. C. and Kwok, Oi-man}, title={{Examining the rule of thumb of not using multilevel modeling: The “design effect smaller than two” rule}}, journal={The Journal of Experimental Education}, year={2015}, volume={83}, number={3}, pages={423--438}, doi={10.1080/00220973.2014.907229}}