Co to jest podwójnie ślepa próba?
Podwójnie ślepa próba (badanie podwójnie zaślepione, ang. double-blind trial) to badanie z losowym przydziałem (najczęściej eksperyment kliniczny), w którym ani uczestnicy, ani osoby prowadzące badanie i oceniające wyniki nie wiedzą, kto otrzymał interwencję, a kto warunek porównawczy, np. placebo. Słowo „próba” oznacza tu badanie (ang. trial), a nie próbę w sensie statystycznym. To częste źródło nieporozumień w pracach dyplomowych.
Schulz i Grimes (2002) zwracają uwagę, że terminy „pojedynczo”, „podwójnie” i „potrójnie” ślepa próba różni badacze rozumieją różnie. Zaślepienie może obejmować kilka grup osób:
| Kogo zaślepiamy | Przed jakim błędem chroni | Przykład w psychologii |
|---|---|---|
| Uczestników | Efekt oczekiwań, placebo, różne zaangażowanie i rezygnacje | Kapsułka suplementu vs identyczna kapsułka placebo |
| Prowadzących interwencję | Różne traktowanie grup, dodatkowe wsparcie dla „swojej” grupy | Eksperymentator nie zna warunku, w którym jest osoba badana |
| Oceniających wynik | Stronniczość oceny (błąd obserwatora) | Klinicysta oceniający nasilenie lęku nie wie, kto był w której grupie |
| Analizujących dane | Wybór analizy pod oczekiwany wynik | Grupy zakodowane jako A i B do czasu zakończenia analizy |
Dlatego zamiast samej etykiety „podwójnie ślepa” napisz wprost, kto był zaślepiony i w jaki sposób – to główne zalecenie Schulza i Grimesa (2002).
Po co zaślepiać i co to daje
Zaślepienie nie jest tym samym co losowanie ani ukrycie przydziału (ang. allocation concealment). Losowanie tworzy porównywalne grupy. Ukrycie przydziału sprawia, że osoba włączająca uczestnika nie wie, do której grupy trafi następny. Zaślepienie chroni porównywalność grup po przydziale: wyrównuje oczekiwania, sposób traktowania uczestników i ocenę wyników.
Największy zysk daje zaślepienie oceny wyników subiektywnych. Hróbjartsson i in. (2012) przeanalizowali 21 badań, w których ten sam wynik binarny oceniali i zaślepieni, i niezaślepieni oceniający. Niezaślepiona ocena zawyżała iloraz szans średnio o 36%, choć oceniający zgadzali się w medianie 78% przypadków. Do takiego zawyżenia wystarczyło przeklasyfikowanie mediany 3% pacjentów. Schulz i Grimes (2002) przypominają, że przy wynikach obiektywnych, np. zgonie, pole do stronniczości jest małe.
W psychologii pełne zaślepienie bywa niemożliwe: uczestnik wie, że chodzi na psychoterapię, a terapeuta wie, co robi. Boot i in. (2013) pokazują, że nawet aktywna grupa kontrolna nie wystarcza, by przypisać poprawę interwencji, jeśli obie grupy mają różne oczekiwania poprawy. Proponują mierzyć te oczekiwania. W takich badaniach realnym celem jest zaślepienie oceniających i analizujących dane oraz pomiar oczekiwań uczestników.
Jak zaślepić w praktyce
- Identyczny wygląd warunków – kapsułki, aplikacje czy nagrania różnią się tylko składnikiem aktywnym; sprawdź też smak, zapach i czas trwania.
- Kodowanie warunków – osoba niezwiązana z rekrutacją przygotowuje listę przydziału i opakowania oznaczone numerami.
- Rozdzielenie ról – kto prowadzi interwencję, nie ocenia wyniku; oceniający nie rozmawia z uczestnikami o przebiegu interwencji.
- Standaryzowane instrukcje – ten sam tekst wprowadzenia we wszystkich grupach, bez sugestii, czego się spodziewać.
- Zaślepiona analiza – grupy oznaczone literami do zakończenia głównej analizy.
- Procedura odślepienia – w badaniach z ryzykiem dla zdrowia ustal z góry, kto i kiedy może poznać przydział konkretnej osoby.
Przykład 1: czy zaślepienie się udało?
W symulowanym badaniu suplementu i placebo w lęku (po 80 osób w ramieniu) po 8 tygodniach zapytano uczestników, co ich zdaniem otrzymywali. W ramieniu suplementu 38 osób odpowiedziało „suplement”, 22 – „placebo”, a 20 – „nie wiem”. W ramieniu placebo odpowiedzi rozkładały się tak: 25, 27 i 28.
Bang i in. (2004) zaproponowali indeks zaślepienia w skali od −1 do 1, liczony osobno dla każdego ramienia. Wartość 1 oznacza całkowity brak zaślepienia, 0 jest zgodne z pełnym zaślepieniem, a −1 wskazuje na odwrotne zgadywanie. W ramieniu indeks to różnica między liczbą trafnych i nietrafnych odpowiedzi podzielona przez liczebność ramienia.
- Ramię suplementu: BI = (38 − 22) / 80 = .200, 95% CI [.015, .385]. Uczestnicy częściej niż przypadkowo trafiali, że dostali suplement, np. z powodu posmaku lub skutków ubocznych.
- Ramię placebo: BI = (27 − 25) / 80 = .025, 95% CI [−.152, .202] – zgodne z zaślepieniem.
Częściowe odślepienie w jednym ramieniu nie unieważnia badania, ale trzeba je zgłosić. Warto też sprawdzić, czy efekt jest podobny u osób, które zgadywały trafnie, i u tych, które odpowiadały „nie wiem”.
Przykład 2: co robi niezaślepiony oceniający
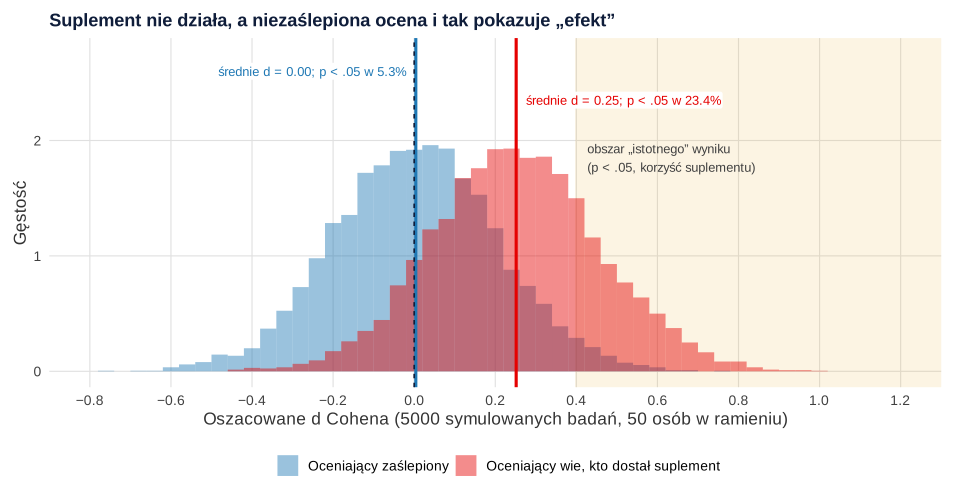
W symulacji 5000 badań po 50 osób w ramieniu klinicysta ocenia nasilenie lęku w skali HAM-A (SD = 6). Niezaślepiony oceniający „widzi” w ramieniu suplementu średnio o 1.5 punktu mniej objawów, czyli o 0.25 SD. Gdy suplement nie działa, przy zaślepionej ocenie średnie d Cohena wynosi 0.00, a fałszywie istotne wyniki (błąd I rodzaju) pojawiają się w 5.3% badań. Przy niezaślepionej ocenie średnie d rośnie do 0.25, a odsetek „istotnych” wyników – do 23.4% (rysunek 1). Gdy suplement rzeczywiście obniża objawy o 2.4 punktu, niezaślepiona ocena zawyża d z 0.40 do 0.65, a odsetek istotnych wyników, czyli pozorna moc, wzrasta z 51.5% do 89.3%. Badanie wygląda wtedy na mocniejsze, niż jest.
Jak opisać zaślepienie w pracy
Podaj kto (uczestnicy, prowadzący, oceniający, analizujący), jak (identyczne kapsułki, kodowanie grup, oddzielenie ról) i czy sprawdzano skuteczność zaślepienia. Wymóg opisu zaślepienia jest częścią listy CONSORT, o której piszemy w tekście statystyka w publikacji medycznej. Plan zaślepienia analizy warto zapisać w prerejestracji.
Przykład w R
Kod liczy indeks zaślepienia Banga z 95% CI dla obu ramion badania, a następnie w 5000 symulowanych badaniach porównuje zaślepioną i niezaślepioną ocenę wyniku przy braku efektu i przy rzeczywistym efekcie. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Indeks zaślepienia Banga i symulacja stronniczości oceny
R
# Przykład 1 (dane symulowane): ocena skuteczności zaślepienia indeksem Banga.
# Badanie suplementu vs placebo w lęku; po 8 tygodniach każdego uczestnika zapytano:
# „Jak myślisz, co otrzymywałeś/aś?” (suplement / placebo / nie wiem).
zgadywanie <- matrix(c(38, 22, 20,      # ramię suplementu: suplement, placebo, nie wiem
                       25, 27, 28),     # ramię placebo
                     nrow = 2, byrow = TRUE,
                     dimnames = list(ramie = c("suplement", "placebo"), odpowiedz = c("suplement", "placebo", "nie wiem")))
zgadywanie
indeks_banga <- function(trafne, nietrafne, n) {
  bi <- (trafne - nietrafne) / n                       # od −1 do 1; 0 = zgodne z pełnym zaślepieniem
  se <- sqrt((trafne / n + nietrafne / n - bi^2) / n)  # błąd standardowy (rozkład wielomianowy)
  round(c(BI = bi, SE = se, dolna = bi - 1.96 * se, gorna = bi + 1.96 * se), 3)
}
indeks_banga(trafne = 38, nietrafne = 22, n = 80)     # ramię suplementu
indeks_banga(trafne = 27, nietrafne = 25, n = 80)     # ramię placebo

# Przykład 2 (symulacja): co się dzieje, gdy oceniający wynik wie, kto dostał suplement.
# Wynik: nasilenie lęku w skali HAM-A (SD = 6) oceniane przez klinicystę; 50 osób w ramieniu.
# Niezaślepiony oceniający „widzi” w ramieniu suplementu średnio o 1.5 pkt mniej objawów (0.25 SD).
set.seed(195)
symulacja <- function(prawdziwy_efekt, stronniczosc, R = 5000, n = 50) {
  wyn <- replicate(R, {
    supl <- rnorm(n, 20 - prawdziwy_efekt - stronniczosc, 6); plac <- rnorm(n, 20, 6)
    c(d = (mean(plac) - mean(supl)) / sqrt((var(plac) + var(supl)) / 2), p = t.test(plac, supl, var.equal = TRUE)$p.value)
  })
  round(c(sredni_d = mean(wyn["d", ]), odsetek_p_ponizej_05 = mean(wyn["p", ] < .05)), 3)
}
rbind(`brak efektu, oceniający zaślepiony`      = symulacja(0, 0),
      `brak efektu, oceniający niezaślepiony`   = symulacja(0, 1.5),
      `efekt 2.4 pkt, oceniający zaślepiony`    = symulacja(2.4, 0),
      `efekt 2.4 pkt, oceniający niezaślepiony` = symulacja(2.4, 1.5))
Wynik w R
           odpowiedz
ramie       suplement placebo nie wiem
  suplement        38      22       20
  placebo          25      27       28
   BI    SE dolna gorna
0.200 0.094 0.015 0.385
    BI     SE  dolna  gorna
 0.025  0.090 -0.152  0.202
                                        sredni_d odsetek_p_ponizej_05
brak efektu, oceniający zaślepiony         0.004                0.053
brak efektu, oceniający niezaślepiony      0.252                0.234
efekt 2.4 pkt, oceniający zaślepiony       0.403                0.515
efekt 2.4 pkt, oceniający niezaślepiony    0.652                0.893
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Etykieta „podwójnie ślepa” bez opisu, kogo i jak zaślepiono. Czytelnik nie wie wtedy, czy zaślepiono oceniających, a to od nich zależy stronniczość wyników subiektywnych.
- Mylenie zaślepienia z randomizacją lub ukryciem przydziału. To trzy różne zabezpieczenia; badanie może mieć jedno bez pozostałych.
- Uznawanie badania za słabe tylko dlatego, że nie jest podwójnie ślepe. Przy psychoterapii pełne zaślepienie jest niemożliwe. Liczy się zaślepienie oceny wyniku i pomiar oczekiwań (Boot i in., 2013).
- Brak sprawdzenia skuteczności zaślepienia przy preparatach z wyraźnymi skutkami ubocznymi. Pytanie o domniemany przydział nic nie kosztuje, a pozwala policzyć indeks zaślepienia.
- Odślepienie analityka: wybór testu, wykluczeń i obserwacji odstających po zobaczeniu, która grupa wypada lepiej. Ustal reguły przed odkodowaniem grup.
- „Ślepa próba” rozumiana jako sposób doboru uczestników. Zaślepienie dotyczy wiedzy o przydziale, a nie tego, jak uczestników zrekrutowano.
Najczęstsze pytania
Czym różni się pojedynczo ślepa próba od podwójnie ślepej?
W pojedynczo ślepej próbie przydziału nie znają zwykle tylko uczestnicy, a w podwójnie ślepej – także prowadzący badanie i oceniający wyniki. Terminy te bywają rozumiane różnie, dlatego w pracy zawsze wymień, kto dokładnie był zaślepiony.
Czy psychoterapię można badać metodą podwójnie ślepej próby?
Zwykle nie w pełni, bo uczestnik i terapeuta wiedzą, jaka terapia jest prowadzona. Można jednak zaślepić osoby oceniające wynik i analizujące dane, zastosować aktywną grupę kontrolną i zmierzyć oczekiwania uczestników wobec poprawy.
Jak sprawdzić, czy zaślepienie się udało?
Po zakończeniu badania zapytaj uczestników (i ewentualnie oceniających), do której grupy ich zdaniem należeli, z opcją „nie wiem”. Na tej podstawie policz indeks zaślepienia Banga dla każdego ramienia: wartości bliskie 0 są zgodne z zaślepieniem, bliskie 1 wskazują na odślepienie.
Czym różni się zaślepienie od ukrycia przydziału?
Ukrycie przydziału dotyczy momentu włączania do badania: osoba rekrutująca nie wie, do której grupy trafi następny uczestnik. Zaślepienie dotyczy okresu po przydziale: uczestnicy, prowadzący i oceniający nie wiedzą, kto jest w której grupie.
Co to jest potrójnie ślepa próba?
Najczęściej oznacza badanie, w którym oprócz uczestników i prowadzących zaślepiono także osoby oceniające wyniki lub analizujące dane. Ponieważ znaczenie terminu nie jest ustalone, lepiej opisać każdą zaślepioną grupę osobno.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →PoradnikStatystyka dla lekarza
ARR, RR, NNT i NNH z przedziałem ufności, PPV i ilorazy wiarygodności, krzywe Kaplana–Meiera i HR, non-inferiority, pułapki i pierwsze kroki własnego badania.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bang, H., Ni, L., & Davis, C. E. (2004). Assessment of blinding in clinical trials. Controlled Clinical Trials, 25(2), 143–156. https://doi.org/10.1016/j.cct.2003.10.016
- Boot, W. R., Simons, D. J., Stothart, C., & Stutts, C. (2013). The pervasive problem with placebos in psychology: Why active control groups are not sufficient to rule out placebo effects. Perspectives on Psychological Science, 8(4), 445–454. https://doi.org/10.1177/1745691613491271
- Hróbjartsson, A., Thomsen, A. S. S., Emanuelsson, F., Tendal, B., Hilden, J., Boutron, I., Ravaud, P., & Brorson, S. (2012). Observer bias in randomised clinical trials with binary outcomes: Systematic review of trials with both blinded and non-blinded outcome assessors. BMJ, 344, Article e1119. https://doi.org/10.1136/bmj.e1119 ● Otwarty dostęp
- Schulz, K. F., & Grimes, D. A. (2002). Blinding in randomised trials: Hiding who got what. The Lancet, 359(9307), 696–700. https://doi.org/10.1016/s0140-6736(02)07816-9
Cytowania BibTeX
@article{bang2004assessment, author={Bang, Heejung and Ni, Liyun and Davis, Clarence E.}, title={{Assessment of blinding in clinical trials}}, journal={Controlled Clinical Trials}, year={2004}, volume={25}, number={2}, pages={143--156}, doi={10.1016/j.cct.2003.10.016}}@article{boot2013pervasive, author={Boot, Walter R. and Simons, Daniel J. and Stothart, Cary and Stutts, Cassie}, title={{The pervasive problem with placebos in psychology: Why active control groups are not sufficient to rule out placebo effects}}, journal={Perspectives on Psychological Science}, year={2013}, volume={8}, number={4}, pages={445--454}, doi={10.1177/1745691613491271}}@article{hrobjartsson2012observer, author={Hróbjartsson, Asbjørn and Thomsen, Ann Sofia Skou and Emanuelsson, Frida and Tendal, Britta and Hilden, Jørgen and Boutron, Isabelle and Ravaud, Philippe and Brorson, Stig}, title={{Observer bias in randomised clinical trials with binary outcomes: Systematic review of trials with both blinded and non-blinded outcome assessors}}, journal={BMJ}, year={2012}, volume={344}, eid={e1119}, doi={10.1136/bmj.e1119}}@article{schulz2002blinding, author={Schulz, Kenneth F. and Grimes, David A.}, title={{Blinding in randomised trials: Hiding who got what}}, journal={The Lancet}, year={2002}, volume={359}, number={9307}, pages={696--700}, doi={10.1016/s0140-6736(02)07816-9}}