Co to jest próba kwotowa?
Próba kwotowa (dobór kwotowy, ang. quota sampling) to nieprobabilistyczny sposób doboru próby. Badacz ustala z góry, ile osób o określonych cechach ma znaleźć się w próbie – zwykle tak, by odtworzyć strukturę populacji pod względem płci, wieku, wykształcenia czy miejsca zamieszkania. Potem zbiera respondentów dowolną dostępną drogą, aż każda kwota się zapełni. Na przykład jeśli w populacji studentów 61% to kobiety, w próbie 400 osób rekrutuje się 243 kobiety i 157 mężczyzn. Kolejnych chętnych z zapełnionej kategorii już się nie przyjmuje.
Od próby losowej próbę kwotową odróżnia to, kto wybiera konkretne osoby w obrębie kategorii. W próbie losowej decyduje mechanizm losowania. W kwotowej – ankieter, panel internetowy albo sami respondenci, którzy się zgłaszają. Od doboru wygodnego różni ją tylko kontrola struktury próby. W obrębie kategorii dobór jest tak samo wygodny.
Jak ustala się kwoty
| Rodzaj kwot | Przykład | Ograniczenie |
|---|---|---|
| Brzegowe (osobno dla każdej zmiennej) | 61% kobiet; 33% studentów niestacjonarnych | Rozkłady łączne mogą być złe, np. prawie wszyscy niestacjonarni to mężczyźni |
| Krzyżowe (dla kombinacji zmiennych) | Kobiety niestacjonarne 18.7%, kobiety stacjonarne 42.0% itd. | Szybko rośnie liczba komórek; trudno zapełnić rzadkie |
| Rozszerzone o zmienne związane z tematem | Dodatkowo kwota na osoby pracujące zawodowo | Wymaga znajomości struktury populacji także dla tych zmiennych |
Strukturę populacji bierze się z wiarygodnego źródła, np. danych GUS, sprawozdań uczelni czy rejestrów. Kwoty mają sens tylko dla zmiennych, które wiążą się z badaną cechą. Kwota na płeć niczego nie poprawi, jeśli płeć nie różnicuje wyniku. Z drugiej strony każda dodatkowa zmienna mnoży liczbę komórek. Przy kwotach krzyżowych dla płci, czterech grup wieku i trzech poziomów wykształcenia jest ich już 24, a najrzadsze zapełniają się tygodniami.
Co kwoty naprawiają, a czego nie
Kwoty wyrównują skład próby pod względem zmiennych kwotowych. Jeśli osoby, które zgłosiły się w ramach danej komórki, różnią się od pozostałych osób z tej komórki, obciążenie zostaje. Mercer i in. (2017), korzystając z analogii do wnioskowania przyczynowego, opisują trzy elementy, od których zależy wielkość obciążenia selekcyjnego w próbach nieprobabilistycznych. W praktyce oznacza to, że kwoty pomagają tylko wtedy, gdy zmienne kwotowe rzeczywiście wyjaśniają, kto zgłasza się do badania, i gdy w każdej komórce da się dotrzeć do różnych osób. Baker i in. (2013) w raporcie grupy zadaniowej AAPOR podkreślają, że wnioskowanie z prób nieprobabilistycznych zawsze wymaga założeń modelowych, które trzeba jawnie opisać. Cornesse i in. (2020) dodają, że trafność takich wniosków zależy całkowicie od modeli, podczas gdy zaufanie do prób losowych uzasadnia sama teoria statystyczna.
Dane empiryczne są zgodne z tą teorią. Erens i in. (2014) porównali cztery internetowe panele ochotników z kwotami z badaniem probabilistycznym. Około dwie trzecie kluczowych oszacowań różniło się od wzorca. Rozszerzenie kwot o dodatkowe zmienne nieco poprawiło wyniki u mężczyzn, ale nie u kobiet.
Przykład: stres studentów w trzech sposobach doboru
Symulowana uczelnia liczy 12 000 studentów. Prawdziwy średni stres (PSS-10, 0–40) wynosi 21.80. Studentki i osoby studiujące niestacjonarnie mają wyższy stres. Ankietę rozesłaną w grupach studenckich chętniej wypełniają kobiety i studenci stacjonarni (to składowa związana z kwotami). Rzadziej wypełniają ją osoby najbardziej zestresowane, niezależnie od płci i trybu (to składowa niezwiązana z kwotami). Porównujemy trzy sposoby zebrania 400 osób:
- Dobór wygodny – pierwsze 400 zgłoszeń. W jednej realizacji kobiety stanowiły 70.25%, studenci niestacjonarni 9.50%, a średni stres wyniósł 20.02.
- Dobór kwotowy – kwoty krzyżowe płeć × tryb (75, 168, 55 i 102 osoby), zapełniane pierwszymi zgłoszeniami. Struktura zgadza się z populacją (60.75% kobiet, 32.50% niestacjonarnych), ale średni stres wyniósł 20.58.
- Losowanie z listy studentów: 59.50% kobiet, 32.75% niestacjonarnych, średni stres 21.52.
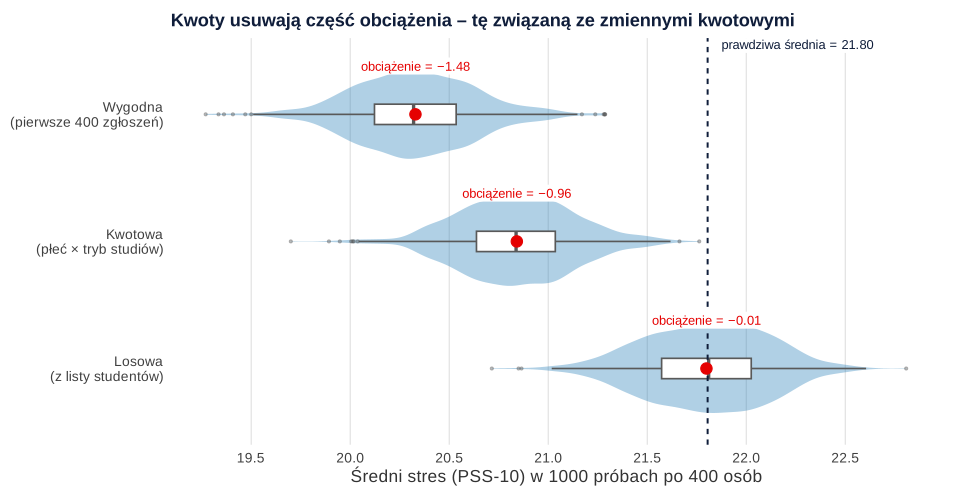
W 1000 powtórzeń dobór wygodny zaniżał średnią średnio o 1.48 punktu, dobór kwotowy – o 0.96, a losowy – o 0.01. Pierwiastek błędu średniokwadratowego (RMSE) wyniósł odpowiednio 1.51, 1.01 i 0.31. Kwoty usunęły tę część obciążenia, która wynikała ze złego składu próby, ale nie tę, która wynikała z samoselekcji w obrębie komórek (rysunek 1). Przy tym próba kwotowa wygląda w tabeli charakterystyki dokładnie jak populacja, co łatwo wziąć za dowód reprezentatywności (zob. wzór charakterystyki próby).
Kiedy dobór kwotowy ma sens
Mimo ograniczeń próba kwotowa bywa rozsądnym wyborem. Sprawdza się, gdy nie ma operatu losowania, a pełna losowość jest nieosiągalna, np. w ankiecie internetowej do pracy dyplomowej. Przydaje się też, gdy celem jest porównanie grup lub sprawdzenie związku, a nie oszacowanie rozpowszechnienia. Wtedy kwoty gwarantują przynajmniej, że każda ważna grupa będzie dostatecznie liczna, np. przy porównaniu studentów stacjonarnych i niestacjonarnych.
Alternatywą lub uzupełnieniem kwot jest ważenie (poststratyfikacja). Zbiera się próbę bez kwot, a potem nadaje respondentom wagi tak, by struktura próby odpowiadała populacji. Ważenie ma te same ograniczenia co kwoty, bo koryguje tylko zmienne użyte do ważenia. Do tego zwiększa błąd standardowy, gdy wagi są bardzo zróżnicowane. W pracy dyplomowej najuczciwiej jest opisać dobór, pokazać strukturę próby obok struktury populacji i w dyskusji wskazać, w których grupach rekrutacja była najtrudniejsza.
Jak opisać dobór kwotowy w pracy
Napisz, skąd wzięto strukturę populacji, jakie zmienne i jakie kwoty zastosowano (brzegowe czy krzyżowe), jak rekrutowano respondentów w ramach kwot i ile osób odrzucono po zapełnieniu kwot. W ograniczeniach wskaż, że kwoty zapewniają zgodność struktury tylko dla wybranych zmiennych. Więcej o rekrutacji w poradnikach gdzie znaleźć respondentów do ankiety i rodzaje badań ankietowych.
Przykład w R
Kod tworzy populację studentów, wyznacza kwoty krzyżowe płeć × tryb studiów, losuje po jednej próbie każdą metodą i powtarza dobór 1000 razy, licząc obciążenie, rozrzut i RMSE oszacowania średniego stresu. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Dobór wygodny, kwotowy i losowy w symulowanej populacji
R
# Dane symulowane: populacja 12 000 studentów uczelni; cel – oszacować średni stres (PSS-10, 0–40).
# Zmienne kwotowe: płeć (K/M) i tryb studiów (stacjonarne/niestacjonarne) – kwoty krzyżowe (4 komórki).
set.seed(197)
N <- 12000
plec <- sample(c("K", "M"), N, replace = TRUE, prob = c(0.60, 0.40))
tryb <- ifelse(runif(N) < ifelse(plec == "K", 0.70, 0.65), "stacjonarne", "niestacjonarne")
stres <- 19 + 2.5 * (plec == "K") + 4 * (tryb == "niestacjonarne") + rnorm(N, 0, 6)
stres <- round(pmin(pmax(stres, 0), 40))
pop <- data.frame(plec, tryb, stres)
round(prop.table(table(pop$plec, pop$tryb)), 3)              # struktura populacji = kwoty
round(mean(pop$stres), 2)                                    # prawdziwa średnia (parametr)

# Skłonność do udziału w ankiecie rozesłanej w grupach studenckich: wyższa u kobiet i studentów stacjonarnych
# (składowa związana z kwotami) ORAZ niższa przy wysokim stresie (składowa niezwiązana z kwotami)
sklonnosc <- plogis(-2.5 + 0.8 * (plec == "K") + 1.6 * (tryb == "stacjonarne") - 0.04 * (stres - 21))

n <- 400
komorka <- paste(pop$plec, pop$tryb)
kwoty <- round(n * prop.table(table(komorka)))              # ile osób zebrać w każdej komórce
kwoty

proba_wygodna <- function() sample(N, n, prob = sklonnosc)                       # pierwsze 400 zgłoszeń
proba_kwotowa <- function() unlist(lapply(names(kwoty), function(k) {           # pierwsze zgłoszenia w każdej komórce
  idx <- which(komorka == k); idx[sample.int(length(idx), kwoty[[k]], prob = sklonnosc[idx])] }))
proba_losowa  <- function() sample(N, n)                                         # losowanie z pełnej listy studentów

# Jedna realizacja każdej metody: struktura próby i średni stres
set.seed(1970)
for (metoda in list(wygodna = proba_wygodna, kwotowa = proba_kwotowa, losowa = proba_losowa)) {
  i <- metoda(); print(round(c(proc_K = 100 * mean(pop$plec[i] == "K"), proc_niestac = 100 * mean(pop$tryb[i] == "niestacjonarne"),
                          sredni_stres = mean(pop$stres[i])), 2))
}

# 1000 powtórzeń: obciążenie i pierwiastek błędu średniokwadratowego (RMSE) oszacowania średniej
wyniki <- sapply(list(wygodna = proba_wygodna, kwotowa = proba_kwotowa, losowa = proba_losowa),
                 function(f) replicate(1000, mean(pop$stres[f()])))
round(rbind(srednia_oszacowan = colMeans(wyniki), obciazenie = colMeans(wyniki) - mean(pop$stres),
            SD = apply(wyniki, 2, sd), RMSE = sqrt(colMeans((wyniki - mean(pop$stres))^2))), 2)
Wynik w R
    niestacjonarne stacjonarne
  K          0.187       0.420
  M          0.138       0.254
[1] 21.8
komorka
K niestacjonarne    K stacjonarne M niestacjonarne    M stacjonarne
              75              168               55              102
      proc_K proc_niestac sredni_stres
       70.25         9.50        20.02
      proc_K proc_niestac sredni_stres
       60.75        32.50        20.58
      proc_K proc_niestac sredni_stres
       59.50        32.75        21.52
                  wygodna kwotowa losowa
srednia_oszacowan   20.33   20.84  21.80
obciazenie          -1.48   -0.96  -0.01
SD                   0.31    0.29   0.31
RMSE                 1.51    1.01   0.31
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Próba kwotowa, więc reprezentatywna”. Zgodność struktury dotyczy tylko zmiennych kwotowych; o reprezentatywności względem badanej cechy nic nie przesądza.
- Kwoty na zmienne niezwiązane z tematem – „bo tak się robi”. Kwoty pomagają tylko wtedy, gdy zmienna wiąże się i z wynikiem, i ze skłonnością do udziału.
- Testowanie zgodności struktury próby z populacją testem chi-kwadrat jako dowód reprezentatywności. Przy kwotach zgodność jest wbudowana w dobór, więc test nic nie mówi.
- Liczenie przedziałów ufności tak jak dla próby losowej bez komentarza. Formalnie wymaga to założenia, że w każdej komórce respondenci są jak losowa próba z tej komórki.
- Brak informacji, kogo odrzucono po zapełnieniu kwot i ile trwało zapełnianie rzadkich komórek – to sygnał, jak bardzo próba różni się od populacji.
- Mylenie doboru kwotowego z warstwowym. Dobór warstwowy też ustala liczebności w kategoriach, ale osoby w warstwach losuje z listy; kwotowy pozostawia wybór respondentom lub ankieterom.
Najczęstsze pytania
Czym różni się próba kwotowa od próby losowej?
W obu można odtworzyć strukturę populacji, ale w próbie losowej konkretne osoby wybiera mechanizm losowania z listy, a w kwotowej – ankieter, panel lub sami zgłaszający się respondenci. Dlatego dla próby losowej znamy prawdopodobieństwa wyboru i możemy oszacować błąd, a dla kwotowej wnioskowanie wymaga dodatkowych założeń.
Czym różni się dobór kwotowy od warstwowego?
Oba dzielą populację na kategorie i ustalają liczebności w każdej z nich. W doborze warstwowym osoby w warstwach losuje się z operatu, więc jest to dobór probabilistyczny. W doborze kwotowym w ramach kategorii zbiera się dowolnych chętnych aż do zapełnienia kwoty.
Czy próba kwotowa jest reprezentatywna?
Tylko pod względem zmiennych, według których ustalono kwoty. Jeśli osoby zgłaszające się w danej kategorii różnią się od reszty tej kategorii w badanej cesze, oszacowania pozostaną obciążone, mimo że tabela charakterystyki próby wygląda jak struktura populacji.
Jakie zmienne wybrać do kwot?
Te, które wiążą się z badaną cechą i jednocześnie ze skłonnością do udziału w badaniu, oraz dla których znasz rzetelną strukturę populacji (np. z GUS lub danych uczelni). Najczęściej są to płeć, wiek, wykształcenie, miejsce zamieszkania, a w badaniach studentów – kierunek i tryb studiów.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dobór nielosowy w obrazkach
Próba wygodna, celowa, kwotowa, kula śnieżna i samoselekcja na mapie fikcyjnej uczelni oraz 1000 badań każdym sposobem – sześć rysunków z R.
Czytaj →PoradnikGdzie znaleźć respondentów do ankiety?
Uczelnia, grupy tematyczne, kula śnieżna, panele i wymiana ankiet – porównanie kanałów, wzór zaproszenia, liczba zaproszeń i opis próby w pracy.
Czytaj →PoradnikRodzaje badań ankietowych
Czas, dobór, kanał i cel badania ankietowego oraz ich konsekwencje dla wniosków – z symulacją autoselekcji w R i wzorem opisu schematu.
Czytaj →PoradnikJak zrobić ankietę do pracy dyplomowej
12 kroków od hipotez do czystych danych: skale, pytania, zgoda, pilotaż, Google Forms czy LimeSurvey, książka kodów, harmonogram i lista kontrolna.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Baker, R., Brick, J. M., Bates, N. A., Battaglia, M., Couper, M. P., Dever, J. A., Gile, K. J., & Tourangeau, R. (2013). Summary report of the AAPOR Task Force on Non-probability Sampling. Journal of Survey Statistics and Methodology, 1(2), 90–143. https://doi.org/10.1093/jssam/smt008
- Cornesse, C., Blom, A. G., Dutwin, D., Krosnick, J. A., De Leeuw, E. D., Legleye, S., Pasek, J., Pennay, D., Phillips, B., Sakshaug, J. W., Struminskaya, B., & Wenz, A. (2020). A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research. Journal of Survey Statistics and Methodology, 8(1), 4–36. https://doi.org/10.1093/jssam/smz041 ● Otwarty dostęp
- Erens, B., Burkill, S., Couper, M. P., Conrad, F., Clifton, S., Tanton, C., Phelps, A., Datta, J., Mercer, C. H., Sonnenberg, P., Prah, P., Mitchell, K. R., Wellings, K., Johnson, A. M., & Copas, A. J. (2014). Nonprobability web surveys to measure sexual behaviors and attitudes in the general population: A comparison with a probability sample interview survey. Journal of Medical Internet Research, 16(12), Article e276. https://doi.org/10.2196/jmir.3382 ● Otwarty dostęp
- Mercer, A. W., Kreuter, F., Keeter, S., & Stuart, E. A. (2017). Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference. Public Opinion Quarterly, 81(S1), 250–271. https://doi.org/10.1093/poq/nfw060 ● Otwarty dostęp
Cytowania BibTeX
@article{baker2013summary, author={Baker, R. and Brick, J. M. and Bates, N. A. and Battaglia, M. and Couper, M. P. and Dever, J. A. and Gile, K. J. and Tourangeau, R.}, title={{Summary report of the AAPOR Task Force on Non-probability Sampling}}, journal={Journal of Survey Statistics and Methodology}, year={2013}, volume={1}, number={2}, pages={90--143}, doi={10.1093/jssam/smt008}}@article{cornesse2020review, author={Cornesse, Carina and Blom, Annelies G. and Dutwin, David and Krosnick, Jon A. and De Leeuw, Edith D. and Legleye, Stéphane and Pasek, Josh and Pennay, Darren and Phillips, Benjamin and Sakshaug, Joseph W. and Struminskaya, Bella and Wenz, Alexander}, title={{A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={1}, pages={4--36}, doi={10.1093/jssam/smz041}}@article{erens2014nonprobability, author={Erens, Bob and Burkill, Sarah and Couper, Mick P. and Conrad, Frederick and Clifton, Soazig and Tanton, Clare and Phelps, Andrew and Datta, Jessica and Mercer, Catherine H. and Sonnenberg, Pam and Prah, Philip and Mitchell, Kirstin R. and Wellings, Kaye and Johnson, Anne M. and Copas, Andrew J.}, title={{Nonprobability web surveys to measure sexual behaviors and attitudes in the general population: A comparison with a probability sample interview survey}}, journal={Journal of Medical Internet Research}, year={2014}, volume={16}, number={12}, eid={e276}, doi={10.2196/jmir.3382}}@article{mercer2017theory, author={Mercer, Andrew W. and Kreuter, Frauke and Keeter, Scott and Stuart, Elizabeth A.}, title={{Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference}}, journal={Public Opinion Quarterly}, year={2017}, volume={81}, number={S1}, pages={250--271}, doi={10.1093/poq/nfw060}}