Co to jest krzywa ROC?
Krzywa ROC (ang. receiver operating characteristic curve) pokazuje, jak dobrze wynik ilościowy – na przykład liczba punktów w kwestionariuszu przesiewowym albo prawdopodobieństwo z modelu – odróżnia osoby z danym stanem od osób bez niego. Na osi pionowej jest czułość, a na poziomej odsetek fałszywych alarmów (1 − swoistość) dla wszystkich możliwych punktów odcięcia. Mandrekar (2010) zwraca uwagę, że gdy wynik testu jest ilościowy lub porządkowy, warto ocenić go w całym zakresie możliwych progów – i to właśnie robi krzywa ROC.
W psychologii krzywą ROC stosuje się przy walidacji krótkich skal przesiewowych względem diagnozy klinicznej (to jeden z dowodów trafności kryterialnej), przy wyznaczaniu progów interpretacyjnych testów i przy ocenie modeli predykcyjnych, np. regresji logistycznej. Jej podsumowaniem jest pole pod krzywą, AUC (ang. area under the curve).
Czułość, swoistość i punkt odcięcia
Każdy punkt odcięcia zamienia wynik ilościowy na decyzję „dodatni/ujemny” i tworzy tabelę 2 × 2 z czterema komórkami: TP (trafnie wykryci), FN (przeoczeni), FP (fałszywe alarmy) i TN (trafnie uznani za zdrowych). Czułość to TP / (TP + FN), a swoistość to TN / (TN + FP); pełny zestaw miar opisuje hasło macierz pomyłek. Rozkłady wyników w obu grupach zwykle na siebie zachodzą, więc obniżenie progu wykrywa więcej osób z zaburzeniem, ale też częściej alarmuje bez potrzeby. FN i FP to odpowiedniki błędów II i I rodzaju.
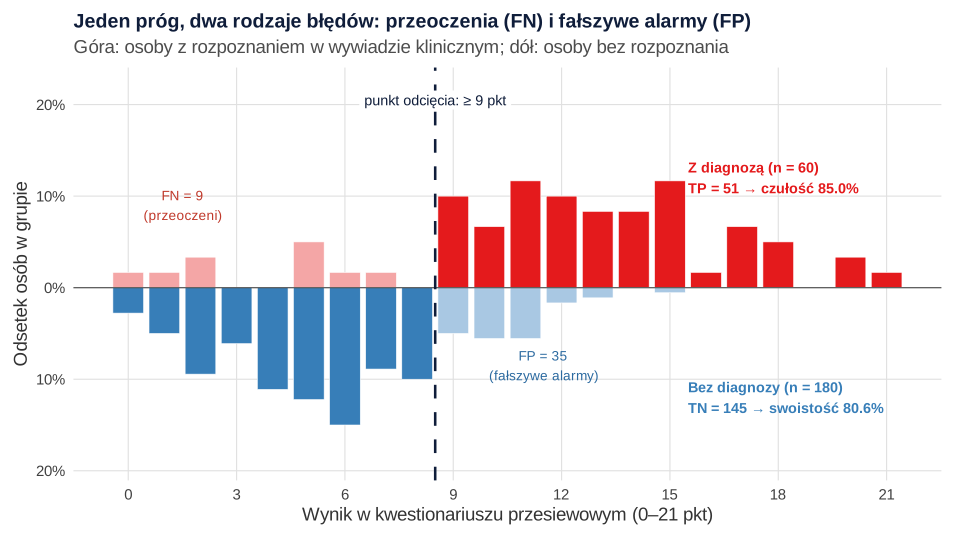
| Wynik dodatni od | TP / FN | FP / TN | Czułość | Swoistość | PPV | NPV |
|---|---|---|---|---|---|---|
| 7 pkt | 52 / 8 | 69 / 111 | 86.7% | 61.7% | 43.0% | 93.3% |
| 9 pkt (indeks Youdena) | 51 / 9 | 35 / 145 | 85.0% | 80.6% | 59.3% | 94.2% |
| 11 pkt | 41 / 19 | 16 / 164 | 68.3% | 91.1% | 71.9% | 89.6% |
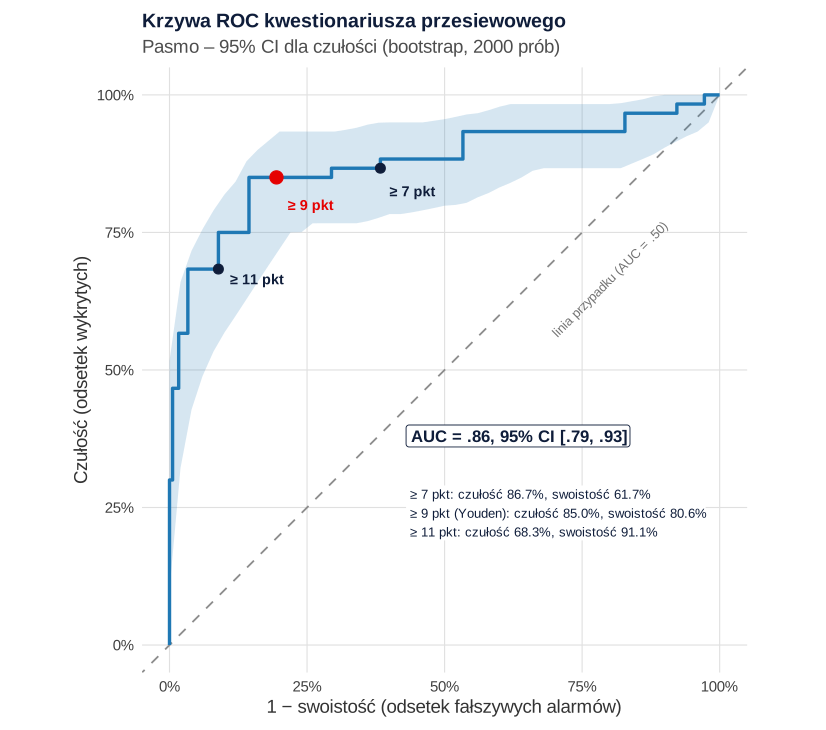
Krzywą ROC dostajesz, łącząc takie pary (1 − swoistość, czułość) dla wszystkich progów: od najniższego, przy którym każdy wynik jest dodatni (punkt w prawym górnym rogu), do najwyższego, przy którym żaden nie jest (lewy dolny róg).
Pole pod krzywą (AUC) – jak je interpretować?
AUC przyjmuje wartości od 0 do 1. Hanley i McNeil (1982) pokazali, że ma prostą interpretację: to prawdopodobieństwo, że losowo wybrana osoba z zaburzeniem uzyska wyższy wynik niż losowo wybrana osoba bez niego. To ta sama wielkość, którą szacuje statystyka Wilcoxona–Manna–Whitneya. AUC = .50 oznacza rozróżnianie na poziomie rzutu monetą (krzywa pokrywa się z przekątną), a AUC = 1 – rozdzielenie idealne.
Nahm (2022) podaje orientacyjną skalę: AUC ≥ .90 – doskonałe, .80–.89 – dobre, .70–.79 – zadowalające, .60–.69 – słabe, .50–.59 – nieprzydatne. Traktuj ją ostrożnie, bo wymagania zależą od zastosowania. Zaletą krzywej ROC jest to, że nie zależy od częstości zaburzenia w próbie (Nahm, 2022). Wadą – że na wykresie nie widać samych progów ani liczebności, a AUC uśrednia także obszary krzywej, z których nikt nie skorzysta, np. progi o swoistości 20%.
Przykład: kwestionariusz przesiewowy a diagnoza kliniczna
240 osób zgłaszających się do poradni (dane symulowane) wypełniło 7-pytaniowy kwestionariusz przesiewowy objawów lękowych (0–21 pkt), a następnie klinicysta, który nie znał wyniku kwestionariusza, przeprowadził ustrukturyzowany wywiad diagnostyczny. Zaburzenie lękowe rozpoznano u 60 osób (25.0%). Osoby z rozpoznaniem miały w kwestionariuszu średnio M = 11.92 pkt (SD = 4.64), a osoby bez rozpoznania – M = 5.84 pkt (SD = 3.12).
Pole pod krzywą wyniosło AUC = .86, 95% CI [.79, .93]. Przedział ufności policzono metodą DeLonga i in. (1988) – nieparametrycznym podejściem opartym na statystykach U, opracowanym do porównywania pól pod krzywymi ROC. Ten sam wynik, .860, daje statystyka Wilcoxona podzielona przez liczbę par (60 × 180): w 86% par „osoba z rozpoznaniem – osoba bez rozpoznania” wynik kwestionariusza był wyższy u tej pierwszej (remisy liczą się po połowie).
Indeks Youdena wskazał próg 9 pkt: czułość 85.0%, 95% CI [73.9%, 91.9%], swoistość 80.6%, 95% CI [74.2%, 85.7%]. Wśród osób z wynikiem dodatnim zaburzenie miało 59.3% (PPV), a wśród osób z wynikiem ujemnym nie miało go 94.2% (NPV). Wartości predykcyjne zależą jednak od częstości zaburzenia: przy tej samej czułości i swoistości, ale częstości 5% (np. w badaniu przesiewowym studentów), PPV spadłoby do 18.7% – ponad cztery na pięć wyników dodatnich byłyby fałszywymi alarmami.
Optymalny punkt odcięcia – indeks Youdena i jego pułapki
Indeks Youdena to J = czułość + swoistość − 1 (w przykładzie J = .656). Fluss i in. (2005) opisują go jako często stosowane podsumowanie krzywej ROC, które jednocześnie mierzy skuteczność markera i pozwala wybrać punkt odcięcia; w ich symulacjach najczęściej używana, empiryczna metoda szacowania (ta sama, której użyliśmy w przykładzie) wypadła jednak najgorzej. Na wykresie to punkt krzywej położony najwyżej nad przekątną. J traktuje przeoczenie i fałszywy alarm jako równie kosztowne, a to rzadko jest prawdą. Nahm (2022) przypomina, że metod wyboru progu jest ponad 30, a wybór powinien zależeć od tego, czy ważniejsza jest czułość (np. gdy przeoczenie przypadku ma poważne skutki), czy swoistość (gdy potwierdzenie diagnozy jest kosztowne lub ryzykowne).
Druga pułapka to optymizm. Próg dobrany do danych daje zawyżone oszacowania czułości i swoistości, zwłaszcza w małych próbach (Leeflang i in., 2008). W symulacji znamy prawdę: w populacji, z której wylosowano osoby, próg 9 pkt ma czułość 80.9% i swoistość 76.2%, a w próbie wyszło 85.0% i 80.6%. Sam próg był w miarę stabilny – w 2000 próbach bootstrapowych indeks Youdena wskazał 9 pkt w 82.6% prób, a 10, 11 lub 12 pkt w pozostałych. Dlatego próg wybieraj z uzasadnieniem merytorycznym, a jego czułość i swoistość sprawdzaj w niezależnej próbie.
Jak opisać krzywą ROC w pracy (APA)
Podaj kryterium (standard referencyjny) i liczebności obu grup, AUC z 95% CI i metodą jego wyznaczenia, sposób wyboru punktu odcięcia oraz czułość i swoistość z przedziałami ufności. Wzór dla przykładu:
Krzywą ROC pokaż na rysunku z przekątną odniesienia i zaznaczonym progiem. Jeśli porównujesz dwa kwestionariusze wypełnione przez te same osoby, podaj test różnicy AUC dla krzywych skorelowanych (metoda DeLonga, w pROC funkcja roc.test()), a nie tylko dwa przedziały ufności.
Przykład w R
Kod tworzy dane z przykładu i w pakiecie pROC liczy krzywą ROC, AUC z przedziałem ufności, próg Youdena, czułość, swoistość i wartości predykcyjne dla trzech progów, a na końcu sprawdza w 2000 próbach bootstrapowych, jak zmienia się „optymalny” próg (obliczenia trwają kilka sekund). W SPSS 29.0.1 i nowszym wybierz Analiza → Klasyfikacja → Analiza ROC (ang. Analyze → Classify → ROC Analysis); starsze okno ROC Curve usunięto w tej wersji. Opis krok po kroku: krzywa ROC w SPSS. Wynik kwestionariusza wpisz jako zmienną testową, diagnozę – jako zmienną stanu z wartością 1, a w opcjach zaznacz linię odniesienia, błąd standardowy z przedziałem ufności i współrzędne punktów krzywej – z nich odczytasz czułość i 1 − swoistość dla kolejnych progów.
Krzywa ROC, AUC i punkt odcięcia w pakiecie pROC
R
# Kwestionariusz przesiewowy lęku (0–21 pkt) a diagnoza z wywiadu klinicznego. Dane symulowane, N = 240
suppressPackageStartupMessages(library(pROC))
set.seed(42)
diagnoza <- c(rep(1, 60), rep(0, 180))                      # 1 = zaburzenie lękowe rozpoznane w wywiadzie
wynik <- pmin(21, pmax(0, round(c(rnorm(60, 12, 4), rnorm(180, 6, 3.5)))))
tapply(wynik, diagnoza, function(x) round(c(M = mean(x), SD = sd(x)), 2))

roc_k <- roc(diagnoza, wynik, levels = c(0, 1), direction = "<", quiet = TRUE)  # wyższy wynik = większe ryzyko
round(as.numeric(ci.auc(roc_k)), 3)       # dolna granica 95% CI, AUC, górna granica (metoda DeLonga)

# AUC = prawdopodobieństwo, że losowa osoba z diagnozą ma wyższy wynik niż losowa osoba bez niej
W <- wilcox.test(wynik[diagnoza == 1], wynik[diagnoza == 0], exact = FALSE)$statistic
round(W / (60 * 180), 3)

# Punkt odcięcia maksymalizujący indeks Youdena J = czułość + swoistość − 1
best <- coords(roc_k, "best", best.method = "youden", ret = c("threshold", "sensitivity", "specificity"))
cbind(best, J = best$sensitivity + best$specificity - 1)

# Trzy progi: 6.5, 8.5 i 10.5 oznaczają wynik dodatni od 7, 9 i 11 pkt
round(coords(roc_k, x = c(6.5, 8.5, 10.5), input = "threshold",
             ret = c("threshold", "tp", "fn", "fp", "tn", "sensitivity", "specificity", "ppv", "npv")), 3)

# 95% CI (Wilsona) dla czułości i swoistości przy wyniku ≥ 9 pkt
round(rbind(czulosc   = prop.test(51, 60, correct = FALSE)$conf.int,
            swoistosc = prop.test(145, 180, correct = FALSE)$conf.int), 3)

# PPV przy tej samej czułości i swoistości, gdy zaburzenie ma 5% osób badanych
se <- 51 / 60; sp <- 145 / 180
round(se * 0.05 / (se * 0.05 + (1 - sp) * 0.95), 3)

# Prawdziwa czułość i swoistość progu ≥ 9 pkt w populacji, z której losowano dane
round(c(czulosc = 1 - pnorm(8.5, 12, 4), swoistosc = pnorm(8.5, 6, 3.5)), 3)

# Jak bardzo „optymalny” próg zależy od próby? 2000 prób bootstrapowych
set.seed(2026)
progi <- replicate(2000, {
  i <- c(sample(which(diagnoza == 1), replace = TRUE), sample(which(diagnoza == 0), replace = TRUE))
  r <- roc(diagnoza[i], wynik[i], levels = c(0, 1), direction = "<", quiet = TRUE)
  coords(r, "best", best.method = "youden", ret = "threshold")$threshold[1]
})
round(prop.table(table(ceiling(progi))), 3)   # od ilu punktów wynik byłby uznany za dodatni
Wynik w R
$`0`
   M   SD
5.84 3.12

$`1`
    M    SD
11.92  4.64

[1] 0.793 0.860 0.926
   W
0.86
  threshold sensitivity specificity         J
1       8.5        0.85   0.8055556 0.6555556
  threshold tp fn fp  tn sensitivity specificity   ppv   npv
1       6.5 52  8 69 111       0.867       0.617 0.430 0.933
2       8.5 51  9 35 145       0.850       0.806 0.593 0.942
3      10.5 41 19 16 164       0.683       0.911 0.719 0.896
           [,1]  [,2]
czulosc   0.739 0.919
swoistosc 0.742 0.857
[1] 0.187
  czulosc swoistosc
    0.809     0.762

    9    10    11    12
0.826 0.071 0.098 0.005
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i pakietu pROC; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Próg wybrany i oceniony na tych samych danych – czułość i swoistość wychodzą zbyt optymistycznie (Leeflang i in., 2008). Sprawdź je w próbie walidacyjnej albo przynajmniej opisz to ograniczenie.
- AUC jako odsetek poprawnych klasyfikacji. AUC = .86 nie znaczy, że test trafnie klasyfikuje 86% osób – to prawdopodobieństwo poprawnego uporządkowania pary osób.
- PPV przeniesione do innej populacji – wartości predykcyjne zależą od częstości zaburzenia; 59.3% w poradni to 18.7% przy częstości 5%.
- Porównywanie dwóch testów „na oko” po nakładaniu się przedziałów ufności zamiast testem dla krzywych skorelowanych (DeLong i in., 1988).
- Odwrócony kierunek – jeśli wyższy wynik oznacza mniejsze ryzyko, ustaw
direction = ">"; AUC wyraźnie poniżej .50 zwykle oznacza błąd w kodowaniu, a nie „antydiagnostyczny” test. - Skażenie kryterium – gdy diagnosta zna wynik kwestionariusza, AUC jest zawyżone (zob. trafność kryterialna).
Najczęstsze pytania
Co to jest krzywa ROC?
To wykres, który dla każdego możliwego punktu odcięcia pokazuje czułość testu (odsetek wykrytych osób z danym stanem) względem odsetka fałszywych alarmów (1 − swoistość). Im bardziej krzywa wybrzusza się w stronę lewego górnego rogu, tym lepiej test odróżnia obie grupy; przekątna oznacza rozróżnianie na poziomie przypadku.
Jak interpretować AUC?
AUC to prawdopodobieństwo, że losowo wybrana osoba z danym stanem ma wyższy wynik niż losowo wybrana osoba bez niego (Hanley i McNeil, 1982). AUC = .50 to poziom przypadku, a AUC = 1 – idealne rozróżnianie. Według orientacyjnej skali Nahma (2022) wartości .80–.89 oznaczają dobre, a ≥ .90 – doskonałe rozróżnianie.
Jakie AUC jest dobre?
Nie ma jednej granicy, bo wymagania zależą od zastosowania – inne są dla wstępnego badania przesiewowego, a inne dla decyzji o leczeniu. Jako orientację często podaje się, że AUC ≥ .80 jest akceptowalne, a ≥ .90 doskonałe (Nahm, 2022). Zawsze podawaj 95% przedział ufności, bo w małych próbach AUC jest mało precyzyjne.
Jak wyznaczyć punkt odcięcia z krzywej ROC?
Najczęściej wybiera się próg maksymalizujący indeks Youdena J = czułość + swoistość − 1. Zakłada on jednak, że przeoczenie i fałszywy alarm są równie kosztowne; gdy ważniejsza jest czułość (np. w badaniu przesiewowym), wybiera się niższy próg. Czułość i swoistość wybranego progu sprawdź w niezależnej próbie, bo na danych, na których go wybrano, są zawyżone.
Czy AUC zależy od częstości zaburzenia?
Krzywa ROC i AUC nie zależą od częstości (prewalencji) zaburzenia w próbie, bo opierają się na czułości i swoistości. Zależą od niej natomiast wartości predykcyjne: w przykładzie z tego hasła PPV wynosiło 59.3% przy częstości 25%, a przy częstości 5% spadłoby do 18.7%.
Jak zrobić krzywą ROC w SPSS i R?
W SPSS 29.0.1 i nowszym: Analiza → Klasyfikacja → Analiza ROC (krok po kroku: krzywa ROC w SPSS); wynik testu to zmienna testowa, a diagnoza – zmienna stanu z wartością oznaczającą obecność stanu. W R użyj pakietu pROC: roc(diagnoza, wynik), ci.auc() dla przedziału ufności i coords(..., "best") dla progu Youdena.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Krzywa ROC w obrazkach
Dwa rozkłady i próg, punkty na krzywej, AUC jako odsetek wygranych par, d a kształt krzywej, Youden i koszty, CI dla AUC – sześć rysunków z R.
Czytaj →PoradnikModele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikStatystyka dla psychologa
Analizy w pracy dyplomowej z psychologii: typowe projekty, wynik kwestionariusza, alfa i omega, normy i steny, eksperyment i raport APA – z danymi i kodem R.
Czytaj →PoradnikKrzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- Fluss, R., Faraggi, D., & Reiser, B. (2005). Estimation of the Youden index and its associated cutoff point. Biometrical Journal, 47(4), 458–472. https://doi.org/10.1002/bimj.200410135
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- Leeflang, M. M. G., Moons, K. G. M., Reitsma, J. B., & Zwinderman, A. H. (2008). Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions. Clinical Chemistry, 54(4), 729–737. https://doi.org/10.1373/clinchem.2007.096032
- Mandrekar, J. N. (2010). Receiver operating characteristic curve in diagnostic test assessment. Journal of Thoracic Oncology, 5(9), 1315–1316. https://doi.org/10.1097/jto.0b013e3181ec173d ● Otwarty dostęp
- Nahm, F. S. (2022). Receiver operating characteristic curve: Overview and practical use for clinicians. Korean Journal of Anesthesiology, 75(1), 25–36. https://doi.org/10.4097/kja.21209 ● Otwarty dostęp
Cytowania BibTeX
@article{delong1988comparing, author={DeLong, Elizabeth R. and DeLong, David M. and Clarke-Pearson, Daniel L.}, title={{Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach}}, journal={Biometrics}, year={1988}, volume={44}, number={3}, pages={837--845}, doi={10.2307/2531595}}@article{fluss2005estimation, author={Fluss, Ronen and Faraggi, David and Reiser, Benjamin}, title={{Estimation of the Youden index and its associated cutoff point}}, journal={Biometrical Journal}, year={2005}, volume={47}, number={4}, pages={458--472}, doi={10.1002/bimj.200410135}}@article{hanley1982meaning, author={Hanley, James A. and McNeil, Barbara J.}, title={{The meaning and use of the area under a receiver operating characteristic (ROC) curve}}, journal={Radiology}, year={1982}, volume={143}, number={1}, pages={29--36}, doi={10.1148/radiology.143.1.7063747}}@article{leeflang2008bias, author={Leeflang, Mariska M. G. and Moons, Karel G. M. and Reitsma, Johannes B. and Zwinderman, Aeilko H.}, title={{Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions}}, journal={Clinical Chemistry}, year={2008}, volume={54}, number={4}, pages={729--737}, doi={10.1373/clinchem.2007.096032}}@article{mandrekar2010receiver, author={Mandrekar, Jayawant N.}, title={{Receiver operating characteristic curve in diagnostic test assessment}}, journal={Journal of Thoracic Oncology}, year={2010}, volume={5}, number={9}, pages={1315--1316}, doi={10.1097/jto.0b013e3181ec173d}}@article{nahm2022receiver, author={Nahm, Francis Sahngun}, title={{Receiver operating characteristic curve: Overview and practical use for clinicians}}, journal={Korean Journal of Anesthesiology}, year={2022}, volume={75}, number={1}, pages={25--36}, doi={10.4097/kja.21209}}