Co to jest kurtoza?
Kurtoza (ang. kurtosis) to miara ciężkości ogonów rozkładu. Mówi, jak często pojawiają się wyniki bardzo odległe od średniej w porównaniu z rozkładem normalnym. Westfall (2014) podkreśla, że jej jedyna jednoznaczna interpretacja dotyczy właśnie ogonów: w próbie – obecności wartości odstających, a w rozkładzie teoretycznym – skłonności do ich generowania.
Rozkład normalny ma kurtozę równą 3, dlatego programy takie jak SPSS podają zwykle kurtozę nadmiarową (ang. excess kurtosis), pomniejszoną o 3 – dla rozkładu normalnego wynosi ona 0 (Kim, 2013). Rozkład o dodatniej kurtozie nadmiarowej nazywa się leptokurtycznym (ciężkie ogony, więcej wyników skrajnych), a o ujemnej – platykurtycznym (lekkie ogony). Kurtozę podaje się razem ze skośnością, która opisuje asymetrię. W danych psychologicznych bywa wysoka: Blanca i in. (2013) w 693 rozkładach z małych prób odnotowali kurtozę od −1.92 do 7.41.
Kurtoza to nie „spiczastość”
Wiele podręczników opisuje kurtozę jako miarę „spiczastości” rozkładu – tak definiuje ją np. Kim (2013). DeCarlo (1997) zwraca uwagę, że podręczniki często opisują kurtozę niepełnie lub błędnie: w rozkładach symetrycznych i jednomodalnych dodatnia kurtoza oznacza ciężkie ogony i wysmuklenie, a ujemna – lekkie ogony i spłaszczenie względem rozkładu normalnego. Westfall (2014) idzie dalej: kurtoza nie mówi praktycznie nic o kształcie szczytu, a obszar μ ± σ odpowiada zwykle za bardzo małą część jej wartości.
Łatwo to sprawdzić. W rozkładzie normalnym wyniki z przedziału ±1 odchylenia standardowego to 68% obserwacji, ale wnoszą one tylko 3.7% wartości kurtozy – resztę tworzą ogony. Rozkład trójkątny ma ostry szczyt, a mimo to jego kurtoza nadmiarowa wynosi −0.6, bo jego ogony są krótkie.
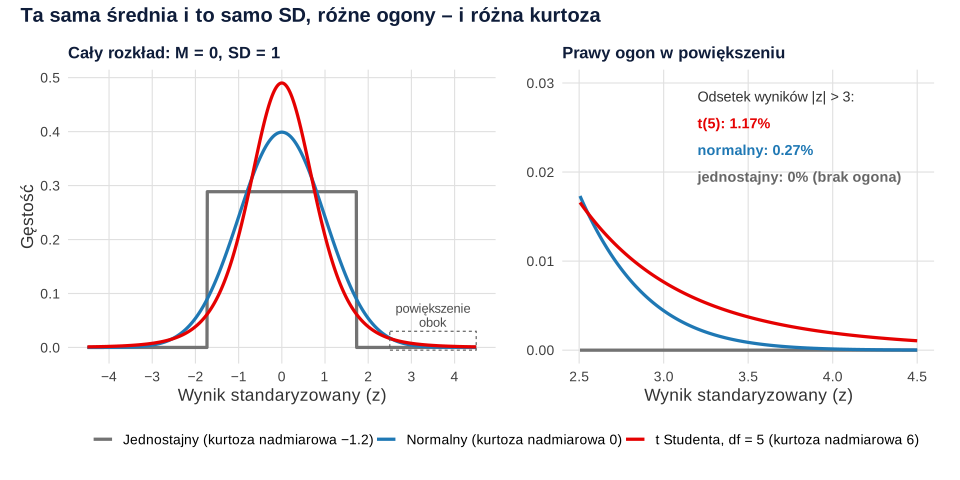
Trzy rozkłady na rysunku 1 mają tę samą średnią i to samo odchylenie standardowe, a różnią się ogonami. Wyniki odległe od średniej o ponad 3 SD zdarzają się w rozkładzie t(5) ponad czterokrotnie częściej niż w normalnym (1.17% wobec 0.27%), a o ponad 4 SD – 56 razy częściej (0.36% wobec 0.0063%). Rozkład jednostajny nie ma ogonów wcale. To właśnie mierzy kurtoza.
Wzór na kurtozę i kurtozę nadmiarową
kurtoza nadmiarowa: g2 = b2 − 3
m4 to średnia z czwartych potęg odchyleń od średniej, a m2 – wariancja (z mianownikiem n). Czwarta potęga sprawia, że wynik odległy o 4 SD wnosi do sumy 256 razy więcej niż wynik odległy o 1 SD – stąd ogromna wrażliwość kurtozy na pojedyncze skrajne wartości.
SPSS i Excel (funkcja KURTOZA) podają estymator skorygowany o liczebność próby: G2 = [(n + 1)g2 + 6] × (n − 1) / [(n − 2)(n − 3)]. W R ten sam wynik daje psych::kurtosi(x, type = 2), a psych::describe() domyślnie stosuje inny wariant. Joanes i Gill (1998) pokazali, że różne pakiety statystyczne korzystają z różnych estymatorów, dlatego w pracy podaj program i zaznacz, że chodzi o kurtozę nadmiarową. Błąd standardowy kurtozy to SEK = 2 × SES × √[(n² − 1) / ((n − 3)(n + 5))], gdzie SES jest błędem standardowym skośności; dla n = 200 wynosi 0.34, a dla n = 20 – aż 0.99.
Przykład: zmiana objawów po programie terapeutycznym
Dwieście osób wypełniło skalę depresji przed ośmiotygodniowym programem i po nim (dane symulowane). Analizujemy zmianę wyniku (po − przed). U większości osób objawy zmieniły się o kilka punktów, ale u nielicznych – bardzo mocno, w obie strony. Rozkład jest symetryczny (skośność = −0.08), średnia zmiana wynosi M = −1.06 (SD = 4.15), a kurtoza nadmiarowa – 5.24 (SE = 0.34).
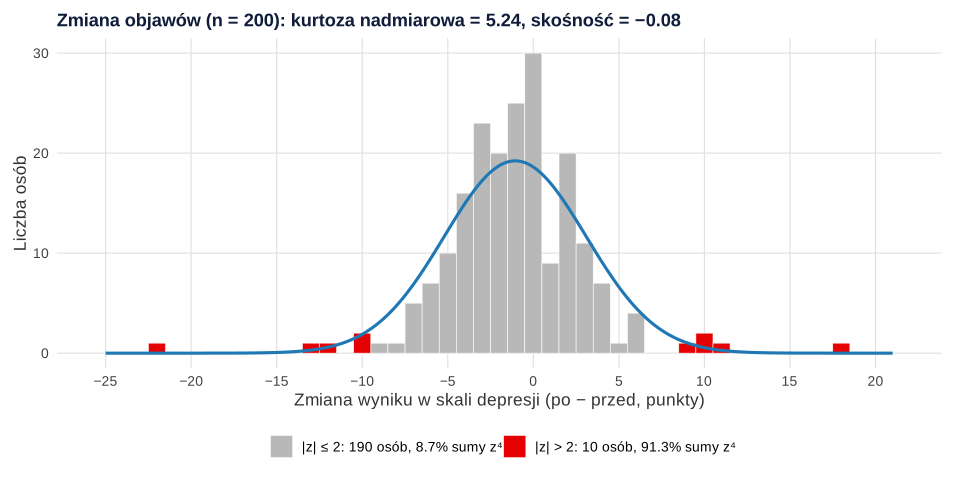
Rysunek 2 pokazuje, skąd bierze się ta wartość. Dziesięć osób (5%) z wynikami odległymi od średniej o ponad 2 SD odpowiada za 91.3% sumy z4, z której liczy się kurtozę. 164 osoby (82%) z wynikami w przedziale ±1 SD wnoszą zaledwie 1.9%. Wyniki odległe od średniej o ponad 3 SD ma 1.0% osób – prawie cztery razy więcej niż 0.27% oczekiwane w rozkładzie normalnym (por. reguła trzech sigm).
Według reguł Kima (2013) dla prób od 50 do 300 osób wartość z = 15.31 wyraźnie przekracza próg 3.29. Spełnione jest też kryterium dla dużych prób: kurtoza niepomniejszona o 3 wynosi 8.08, a Kim za znaczne odejście od normalności uznaje wartość powyżej 7 (czyli kurtozę nadmiarową powyżej 4). Ciężkie ogony to tu informacja, a nie błąd – mogą wskazywać na osoby, które zareagowały na program wyjątkowo dobrze albo wyjątkowo źle.
Kiedy kurtoza ma znaczenie?
DeCarlo (1997) omawia rolę kurtozy w testowaniu normalności, odporności metod statystycznych i wykrywaniu obserwacji odstających. W praktyce zwróć na nią uwagę w czterech sytuacjach:
- Opis danych i obserwacje odstające. Wyniki skrajne zawyżają odchylenie standardowe: w przykładzie SD = 4.15, a odporne medianowe odchylenie bezwzględne MAD = 2.97. Pojedyncze przypadki zobaczysz na wykresie pudełkowym; decyzję podejmij według reguł dla obserwacji odstających. W ankietach źródłem ciężkich ogonów bywają też nieuważne odpowiedzi.
- Porównywanie wariancji – testy równości wariancji są na kurtozę szczególnie wrażliwe (tabela niżej).
- Reszty modelu. Ciężkie ogony reszt widać na wykresie kwantylowym Q-Q jako kształt litery S.
- Modele równań strukturalnych – kurtoza wpływa na wybór estymatora (zob. MLR).
Symulacja w R: 10 000 razy losowaliśmy dwie grupy po 30 osób z tego samego rozkładu. Wariancje w populacji były równe, więc każdy istotny wynik to fałszywy alarm – przy α = .05 powinno ich być około 5%.
| Rozkład (kurtoza nadmiarowa) | Test F dla dwóch wariancji | Test Levene’a (od średniej) | Test Brown–Forsythe’a (od mediany) |
|---|---|---|---|
| Jednostajny (−1.2) | 0.4% | 5.2% | 3.5% |
| Normalny (0) | 5.3% | 5.3% | 4.3% |
| t z 5 stopniami swobody (6) | 17.9% | 5.6% | 4.4% |
Klasyczny test F działa poprawnie tylko przy rozkładzie normalnym: przy ciężkich ogonach daje 17.9% fałszywych alarmów, a przy lekkich staje się nadmiernie zachowawczy. Testy oparte na odchyleniach bezwzględnych trzymają się poziomu 5%. Brown i Forsythe (1974) pokazali, że wersje statystyki Levene’a, w których średnią zastąpiono odporniejszą miarą położenia, np. medianą, są odporne na nienormalność. Do sprawdzania homogeniczności wariancji używaj więc testu Levene’a (najlepiej w wersji z medianą), a nie testu F.
Jak opisać kurtozę w pracy (APA)
Kurtozę podaje się razem ze skośnością w tabeli statystyk opisowych. Zawsze zaznacz, że chodzi o kurtozę nadmiarową. Przykładowy opis wyniku z przykładu:
Przykład w R
Kod odtwarza dane z przykładu i liczy kurtozę nadmiarową, jej błąd standardowy, wartość z oraz udział ogonów i środka rozkładu w sumie z4. W SPSS kurtozę nadmiarową z błędem standardowym dają Analiza → Opis statystyczny → Statystyki opisowe → Opcje („Kurtoza”).
Kurtoza, jej błąd standardowy i źródło jej wartości
R
library(psych)
set.seed(4)
n <- 200
podgrupa <- rbinom(n, 1, 0.07)        # nieliczne osoby z dużą zmianą w obie strony
zmiana <- round(ifelse(podgrupa == 1, rnorm(n, -1, 11), rnorm(n, -1, 3)))

# kurtoza nadmiarowa (0 = rozkład normalny); type = 2 – estymator jak w SPSS i Excelu
round(describe(zmiana, type = 2)[, c("n", "mean", "sd", "skew", "kurtosis")], 2)

# błąd standardowy kurtozy (wzór jak w SPSS) i wartość z
se_skos <- function(n) sqrt(6 * n * (n - 1) / ((n - 2) * (n + 1) * (n + 3)))
se_kurt <- function(n) 2 * se_skos(n) * sqrt((n^2 - 1) / ((n - 3) * (n + 5)))
round(c(SE = se_kurt(n), z = kurtosi(zmiana, type = 2) / se_kurt(n)), 2)

# skąd bierze się kurtoza? udział ogonów i środka rozkładu w sumie z^4 (%)
z <- as.numeric(scale(zmiana))
round(100 * c(ogony = sum(z[abs(z) > 2]^4), srodek = sum(z[abs(z) < 1]^4)) / sum(z^4), 1)
table(abs(z) > 2)
Wynik w R
     n  mean   sd  skew kurtosis
X1 200 -1.06 4.15 -0.08     5.24
   SE     z
 0.34 15.31
 ogony srodek
  91.3    1.9

FALSE  TRUE
  190    10
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (symulację testów wariancji wykonano funkcjami var.test() i t.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Interpretowanie kurtozy jako „spiczastości” – wysoki lub ostry szczyt nie oznacza dużej kurtozy; liczą się ogony (Westfall, 2014).
- Mylenie kurtozy nadmiarowej z kurtozą niepomniejszoną o 3 – rozkład normalny ma odpowiednio 0 albo 3, a progi z literatury (np. 7 u Kima) odnoszą się do konkretnej wersji.
- Wnioski z kurtozy w małej próbie – w 10 000 próbach po 20 osób z rozkładu normalnego 95% wartości kurtozy nadmiarowej mieściło się między −1.27 a 2.48.
- Usuwanie skrajnych wyników, by „poprawić” kurtozę – kurtozę tworzą właśnie te wyniki, a często niosą one najważniejszą informację.
- Test F do porównania wariancji przy ciężkich ogonach – w symulacji dawał 17.9% fałszywych alarmów zamiast 5%.
Najczęstsze pytania
Co oznacza kurtoza dodatnia?
Dodatnia kurtoza nadmiarowa (rozkład leptokurtyczny) oznacza, że ogony rozkładu są cięższe niż w rozkładzie normalnym: wyniki bardzo odległe od średniej zdarzają się częściej, niż przewiduje krzywa normalna. Często wskazuje to na obserwacje odstające albo podgrupę osób o nietypowych wynikach.
Co to jest kurtoza nadmiarowa?
To kurtoza pomniejszona o 3, czyli o kurtozę rozkładu normalnego. Dzięki temu rozkład normalny ma kurtozę nadmiarową 0, wartości dodatnie oznaczają cięższe ogony, a ujemne – lżejsze. SPSS i Excel podają właśnie kurtozę nadmiarową.
Jaka kurtoza jest dopuszczalna?
Nie ma jednego progu. Kim (2013) proponuje dzielić kurtozę przez jej błąd standardowy i przy n < 50 traktować jako istotne odchylenie |z| > 1.96, a przy n od 50 do 300 – |z| > 3.29. W większych próbach jako znaczne odejście od normalności traktuje kurtozę niepomniejszoną o 3 powyżej 7, czyli kurtozę nadmiarową powyżej 4.
Czy kurtoza mierzy spiczastość rozkładu?
Nie – to popularne, ale błędne uproszczenie. Westfall (2014) pokazuje, że kurtoza nie mówi praktycznie nic o kształcie szczytu, tylko o ogonach, czyli skłonności do wyników skrajnych. Rozkład trójkątny ma ostry szczyt, a mimo to ujemną kurtozę nadmiarową (−0.6).
Jak obliczyć kurtozę w SPSS, Excelu i R?
W SPSS: Analiza → Opis statystyczny → Statystyki opisowe → Opcje → Kurtoza. W Excelu: funkcja KURTOZA. W R: psych::kurtosi(x, type = 2). Wszystkie trzy dają ten sam estymator kurtozy nadmiarowej (0 dla rozkładu normalnego).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyki opisowe w pracy
Co policzyć dla jakiej zmiennej, jak zbudować tabelę APA, ile miejsc po przecinku podać, jak pokazać braki danych i które wykresy wybrać – na jednym przykładzie z R.
Czytaj →PoradnikNieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikStatystyka do pracy magisterskiej
Plan analiz, CFA i omega, regresja hierarchiczna, moderacja i mediacja z bootstrapem, wzory opisu APA i pytania na obronie – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Blanca, M. J., Arnau, J., López-Montiel, D., Bono, R., & Bendayan, R. (2013). Skewness and kurtosis in real data samples. Methodology, 9(2), 78–84. https://doi.org/10.1027/1614-2241/a000057
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- DeCarlo, L. T. (1997). On the meaning and use of kurtosis. Psychological Methods, 2(3), 292–307. https://doi.org/10.1037/1082-989X.2.3.292
- Joanes, D. N., & Gill, C. A. (1998). Comparing measures of sample skewness and kurtosis. Journal of the Royal Statistical Society: Series D (The Statistician), 47(1), 183–189. https://doi.org/10.1111/1467-9884.00122
- Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52–54. https://doi.org/10.5395/rde.2013.38.1.52 ● Otwarty dostęp
- Westfall, P. H. (2014). Kurtosis as peakedness, 1905–2014. R.I.P. The American Statistician, 68(3), 191–195. https://doi.org/10.1080/00031305.2014.917055 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{blanca2013skewness, author={Blanca, María J. and Arnau, Jaume and López-Montiel, Dolores and Bono, Roser and Bendayan, Rebecca}, title={{Skewness and kurtosis in real data samples}}, journal={Methodology}, year={2013}, volume={9}, number={2}, pages={78--84}, doi={10.1027/1614-2241/a000057}}@article{brown1974robust, author={Brown, Morton B. and Forsythe, Alan B.}, title={{Robust tests for the equality of variances}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={346}, pages={364--367}, doi={10.1080/01621459.1974.10482955}}@article{decarlo1997meaning, author={DeCarlo, Lawrence T.}, title={{On the meaning and use of kurtosis}}, journal={Psychological Methods}, year={1997}, volume={2}, number={3}, pages={292--307}, doi={10.1037/1082-989x.2.3.292}}@article{joanes1998comparing, author={Joanes, D. N. and Gill, C. A.}, title={{Comparing measures of sample skewness and kurtosis}}, journal={Journal of the Royal Statistical Society: Series D (The Statistician)}, year={1998}, volume={47}, number={1}, pages={183--189}, doi={10.1111/1467-9884.00122}}@article{kim2013assessing, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis}}, journal={Restorative Dentistry \& Endodontics}, year={2013}, volume={38}, number={1}, pages={52--54}, doi={10.5395/rde.2013.38.1.52}}@article{westfall2014kurtosis, author={Westfall, Peter H.}, title={{Kurtosis as peakedness, 1905–2014. R.I.P.}}, journal={The American Statistician}, year={2014}, volume={68}, number={3}, pages={191--195}, doi={10.1080/00031305.2014.917055}}