Co to jest wykres pudełkowy?
Wykres pudełkowy (ang. box plot, box-and-whisker plot; w polskiej wersji SPSS – wykres skrzynkowy) streszcza rozkład zmiennej ilościowej za pomocą mediany, dwóch kwartyli i dwóch „wąsów”, a do tego pokazuje pojedyncze obserwacje odstające. Wywodzi się z eksploracyjnej analizy danych, którą upowszechnił Tukey (1977). Williamson i in. (1989) opisują go jako prostą metodę pokazującą położenie, rozproszenie i symetrię rozkładu, którą łatwo rozbudować o identyfikację wartości odstających.
Wykres pudełkowy opiera się na medianie i kwartylach, więc pojedyncze skrajne wyniki nie zmieniają kształtu pudełka. Dobrze sprawdza się zwłaszcza przy porównywaniu kilku grup – zamiast wykresu słupkowego ze średnimi, który według przeglądu Weissgerber i in. (2015) dominuje w publikacjach, choć dla bardzo różnych rozkładów może wyglądać identycznie.
Z czego składa się wykres pudełkowy
- linia w pudełku – mediana, czyli wynik środkowy;
- dolna i górna krawędź pudełka – pierwszy i trzeci kwartyl (Q1 i Q3): poniżej Q1 leży 25% wyników, poniżej Q3 – 75%;
- wysokość pudełka – rozstęp ćwiartkowy IQR = Q3 − Q1, czyli środkowe 50% wyników;
- wąsy – w wersji Tukeya sięgają do najbardziej skrajnego wyniku, który leży nie dalej niż 1.5 × IQR od krawędzi pudełka (Krzywinski i Altman, 2014);
- punkty poza wąsami – obserwacje odstające.
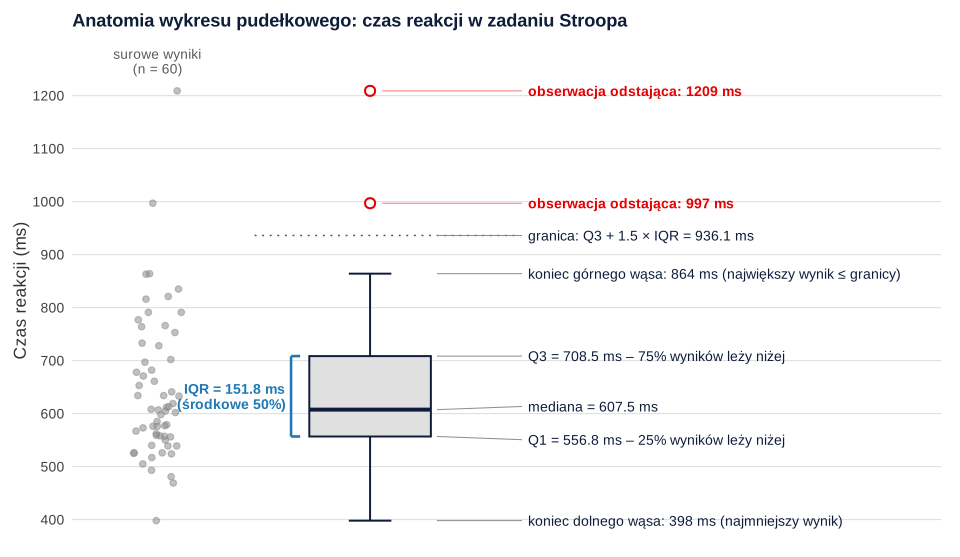
W przykładzie z rysunku 1 IQR wynosi 708.5 − 556.8 = 151.8 ms, więc górna granica dla wąsa to 708.5 + 1.5 × 151.8 = 936.1 ms. Największy wynik poniżej tej granicy (864 ms) wyznacza koniec górnego wąsa, a dwa wyniki powyżej niej (997 i 1209 ms) zaznaczono jako odstające. Dolny wąs kończy się na najmniejszym wyniku (398 ms), bo dolna granica (329.1 ms) leży poniżej wszystkich danych. Ghasemi i Zahediasl (2012) opisują także drugi próg: wyniki odległe od pudełka o ponad 3 × IQR traktuje się jako skrajnie odstające (SPSS oznacza je gwiazdką).
Wykres zdradza też kształt rozkładu. Mediana leży bliżej dolnej krawędzi pudełka (50.8 ms od Q1, 101 ms od Q3), a górny wąs jest dłuższy od dolnego – to obraz prawostronnej skośności, typowej dla czasów reakcji. Wykres pudełkowy ma sens od około 5 obserwacji, a ponieważ programy liczą kwartyle różnymi metodami, w podpisie podaj liczebność i sposób konstrukcji wykresu (Krzywinski i Altman, 2014).
Jak czytać wykres pudełkowy przy porównaniu grup
Przykład (dane symulowane): po ośmiu tygodniach zmierzono stres (PSS-10, 0–40 pkt) w trzech grupach po 40 osób – kontrolnej, treningu uważności i psychoedukacji. Rysunek 2 łączy pudełka z surowymi wynikami i średnią, tak jak robi to aplikacja SZTOS.
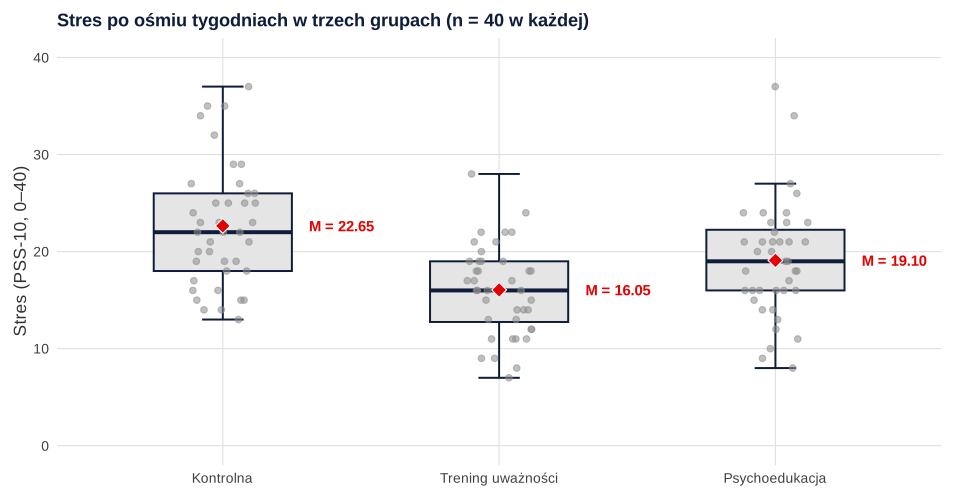
- Porównaj mediany. Najniższa jest w grupie treningu uważności (16 pkt), najwyższa w kontrolnej (22 pkt); psychoedukacja leży pośrodku (19 pkt).
- Porównaj wysokość pudełek. Rozproszenie środkowych 50% wyników jest podobne: IQR = 8.00 w grupie kontrolnej i 6.25 w dwóch pozostałych.
- Sprawdź nakładanie się pudełek. Pudełka grupy kontrolnej (18–26) i uważności (12.75–19) zachodzą na siebie tylko w wąskim zakresie, co sugeruje wyraźną różnicę.
- Odszukaj obserwacje odstające. W psychoedukacji dwie osoby mają 34 i 37 punktów, czyli więcej niż granica Q3 + 1.5 × IQR = 31.6, dlatego wąs kończy się na 27 punktach.
- Porównaj średnią z medianą. Gdy różnią się wyraźnie, rozkład jest skośny lub zawiera wyniki skrajne.
Wykres pudełkowy nie jest testem statystycznym. O istotności różnic zdecyduje analiza wariancji (zob. ANOVA krok po kroku) albo test Kruskala-Wallisa, a wykres pomoże ocenić założenia i opisać wynik.
Pułapka: te same pudełka, zupełnie inne dane
Pięć liczb to wciąż streszczenie, które może ukryć ważne cechy rozkładu. Na rysunku 3 dwie grupy po 100 osób mają prawie identyczne pudełka: wąsy od 29.7 do 68.4, Q1 = 42.4, mediany 49.2 i 48.8, Q3 = 55.5 i 55.6. Dopiero surowe wyniki i krzywa gęstości pokazują, że w grupie B są dwa skupienia, a środek skali jest prawie pusty: w odległości do 3 punktów od mediany znalazły się 24 wyniki z grupy A i tylko 7 z grupy B.
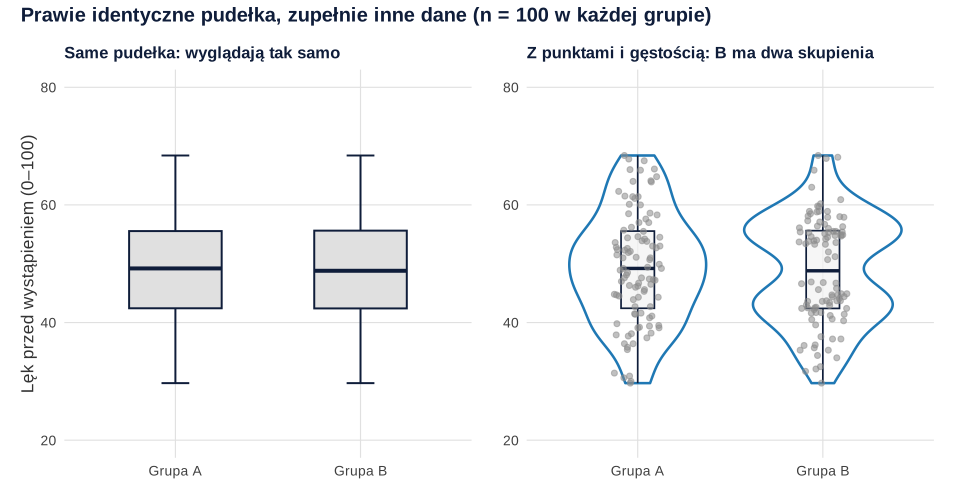
Taki rozkład dwumodalny może oznaczać dwie podgrupy, np. osoby z doświadczeniem wystąpień i bez niego. Dlatego przy kilkudziesięciu czy kilkuset obserwacjach na grupę dodawaj do pudełek surowe wyniki, a rozkład w każdej grupie sprawdzaj także na histogramie albo wykresie kwantylowym Q-Q.
Odmiany wykresu pudełkowego
Nuzzo (2016) omawia warianty wykresu pudełkowego, które dostarczają dodatkowych informacji. Najprzydatniejsze w pracy dyplomowej:
- pudełko z punktami (rozrzuconymi losowo w poziomie, tzw. jitter) – pokazuje liczebność i każdy wynik;
- wykres skrzypcowy z wąskim pudełkiem w środku – dodaje krzywą gęstości, więc ujawnia kilka szczytów (rysunek 3);
- pudełko z wcięciem (notched box plot) – wcięcie to przybliżony 95% przedział ufności dla mediany, w R: mediana ± 1.58 × IQR / √n; w przykładzie z rysunku 2 to 20.00–24.00 dla grupy kontrolnej i 14.44–17.56 dla treningu uważności, a wcięcia, które się nie nakładają, są przesłanką różnicy median;
- pudełko ze średnią – czerwony romb pozwala porównać średnią z medianą (rysunek 2).
Jak opisać wykres pudełkowy w pracy (APA)
Podpis musi wyjaśniać, co oznaczają pudełko, wąsy i punkty, oraz podawać liczebność. Przykładowy podpis do rysunku 2:
W tekście dodaj liczby, których nie da się odczytać dokładnie z wykresu, np.: „Najniższy poziom stresu wystąpił w grupie treningu uważności (Me = 16.00, IQR = 6.25), a najwyższy w grupie kontrolnej (Me = 22.00, IQR = 8.00)”. Gdy porównujesz grupy testem, podaj też jego wynik (gotowe zdania znajdziesz w poradniku jak opisać wyniki w stylu APA).
Przykład w R
Kod odtwarza dane z rysunku 2, wypisuje pięć liczb w każdej grupie, znajduje obserwacje odstające według reguły 1.5 × IQR i rysuje pudełka z surowymi wynikami oraz średnimi. W SPSS wykresy skrzynkowe dla grup otrzymasz w menu Analiza → Opis statystyczny → Eksploracja (grupę wpisz jako czynnik).
Pięć liczb, obserwacje odstające i wykres w ggplot2
R
library(ggplot2)
set.seed(7)
grupy <- data.frame(
  grupa = factor(rep(c("Kontrolna", "Trening uważności", "Psychoedukacja"), each = 40),
                 levels = c("Kontrolna", "Trening uważności", "Psychoedukacja")),
  stres = c(round(rnorm(40, 21, 6)), round(rnorm(40, 15.5, 5)), round(rnorm(38, 18, 5.5)), 34, 37))
grupy$stres <- pmin(pmax(grupy$stres, 0), 40)        # skala PSS-10: 0–40 pkt

# pięć liczb wykresu pudełkowego w każdej grupie (kwartyle jak w ggplot2)
aggregate(stres ~ grupa, data = grupy, FUN = quantile)

# obserwacje odstające według reguły 1.5 × IQR
odstajace <- function(x) {
  q <- quantile(x, c(.25, .75)); g <- 1.5 * (q[2] - q[1])
  x[x < q[1] - g | x > q[2] + g]
}
tapply(grupy$stres, grupy$grupa, odstajace)

# wykres: pudełka + surowe wyniki + średnia (czerwony romb)
ggplot(grupy, aes(grupa, stres)) +
  geom_boxplot(width = 0.5, outlier.shape = NA) +      # punkty pokaże geom_jitter
  geom_jitter(width = 0.12, height = 0, alpha = 0.5, colour = "grey45") +
  stat_summary(fun = mean, geom = "point", shape = 23, size = 3.5, fill = "#e50101") +
  labs(x = NULL, y = "Stres (PSS-10, 0–40)") +
  theme_minimal(base_size = 13)
Wynik w R
              grupa stres.0% stres.25% stres.50% stres.75% stres.100%
1         Kontrolna    13.00     18.00     22.00     26.00      37.00
2 Trening uważności     7.00     12.75     16.00     19.00      28.00
3    Psychoedukacja     8.00     16.00     19.00     22.25      37.00
$Kontrolna
numeric(0)

$`Trening uważności`
numeric(0)

$Psychoedukacja
[1] 34 37
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Same pudełka bez surowych danych – ukrywają liczebność i kształt rozkładu, np. dwa skupienia wyników (rysunek 3).
- Utożsamianie wąsów z minimum i maksimum – w wersji Tukeya wąsy kończą się na granicy 1.5 × IQR, a dalsze wyniki są pokazane osobno.
- Brak opisu konstrukcji w podpisie – czytelnik musi wiedzieć, co oznaczają pudełko, wąsy i punkty oraz ile było obserwacji (Krzywinski i Altman, 2014).
- Automatyczne usuwanie „kropek” – wynik poza wąsem to sygnał do sprawdzenia, a nie dowód błędu.
- Wnioskowanie o istotności z nakładania się pudełek – do tego służy test statystyczny i wielkość efektu.
Najczęstsze pytania
Jak czytać wykres pudełkowy?
Linia w pudełku to mediana, a krawędzie pudełka to pierwszy i trzeci kwartyl – między nimi leży środkowe 50% wyników (IQR). Wąsy sięgają do najbardziej skrajnych wyników nie dalszych niż 1.5 × IQR od pudełka, a punkty poza nimi to obserwacje odstające. Położenie mediany w pudełku i długość wąsów mówią o symetrii rozkładu.
Co oznaczają wąsy na wykresie pudełkowym?
W najczęstszej wersji (Tukeya) wąs kończy się na najbardziej skrajnym wyniku, który leży nie dalej niż 1.5 rozstępu ćwiartkowego od krawędzi pudełka. Wąsy nie muszą więc sięgać minimum i maksimum – dalsze wyniki są pokazane jako osobne punkty. Inne konwencje (np. wąsy do minimum i maksimum) opisz w podpisie rysunku.
Co oznaczają kropki na wykresie pudełkowym?
Kropki poza wąsami to obserwacje odstające, czyli wyniki odległe od pudełka o ponad 1.5 × IQR; SPSS dodatkowo oznacza gwiazdką wyniki dalsze niż 3 × IQR. Odstający wynik nie musi być błędem – sprawdź jego źródło, zanim zdecydujesz, co z nim zrobić.
Kiedy użyć wykresu pudełkowego zamiast słupkowego?
Zawsze, gdy pokazujesz zmienną ilościową w grupach i chcesz przedstawić rozkład, a nie tylko średnią. Słupki średnich mogą wyglądać identycznie dla bardzo różnych danych. Najlepiej łączyć pudełka z surowymi wynikami. Wykres słupkowy zostaw dla liczebności i odsetków kategorii.
Jak zrobić wykres pudełkowy w SPSS i R?
W SPSS: Analiza → Opis statystyczny → Eksploracja albo kreator wykresów. W R: boxplot(wynik ~ grupa, data = dane) lub w ggplot2 geom_boxplot(), najlepiej z geom_jitter(), żeby pokazać surowe wyniki.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikStatystyka do pracy licencjackiej: analiza krok po kroku
Jak zaplanować analizę statystyczną do pracy licencjackiej, przygotować ankietę i bazę danych oraz otrzymać wyniki, które da się obronić.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486–489. https://doi.org/10.5812/ijem.3505 ● Otwarty dostęp
- Krzywinski, M., & Altman, N. (2014). Visualizing samples with box plots. Nature Methods, 11(2), 119–120. https://doi.org/10.1038/nmeth.2813
- Nuzzo, R. L. (2016). The box plots alternative for visualizing quantitative data. PM&R, 8(3), 268–272. https://doi.org/10.1016/j.pmrj.2016.02.001 ● Otwarty dostęp
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
- Williamson, D. F., Parker, R. A., & Kendrick, J. S. (1989). The box plot: A simple visual method to interpret data. Annals of Internal Medicine, 110(11), 916–921. https://doi.org/10.7326/0003-4819-110-11-916
Cytowania BibTeX
@article{ghasemi2012normality, author={Ghasemi, Asghar and Zahediasl, Saleh}, title={{Normality tests for statistical analysis: A guide for non-statisticians}}, journal={International Journal of Endocrinology and Metabolism}, year={2012}, volume={10}, number={2}, pages={486--489}, doi={10.5812/ijem.3505}}@article{krzywinski2014visualizing, author={Krzywinski, Martin and Altman, Naomi}, title={{Visualizing samples with box plots}}, journal={Nature Methods}, year={2014}, volume={11}, number={2}, pages={119--120}, doi={10.1038/nmeth.2813}}@article{nuzzo2016box, author={Nuzzo, Regina L.}, title={{The box plots alternative for visualizing quantitative data}}, journal={PM\&R}, year={2016}, volume={8}, number={3}, pages={268--272}, doi={10.1016/j.pmrj.2016.02.001}}@book{tukey1977exploratory, author={Tukey, John W.}, title={{Exploratory data analysis}}, year={1977}, publisher={Addison-Wesley}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}@article{williamson1989box, author={Williamson, David F. and Parker, Robert A. and Kendrick, Juliette S.}, title={{The box plot: A simple visual method to interpret data}}, journal={Annals of Internal Medicine}, year={1989}, volume={110}, number={11}, pages={916--921}, doi={10.7326/0003-4819-110-11-916}}