Co to jest wykres pszczelego roju i wykres sina?
Wykres pszczelego roju (ang. beeswarm plot) pokazuje każdą obserwację jako osobny punkt na osi wyniku. Punkty o zbliżonych wartościach algorytm rozsuwa na boki, tak by stykały się, ale nie nakładały – w miejscach, gdzie wyników jest dużo, chmura robi się szeroka jak rój. To potomek klasycznego wykresu punktowego pojedynczych obserwacji, który od ponad stu lat rysowano ręcznie, układając symbole możliwie blisko ich miejsc na skali (Wilkinson, 1999). Nie myl go z wykresem punktowym Clevelanda, który pokazuje jedną liczbę na kategorię.
Wykres sina (ang. sina plot) robi to samo inaczej: punkty rozrzuca losowo w poziomie, a granice rozrzutu wyznacza oszacowana gęstość. Ma więc kontur wykresu skrzypcowego, a przy małej liczbie punktów wygląda jak zwykły wykres punktów; szerokość jest normalizowana we wszystkich grupach, co ułatwia porównanie grup o różnej liczebności (Sidiropoulos i in., 2018).
Jak czytać
- Położenie punktu na osi wyniku to wartość jednej osoby. Położenie na boki nie znaczy nic – służy tylko temu, by punkty się nie zasłaniały.
- Szerokość chmury pokazuje, gdzie wyników jest najwięcej. Dwa przewężenia i dwa poszerzenia to dwa szczyty rozkładu.
- Liczba punktów to liczebność grupy – widać ją bez podpisu, a pojedyncze skrajne wyniki są widoczne jako osobne kropki.
Przykład
Symulowaliśmy wyniki testu w trzech grupach: 81 osób z rozkładem o jednym szczycie, 81 osób z dwoma szczytami i 13 osób. Każdą grupę przekształcono odcinkami liniowo tak, by miała dokładnie te same minimum, kwartyle i maksimum: 20, 40, 50, 60 i 80 punktów. Średnie wyniosły 50.5, 50.4 i 51.1, a odchylenia standardowe 12.1, 13.6 i 18.1. Kształty i liczebności dobrano ręcznie, żeby różnice ukryte pod pudełkiem były wyraźne; ziarna (732) nie zmieniano.
Na rysunku
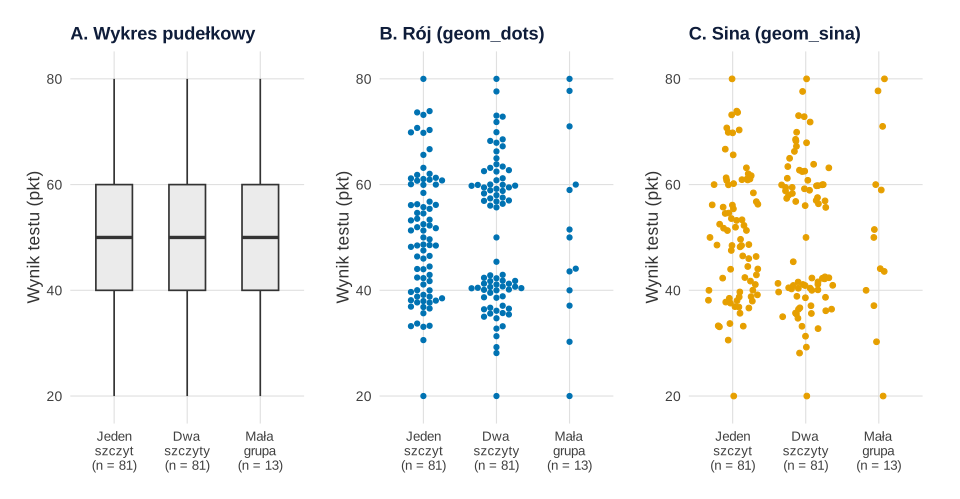
set.seed(732)).Co widać. Pudełka w panelu A są identyczne, bo z założenia mają te same pięć liczb. Rój w panelu B pokazuje trzy różne sytuacje: jeden szczyt, dwa skupiska wokół 40 i 60 z pustką w miejscu mediany oraz grupę tak małą, że kwartyle opierają się na pojedynczych osobach. Sina w panelu C pokazuje te same kształty, ale punkty są rozrzucone luźniej i losowo.
Na co uważać. Rój przy kilkuset osobach w grupie robi się za szeroki albo punkty trzeba zmniejszać, więc przy dużych grupach lepiej sprawdzają się sina, skrzypce albo histogram. Żaden z tych wykresów nie pokazuje sam z siebie średniej ani przedziału ufności – jeśli porównujesz grupy, dorysuj je albo połącz punkty z pudełkiem, jak w wykresie raincloud.
Podpis do pracy:
Jak opisać w pracy
Wykres wspiera opis rozkładu w tekście – podaj liczby, a kształt opisz słowami. Więcej wariantów porównania grup na jednym zbiorze danych pokazuje wpis porównanie grup na wykresie: od słupka do raincloud.
Na co uważać
- Odczytywanie położenia w poziomie jako drugiej zmiennej. Oś pozioma w obrębie grupy nie ma skali.
- Zwykły jitter zamiast roju. Losowe rozsunięcie bez ograniczeń daje chmurę o stałej szerokości, w której nie widać kształtu rozkładu. Sina rozwiązuje to, wiążąc szerokość z gęstością (Wilke, 2019).
- Za duże punkty przy wielu obserwacjach zlewają się w plamę. Zmniejsz je albo zmień wykres.
Wykres pszczelego roju i sina w R
Kod symuluje trzy grupy, dopasowuje ich pięć liczb, sprawdza je i rysuje trzy panele. Rój rysuje funkcja geom_dots() z pakietu ggdist (side = "both", układ "weave"), wykres sina – geom_sina() z pakietu ggforce. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu; dane, geometrie i skale są identyczne.
Te same pudełka, różne rozkłady
Kod R rysunku 1
# Wykres pszczelego roju i wykres sina: trzy grupy z identycznym wykresem pudełkowym
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(ggdist); library(ggforce)})
oi <- c(niebieski = "#0072B2", pomarancz = "#E69F00", szary = "grey60")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())

# Przekształcenie odcinkami liniowe: min, Q1, mediana, Q3 i max każdej grupy = 20, 40, 50, 60, 80
dopasuj <- function(x, cel = c(20, 40, 50, 60, 80)) approx(quantile(x), cel, xout = x)$y
set.seed(732)
n <- 81                                   # przy n = 4k + 1 kwartyle są pojedynczymi obserwacjami
jedno <- rnorm(n)                                                  # jeden szczyt
dwa   <- c(rnorm(40, -1.5, 0.4), rnorm(41, 1.5, 0.4))              # dwa szczyty
mala  <- rnorm(13)                                                 # mała grupa, 13 osób
etyk <- c("Jeden\nszczyt\n(n = 81)", "Dwa\nszczyty\n(n = 81)", "Mała\ngrupa\n(n = 13)")
d <- data.frame(grupa = factor(rep(etyk, times = c(n, n, 13)), levels = etyk),
                wynik = c(dopasuj(jedno), dopasuj(dwa), dopasuj(mala)))
opis <- t(sapply(split(d$wynik, d$grupa), function(x) c(quantile(x), M = mean(x), SD = sd(x))))
rownames(opis) <- c("Jeden szczyt", "Dwa szczyty", "Mała grupa")
print(round(opis, 1))

pA <- ggplot(d, aes(grupa, wynik)) + geom_boxplot(width = 0.5, fill = "grey92") +
  labs(title = "A. Wykres pudełkowy", x = NULL, y = "Wynik testu (pkt)")
pB <- ggplot(d, aes(grupa, wynik)) + geom_dots(side = "both", layout = "weave", colour = oi[["niebieski"]],
                                                fill = oi[["niebieski"]], binwidth = 1.1) +
  labs(title = "B. Rój (geom_dots)", x = NULL, y = "Wynik testu (pkt)")
set.seed(732)                             # sina rozrzuca punkty losowo w granicach gęstości
pC <- ggplot(d, aes(grupa, wynik)) + geom_sina(colour = oi[["pomarancz"]], size = 1.6, maxwidth = 0.8) +
  labs(title = "C. Sina (geom_sina)", x = NULL, y = "Wynik testu (pkt)")
p1 <- (pA + pB + pC) & coord_cartesian(ylim = c(18, 82)) & motyw &
  theme(axis.text.x = element_text(size = 10))
p1
Wynik w R
             0% 25% 50% 75% 100%    M   SD
Jeden szczyt 20  40  50  60   80 50.5 12.1
Dwa szczyty  20  40  50  60   80 50.4 13.6
Mała grupa   20  40  50  60   80 51.1 18.1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dane – funkcje bazowe rnorm(), quantile(), approx(); rysunek – pakiety ggplot2, ggdist, ggforce i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggdist (wersja 3.3.3): Kay, M. (2025). ggdist: Visualizations of distributions and uncertainty [R package]. https://doi.org/10.5281/zenodo.3879620
- ggforce (wersja 0.5.0): Pedersen, T. L. (2025). ggforce: Accelerating ggplot2 (R package version 0.5.0) [Computer software]. https://doi.org/10.32614/CRAN.package.ggforce
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym różni się wykres pszczelego roju od wykresu sina?
W roju punkty układa algorytm tak, by stykały się, ale nie nakładały – szerokość wynika z liczby punktów. W sinie punkty są losowo rozrzucone na boki w granicach krzywej gęstości, jak we wnętrzu skrzypiec, więc wykres mieści też duże grupy.
Kiedy wykres pszczelego roju jest lepszy niż wykres pudełkowy?
Gdy grupy liczą od kilkunastu do kilkuset osób i ważny jest kształt rozkładu albo liczebność. Pudełko streszcza pięć liczb, a rój pokazuje wszystkie wyniki, w tym dwa szczyty i małe grupy.
Czy wykres sina daje za każdym razem ten sam obraz?
Nie, rozrzut na boki jest losowy, więc bez ustalonego ziarna punkty przy każdym rysowaniu leżą trochę inaczej. Ich wartości na osi wyniku się nie zmieniają; dla powtarzalności ustaw set.seed() przed rysowaniem.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Porównanie grup na wykresie: od słupka do raincloud
Jeden zbiór na pięciu wykresach w R: słupek ± SE i ± SD, pudełko, skrzypce, punkty z 95% CI i raincloud – co każdy ukrywa, podpisy i zdania do Wyników.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikRozkład zmiennej na wykresie
Histogram przy czterech szerokościach przedziału, gęstość za gładka i za szorstka, ECDF, dwie grupy i skala Likerta – sześć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Sidiropoulos, N., Sohi, S. H., Pedersen, T. L., Porse, B. T., Winther, O., Rapin, N., & Bagger, F. O. (2018). SinaPlot: An enhanced chart for simple and truthful representation of single observations over multiple classes. Journal of Computational and Graphical Statistics, 27(3), 673–676. https://doi.org/10.1080/10618600.2017.1366914 ● Otwarty dostęp: pełny tekst
- Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media. https://clauswilke.com/dataviz/ ● Otwarty dostęp
- Wilkinson, L. (1999). Dot plots. The American Statistician, 53(3), 276–281. https://doi.org/10.1080/00031305.1999.10474474
Cytowania BibTeX
@article{sidiropoulos2018sinaplot, author={Sidiropoulos, Nikos and Sohi, Sina Hadi and Pedersen, Thomas Lin and Porse, Bo Torben and Winther, Ole and Rapin, Nicolas and Bagger, Frederik Otzen}, title={{SinaPlot: An enhanced chart for simple and truthful representation of single observations over multiple classes}}, journal={Journal of Computational and Graphical Statistics}, year={2018}, volume={27}, number={3}, pages={673--676}, doi={10.1080/10618600.2017.1366914}}@book{wilke2019fundamentals, author={Wilke, Claus O.}, title={{Fundamentals of data visualization: A primer on making informative and compelling figures}}, year={2019}, publisher={O’Reilly Media}, url={https://clauswilke.com/dataviz/}}@article{wilkinson1999dot, author={Wilkinson, Leland}, title={{Dot plots}}, journal={The American Statistician}, year={1999}, volume={53}, number={3}, pages={276--281}, doi={10.1080/00031305.1999.10474474}}