Co to jest wykres punktowy Clevelanda?
Wykres punktowy Clevelanda (ang. dot plot lub dot chart) pokazuje po jednej liczbie dla każdej kategorii – średnią, odsetek, liczebność – jako punkt na wspólnej osi. Kategorie leżą zwykle w wierszach, jedna pod drugą, z etykietami po lewej. Cleveland (1984) zaproponował go jako zamiennik wykresu słupkowego dla danych z etykietami: można go użyć w większej liczbie sytuacji, a wartości odczytuje się z niego skuteczniej. Cleveland i McGill (1984) uporządkowali zadania percepcyjne według dokładności odczytu; położenie na wspólnej skali wypada najlepiej, dlatego proponują punkty w miejsce m.in. słupków i wykresów kołowych.
Nie myl go z wykresem pojedynczych obserwacji ułożonych w stosy, który po angielsku też bywa nazywany dot plot – ten opisujemy w haśle o wykresie pszczelego roju.
Jak czytać wykres punktowy
- Położenie punktu to wartość. Liczy się odległość między punktami, a nie od zera, więc oś może zaczynać się blisko najmniejszej wartości.
- Kolejność wierszy niesie informację, jeśli kategorie posortowano według wartości – od razu widać ranking i skupiska podobnych wyników.
- Poziome odcinki to zwykle 95% przedziały ufności. Dopiero z nimi widać, które różnice są wyraźne, a które mieszczą się w niepewności oszacowania. Ten sam układ ma wykres lasu w metaanalizie.
Przykład
W symulowanych danych 565 studentów z 12 kierunków oceniło stres na skali 1–5. Średnie wyniosły od 2.83 (matematyka, n = 18) do 3.55 (medycyna, n = 60). Na skali od 0 do 5 cała ta rozpiętość to niecałe 15% długości osi. Średnie i liczebności grup ustawiono ręcznie tak, by różnice były małe, a grupy nierówne; ziarna (731) nie zmieniano.
Na rysunku
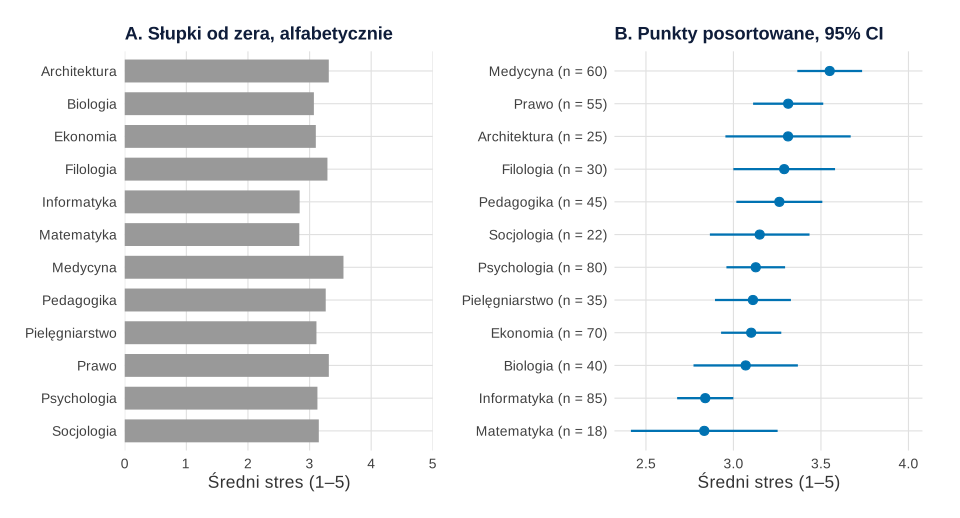
set.seed(731)).Co widać. W panelu A słupki mają niemal tę samą długość, a porządek alfabetyczny każe szukać najwyższej wartości wzrokiem. W panelu B ranking czyta się od góry: medycyna wyraźnie wyżej, matematyka i informatyka najniżej, reszta w jednym skupisku między 3.07 a 3.31. Przedziały pokazują też to, czego słupki nie mówią: matematyka ma najniższą średnią, ale jej przedział [2.41, 3.25] jest najszerszy, bo grupa liczy 18 osób.
Na co uważać. Punkt ze średnią nie pokazuje rozkładu wyników w grupie – dwumodalność czy wartości odstające zobaczysz dopiero na wykresie pudełkowym lub na punktach poszczególnych osób. Przy liczebnościach i odsetkach słupki od zera są poprawne; punkty są wtedy po prostu lżejsze.
Podpis do pracy:
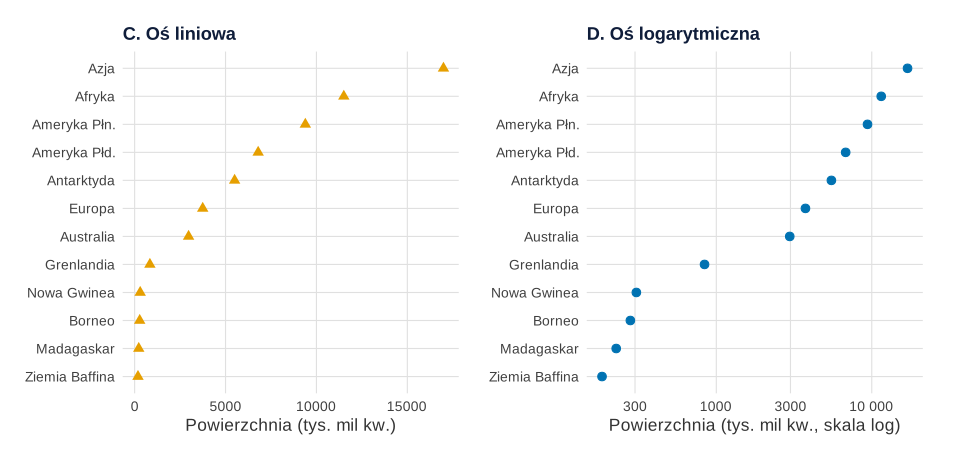
islands).Co widać. Największa wartość jest 92.3 raza większa od najmniejszej. Na osi liniowej pięć ostatnich lądów zlewa się przy zerze. Na osi logarytmicznej równe odległości oznaczają równe ilorazy, więc widać wszystkie różnice. Cleveland (1984) zaleca logarytmy przy takich danych, często o podstawie 2 lub e zamiast 10 – więcej o skali logarytmicznej w haśle o transformacji logarytmicznej.
Na co uważać. Na osi logarytmicznej nie ma zera, więc słupków nie da się na niej sensownie narysować – to kolejny argument za punktami. Podpisz oś jako logarytmiczną i daj na niej wartości w oryginalnych jednostkach.
Podpis do pracy:
Jak opisać w pracy
W tekście podaj liczby, a wykres traktuj jako ilustrację. Ogólne zasady podpisu i numeracji rysunków omawia wpis wykresy w pracy dyplomowej.
Na co uważać
- Kolejność alfabetyczna marnuje główną zaletę wykresu. Sortuj według wartości, chyba że kategorie mają naturalny porządek (np. grupy wiekowe).
- Brak informacji o niepewności. Bez przedziałów i liczebności czytelnik nie odróżni różnicy od szumu. Wykresy, które pokazują same podsumowania, mogą też ukrywać kształt rozkładu (Weissgerber i in., 2015) – przy porównaniu grup rozważ dodanie wyników osób, jak we wpisie porównanie grup na wykresie.
- Linie łączące punkty sugerują ciągłość, której między kategoriami nominalnymi nie ma.
Wykres punktowy Clevelanda w R
Kod symuluje dane z przykładu, liczy średnie z 95% CI i rysuje oba rysunki w ggplot2. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Słupki a punkty i oś logarytmiczna
Kod R rysunków 1 i 2
# Wykres punktowy Clevelanda: słupki vs punkty (rysunek 1) i oś logarytmiczna (rysunek 2)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomarancz = "#E69F00", szary = "grey60")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())

# Rysunek 1: średni stres (skala 1–5) na 12 kierunkach, dane symulowane
set.seed(731)
kierunki <- c("Architektura", "Biologia", "Ekonomia", "Filologia", "Informatyka", "Matematyka",
              "Medycyna", "Pedagogika", "Pielęgniarstwo", "Prawo", "Psychologia", "Socjologia")
mu <- c(3.30, 3.05, 3.10, 3.20, 2.80, 2.95, 3.65, 3.15, 3.50, 3.40, 3.25, 3.00)
n  <- c(25, 40, 70, 30, 85, 18, 60, 45, 35, 55, 80, 22)
d <- do.call(rbind, lapply(seq_along(kierunki), function(i) {
  y <- pmin(pmax(round(rnorm(n[i], mu[i], 0.75), 1), 1), 5)
  data.frame(kierunek = kierunki[i], n = n[i], M = mean(y),
             dolna = mean(y) - qt(.975, n[i] - 1) * sd(y) / sqrt(n[i]),
             gorna = mean(y) + qt(.975, n[i] - 1) * sd(y) / sqrt(n[i]))
}))
d <- d[order(d$M), ]
d$etykieta <- factor(sprintf("%s (n = %d)", d$kierunek, d$n), levels = sprintf("%s (n = %d)", d$kierunek, d$n))
cat("N =", sum(d$n), "\n")
print(data.frame(d[, c("kierunek", "n")], round(d[, c("M", "dolna", "gorna")], 2)), row.names = FALSE)

pA <- ggplot(d, aes(x = M, y = factor(kierunek, levels = rev(kierunki)))) +
  geom_col(fill = oi[["szary"]], width = 0.7) +
  scale_x_continuous(limits = c(0, 5), expand = c(0, 0)) +
  labs(title = "A. Słupki od zera, alfabetycznie", x = "Średni stres (1–5)", y = NULL)
pB <- ggplot(d, aes(x = M, y = etykieta)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, orientation = "y", colour = oi[["niebieski"]], linewidth = 0.8) +
  geom_point(size = 2.8, colour = oi[["niebieski"]]) +
  scale_x_continuous(limits = c(2.4, 4)) +
  labs(title = "B. Punkty posortowane, 95% CI", x = "Średni stres (1–5)", y = NULL)
p1 <- (pA + pB) & motyw

# Rysunek 2: powierzchnia 12 największych lądów (wbudowany zbiór islands, tys. mil kw.)
w <- sort(islands, decreasing = TRUE)[1:12]
pl <- c(Asia = "Azja", Africa = "Afryka", "North America" = "Ameryka Płn.", "South America" = "Ameryka Płd.",
        Antarctica = "Antarktyda", Europe = "Europa", Australia = "Australia", Greenland = "Grenlandia",
        "New Guinea" = "Nowa Gwinea", Borneo = "Borneo", Madagascar = "Madagaskar", Baffin = "Ziemia Baffina")
dw <- data.frame(lad = factor(pl[names(w)], levels = rev(pl[names(w)])), pow = as.numeric(w))
print(range(dw$pow)); print(round(max(dw$pow) / min(dw$pow), 1))
pC <- ggplot(dw, aes(x = pow, y = lad)) + geom_point(size = 2.6, colour = oi[["pomarancz"]], shape = 17) +
  labs(title = "C. Oś liniowa", x = "Powierzchnia (tys. mil kw.)", y = NULL)
pD <- ggplot(dw, aes(x = pow, y = lad)) + geom_point(size = 2.6, colour = oi[["niebieski"]]) +
  scale_x_log10(breaks = c(100, 300, 1000, 3000, 10000), labels = c("100", "300", "1000", "3000", "10 000")) +
  labs(title = "D. Oś logarytmiczna", x = "Powierzchnia (tys. mil kw., skala log)", y = NULL)
p2 <- (pC + pD) & motyw
p1
p2
Wynik w R
N = 565
       kierunek  n    M dolna gorna
     Matematyka 18 2.83  2.41  3.25
    Informatyka 85 2.84  2.68  3.00
       Biologia 40 3.07  2.77  3.37
       Ekonomia 70 3.10  2.93  3.27
 Pielęgniarstwo 35 3.11  2.89  3.33
    Psychologia 80 3.13  2.96  3.30
     Socjologia 22 3.15  2.87  3.43
     Pedagogika 45 3.26  3.02  3.51
      Filologia 30 3.29  3.00  3.58
   Architektura 25 3.31  2.95  3.67
          Prawo 55 3.31  3.11  3.51
       Medycyna 60 3.55  3.36  3.74
[1]   184 16988
[1] 92.3
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dane i przedziały – funkcje bazowe rnorm(), qt(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym różni się wykres punktowy Clevelanda od wykresu słupkowego?
Słupek koduje wartość długością od zera, punkt – położeniem na osi. Dzięki temu oś wykresu punktowego nie musi zaczynać się od zera, a przy wielu kategoriach wykres jest lżejszy i łatwiej dodać do niego przedziały ufności.
Czy dot plot to to samo co wykres rozrzutu?
Nie. Wykres rozrzutu pokazuje dwie zmienne ilościowe, a wykres punktowy Clevelanda – jedną liczbę dla każdej kategorii. Tę samą angielską nazwę dot plot nosi też wykres pojedynczych obserwacji ułożonych w stosy, opisany w haśle o wykresie pszczelego roju.
Jak zrobić wykres punktowy Clevelanda w R?
W ggplot2 wystarczy geom_point() z kategoriami na osi pionowej i reorder(), które sortuje je według wartości. Przedziały dodasz przez geom_errorbar() z orientation = "y"; w bazowym R gotową funkcją jest dotchart().
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikTabela krzyżowa na wykresie
Słupki 100% w wierszach i kolumnach, mozaika, mapa reszt χ² z korektą i odsetki z CI – jedna tabela 3 × 4, pięć rysunków z R, podpisy APA.
Czytaj →PoradnikPorównanie grup na wykresie: od słupka do raincloud
Jeden zbiór na pięciu wykresach w R: słupek ± SE i ± SD, pudełko, skrzypce, punkty z 95% CI i raincloud – co każdy ukrywa, podpisy i zdania do Wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cleveland, W. S. (1984). Graphical methods for data presentation: Full scale breaks, dot charts, and multibased logging. The American Statistician, 38(4), 270–280. https://doi.org/10.1080/00031305.1984.10483224
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@article{cleveland1984dot, author={Cleveland, William S.}, title={{Graphical methods for data presentation: Full scale breaks, dot charts, and multibased logging}}, journal={The American Statistician}, year={1984}, volume={38}, number={4}, pages={270--280}, doi={10.1080/00031305.1984.10483224}}@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}