Jedna tabela, pięć obrazów
Test χ² mówi, czy dwie zmienne nominalne są związane. Nie mówi, jak – a to właśnie chcesz pokazać w rozdziale Wyników. Procedurę testu (liczebności oczekiwane, warunki, zapis APA) znajdziesz we wpisie test chi-kwadrat krok po kroku i w haśle chi-kwadrat (test niezależności), a okna programów – w poradnikach chi-kwadrat w SPSS i chi-kwadrat w jamovi. Tu zajmujemy się wyłącznie obrazem: jedną tabelę krzyżową rysujemy pięć razy i za każdym razem sprawdzamy, na jakie pytanie odpowiada rysunek.
Przykład jest fikcyjny: 400 absolwentów rok po dyplomie, trzy kierunki (psychologia – 180 osób, ekonomia – 130, informatyka – 90) i cztery formy zatrudnienia (umowa o pracę, umowa cywilnoprawna, własna firma, bez pracy). Dane wylosowaliśmy w R z ręcznie ustalonych odsetków (ziarno 575) i można je pobrać jako plik CSV – link jest w sekcji z kodem. Tabela wygląda tak:
| Kierunek | Umowa o pracę | Umowa cywilnoprawna | Własna firma (B2B) | Bez pracy | Razem |
|---|---|---|---|---|---|
| Psychologia | 89 | 45 | 16 | 30 | 180 |
| Ekonomia | 55 | 32 | 24 | 19 | 130 |
| Informatyka | 45 | 13 | 30 | 2 | 90 |
| Razem | 189 | 90 | 70 | 51 | 400 |
Test niezależności daje χ²(6, N = 400) = 35.29, p < .001; najmniejsza liczebność oczekiwana to 11.5, więc warunki testu są spełnione. Przy każdym rysunku znajdziesz cztery elementy: co widać, czego wykres nie pokazuje (albo jak może zmylić), gotowy podpis w stylu APA i zdanie do pracy. Ogólnych zasad rysowania (rozmiar, czcionki, eksport) nie powtarzamy – są we wpisach wykresy w pracy dyplomowej i tabele i rysunki do artykułu.
Rysunek 1: słupki liczebności
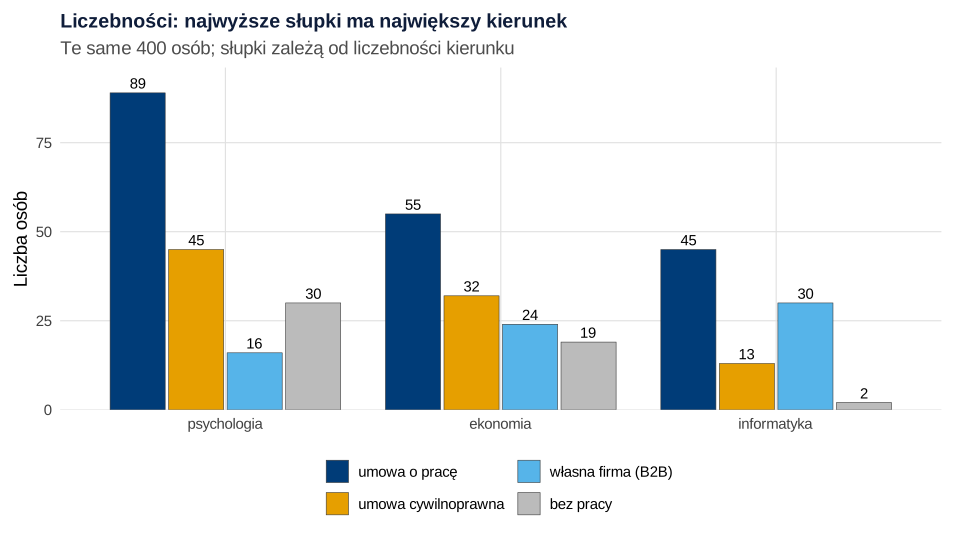
set.seed(575)).Co widać. Liczby z tabeli zamienione na wysokości słupków. Najwyższe słupki ma psychologia, bo to największy kierunek: 89 osób na umowie o pracę wobec 45 w informatyce. Jedna różnica przebija się mimo to – w informatyce własną firmę prowadzi 30 osób, więcej niż w dwa razy liczniejszej psychologii (16).
Jak może zmylić. Słupki liczebności mieszają dwie rzeczy: wielkość kierunku i sposób zatrudnienia. Z rysunku łatwo wyczytać „psycholodzy najczęściej pracują na umowie o pracę”, choć odsetek jest prawie taki sam jak w informatyce (49.4% i 50.0%). Porównywanie grup o różnej liczebności wymaga odsetków. Ten rysunek nadaje się do opisu próby, a nie do opisu związku. Więcej o wariantach słupków – w haśle wykres słupkowy.
Podpis do pracy:
Zdanie do pracy (opis próby):
Rysunek 2: słupki 100% – wiersze czy kolumny?
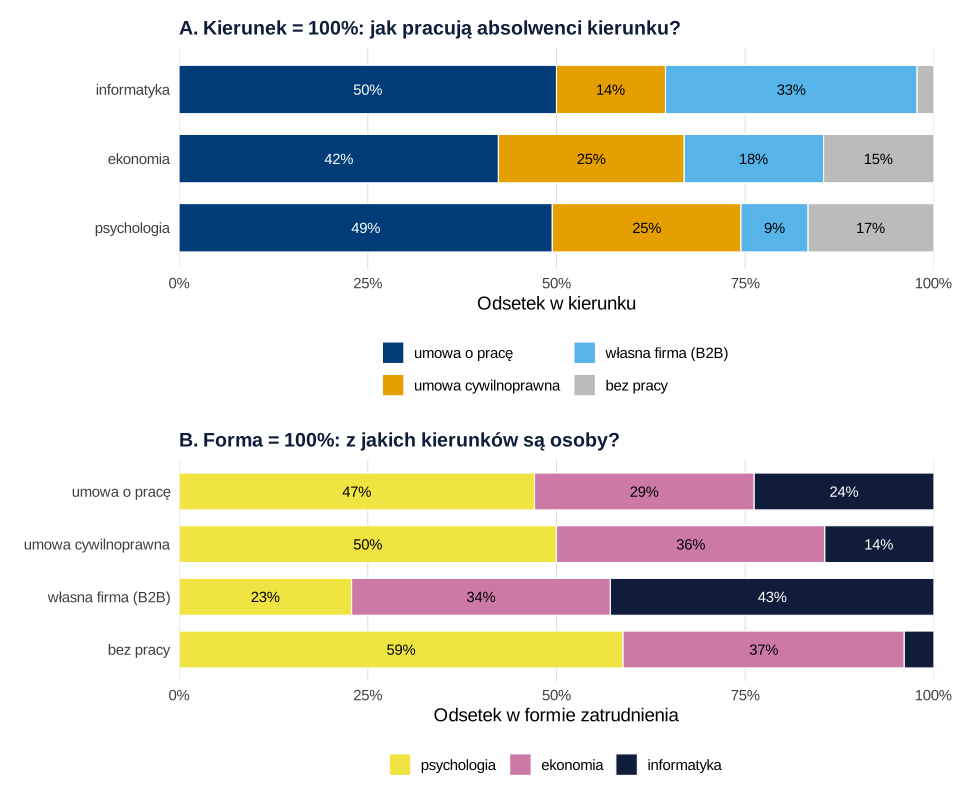
Co widać. Panel A odpowiada na pytanie „jak pracują absolwenci danego kierunku?”. Własną firmę prowadzi 8.9% absolwentów psychologii, 18.5% ekonomii i 33.3% informatyki. Bez pracy pozostaje 16.7%, 14.6% i 2.2% z nich. Panel B odpowiada na inne pytanie: „z jakich kierunków są osoby w danej formie zatrudnienia?”. Wśród 51 osób bez pracy 58.8% to absolwenci psychologii.
Jak może zmylić. Zdanie „prawie 60% bezrobotnych to psycholodzy” jest prawdziwe, ale nic nie mówi o ryzyku bezrobocia w psychologii. Psycholodzy to 45% całej próby, więc w panelu B stanowią około połowy większości kolumn – także wśród zatrudnionych na umowę o pracę (47.1%) i na umowę cywilnoprawną (50.0%). Panel B zależy od tego, ilu absolwentów każdego kierunku trafiło do próby. Panel A tak nie działa. Zasada: licz odsetki w obrębie grup, które porównujesz w hipotezie, i napisz na osi, co jest 100% (w przykładzie – „odsetek w kierunku”). Ćwiczenie na liczbach – zadanie 4 w zbiorze chi-kwadrat – zadania z rozwiązaniami.
Drugie ograniczenie dotyczy samych słupków skumulowanych. Długość segmentu łatwo porównać tylko dla pierwszej kategorii (wszystkie zaczynają się od zera). Segmenty środkowe „pływają”, a ich długości oko ocenia słabo. Cleveland i McGill (1984) uporządkowali zadania percepcyjne według dokładności odczytu; słupki skumulowane wymieniają wśród popularnych wykresów, które należałoby gruntownie przebudować, i proponują zamiast nich m.in. wykresy punktowe (rysunek 5).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: wykres mozaikowy
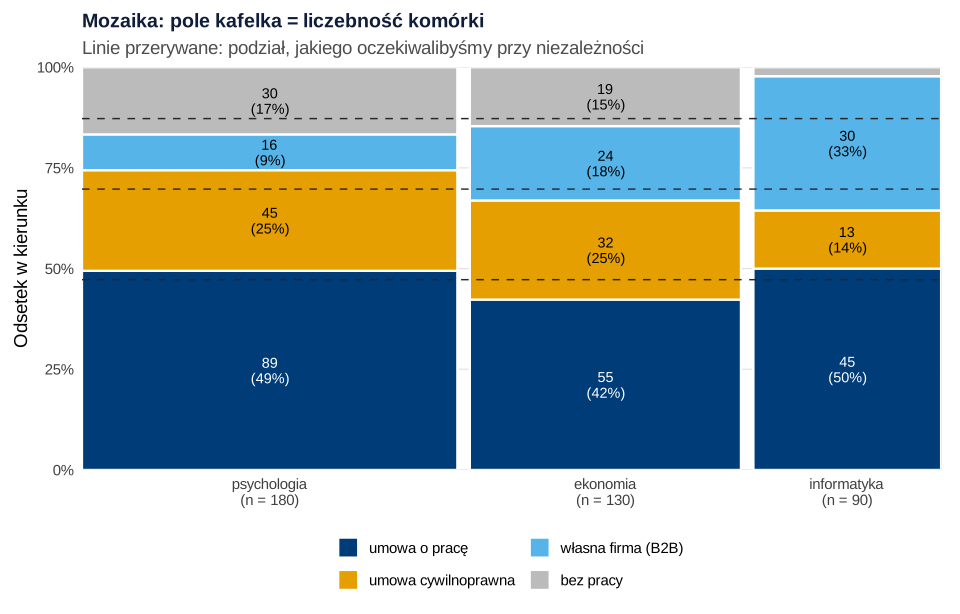
geom_rect). Obliczenia: R (dane fikcyjne).Co widać. Mozaika łączy rysunki 1 i 2A. Szerokość kolumny to udział kierunku w próbie (0.450, 0.325 i 0.225), wysokość kafelka – odsetek w kierunku, więc pole kafelka odpowiada liczebności komórki: 0.450 × 0.494 = 0.222, czyli 89 z 400 osób. Linie przerywane pokazują, jak wyglądałby podział, gdyby forma zatrudnienia nie zależała od kierunku: na wysokości 47.2%, 69.8% i 87.3% (rozkład w całej próbie). Przy niezależności granice kafelków leżałyby na tych liniach. W ekonomii granice leżą blisko linii. W psychologii kafelek własnej firmy jest niższy, niż „należy się” przy niezależności (8.9% wobec 17.5% w całej próbie). W informatyce ten sam kafelek rozpycha się w górę, a kafelek „bez pracy” (2 osoby, 2.2%) niemal znika.
Czego ten wykres nie pokazuje. Czy odchylenia są większe, niż daje przypadek – oko nie odróżni 3 punktów procentowych różnicy od 10 przy wąskiej kolumnie. Friendly (1994) proponował dlatego cieniowanie kafelków według znaku i wielkości reszt standaryzowanych. My pokazujemy reszty osobno (rysunek 4), żeby kolor w mozaice nadal oznaczał formę zatrudnienia. Mozaika gorzej działa też przy wielu kategoriach i bardzo małych komórkach: kafelki o polu poniżej 1% stają się kreskami bez etykiet.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: mapa skorygowanych reszt i korekta przy 12 komórkach
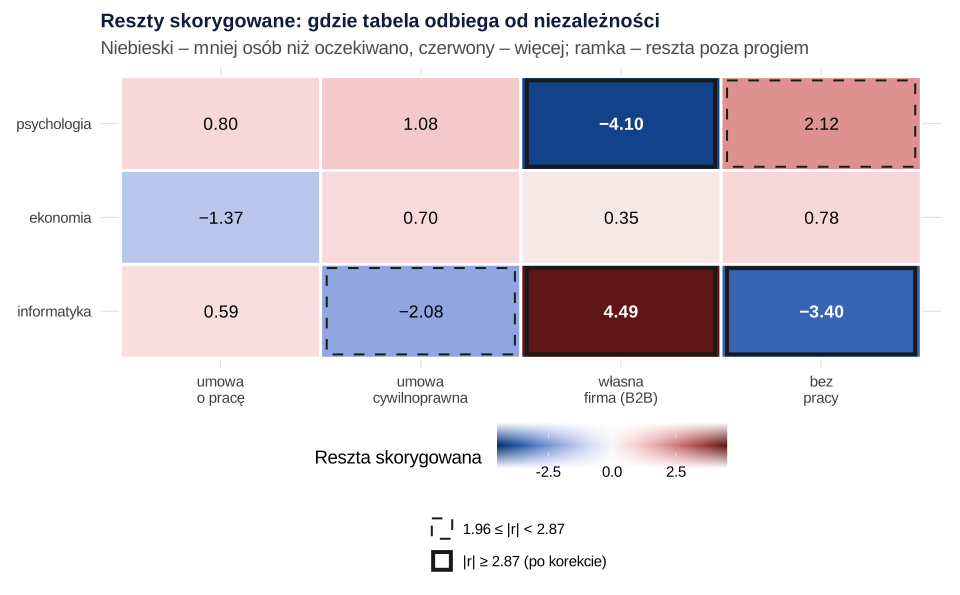
Co widać. Każda komórka to skorygowana reszta standaryzowana (Haberman, 1973): różnica między liczebnością obserwowaną a oczekiwaną przy niezależności, podzielona przez jej błąd standardowy. Przy braku związku reszty mają w przybliżeniu standardowy rozkład normalny. Kolor ma rozbieżną skalę symetryczną wokół zera: niebieski – mniej osób, niż przewiduje niezależność, czerwony – więcej, biel – zgodność. Skala o jednolitej percepcji jasności bez pary czerwony–zielony pozostaje czytelna także przy zaburzeniach widzenia barw (Crameri i in., 2020); wartości w komórkach są i tak wpisane liczbą. Związek „robią” trzy komórki: informatycy częściej prowadzą własną firmę (4.49) i rzadziej są bez pracy (−3.40), a psycholodzy rzadziej prowadzą firmę (−4.10).
Jak może zmylić: próg ±1.96 przy 12 komórkach. Wartość 1.96 to próg dla jednej komórki. Sprawdzając 12 komórek, wykonujesz 12 testów naraz. Ile to kosztuje, sprawdziliśmy symulacją: 10 000 tabel z tymi samymi sumami wierszy i kolumn, ale bez żadnego związku (funkcja r2dtable). Co najmniej jedna reszta przekroczyła ±1.96 w 40.34% tabel (błąd Monte Carlo 0.49 pp). Po korekcie Bonferroniego (α = .05 dzielone na 12 komórek, dwustronnie) próg rośnie do 2.87, a fałszywy alarm zdarzył się w 4.29% tabel (błąd 0.20 pp). Korekta jest nieco zachowawcza, bo reszty w jednej tabeli są ze sobą powiązane. MacDonald i Gardner (2000) w symulacjach tabel 3 × 4 pokazali, że metoda skorygowanych reszt dobrze kontroluje błąd I rodzaju dla całej tabeli, jeśli poziom α odpowiednio się skoryguje. Szerszy obraz problemu wielu testów – we wpisie wielokrotne testy w obrazkach.
Dlatego ramki na rysunku mają dwa rodzaje. Ramka pełna oznacza resztę po korekcie (|r| ≥ 2.87), ramka przerywana – resztę „istotną” tylko bez korekty: psychologia–bez pracy (2.12) i informatyka–umowa cywilnoprawna (−2.08). Te dwie komórki opisz ostrożnie albo wcale. Analiza reszt to tylko jeden ze sposobów szukania źródła istotnego χ²; Sharpe (2015) omawia obok niej porównania komórek i podział tabeli na mniejsze części.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: odsetki z przedziałami ufności zamiast skumulowanych słupków
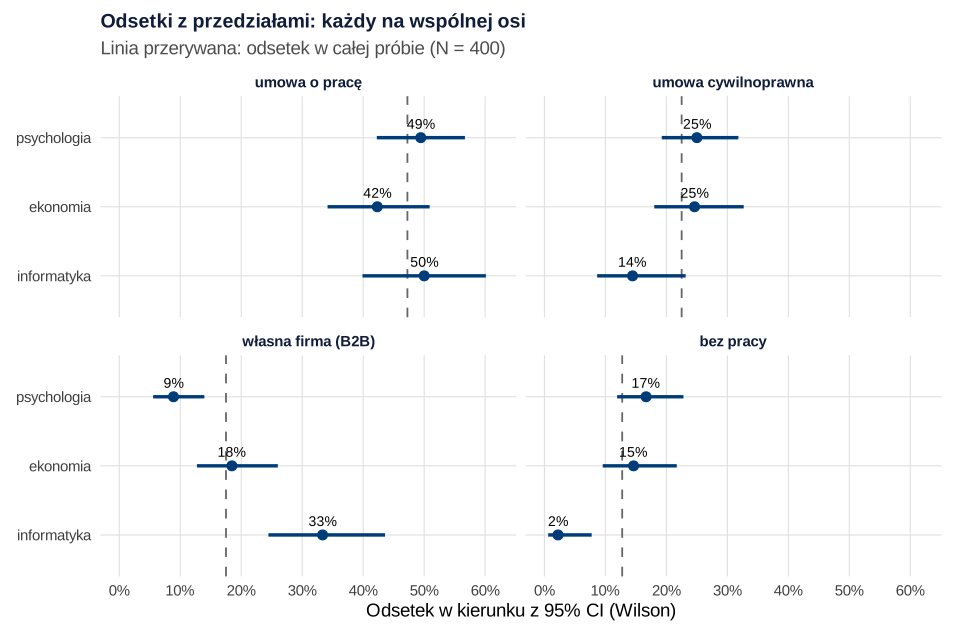
Co widać. Każdy odsetek z panelu A rysunku 2 dostał punkt na wspólnej osi i przedział ufności dla proporcji (metoda Wilsona). Porównanie trzech kierunków w jednej formie zatrudnienia to teraz porównanie położenia punktów na tej samej skali, a nie długości „pływających” segmentów. Od razu widać też niepewność: odsetek własnej firmy w informatyce to 33.3%, 95% CI [24.5, 43.6], w psychologii 8.9% [5.5, 14.0]. Przy umowie o pracę przedziały trzech kierunków mocno się nakładają (od 42.3% do 50.0%). Przedziały informatyki są najszersze, bo to najmniejsza grupa.
Jak może zmylić. Przedziały policzono osobno dla każdego odsetka, więc nie zastępują testu różnicy – nakładanie się dwóch przedziałów nie oznacza braku istotnej różnicy (rysunek 6 we wpisie przedział ufności w obrazkach). Odsetki w obrębie kierunku sumują się do 100%, więc punkty jednego kierunku w czterech panelach nie są od siebie niezależne. Przedział dla różnicy dwóch odsetków policzysz według wpisu jak porównać odsetki w dwóch grupach. Ten sam typ wykresu – poziome słupki albo punkty z CI – polecamy przy pytaniach wielokrotnego wyboru.
Podpis do pracy:
Zdanie do Wyników:
Siła związku: V Craméra z przedziałem ufności
Żaden z rysunków nie podaje jednej liczby opisującej siłę związku. Tę rolę pełni V Craméra: V = .21. Przedział ufności dla V można policzyć, szukając takich parametrów niecentralności rozkładu χ², przy których obserwowana statystyka 35.29 wypada na 97.5. i na 2.5. centylu. Ten przedział niecentralny daje 95% CI [.15, .28] (kontrolnie tę samą wartość zwraca funkcja ci_cramersv() z pakietu confintr). V Craméra w skończonych próbach bywa zawyżone; Bergsma (2013) zaproponował prostą korektę obciążenia – tu daje ona .19. Kształt rozkładu χ² przy różnych stopniach swobody pokazujemy we wpisie skąd się biorą rozkłady t, χ² i F.
Zdanie do Wyników łączy test, wielkość efektu i odesłanie do rysunków:
Który wykres do pracy
- Jeden rysunek w rozdziale Wyników: słupki 100% w obrębie grup z hipotezy (rysunek 2A) albo – lepiej przy porównaniach – odsetki z przedziałami (rysunek 5). Liczebności podaj w tabeli albo w nocie.
- Grupy bardzo różnej wielkości: mozaika (rysunek 3), bo szerokość kolumny od razu mówi, ile osób stoi za odsetkiem.
- Istotny test i pytanie „gdzie leży związek?”: mapa reszt z progiem po korekcie (rysunek 4) – w Wynikach albo w aneksie.
- Opis próby: słupki liczebności (rysunek 1) albo po prostu tabela.
- Wiele kategorii w obu zmiennych (np. 6 × 8): zamiast słupków rozważ analizę korespondencji, która pokazuje strukturę dużej tabeli na mapie.
- Tabela 2 × 2 albo małe liczebności: rysunek niewiele doda; wynik testu dokładnego policzysz w kalkulatorze tabeli 2×2 i r×c, a wybór testu opisuje wpis chi-kwadrat czy test Fishera.
Kod R wszystkich rysunków i liczb
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje motyw, paletę i dane, z których korzystają następne. Każdy przepis tworzy obiekt wykresu (p1–p5); wpisz jego nazwę, żeby go wyświetlić, a do zapisu użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG.
Dane są fikcyjne. Liczebności kierunków (180, 130, 90) i odsetki form zatrudnienia, z których losowano dane, ustaliliśmy ręcznie tak, żeby na mapie reszt znalazły się komórki wyraźnie odstające, graniczne i zgodne z niezależnością. Ziarno 575 ustaliliśmy raz. Te same 400 obserwacji pobierzesz jako plik tabela-krzyzowa-absolwenci.csv (kolumny kierunek i zatrudnienie); tabelę odtworzysz poleceniem table(dane$kierunek, dane$zatrudnienie). Symulacja w przepisie 4 ma 10 000 powtórzeń; błąd Monte Carlo odsetka to √(p(1 − p)/10 000).
1. Motyw, paleta, dane i słupki liczebności: Rysunek 1
R
# Rysunek 1. Tabela krzyżowa 3 × 4 i słupki liczebności (dane fikcyjne: 400 absolwentów rok po dyplomie)
library(ggplot2)

# Motyw i paleta (odcienie Okabe–Ito sprawdzone w symulacji deuteranopii; kolor wspierają etykiety)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
formy <- c("umowa o pracę", "umowa cywilnoprawna", "własna firma (B2B)", "bez pracy")
kol <- setNames(c("#003C78", "#E69F00", "#56B4E9", "#BBBBBB"), formy)
kol_tekst <- setNames(c("white", "black", "black", "black"), formy)   # czytelny tekst na kafelkach

# Dane fikcyjne: liczebności kierunków ustalone, forma zatrudnienia losowana z założonych odsetków
set.seed(575)                                   # ziarno ustalone raz, bez dobierania pod wynik
n_kier <- c(psychologia = 180, ekonomia = 130, informatyka = 90)
p_kier <- rbind(psychologia = c(.42, .27, .10, .21),   # założone odsetki (dobrane ręcznie)
                ekonomia    = c(.44, .20, .14, .22),
                informatyka = c(.44, .14, .30, .12))
dane <- do.call(rbind, lapply(names(n_kier), function(k)
  data.frame(kierunek = k, zatrudnienie = sample(formy, n_kier[[k]], replace = TRUE, prob = p_kier[k, ]))))
dane$kierunek <- factor(dane$kierunek, levels = names(n_kier))
dane$zatrudnienie <- factor(dane$zatrudnienie, levels = formy)
# write.csv(dane, "tabela-krzyzowa-absolwenci.csv", row.names = FALSE)   # te same dane co w pliku CSV

tab <- table(dane$kierunek, dane$zatrudnienie)
names(dimnames(tab)) <- c("kierunek", "zatrudnienie")
addmargins(tab)

d1 <- as.data.frame(tab, responseName = "n")
p1 <- ggplot(d1, aes(kierunek, n, fill = zatrudnienie)) +
  geom_col(position = position_dodge(width = 0.85), width = 0.8, colour = "grey20", linewidth = 0.2) +
  geom_text(aes(label = n), position = position_dodge(width = 0.85), vjust = -0.4, size = 3.9) +
  scale_fill_manual(values = kol, name = NULL) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.08))) +
  guides(fill = guide_legend(nrow = 2)) +
  labs(x = NULL, y = "Liczba osób", title = "Liczebności: najwyższe słupki ma największy kierunek",
       subtitle = "Te same 400 osób; słupki zależą od liczebności kierunku") + motyw
# p1   # zapis: ggsave("tabela-krzyzowa-slupki-liczebnosci.svg", p1, width = 10, height = 5.6)
Wynik w R
             zatrudnienie
kierunek      umowa o pracę umowa cywilnoprawna własna firma (B2B) bez pracy
  psychologia            89                  45                 16        30
  ekonomia               55                  32                 24        19
  informatyka            45                  13                 30         2
  Sum                   189                  90                 70        51
             zatrudnienie
kierunek      Sum
  psychologia 180
  ekonomia    130
  informatyka  90
  Sum         400
2. Słupki 100% w wierszach i w kolumnach: Rysunek 2
R
# Rysunek 2. Słupki 100%: odsetki w wierszach (profil kierunku) i w kolumnach (skład formy zatrudnienia)
library(patchwork)                              # kontynuacja: tab, kol, kol_tekst, formy, motyw z bloku 1

proc_w <- prop.table(tab, margin = 1)           # każdy kierunek = 100%
proc_k <- prop.table(tab, margin = 2)           # każda forma zatrudnienia = 100%
round(100 * addmargins(proc_w, margin = 2), 1)
round(100 * addmargins(proc_k, margin = 1), 1)
round(100 * prop.table(margin.table(tab, 2)), 1)   # rozkład brzegowy formy zatrudnienia (wszyscy)

d2a <- as.data.frame(proc_w, responseName = "odsetek")
d2b <- as.data.frame(proc_k, responseName = "odsetek")
etykieta <- function(x) ifelse(x >= .06, sprintf("%.0f%%", 100 * x), "")   # bez etykiet w wąskich kawałkach
kol_kier <- c(psychologia = "#F0E442", ekonomia = "#CC79A7", informatyka = "#0f1d3a")
p2a <- ggplot(d2a, aes(odsetek, kierunek, fill = zatrudnienie)) +
  geom_col(width = 0.7, colour = "white", linewidth = 0.4, position = position_stack(reverse = TRUE)) +
  geom_text(aes(label = etykieta(odsetek), colour = zatrudnienie), position = position_stack(vjust = 0.5, reverse = TRUE),
            size = 3.9, show.legend = FALSE) +
  scale_fill_manual(values = kol, name = NULL) + scale_colour_manual(values = kol_tekst) +
  guides(fill = guide_legend(nrow = 2)) +
  scale_x_continuous(labels = scales::percent, expand = expansion(0)) +
  labs(x = "Odsetek w kierunku", y = NULL, title = "A. Kierunek = 100%: jak pracują absolwenci kierunku?") + motyw
p2b <- ggplot(d2b, aes(odsetek, zatrudnienie, fill = kierunek)) +
  geom_col(width = 0.7, colour = "white", linewidth = 0.4, position = position_stack(reverse = TRUE)) +
  geom_text(aes(label = etykieta(odsetek), colour = kierunek), position = position_stack(vjust = 0.5, reverse = TRUE),
            size = 3.9, show.legend = FALSE) +
  scale_fill_manual(values = kol_kier, name = NULL) +
  scale_colour_manual(values = c(psychologia = "black", ekonomia = "black", informatyka = "white")) +
  scale_x_continuous(labels = scales::percent, expand = expansion(0)) +
  scale_y_discrete(limits = rev(formy)) +
  labs(x = "Odsetek w formie zatrudnienia", y = NULL, title = "B. Forma = 100%: z jakich kierunków są osoby?") + motyw
p2 <- p2a / p2b
# p2   # zapis: ggsave("tabela-krzyzowa-slupki-100-wiersze-kolumny.svg", p2, width = 10, height = 8.4)
Wynik w R
             zatrudnienie
kierunek      umowa o pracę umowa cywilnoprawna własna firma (B2B) bez pracy
  psychologia          49.4                25.0                8.9      16.7
  ekonomia             42.3                24.6               18.5      14.6
  informatyka          50.0                14.4               33.3       2.2
             zatrudnienie
kierunek        Sum
  psychologia 100.0
  ekonomia    100.0
  informatyka 100.0
             zatrudnienie
kierunek      umowa o pracę umowa cywilnoprawna własna firma (B2B) bez pracy
  psychologia          47.1                50.0               22.9      58.8
  ekonomia             29.1                35.6               34.3      37.3
  informatyka          23.8                14.4               42.9       3.9
  Sum                 100.0               100.0              100.0     100.0
zatrudnienie
      umowa o pracę umowa cywilnoprawna  własna firma (B2B)           bez pracy
               47.2                22.5                17.5                12.8
3. Wykres mozaikowy z geom_rect: Rysunek 3
R
# Rysunek 3. Wykres mozaikowy rysowany ręcznie: szerokość = liczebność kierunku, wysokość = odsetek w kierunku
# (kontynuacja: tab, proc_w, kol, kol_tekst, formy, motyw)
szer <- setNames(as.vector(margin.table(tab, 1)) / sum(tab), rownames(tab))   # udział kierunku = szerokość kolumny
odstep <- 0.015                                 # biały odstęp między kolumnami (na osi 0–1)
x_lewy <- unname(c(0, cumsum(szer)[-length(szer)]) + odstep * (seq_along(szer) - 1))
d3 <- do.call(rbind, lapply(seq_along(szer), function(i) {
  w <- as.vector(proc_w[i, ])
  data.frame(kierunek = names(szer)[i], zatrudnienie = factor(formy, levels = formy),
             xmin = x_lewy[i], xmax = x_lewy[i] + szer[[i]],
             ymin = c(0, cumsum(w)[-length(w)]), ymax = cumsum(w), n = as.vector(tab[i, ]))
}))
d3$etykieta <- ifelse(d3$ymax - d3$ymin >= .07, sprintf("%d\n(%.0f%%)", d3$n, 100 * (d3$ymax - d3$ymin)), "")
brzeg <- cumsum(as.vector(prop.table(margin.table(tab, 2))))[-length(formy)]   # podział przy niezależności
data.frame(d3[, c("kierunek", "zatrudnienie", "n")], szerokosc = round(d3$xmax - d3$xmin, 3),
           wysokosc = round(d3$ymax - d3$ymin, 3), row.names = NULL)
setNames(round(brzeg, 3), formy[-length(formy)])   # granice kafelków przy niezależności

p3 <- ggplot(d3) +
  geom_rect(aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax, fill = zatrudnienie),
            colour = "white", linewidth = 0.8) +
  geom_text(aes((xmin + xmax) / 2, (ymin + ymax) / 2, label = etykieta, colour = zatrudnienie),
            size = 3.8, lineheight = 0.9, show.legend = FALSE) +
  geom_hline(yintercept = brzeg, linetype = "dashed", colour = "grey15", linewidth = 0.5) +
  scale_fill_manual(values = kol, name = NULL) + scale_colour_manual(values = kol_tekst) +
  guides(fill = guide_legend(nrow = 2)) +
  scale_x_continuous(breaks = (x_lewy + x_lewy + szer) / 2,
                     labels = sprintf("%s\n(n = %d)", names(szer), as.vector(margin.table(tab, 1))),
                     expand = expansion(0)) +
  scale_y_continuous(labels = scales::percent, expand = expansion(0)) +
  labs(x = NULL, y = "Odsetek w kierunku", title = "Mozaika: pole kafelka = liczebność komórki",
       subtitle = "Linie przerywane: podział, jakiego oczekiwalibyśmy przy niezależności") +
  motyw + theme(panel.grid = element_blank())
# p3   # zapis: ggsave("tabela-krzyzowa-wykres-mozaikowy.svg", p3, width = 10, height = 6.4)
Wynik w R
      kierunek        zatrudnienie  n szerokosc wysokosc
1  psychologia       umowa o pracę 89     0.450    0.494
2  psychologia umowa cywilnoprawna 45     0.450    0.250
3  psychologia  własna firma (B2B) 16     0.450    0.089
4  psychologia           bez pracy 30     0.450    0.167
5     ekonomia       umowa o pracę 55     0.325    0.423
6     ekonomia umowa cywilnoprawna 32     0.325    0.246
7     ekonomia  własna firma (B2B) 24     0.325    0.185
8     ekonomia           bez pracy 19     0.325    0.146
9  informatyka       umowa o pracę 45     0.225    0.500
10 informatyka umowa cywilnoprawna 13     0.225    0.144
11 informatyka  własna firma (B2B) 30     0.225    0.333
12 informatyka           bez pracy  2     0.225    0.022
      umowa o pracę umowa cywilnoprawna  własna firma (B2B)
              0.472               0.698               0.873
4. Test χ², reszty skorygowane, korekta i symulacja 10 000 tabel: Rysunek 4
R
# Rysunek 4. Mapa skorygowanych reszt standaryzowanych z progiem ±1.96 i progiem po korekcie Bonferroniego
# (kontynuacja: tab, formy, motyw)
test <- chisq.test(tab)
test
round(test$expected, 1)                         # liczebności oczekiwane przy niezależności
round(test$stdres, 2)                           # skorygowane reszty standaryzowane (Haberman)
k <- length(tab)                                # 12 komórek
prog_bonf <- qnorm(1 - .05 / (2 * k))           # dwustronnie, α = .05 podzielone na 12 komórek
round(c(prog_bez_korekty = qnorm(.975), prog_Bonferroni = prog_bonf), 2)

# Ile tabel „ma” co najmniej jedną resztę poza progiem, gdy związku nie ma? 10 000 tabel z tymi samymi brzegami
R <- 10000
set.seed(575)
max_res <- vapply(r2dtable(R, margin.table(tab, 1), margin.table(tab, 2)), function(t) {
  e <- outer(rowSums(t), colSums(t)) / sum(t)
  v <- outer(1 - rowSums(t) / sum(t), 1 - colSums(t) / sum(t))
  max(abs((t - e) / sqrt(e * v)))
}, numeric(1))
odsetek <- c(prog_1.96 = mean(max_res > qnorm(.975)), prog_Bonferroni = mean(max_res > prog_bonf))
round(rbind(odsetek_proc = 100 * odsetek, blad_MC_pp = 100 * sqrt(odsetek * (1 - odsetek) / R)), 2)

d4 <- as.data.frame(as.table(test$stdres), responseName = "reszta")
d4$zatrudnienie <- factor(d4$zatrudnienie, levels = formy)
d4$poziom <- cut(abs(d4$reszta), c(0, qnorm(.975), prog_bonf, Inf),
                 labels = c("|r| < 1.96", "1.96 ≤ |r| < 2.87", "|r| ≥ 2.87 (po korekcie)"))
granica <- max(abs(d4$reszta))
p4 <- ggplot(d4, aes(zatrudnienie, kierunek)) +
  geom_tile(aes(fill = reszta), colour = "white", linewidth = 1) +
  geom_tile(data = subset(d4, poziom != "|r| < 1.96"), aes(linetype = poziom, linewidth = poziom),
            fill = NA, colour = "grey10", width = 0.94, height = 0.92) +
  geom_text(aes(label = sub("-", "−", sprintf("%.2f", reszta))), size = 4.6,
            colour = ifelse(abs(d4$reszta) > 3, "white", "black"),
            fontface = ifelse(abs(d4$reszta) >= prog_bonf, "bold", "plain")) +
  scale_fill_gradientn(colours = colorspace::diverging_hcl(11, "Blue-Red 3"),
                       limits = c(-granica, granica), name = "Reszta skorygowana") +
  scale_linetype_manual(values = c("1.96 ≤ |r| < 2.87" = "dashed", "|r| ≥ 2.87 (po korekcie)" = "solid"),
                        name = NULL, drop = FALSE) +
  scale_linewidth_manual(values = c("1.96 ≤ |r| < 2.87" = 0.7, "|r| ≥ 2.87 (po korekcie)" = 1.4),
                         name = NULL, drop = FALSE) +
  scale_x_discrete(labels = function(x) sub(" ", "\n", x)) + scale_y_discrete(limits = rev) +
  guides(fill = guide_colourbar(barwidth = 12, order = 1), linetype = guide_legend(nrow = 2, order = 2),
         linewidth = guide_legend(nrow = 2, order = 2)) +
  labs(x = NULL, y = NULL, title = "Reszty skorygowane: gdzie tabela odbiega od niezależności",
       subtitle = "Niebieski – mniej osób niż oczekiwano, czerwony – więcej; ramka – reszta poza progiem") +
  motyw + theme(panel.grid = element_blank(), legend.box = "vertical")
# p4   # zapis: ggsave("tabela-krzyzowa-mapa-reszt.svg", p4, width = 10, height = 6.2)
Wynik w R
	Pearson's Chi-squared test

data:  tab
X-squared = 35.286, df = 6, p-value = 3.792e-06

             zatrudnienie
kierunek      umowa o pracę umowa cywilnoprawna własna firma (B2B) bez pracy
  psychologia          85.0                40.5               31.5      23.0
  ekonomia             61.4                29.2               22.8      16.6
  informatyka          42.5                20.2               15.8      11.5
             zatrudnienie
kierunek      umowa o pracę umowa cywilnoprawna własna firma (B2B) bez pracy
  psychologia          0.80                1.08              -4.10      2.12
  ekonomia            -1.37                0.70               0.35      0.78
  informatyka          0.59               -2.08               4.49     -3.40
prog_bez_korekty  prog_Bonferroni
            1.96             2.87
             prog_1.96 prog_Bonferroni
odsetek_proc     40.34            4.29
blad_MC_pp        0.49            0.20
5. Odsetki z 95% przedziałami Wilsona: Rysunek 5
R
# Rysunek 5. Odsetki w kierunkach z 95% przedziałami Wilsona – zamiast skumulowanych słupków
# (kontynuacja: tab, formy, motyw)
wilson <- function(x, n) {                      # przedział Wilsona = prop.test bez poprawki na ciągłość
  ci <- prop.test(x, n, correct = FALSE)$conf.int; c(dolna = ci[1], gorna = ci[2])
}
d5 <- as.data.frame(tab, responseName = "n_komorki")
d5$n_kierunku <- as.vector(margin.table(tab, 1)[d5$kierunek])
d5$odsetek <- d5$n_komorki / d5$n_kierunku
d5 <- cbind(d5, t(mapply(wilson, d5$n_komorki, d5$n_kierunku)))
d5$zatrudnienie <- factor(d5$zatrudnienie, levels = formy)
cbind(d5[, c("kierunek", "zatrudnienie", "n_komorki")], round(100 * d5[, c("odsetek", "dolna", "gorna")], 1))
ogolem <- data.frame(zatrudnienie = factor(formy, levels = formy), odsetek = as.vector(prop.table(margin.table(tab, 2))))

p5 <- ggplot(d5, aes(odsetek, kierunek)) +
  geom_vline(data = ogolem, aes(xintercept = odsetek), linetype = "dashed", colour = "grey40") +
  geom_linerange(aes(xmin = dolna, xmax = gorna), colour = "#003C78", linewidth = 1.2) +
  geom_point(colour = "#003C78", size = 3) +
  geom_text(aes(label = sprintf("%.0f%%", 100 * odsetek)), vjust = -0.9, size = 3.7) +
  facet_wrap(~ zatrudnienie, ncol = 2) +
  scale_x_continuous(labels = scales::percent, limits = c(0, .62), breaks = seq(0, .6, .1)) +
  scale_y_discrete(limits = rev) +
  labs(x = "Odsetek w kierunku z 95% CI (Wilson)", y = NULL, title = "Odsetki z przedziałami: każdy na wspólnej osi",
       subtitle = "Linia przerywana: odsetek w całej próbie (N = 400)") + motyw
# p5   # zapis: ggsave("tabela-krzyzowa-odsetki-z-przedzialami.svg", p5, width = 10, height = 6.6)
Wynik w R
      kierunek        zatrudnienie n_komorki odsetek dolna gorna
1  psychologia       umowa o pracę        89    49.4  42.2  56.7
2     ekonomia       umowa o pracę        55    42.3  34.2  50.9
3  informatyka       umowa o pracę        45    50.0  39.9  60.1
4  psychologia umowa cywilnoprawna        45    25.0  19.2  31.8
5     ekonomia umowa cywilnoprawna        32    24.6  18.0  32.7
6  informatyka umowa cywilnoprawna        13    14.4   8.6  23.2
7  psychologia  własna firma (B2B)        16     8.9   5.5  14.0
8     ekonomia  własna firma (B2B)        24    18.5  12.7  26.0
9  informatyka  własna firma (B2B)        30    33.3  24.5  43.6
10 psychologia           bez pracy        30    16.7  11.9  22.8
11    ekonomia           bez pracy        19    14.6   9.6  21.7
12 informatyka           bez pracy         2     2.2   0.6   7.7
6. V Craméra z przedziałem ufności
R
# V Craméra z 95% przedziałem ufności (odwrócenie niecentralnego rozkładu χ²) i kontrola w pakiecie confintr
# (kontynuacja: tab, test)
chi2 <- unname(test$statistic); df <- unname(test$parameter); N <- sum(tab); m <- min(dim(tab)) - 1
V <- sqrt(chi2 / (N * m))
# szukamy parametrów niecentralności λ, przy których obserwowane χ² leży na 97.5. i 2.5. centylu
lam_d <- uniroot(function(l) pchisq(chi2, df, ncp = l) - .975, c(0, chi2))$root
lam_g <- uniroot(function(l) pchisq(chi2, df, ncp = l) - .025, c(chi2, 10 * chi2))$root
signif(test$p.value, 3)
round(c(chi2 = chi2, df = df, V = V,
        V_dolna = sqrt((lam_d + df) / (N * m)), V_gorna = sqrt((lam_g + df) / (N * m))), 3)
# korekta obciążenia Bergsmy (2013)
phi2 <- max(0, chi2 / N - (nrow(tab) - 1) * (ncol(tab) - 1) / (N - 1))
r_k <- nrow(tab) - (nrow(tab) - 1)^2 / (N - 1); k_k <- ncol(tab) - (ncol(tab) - 1)^2 / (N - 1)
round(c(V_skorygowane = sqrt(phi2 / min(r_k - 1, k_k - 1))), 3)
confintr::ci_cramersv(tab)                      # kontrola: ta sama metoda w pakiecie confintr
Wynik w R
[1] 3.79e-06
   chi2      df       V V_dolna V_gorna
 35.286   6.000   0.210   0.149   0.280
V_skorygowane
        0.192

	Two-sided 95% chi-squared confidence interval for the population
	Cramer's V

Sample estimate: 0.2100189
Confidence interval:
     2.5%     97.5%
0.1490383 0.2798091
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy kolory rysunków przetrwają zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
roznica <- function(k) {                        # najmniejsza odległość ΔE (CIELAB) między kolorami zestawu
  lab <- coords(as(hex2RGB(k), "LAB")); min(dist(lab))
}
zestawy <- list("4 formy zatrudnienia (rysunki 1–3, 5)" = c("#003C78", "#E69F00", "#56B4E9", "#BBBBBB"),
                "3 kierunki (rysunek 2B)" = c("#F0E442", "#CC79A7", "#0f1d3a"),
                "skrajne kolory skali reszt (rysunek 4)" = diverging_hcl(11, "Blue-Red 3")[c(1, 11)],
                "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
round(t(sapply(zestawy, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                      protanopia = roznica(protan(k))))), 1)
Wynik w R
                                       widzenie_typowe deuteranopia protanopia
4 formy zatrudnienia (rysunki 1–3, 5)             37.3         38.9       31.7
3 kierunki (rysunek 2B)                           60.7         54.4       45.7
skrajne kolory skali reszt (rysunek 4)            64.3         66.8       52.8
czerwony – zielony (dla porównania)              121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, test χ², reszty, przedziały Wilsona, symulacja r2dtable i przedział niecentralny – pakiet stats). Rysunki wykonano w ggplot2 (osie procentowe – pakiet scales), panele złożono pakietem patchwork i zapisano pakietem svglite; skalę reszt i paletę sprawdzono pakietem colorspace, a przedział dla V Craméra skontrolowano pakietem confintr. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- confintr (wersja 1.0.2): Mayer, M. (2023). confintr: Confidence intervals [R package]. https://doi.org/10.32614/CRAN.package.confintr
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Słupki liczebności do porównania grup o różnej wielkości. Pokazują głównie, która grupa jest największa (rysunek 1).
- Odsetki liczone w złą stronę. „59% bezrobotnych to psycholodzy” nie znaczy, że psycholodzy częściej są bez pracy (rysunek 2B).
- Brak informacji, co jest 100%. Napisz to na osi i w nocie pod rysunkiem.
- Szukanie „istotnych” komórek z progiem ±1.96 bez korekty. Przy 12 komórkach to fałszywy alarm w 4 tabelach na 10 (rysunek 4).
- Tęczowa albo czerwono-zielona skala reszt bez wartości w komórkach – nieczytelna w druku czarno-białym i przy zaburzeniach widzenia barw.
- Wnioskowanie o różnicy z nakładania się przedziałów dwóch odsetków (rysunek 5).
- Rysunek zamiast liczb. Wykres uzupełnia raport z χ², df, N, p i V Craméra, ale go nie zastępuje.
Najczęstsze pytania
Jak przedstawić tabelę krzyżową na wykresie?
Najczęściej słupkami 100%: każda grupa (np. kierunek studiów) to jeden słupek, a segmenty pokazują odsetki kategorii odpowiedzi. Gdy liczebności grup się różnią, lepsza jest mozaika, w której szerokość kolumny odpowiada liczebności grupy. Do porównań między grupami najdokładniej odczytuje się wykres punktowy odsetków z 95% przedziałami ufności, a do pokazania, gdzie leży związek – mapa skorygowanych reszt.
Odsetki w wierszach czy w kolumnach – co pokazać na wykresie?
Licz odsetki w obrębie grup, które porównujesz w hipotezie. W przykładzie na tej stronie odsetki w kierunkach (wiersze) mówią, jak pracują absolwenci psychologii, ekonomii i informatyki. Odsetki w formach zatrudnienia (kolumny) mówią, z jakich kierunków są np. osoby bez pracy – i zależą od tego, ile osób z każdego kierunku trafiło do próby. Na wykresie zawsze napisz, co jest 100%.
Co to jest wykres mozaikowy?
To wykres tabeli krzyżowej, w którym każda komórka jest prostokątem o polu proporcjonalnym do jej liczebności: szerokość kolumny odpowiada liczebności grupy, a wysokość kafelka – odsetkowi w tej grupie. Przy niezależności zmiennych granice kafelków układałyby się w proste linie przez cały wykres; im bardziej się rozjeżdżają, tym silniejszy związek. W R mozaikę narysujesz w ggplot2 funkcją geom_rect().
Od jakiej wartości reszta standaryzowana skorygowana jest istotna?
Pojedyncza reszta powyżej 1.96 co do modułu odpowiada p < .05 dla jednej komórki. W tabeli 3 × 4 sprawdzasz jednak 12 komórek naraz: w symulacji 10 000 tabel bez żadnego związku co najmniej jedna reszta przekroczyła ±1.96 w 40.34% tabel. Po korekcie Bonferroniego próg wynosi 2.87 i fałszywy alarm zdarzył się w 4.29% tabel.
Jak podać V Craméra z przedziałem ufności?
Razem z wynikiem testu: χ²(6, N = 400) = 35.29, p < .001, V = .21, 95% CI [.15, .28]. Przedział można policzyć, odwracając niecentralny rozkład χ² (np. funkcja ci_cramersv() w pakiecie confintr). W małych próbach V jest zawyżone; wersja z korektą obciążenia dała tu .19.
Powiązane hasła
Przeczytaj też
Paradoks Simpsona – wizualizacja
Chmury punktów z przeciwnymi znakami, zmiana znaku w regresji w 1000 badaniach, odsetki jako średnia ważona i graf przyczynowy – pięć rysunków z kodem R.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikWielokrotne testy w obrazkach
Pięć symulacji w R: 20 testów bez efektu, krzywa FWER, histogram wartości p, progi Holma i BH oraz ogród ścieżek – z kodem i podpisami.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →Nie wiesz, jak pokazać swoją tabelę krzyżową?
Pomożemy policzyć test χ², reszty i wielkość efektu, dobrać wykres do hipotezy i opisać wynik w pracy – tak, żebyś umiał(a) go wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bergsma, W. (2013). A bias-correction for Cramér’s V and Tschuprow’s T. Journal of the Korean Statistical Society, 42(3), 323–328. https://doi.org/10.1016/j.jkss.2012.10.002
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Crameri, F., Shephard, G. E., & Heron, P. J. (2020). The misuse of colour in science communication. Nature Communications, 11(1), Article 5444. https://doi.org/10.1038/s41467-020-19160-7 ● Otwarty dostęp
- Friendly, M. (1994). Mosaic displays for multi-way contingency tables. Journal of the American Statistical Association, 89(425), 190–200. https://doi.org/10.1080/01621459.1994.10476460
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- MacDonald, P. L., & Gardner, R. C. (2000). Type I error rate comparisons of post hoc procedures for I × J chi-square tables. Educational and Psychological Measurement, 60(5), 735–754. https://doi.org/10.1177/00131640021970871
- Sharpe, D. (2015). Chi-square test is statistically significant: Now what? Practical Assessment, Research, and Evaluation, 20, Article 8. https://doi.org/10.7275/tbfa-x148 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bergsma2013bias, author={Bergsma, Wicher}, title={{A bias-correction for Cramér’s V and Tschuprow’s T}}, journal={Journal of the Korean Statistical Society}, year={2013}, volume={42}, number={3}, pages={323--328}, doi={10.1016/j.jkss.2012.10.002}}@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{crameri2020misuse, author={Crameri, Fabio and Shephard, Grace E. and Heron, Philip J.}, title={{The misuse of colour in science communication}}, journal={Nature Communications}, year={2020}, volume={11}, number={1}, eid={5444}, doi={10.1038/s41467-020-19160-7}}@article{friendly1994mosaic, author={Friendly, Michael}, title={{Mosaic displays for multi-way contingency tables}}, journal={Journal of the American Statistical Association}, year={1994}, volume={89}, number={425}, pages={190--200}, doi={10.1080/01621459.1994.10476460}}@article{haberman1973analysis, author={Haberman, Shelby J.}, title={{The analysis of residuals in cross-classified tables}}, journal={Biometrics}, year={1973}, volume={29}, number={1}, pages={205--220}, doi={10.2307/2529686}}@article{macdonald2000type, author={MacDonald, Paul L. and Gardner, Robert C.}, title={{Type I error rate comparisons of post hoc procedures for I × J chi-square tables}}, journal={Educational and Psychological Measurement}, year={2000}, volume={60}, number={5}, pages={735--754}, doi={10.1177/00131640021970871}}@article{sharpe2015chisquare, author={Sharpe, Donald}, title={{Chi-square test is statistically significant: Now what?}}, journal={Practical Assessment, Research, and Evaluation}, year={2015}, volume={20}, eid={8}, doi={10.7275/tbfa-x148}}