Co robi analiza korespondencji
Analiza korespondencji (CA) zamienia tabelę krzyżową dwóch zmiennych jakościowych w mapę, na której wiersze i kolumny są punktami (Greenacre i Hastie, 1987). Działa podobnie jak PCA: rozkłada zróżnicowanie tabeli na kilka wymiarów i pokazuje dwa najważniejsze. Zamiast wariancji analizuje jednak inercję, czyli odchylenia tabeli od niezależności mierzone tak jak w teście χ². Hasło w słowniku wyjaśnia pojęcia na krótkim przykładzie. Tutaj przechodzimy całą analizę krok po kroku w R: od tabeli i testu, przez profile, wkłady i jakość odwzorowania, po dwa rodzaje map i ich poprawne czytanie.
CA to metoda opisowa. Nie testuje hipotez i nie zastępuje testu χ². Pomaga zobaczyć, które kategorie mają podobne profile i jaki jest główny kierunek związku. To przydatne przy tabelach większych niż 2 × 2, w których same procenty trudno ogarnąć (Sourial i in., 2010). Jeśli interesują cię odległości między obiektami, a nie tabela liczebności, zajrzyj do hasła skalowanie wielowymiarowe. Tę samą analizę w programie SPSS opisuje wpis analiza korespondencji w SPSS.
Przykład: kierunek studiów a preferowana forma zajęć
Przykład jest fikcyjny (dane symulowane). 676 studentów z sześciu kierunków wskazało, jaką formę zajęć woli: wykład w sali, ćwiczenia lub warsztaty, zajęcia hybrydowe, zajęcia online na żywo albo nagrania do obejrzenia w dowolnej chwili. Filologia jest celowo mała (n = 16), żeby pokazać pułapkę rzadkiej kategorii. Plik zawiera też tryb studiów i czas dojazdu – przydadzą się w MCA. Dane wygenerowano z ziarnem set.seed(11), wybranym spośród 15 sprawdzonych tak, by drugi wymiar tworzyła głównie mała filologia. Ziarno losowania tablic w kroku z pułapkami (552) ustalono raz, bez dobierania. Plik: korespondencja-kierunek-forma-zajec.csv.
Krok 1. Tabela krzyżowa i test χ²
Zacznij od tabeli liczebności i testu chi-kwadrat niezależności. Jeśli związku nie ma, mapa pokaże głównie szum. U nas związek był istotny, χ²(20) = 95.37, p < .001, a V Craméra wyniosło .19 – efekt umiarkowany, nie ogromny. Liczenie testu ręcznie i jego opis pokazuje wpis test chi-kwadrat krok po kroku.
Inercja całkowita to χ² podzielone przez n: 95.37 / 676 = 0.1411. To jedna liczba, którą CA rozdziela na wymiary. Z inercji łatwo przejść do V Craméra: V = √(0.1411 / 4) = .188, bo mniejszy wymiar tabeli (5 kolumn) minus 1 daje 4. Ponieważ inercja nie zależy od wielkości próby, dwie tabele o różnym n możesz porównać inercją, ale nie surowym χ².
Liczności oczekiwane. Pięć komórek miało liczność oczekiwaną poniżej 5 – wszystkie w wierszu filologii (od 2.7 do 3.5). Przybliżenie rozkładem χ² jest wtedy wątpliwe i chisq.test() ostrzega o tym komunikatem (w kodzie wyciszonym, bo liczności oczekiwane sprawdzamy jawnie). Przy takiej tabeli rozważ dokładny test lub test Monte Carlo (wpis chi-kwadrat czy test Fishera) albo połączenie lub odłożenie rzadkiej kategorii. Do tego wrócimy w części o pułapkach.
Krok 2. Profile, masy i odległość χ²
Profil wiersza to rozkład procentowy w wierszu: jak rozkładają się preferencje w danym kierunku. Profil średni to rozkład w całej próbie, czyli procenty z wiersza sumy. Masa wiersza to jego udział w próbie: psychologia ma masę .222, a filologia tylko .024.
| Kierunek | Wykład | Ćwiczenia | Hybrydowe | Online | Nagrania | Masa |
|---|---|---|---|---|---|---|
| Psychologia | 18.7 | 24.0 | 22.0 | 19.3 | 16.0 | .222 |
| Pedagogika | 20.0 | 26.9 | 23.1 | 13.8 | 16.2 | .192 |
| Pielęgniarstwo | 18.2 | 40.0 | 26.4 | 8.2 | 7.3 | .163 |
| Ekonomia | 14.3 | 11.4 | 21.4 | 27.1 | 25.7 | .207 |
| Informatyka | 10.8 | 10.0 | 17.7 | 27.7 | 33.8 | .192 |
| Filologia | 43.8 | 18.8 | 25.0 | 12.5 | 0.0 | .024 |
| Profil średni | 17.0 | 21.7 | 22.0 | 19.5 | 19.7 | 1.000 |
CA porównuje profile odległością χ². To odległość euklidesowa, w której różnica w każdej kolumnie jest dzielona przez masę tej kolumny – rzadkie odpowiedzi ważą więcej. Profile pielęgniarstwa i informatyki dzieli 1.017, a psychologii i pedagogiki tylko 0.145. Najdalej od profilu średniego leży filologia: kwadrat odległości to 0.650, a dla pielęgniarstwa 0.307. Średnia ważona masami z kwadratów tych odległości znów daje inercję 0.1411. Inercja to więc średnie oddalenie profili od profilu średniego, a 7 osób na 16 wybierających wykład wystarczyło, by filologia była najbardziej „odstającym” kierunkiem.
Krok 3. Wymiary i procent inercji
Tabela 6 × 5 ma najwyżej min(6, 5) − 1 = 4 wymiary. Pakiet ca rozkłada inercję 0.1411 na cztery wartości własne (inercje główne):
| Wymiar | Inercja główna | % inercji | % skumulowany |
|---|---|---|---|
| 1 | 0.1245 | 88.3 | 88.3 |
| 2 | 0.0143 | 10.2 | 98.4 |
| 3 | 0.0018 | 1.3 | 99.8 |
| 4 | 0.0003 | 0.2 | 100.0 |
Pierwszy wymiar przenosi 88.3% inercji, a dwa pierwsze razem 98.4%. Mapa dwuwymiarowa wiernie oddaje więc tabelę. Wysoki procent na wymiarze 1 nie znaczy jednak, że związek jest silny – to procent z inercji 0.1411, a nie z całego zróżnicowania odpowiedzi.
Krok 4. Wkłady i jakość odwzorowania (cos²)
Zanim nazwiesz wymiar, sprawdź dwie liczby dla każdego punktu. Pakiet ca podaje je w promilach, a FactoMineR wkłady w procentach. Pełne wartości zebrano w Tabeli 1 niżej.
- Wkład (ctr) – jaki procent inercji wymiaru tworzy dany punkt. Wymiar nazywasz po punktach o dużych wkładach. Na wymiarze 1 największe wkłady mają pielęgniarstwo (37.9%) i informatyka (34.8%), a wśród form ćwiczenia (37.2%) i nagrania (33.3%). Wymiar 1 to oś: zajęcia praktyczne w sali – nauka zdalna.
- Jakość (cos², w
cakolumnacor) – jaka część oddalenia punktu od środka leży na danym wymiarze. Psychologia ma na wymiarze 1 cos² = .734, a filologia tylko .327 – jej położenie wyjaśnia przede wszystkim wymiar 2 (.669). Suma cos² dla dwóch wymiarów (qlt) mówi, czy punkt dobrze widać na mapie; najsłabiej wypada psychologia (.827).
Wkład i położenie to co innego. Filologia leży na wymiarze 1 w tym samym miejscu co ćwiczenia (−0.461), blisko pielęgniarstwa (−0.539). Ze względu na małą masę jej wkład w ten wymiar wynosi jednak tylko 4.0%. Greenacre (2013) zwraca uwagę, że rzadkie kategorie na obrzeżach mapy sprawiają fałszywe wrażenie ważnych, choć niewiele wnoszą do rozwiązania. Wymiar 2 tworzy w 71.8% sama filologia, a wśród form wykład (60.8%) – 16 osób zdefiniowało całą oś.
Krok 5. Mapa symetryczna czy asymetryczna – co wolno odczytać
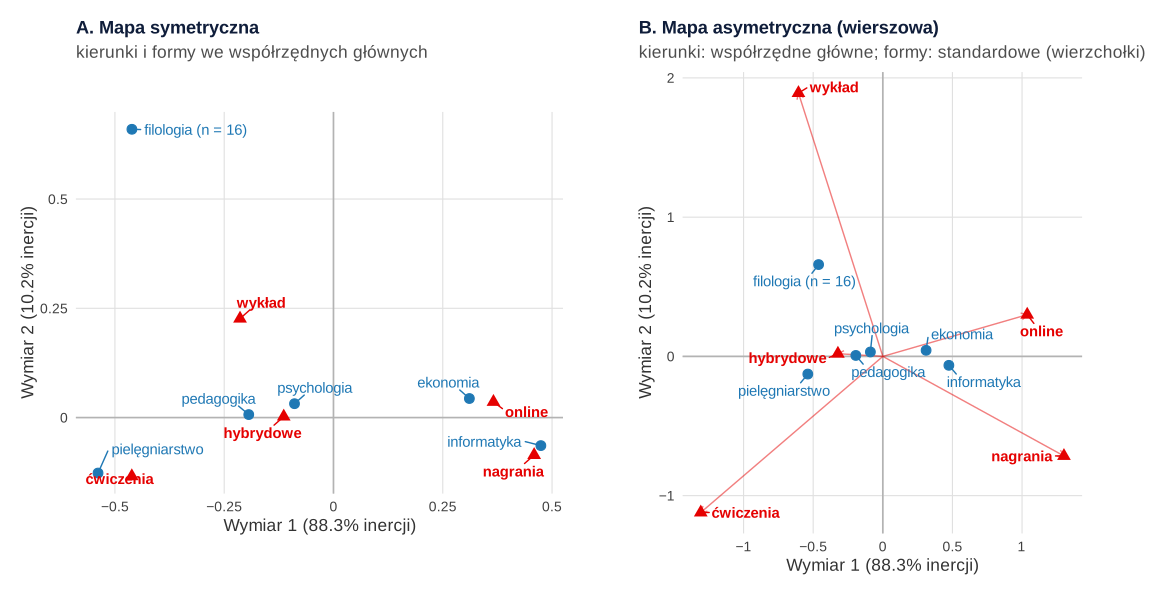
Mapa symetryczna (A) to domyślny wykres w pakiecie ca i w większości programów. Wiersze i kolumny są we współrzędnych głównych. Na takiej mapie wolno czytać:
- odległość kierunek–kierunek – przybliżenie odległości χ² między profilami (na wszystkich wymiarach – dokładnie: pielęgniarstwo–informatyka 1.017);
- odległość forma–forma – tak samo dla profili kolumn;
- położenie względem środka – punkt daleko od środka ma profil odległy od średniego, a punkty po tej samej stronie osi „ciągną” w tym samym kierunku.
Nie wolno wprost czytać odległości kierunek–forma. Oba zbiory punktów zostały tylko nałożone na jeden wykres, a odległość między punktem wiersza i punktem kolumny nie ma w CA określonego znaczenia. Sprawdźmy to na liczbach. Miarą „ta forma jest w tym kierunku częstsza niż przeciętnie” jest iloraz kontyngencji: odsetek w komórce podzielony przez odsetek oczekiwany przy niezależności. Pedagogika leży na mapie A najbliżej zajęć hybrydowych. Jej iloraz dla hybrydowych wynosi jednak 1.05, a dla ćwiczeń 1.24. To samo dotyczy psychologii: najbliżej hybrydowych, a najwyższy iloraz ma dla ćwiczeń (1.10). Zdanie „pedagodzy preferują zajęcia hybrydowe, bo leżą obok siebie” byłoby błędem.
Mapa asymetryczna (B) rozwiązuje ten problem. Kierunki są w współrzędnych głównych, a formy we współrzędnych standardowych – to wierzchołki, czyli położenia „czystych” profili, w których wszyscy wybraliby jedną formę. Taka mapa jest biplotem (Greenacre, 1993): rzut punktu kierunku na strzałkę formy przybliża iloraz kontyngencji. Wzór jest prosty: iloraz ≈ 1 + iloczyn skalarny współrzędnych. Dla pedagogiki i ćwiczeń dwa wymiary dają 1.25 przy rzeczywistym 1.24, a dla pielęgniarstwa i ćwiczeń 1.85 przy 1.84. Ze wszystkimi czterema wymiarami odtworzenie jest dokładne. Przy filologii i nagraniach dwa wymiary dają −0.07, choć iloraz nie może być ujemny – to przybliżenie, a nie odczyt danych.
Wybór mapy zapisz w pracy. Mapa symetryczna dobrze pokazuje podobieństwo kierunków między sobą i form między sobą. Pytanie „które formy wybiera dany kierunek częściej niż przeciętnie” lepiej odczytasz z mapy asymetrycznej, z ilorazów albo z reszt skorygowanych w tabeli krzyżowej.
Krok 6. Kontrola w FactoMineR
Funkcja CA() z pakietu FactoMineR dała te same wartości własne (88.29% na wymiarze 1) i te same współrzędne – różnice bezwzględne wyniosły 0. Programy mogą jednak odwrócić znak wymiaru, bo kierunek osi jest dowolny. Jeśli w innym programie pielęgniarstwo leży po prawej stronie, a w R po lewej, wynik jest ten sam. Różni się też zapis: FactoMineR podaje wkłady w procentach, a ca w promilach (379 ‰ to 37.9%).
Trzy pułapki: małe liczności, drugi wymiar i brak testu
1. Mała kategoria rządzi mapą. Filologia ma 16 osób, a tworzy 10.9% inercji i 71.8% wymiaru 2. Jej profil opiera się na liczbach 7, 3, 4, 2 i 0. Jedna osoba więcej przy nagraniach zmieniłaby go wyraźnie. Rozwiązanie: połącz rzadką kategorię z merytorycznie bliską albo potraktuj ją jako punkt dodatkowy (supplementary). Punkt dodatkowy nie wpływa na wymiary, ale dostaje współrzędne na mapie. Gdy filologia jest dodatkowa, wymiar 1 wyjaśnia 95.6% inercji, a wymiar 2 – tylko 3.0%. Na wymiarze 1 filologia zostaje prawie w tym samym miejscu (−0.429 wobec −0.461), ale już nie tworzy osi.
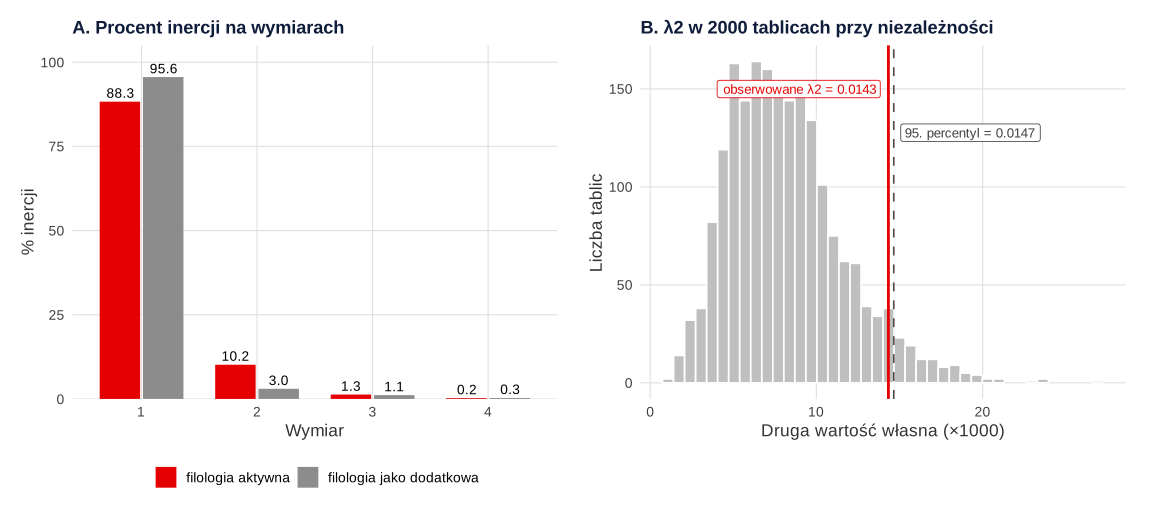
2. Nadinterpretacja drugiego wymiaru. Wymiar 2 z 10.2% inercji kusi, by go nazwać – na przykład „wykład kontra reszta”. Tymczasem w tablicach losowanych przy niezależności, z tymi samymi sumami wierszy i kolumn, druga wartość własna przekraczała 0.0147 w 5% przypadków. Nasza wynosi 0.0143 – nie odróżnia się od tego, co daje przypadek. Bez filologii druga wartość własna spada do 0.0038 przy progu 0.0123. To porównanie jest tylko orientacyjne: tablice losowano bez struktury wymiaru 1. Wniosek jest jednak jasny: opisz jeden wymiar, a drugi pokaż na mapie bez nadawania mu nazwy. Podobną logikę mają bootstrap i testy permutacyjne.
3. Brak testu istotności wymiarów. Test χ² dotyczy całej tabeli. Pakiety ca i FactoMineR nie podają testu dla pojedynczych wymiarów. Liczba wymiarów do opisu to decyzja oparta na procencie inercji, wkładach, interpretowalności i stabilności, którą warto zapisać przed analizą (ogród rozwidlających się ścieżek). Jeśli twoja hipoteza dotyczy konkretnych komórek lub interakcji, potrzebujesz modelu z testami, np. analizy logliniowej.
Wielokrotna analiza korespondencji (MCA) – krótko
Gdy zmiennych jakościowych jest więcej niż dwie, stosuje się wielokrotną analizę korespondencji (Greenacre, 2017). Każda osoba jest wierszem, a każda kategoria kolumną 0/1. Dodaliśmy do kierunku i formy zajęć tryb studiów i czas dojazdu (cztery zmienne, 16 kategorii). FactoMineR (MCA()) i ca (mjca()) dały te same wartości własne: pierwszy wymiar „wyjaśnia” tylko 12.8% inercji, drugi 9.9%, trzeci 9.4%.
Te niskie procenty to cecha analizy macierzy zero-jedynkowej, a nie dowód słabej struktury. Kodowanie 0/1 dodaje sztuczną inercję, więc procenty są zaniżone. Po korekcie inercji (mjca(..., lambda = "adjusted")) pierwszy wymiar wyjaśniał 63.0%, drugi 7.4%. W pracy podaj, którą wersję procentów raportujesz. Jeśli chcesz pogrupować osoby, a nie kategorie, rozważ analizę klas latentnych.
Jak opisać analizę korespondencji w pracy
W rozdziale metodologicznym podaj tabelę i test χ², program i pakiet, rodzaj mapy (symetryczna lub asymetryczna) oraz decyzje o rzadkich kategoriach. W wynikach podaj inercję całkowitą, procent inercji na wymiarach i tabelę wkładów. Przegląd zastosowań i wariantów metody zawiera praca Beha (2004).
Tabela 1
Analiza korespondencji kierunku studiów i preferowanej formy zajęć: masy, współrzędne główne, wkłady w wymiary i jakość odwzorowania
| Kategoria | Masa | Wymiar 1 | Wymiar 2 | Wkład 1 (%) | Wkład 2 (%) | Jakość (cos²) |
|---|---|---|---|---|---|---|
| Kierunek studiów | ||||||
| Psychologia | .222 | −0.089 | 0.032 | 1.4 | 1.6 | .827 |
| Pedagogika | .192 | −0.194 | 0.007 | 5.8 | 0.1 | .920 |
| Pielęgniarstwo | .163 | −0.539 | −0.127 | 37.9 | 18.3 | .999 |
| Ekonomia | .207 | 0.311 | 0.044 | 16.1 | 2.7 | .969 |
| Informatyka | .192 | 0.474 | −0.064 | 34.8 | 5.5 | .992 |
| Filologia | .024 | −0.461 | 0.660 | 4.0 | 71.8 | .996 |
| Preferowana forma zajęć | ||||||
| Wykład | .170 | −0.214 | 0.226 | 6.2 | 60.8 | .985 |
| Ćwiczenia | .217 | −0.461 | −0.134 | 37.2 | 27.3 | .999 |
| Hybrydowe | .220 | −0.114 | 0.002 | 2.3 | 0.0 | .878 |
| Online | .195 | 0.366 | 0.036 | 21.0 | 1.8 | .970 |
| Nagrania | .197 | 0.459 | −0.086 | 33.3 | 10.1 | .985 |
Uwaga. N = 676 (dane fikcyjne). Inercja całkowita = 0.141; wymiar 1 wyjaśnia 88.3%, wymiar 2 – 10.2% inercji. Jakość to suma cos² dla dwóch wymiarów. Wymiar 2 tworzy głównie filologia (n = 16); po potraktowaniu jej jako kategorii dodatkowej wymiar 1 wyjaśnia 95.6% inercji.
Analiza korespondencji w R – pełny kod
Kod odtwarza wszystkie liczby z tekstu i Tabeli 1. Pobierz plik korespondencja-kierunek-forma-zajec.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – kolejne przepisy korzystają z obiektów utworzonych wcześniej. Ziarno losowania tablic w przepisie 6 (552) ustalono raz, bez dobierania pod wynik; ziarno danych fikcyjnych (11) wybrano spośród 15 tak, by drugi wymiar tworzyła mała filologia.
1. Tabela krzyżowa, test χ² i inercja
R
# Analiza korespondencji: kierunek studiów × preferowana forma zajęć (dane fikcyjne)
options(width = 100)
dane <- read.csv("korespondencja-kierunek-forma-zajec.csv", encoding = "UTF-8")
dane$kierunek <- factor(dane$kierunek, levels = c("psychologia", "pedagogika", "pielęgniarstwo",
                                                  "ekonomia", "informatyka", "filologia"))
dane$forma <- factor(dane$forma, levels = c("wykład", "ćwiczenia", "hybrydowe", "online", "nagrania"))
tab <- table(kierunek = dane$kierunek, forma = dane$forma)
addmargins(tab)

# test chi-kwadrat niezależności i liczności oczekiwane
test <- suppressWarnings(chisq.test(tab))
test
round(test$expected["filologia", ], 1)        # liczności oczekiwane w najmniejszym wierszu
sum(test$expected < 5)                         # liczba komórek z licznością oczekiwaną < 5

# inercja całkowita = chi2 / n; V Craméra = pierwiastek z inercji / (min(w, k) - 1)
n <- sum(tab); chi2 <- unname(test$statistic)
round(c(chi2 = chi2, n = n, inercja = chi2 / n, V = sqrt(chi2 / n / (min(dim(tab)) - 1))), 4)
Wynik w R
                forma
kierunek         wykład ćwiczenia hybrydowe online nagrania Sum
  psychologia        28        36        33     29       24 150
  pedagogika         26        35        30     18       21 130
  pielęgniarstwo     20        44        29      9        8 110
  ekonomia           20        16        30     38       36 140
  informatyka        14        13        23     36       44 130
  filologia           7         3         4      2        0  16
  Sum               115       147       149    132      133 676

	Pearson's Chi-squared test

data:  tab
X-squared = 95.366, df = 20, p-value = 8.423e-12

   wykład ćwiczenia hybrydowe    online  nagrania
      2.7       3.5       3.5       3.1       3.1
[1] 5
    chi2        n  inercja        V
 95.3658 676.0000   0.1411   0.1878
2. Profile, masy i odległość χ²
R
# Profile, masy i odległość chi-kwadrat (kontynuacja: tab, n)
P <- tab / n                                   # macierz częstości względnych
masa_w <- rowSums(P); masa_k <- colSums(P)     # masy wierszy i kolumn
profile_w <- prop.table(tab, 1)                # profile wierszy (rozkład form w kierunku)
round(100 * rbind(profile_w, "profil średni" = masa_k), 1)
round(masa_w, 3)

# odległość chi-kwadrat między profilami: różnice ważone odwrotnością masy kolumny
odl_chi2 <- function(a, b) sqrt(sum((a - b)^2 / masa_k))
round(c(pielegn_informat = odl_chi2(profile_w["pielęgniarstwo", ], profile_w["informatyka", ]),
        psych_pedag      = odl_chi2(profile_w["psychologia", ],    profile_w["pedagogika", ])), 3)

# inercja = średnia ważona masami kwadratów odległości profili od profilu średniego
d2_od_sredniego <- apply(profile_w, 1, odl_chi2, b = masa_k)^2
round(d2_od_sredniego, 4)
round(sum(masa_w * d2_od_sredniego), 4)
Wynik w R
               wykład ćwiczenia hybrydowe online nagrania
psychologia      18.7      24.0      22.0   19.3     16.0
pedagogika       20.0      26.9      23.1   13.8     16.2
pielęgniarstwo   18.2      40.0      26.4    8.2      7.3
ekonomia         14.3      11.4      21.4   27.1     25.7
informatyka      10.8      10.0      17.7   27.7     33.8
filologia        43.8      18.8      25.0   12.5      0.0
profil średni    17.0      21.7      22.0   19.5     19.7
   psychologia     pedagogika pielęgniarstwo       ekonomia    informatyka      filologia
         0.222          0.192          0.163          0.207          0.192          0.024
pielegn_informat      psych_pedag
           1.017            0.145
   psychologia     pedagogika pielęgniarstwo       ekonomia    informatyka      filologia
        0.0108         0.0409         0.3066         0.1017         0.2312         0.6504
[1] 0.1411
3. Analiza korespondencji: wymiary, wkłady i jakość
R
# Analiza korespondencji pakietem ca: wymiary, % inercji, masy, jakość, wkłady (kontynuacja: tab)
library(ca)
ak <- ca(tab)
summary(ak)            # wartości w tabelach wierszy i kolumn: w promilach (mass, qlt, inr, cor, ctr) i ×1000 (k)
round(sum(ak$sv^2), 4) # suma wartości własnych = inercja całkowita
Wynik w R
Principal inertias (eigenvalues):

 dim    value      %   cum%   scree plot
 1      0.124549  88.3  88.3  **********************
 2      0.014334  10.2  98.4  ***
 3      0.001842   1.3  99.8
 4      0.000349   0.2 100.0
        -------- -----
 Total: 0.141074 100.0


Rows:
    name   mass  qlt  inr    k=1 cor ctr    k=2 cor ctr
1 | psyc |  222  827   17 |  -89 734  14 |   32  93  16 |
2 | pdgg |  192  920   56 | -194 919  58 |    7   1   1 |
3 | plęg |  163  999  354 | -539 946 379 | -127  53 183 |
4 | eknm |  207  969  149 |  311 950 161 |   44  19  27 |
5 | infr |  192  992  315 |  474 974 348 |  -64  18  55 |
6 | fllg |   24  996  109 | -461 327  40 |  660 669 718 |

Columns:
    name   mass  qlt  inr    k=1 cor ctr    k=2 cor ctr
1 | wykł |  170  985  119 | -214 464  62 |  226 521 608 |
2 | ćwcz |  217  999  356 | -461 921 372 | -134  78 273 |
3 | hybr |  220  878   23 | -114 878  23 |    2   0   0 |
4 | onln |  195  970  193 |  366 961 210 |   36   9  18 |
5 | ngrn |  197  985  309 |  459 951 333 |  -86  33 101 |
[1] 0.1411
4. Co wolno odczytać z mapy
R
# Co wolno odczytać z mapy (kontynuacja: tab, P, masa_w, masa_k, ak)
F_w  <- ak$rowcoord %*% diag(ak$sv)            # współrzędne główne wierszy
G_k  <- ak$colcoord %*% diag(ak$sv)            # współrzędne główne kolumn
Gs_k <- ak$colcoord                            # współrzędne standardowe kolumn (wierzchołki)
dimnames(F_w) <- list(rownames(tab), paste0("wym", 1:4))
dimnames(G_k) <- dimnames(Gs_k) <- list(colnames(tab), paste0("wym", 1:4))
round(F_w[, 1:2], 3); round(G_k[, 1:2], 3)

# 1. Odległość wiersz–wiersz na mapie głównej (wszystkie wymiary) = odległość chi-kwadrat profili
round(sqrt(sum((F_w["pielęgniarstwo", ] - F_w["informatyka", ])^2)), 3)

# 2. Iloraz kontyngencji p_ij / (r_i c_j): powyżej 1 = forma częstsza niż przeciętnie
iloraz <- P / outer(masa_w, masa_k)
round(iloraz, 2)

# 3. Mapa asymetryczna: iloczyn skalarny wiersz (główne) × kolumna (standardowe) przybliża iloraz − 1
przybl_2w <- 1 + F_w[, 1:2] %*% t(Gs_k[, 1:2])
round(przybl_2w, 2)
round(max(abs(1 + F_w %*% t(Gs_k) - iloraz)), 10)   # wszystkie wymiary: odtworzenie dokładne

# 4. Pułapka mapy symetrycznej: najbliższa kolumna na mapie a forma najbardziej nadreprezentowana
najblizsza <- apply(F_w[, 1:2], 1, function(f) colnames(tab)[which.min(colSums((t(G_k[, 1:2]) - f)^2))])
najwyzszy_iloraz <- colnames(tab)[apply(iloraz, 1, which.max)]
data.frame(najblizsza_na_mapie = najblizsza, najwyzszy_iloraz = najwyzszy_iloraz)
Wynik w R
                 wym1   wym2
psychologia    -0.089  0.032
pedagogika     -0.194  0.007
pielęgniarstwo -0.539 -0.127
ekonomia        0.311  0.044
informatyka     0.474 -0.064
filologia      -0.461  0.660
            wym1   wym2
wykład    -0.214  0.226
ćwiczenia -0.461 -0.134
hybrydowe -0.114  0.002
online     0.366  0.036
nagrania   0.459 -0.086
[1] 1.017
                forma
kierunek         wykład ćwiczenia hybrydowe online nagrania
  psychologia      1.10      1.10      1.00   0.99     0.81
  pedagogika       1.18      1.24      1.05   0.71     0.82
  pielęgniarstwo   1.07      1.84      1.20   0.42     0.37
  ekonomia         0.84      0.53      0.97   1.39     1.31
  informatyka      0.63      0.46      0.80   1.42     1.72
  filologia        2.57      0.86      1.13   0.64     0.00
               wykład ćwiczenia hybrydowe online nagrania
psychologia      1.11      1.08      1.03   0.92     0.86
pedagogika       1.13      1.25      1.06   0.80     0.74
pielęgniarstwo   1.09      1.85      1.17   0.40     0.39
ekonomia         0.89      0.54      0.90   1.34     1.37
informatyka      0.59      0.45      0.85   1.47     1.66
filologia        2.53      0.86      1.16   0.72    -0.07
[1] 0
               najblizsza_na_mapie najwyzszy_iloraz
psychologia              hybrydowe        ćwiczenia
pedagogika               hybrydowe        ćwiczenia
pielęgniarstwo           ćwiczenia        ćwiczenia
ekonomia                    online           online
informatyka               nagrania         nagrania
filologia                   wykład           wykład
5. Kontrola w FactoMineR
R
# Kontrola: ten sam wynik w FactoMineR (kontynuacja: tab, ak, F_w, G_k)
library(FactoMineR)
fm <- CA(as.data.frame.matrix(tab), graph = FALSE)
round(fm$eig, 4)
# współrzędne mogą mieć odwrócony znak wymiaru – porównujemy wartości bezwzględne
round(c(wiersze = max(abs(abs(fm$row$coord[, 1:2]) - abs(F_w[, 1:2]))),
        kolumny = max(abs(abs(fm$col$coord[, 1:2]) - abs(G_k[, 1:2])))), 10)
round(fm$row$contrib[, 1:2], 1)        # wkłady w % (ca: w promilach)
round(fm$row$cos2[, 1:2], 3)           # jakość odwzorowania cos2
Wynik w R
      eigenvalue percentage of variance cumulative percentage of variance
dim 1     0.1245                88.2865                           88.2865
dim 2     0.0143                10.1607                           98.4473
dim 3     0.0018                 1.3054                           99.7527
dim 4     0.0003                 0.2473                          100.0000
wiersze kolumny
      0       0
               Dim 1 Dim 2
psychologia      1.4   1.6
pedagogika       5.8   0.1
pielęgniarstwo  37.9  18.3
ekonomia        16.1   2.7
informatyka     34.8   5.5
filologia        4.0  71.8
               Dim 1 Dim 2
psychologia    0.734 0.093
pedagogika     0.919 0.001
pielęgniarstwo 0.946 0.053
ekonomia       0.950 0.019
informatyka    0.974 0.018
filologia      0.327 0.669
6. Rzadka kategoria i drugi wymiar
R
# Pułapki: rzadka kategoria i drugi wymiar (kontynuacja: tab, ak)
# 1. Filologia (n = 16) jako wiersz dodatkowy: nie wpływa na wymiary, ale dostaje współrzędne
ak_sup <- ca(tab, suprow = which(rownames(tab) == "filologia"))
round(100 * ak$sv^2 / sum(ak$sv^2), 1)              # % inercji: filologia aktywna
round(100 * ak_sup$sv^2 / sum(ak_sup$sv^2), 1)      # % inercji: filologia jako dodatkowa
round(ak$rowcoord["filologia", 1:2] * ak$sv[1:2], 3)            # filologia aktywna (współrzędne główne)
round(ak_sup$rowcoord["filologia", 1:2] * ak_sup$sv[1:2], 3)    # filologia dodatkowa

# 2. Drugi wymiar a tablice losowane przy niezależności (te same sumy brzegowe); orientacyjnie, nie test
set.seed(552)
l2_null <- function(t) replicate(2000, ca(r2dtable(1, rowSums(t), colSums(t))[[1]])$sv[2]^2)
tab5 <- tab[rownames(tab) != "filologia", ]
wynik <- rbind(
  "z filologią" = c(lambda2 = ak$sv[2]^2, p95_niezal = quantile(l2_null(tab), .95, names = FALSE)),
  "bez filologii" = c(lambda2 = ca(tab5)$sv[2]^2, p95_niezal = quantile(l2_null(tab5), .95, names = FALSE)))
round(wynik, 4)
Wynik w R
[1] 88.3 10.2  1.3  0.2
[1] 95.6  3.0  1.1  0.3
  Dim1   Dim2
-0.461  0.660
  Dim1   Dim2
-0.429 -0.632
              lambda2 p95_niezal
z filologią    0.0143     0.0147
bez filologii  0.0038     0.0123
7. Wielokrotna analiza korespondencji
R
# Wielokrotna analiza korespondencji (MCA): cztery zmienne jakościowe (kontynuacja: dane)
dane$tryb <- factor(dane$tryb); dane$dojazd <- factor(dane$dojazd)
zm <- dane[, c("kierunek", "forma", "tryb", "dojazd")]
mca_ind <- mjca(zm, lambda = "indicator")   # analiza macierzy zero-jedynkowej
mca_adj <- mjca(zm, lambda = "adjusted")    # inercje skorygowane
round(100 * mca_ind$sv[1:3]^2 / sum(mca_ind$sv^2), 1)   # % inercji – macierz zero-jedynkowa
round(mca_adj$inertia.e[1:3] * 100, 1)                   # % inercji – po korekcie
fm_mca <- MCA(zm, graph = FALSE)
round(fm_mca$eig[1:3, ], 3)                              # FactoMineR: te same wartości własne co wersja zero-jedynkowa
Wynik w R
[1] 12.8  9.9  9.4
[1] 63.0  7.4  3.8
      eigenvalue percentage of variance cumulative percentage of variance
dim 1      0.383                 12.761                            12.761
dim 2      0.296                  9.850                            22.611
dim 3      0.283                  9.420                            32.031
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2, ggrepel i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ca (wersja 0.71.1): Nenadić, O., & Greenacre, M. (2007). Correspondence analysis in R, with two- and three-dimensional graphics: The ca package. Journal of Statistical Software, 20(3), 1–13. https://doi.org/10.18637/jss.v020.i03
- FactoMineR (wersja 2.13): Lê, S., Josse, J., & Husson, F. (2008). FactoMineR: An R package for multivariate analysis. Journal of Statistical Software, 25(1), 1–18. https://doi.org/10.18637/jss.v025.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Czytanie odległości punkt kierunku – punkt formy na mapie symetrycznej jako siły związku.
- Mapa bez testu χ² albo przy nieistotnym związku – wtedy pokazuje głównie szum.
- Nazywanie wymiaru po położeniu punktów, bez sprawdzenia wkładów; rzadka kategoria na obrzeżu wygląda na ważną.
- Interpretacja drugiego wymiaru, który tworzy jedna mała kategoria albo który nie odróżnia się od przypadku.
- Brak procentu inercji i rodzaju mapy w opisie; w MCA – brak informacji, czy procenty są skorygowane.
- Traktowanie mapy jako dowodu („analiza korespondencji wykazała, że…”). Mapa opisuje tabelę, nie testuje hipotez.
Więcej o pracy z tabelami krzyżowymi w badaniach społecznych znajdziesz we wpisie statystyka w pracy z socjologii, a o wyborze metod wymiarowych – we wpisie PCA czy analiza czynnikowa.
Najczęstsze pytania
Jak zrobić analizę korespondencji w R krok po kroku?
Zbuduj tabelę krzyżową (table()), sprawdź związek testem chisq.test(), a potem uruchom ca::ca(tab) i summary(). Odczytaj procent inercji na wymiarach, wkłady (ctr) i jakość odwzorowania (cor, qlt), narysuj mapę i opisz tylko wymiary, które mają sens. Ten sam wynik daje FactoMineR::CA().
Czy na mapie analizy korespondencji punkt wiersza blisko punktu kolumny oznacza związek?
Nie wprost. Na mapie symetrycznej odległość między punktem wiersza i punktem kolumny nie ma określonego znaczenia – w przykładzie pedagogika leżała obok zajęć hybrydowych, a najczęściej ponad przeciętność wybierała ćwiczenia. Związek wiersza z kolumną odczytuj z mapy asymetrycznej (rzut na kierunek wierzchołka), z ilorazów kontyngencji albo z reszt skorygowanych w tabeli.
Co to jest inercja w analizie korespondencji i jak ma się do chi-kwadrat?
Inercja całkowita to χ² podzielone przez liczebność próby. W przykładzie χ² = 95.37 przy n = 676 dało inercję 0.141. Analiza korespondencji dzieli tę inercję na wymiary, a procent inercji mówi, jaką część odchylenia tabeli od niezależności pokazuje dany wymiar.
Ile wymiarów analizy korespondencji interpretować?
Nie ma standardowego testu istotności pojedynczych wymiarów. Decyduj na podstawie procentu inercji, wkładów, interpretowalności i stabilności. Nie nazywaj wymiaru tworzonego przez jedną małą kategorię ani takiego, którego wartość własna nie odróżnia się od tablic losowanych przy niezależności.
Dlaczego w wielokrotnej analizie korespondencji (MCA) procent inercji jest tak niski?
Bo MCA analizuje macierz zero-jedynkową, a takie kodowanie dodaje sztuczną inercję. W przykładzie pierwszy wymiar wyjaśniał 12.8% inercji, a po korekcie (mjca(..., lambda = "adjusted")) 63.0%. W pracy podaj, którą wersję raportujesz.
Powiązane hasła
Przeczytaj też
Analiza korespondencji w SPSS krok po kroku
Correspondence Analysis od pliku .sav po opis APA: Define Range, normalizacje, tabela Summary, wkłady punktów i czytanie biplotu.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikChi-kwadrat w SPSS krok po kroku
Crosstabs w SPSS od pliku po opis APA: opcje Statistics i Cells, wiersz Pearsona, V Craméra, reszty skorygowane, test dokładny, Weight Cases i składnia CROSSTABS – z plikiem .sav.
Czytaj →PoradnikMapa percepcji marek
Sześć marek, 10 cech: analiza korespondencji, pułapka wielkości marki, indeksy, biplot PCA z efektem halo i bootstrap mapy – sześć rysunków z kodem R.
Czytaj →Robisz analizę korespondencji do pracy dyplomowej?
Pomożemy przygotować tabelę, wybrać rodzaj mapy i liczbę wymiarów, sprawdzić rzadkie kategorie i opisać wyniki tak, żebyś umiał(a) je wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Beh, E. J. (2004). Simple correspondence analysis: A bibliographic review. International Statistical Review, 72(2), 257–284. https://doi.org/10.1111/j.1751-5823.2004.tb00236.x
- Greenacre, M. (2013). Contribution biplots. Journal of Computational and Graphical Statistics, 22(1), 107–122. https://doi.org/10.1080/10618600.2012.702494 ● Otwarty dostęp: pełny tekst
- Greenacre, M. (2017). Correspondence analysis in practice (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315369983
- Greenacre, M. J. (1993). Biplots in correspondence analysis. Journal of Applied Statistics, 20(2), 251–269. https://doi.org/10.1080/02664769300000021
- Greenacre, M., & Hastie, T. (1987). The geometric interpretation of correspondence analysis. Journal of the American Statistical Association, 82(398), 437–447. https://doi.org/10.1080/01621459.1987.10478446
- Sourial, N., Wolfson, C., Zhu, B., Quail, J., Fletcher, J., Karunananthan, S., Bandeen-Roche, K., Béland, F., & Bergman, H. (2010). Correspondence analysis is a useful tool to uncover the relationships among categorical variables. Journal of Clinical Epidemiology, 63(6), 638–646. https://doi.org/10.1016/j.jclinepi.2009.08.008 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{beh2004simple, author={Beh, Eric J.}, title={{Simple correspondence analysis: A bibliographic review}}, journal={International Statistical Review}, year={2004}, volume={72}, number={2}, pages={257--284}, doi={10.1111/j.1751-5823.2004.tb00236.x}}@article{greenacre2013contribution, author={Greenacre, Michael}, title={{Contribution biplots}}, journal={Journal of Computational and Graphical Statistics}, year={2013}, volume={22}, number={1}, pages={107--122}, doi={10.1080/10618600.2012.702494}}@book{greenacre2017correspondence, author={Greenacre, Michael}, title={{Correspondence analysis in practice}}, year={2017}, edition={3}, publisher={Chapman and Hall/CRC}, doi={10.1201/9781315369983}}@article{greenacre1993biplots, author={Greenacre, Michael J.}, title={{Biplots in correspondence analysis}}, journal={Journal of Applied Statistics}, year={1993}, volume={20}, number={2}, pages={251--269}, doi={10.1080/02664769300000021}}@article{greenacre1987geometric, author={Greenacre, Michael and Hastie, Trevor}, title={{The geometric interpretation of correspondence analysis}}, journal={Journal of the American Statistical Association}, year={1987}, volume={82}, number={398}, pages={437--447}, doi={10.1080/01621459.1987.10478446}}@article{sourial2010correspondence, author={Sourial, Nadia and Wolfson, Christina and Zhu, Bin and Quail, Jacqueline and Fletcher, John and Karunananthan, Sathya and Bandeen-Roche, Karen and B{\'e}land, Fran{\c{c}}ois and Bergman, Howard}, title={{Correspondence analysis is a useful tool to uncover the relationships among categorical variables}}, journal={Journal of Clinical Epidemiology}, year={2010}, volume={63}, number={6}, pages={638--646}, doi={10.1016/j.jclinepi.2009.08.008}}