Co to jest V Craméra?
V Craméra (ang. Cramér's V) to miara siły związku między dwiema zmiennymi jakościowymi, zwykle mierzonymi na skali nominalnej. Oblicza się ją ze statystyki χ² testu chi-kwadrat niezależności. Przyjmuje wartości od 0 (brak związku) do 1 (pełna zależność), a dla tabel większych niż 2 × 2 jest odpowiednikiem współczynnika φ (Akoglu, 2018). Miarę tę zaproponował Harald Cramér w klasycznej monografii Mathematical Methods of Statistics (Cramér, 1946).
Po co osobna miara? Test χ² odpowiada na pytanie, czy związek istnieje, ale wartość χ² rośnie razem z liczebnością próby, więc nie mówi, jak silny jest związek. McHugh (2013) podkreśla, że test χ² trzeba uzupełnić miarą siły związku – najczęściej właśnie V Craméra. Kim (2017) przypomina, że φ i iloraz szans stosuje się tylko do tabel 2 × 2, a dla większych tabel – V Craméra. W pracach z psychologii V podaje się np. przy związku kierunku studiów z wybraną formą pomocy albo roku studiów ze strategią radzenia sobie ze stresem.
Wzór na V Craméra
- χ² – statystyka testu chi-kwadrat Pearsona dla tabeli krzyżowej (bez poprawki Yatesa),
- N – liczebność próby,
- r, c – liczba wierszy i kolumn; k – mniejsza z tych liczb.
Największa możliwa wartość χ² w tabeli r × c wynosi N(k − 1), więc dzielenie przez to wyrażenie sprowadza wynik do przedziału od 0 do 1. Współczynnik φ = √(χ² / N) (to samo co w Cohena) w tabelach większych niż 2 × 2 może przekroczyć 1 – jego maksimum to √(k − 1). Stąd prosta zależność V = φ / √(k − 1). W tabeli 2 × 2 k − 1 = 1, więc V = |φ|. Pamiętaj, że V nie ma znaku: nie mówi, w którą stronę idzie związek – to pokażą procenty w tabeli krzyżowej i reszty standaryzowane.
Przykład obliczeń
W przykładzie z hasła o teście niezależności 320 studentów (dane symulowane) wskazało preferowaną strategię radzenia sobie ze stresem (zadaniowa, emocjonalna, unikowa); tabela ma 4 wiersze (rok studiów) i 3 kolumny, więc k − 1 = 2. Test dał χ²(6, N = 320) = 19.19, p = .004:
Przedział ufności policzono w pakiecie DescTools metodą opartą na niecentralnym rozkładzie χ². Dla porównania tabela 2 × 2 z hasła o tabeli krzyżowej (udział w warsztatach × zdanie egzaminu, N = 200) dała χ²(1) = 6.00, czyli φ = V = √(6.00 / 200) = .17. Ta sama wartość V = .17 nie oznacza jednak tak samo silnego związku – to zależy od wielkości tabeli.
Interpretacja: progi zależą od wielkości tabeli
Kim (2017) podaje progi interpretacji V zależne od liczby stopni swobody; dla df = 1 (tabela 2 × 2) są to .10, .30 i .50 dla efektu małego, średniego i dużego. Takie progi otrzymasz, dzieląc konwencjonalne wartości w Cohena (1992) – 0.10, 0.30 i 0.50 – przez √(k − 1):
| k − 1 (mniejszy wymiar tabeli − 1) | Przykładowe tabele | Mały | Średni | Duży |
|---|---|---|---|---|
| 1 | 2 × 2, 2 × 5 | .10 | .30 | .50 |
| 2 | 3 × 3, 4 × 3 | .07 | .21 | .35 |
| 3 | 4 × 4, 4 × 6 | .06 | .17 | .29 |
| 4 | 5 × 5 | .05 | .15 | .25 |
W tabeli 4 × 3 wartość V = .17 leży między progiem małego (.07) a średniego efektu (.21), bliżej średniego. W tabeli 2 × 2 to samo V = .17 jest bliżej efektu małego (.10) niż średniego (.30). Inne źródła stosują jeszcze inne skale: Akoglu (2018) przytacza taką, w której już V > .25 oznacza związek „bardzo silny”, i zwraca uwagę, że różni autorzy różnie nazywają te same wartości. Do tego McHugh (2013) zauważa, że V daje stosunkowo niskie wartości nawet przy wysoce istotnych wynikach. Dlatego słowne etykiety traktuj orientacyjnie: podaj V z przedziałem ufności, opisz procenty w tabeli i porównaj wynik z badaniami z Twojej dziedziny (zob. wielkość efektu: jak ocenić znaczenie wyniku).
V w małych próbach: obciążenie i korekta Bergsmy
Statystyka χ² nie może być ujemna, dlatego V obliczone w próbie jest większe od zera nawet wtedy, gdy w populacji zmienne są całkowicie niezależne. Pokazuje to symulacja: wylosowaliśmy po 4000 tabel z populacji, w której V = 0. Dla tabeli 4 × 3 średnie V wyniosło .31 przy N = 30, .17 przy N = 100, .09 przy N = 320 i .05 przy N = 1000; dla tabeli 5 × 5 i N = 30 – aż .37.
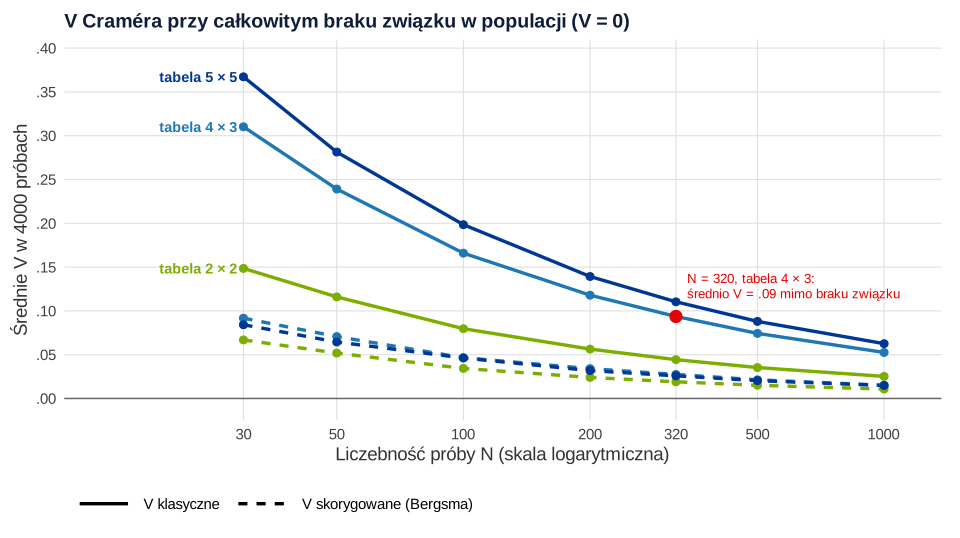
Bergsma (2013) pokazuje, że klasyczne V może mieć w skończonych próbach duże obciążenie, i proponuje prostą korektę. W jego symulacjach skorygowany estymator był lepszy od klasycznego dla tabel większych niż 2 × 2 (dla 2 × 2 – porównywalny), a przewaga rosła wraz z wielkością tabeli i spadkiem liczebności próby. Korekta odejmuje od φ² wartość oczekiwaną przy braku związku i poprawia mianownik:
W naszym przykładzie skorygowane V wynosi .14 zamiast .17. Ma to praktyczne skutki: funkcja cramers_v() z pakietu effectsize domyślnie podaje wersję skorygowaną, a SPSS i wzór klasyczny – nieskorygowaną. Te same dane mogą więc dać .14 w jednym programie i .17 w drugim. W pracy zawsze napisz, którą wersję podajesz.
V Craméra a inne miary związku
V Craméra nie jest jedyną miarą dla tabel krzyżowych. Wybór zależy od wielkości tabeli i skali pomiaru zmiennych:
| Miara | Kiedy stosować | Zakres | Tabela 4 × 3 z przykładu |
|---|---|---|---|
| φ | Tabela 2 × 2; to korelacja Pearsona dwóch zmiennych zakodowanych 0/1 | od −1 do 1 | – |
| Iloraz szans | Tabela 2 × 2, także w regresji logistycznej | od 0 do ∞ | – |
| V Craméra | Dowolna tabela r × c, zmienne nominalne | od 0 do 1 | .17 |
| T Czuprowa | Tabela r × c; w tabelach kwadratowych równe V, w pozostałych mniejsze | od 0 do 1 | .16 |
| Współczynnik kontyngencji C | Tabela r × c; jego maksimum zależy od wielkości tabeli (tu .82), co utrudnia porównania | od 0 do wartości < 1 | .24 |
| Tau-b Kendalla, rho Spearmana | Obie zmienne porządkowe, zależność monotoniczna | od −1 do 1 | – |
| Kappa Cohena | Zgodność dwóch ocen tych samych osób (nie siła związku) | od −1 do 1 | – |
Bergsma (2013) zaproponował korektę obciążenia zarówno dla V, jak i dla blisko z nim spokrewnionego T Czuprowa. Najczęściej raportowaną miarą siły związku dla testu χ² pozostaje jednak V (McHugh, 2013) – dla tabel 2 × 2 warto dodać iloraz szans.
Jak opisać wynik w pracy (APA)
Podaj V zaraz po wyniku testu χ², bez zera przed kropką (bo V nie przekracza 1), najlepiej z 95% przedziałem ufności i informacją o wersji miary:
Kierunek związku opisz osobno – procentami w grupach i skorygowanymi resztami standaryzowanymi, jak w haśle o teście chi-kwadrat niezależności. Gotowe sformułowania dla innych testów zebraliśmy w poradniku jak opisać wyniki w stylu APA.
V Craméra w R
Kod liczy V ze wzoru, z przedziałem ufności (DescTools) oraz w pakiecie effectsize – w wersji klasycznej i skorygowanej. W SPSS: Analiza → Opis statystyczny → Tabele krzyżowe → Statystyki → Phi i V Craméra; SPSS podaje klasyczne V bez przedziału ufności.
V klasyczne, przedział ufności i V skorygowane
R
library(DescTools)
library(effectsize)
tab <- matrix(c(35, 41, 19,
                32, 28, 20,
                40, 19, 16,
                46, 13, 11), nrow = 4, byrow = TRUE)     # rok studiów × strategia (N = 320)
chi <- unname(chisq.test(tab)$statistic)
N <- sum(tab); k <- min(dim(tab))
sqrt(chi / (N * (k - 1)))                                 # V Craméra ze wzoru
CramerV(tab, conf.level = 0.95)                           # V z 95% CI (DescTools)
cramers_v(tab, adjust = FALSE, alternative = "two.sided") # to samo w effectsize
cramers_v(tab)                                            # domyślnie: V skorygowane o obciążenie
Wynik w R
[1] 0.1731647
  Cramer V     lwr.ci     upr.ci
0.17316474 0.05866842 0.23103248
Cramer's V |       95% CI
-------------------------
0.17       | [0.06, 0.23]
Cramer's V (adj.) |       95% CI
--------------------------------
0.14              | [0.00, 1.00]

- One-sided CIs: upper bound fixed at [1.00].
Domyślnie effectsize podaje przedział jednostronny (górna granica ustalona na 1); dwustronny 95% CI uzyskasz argumentem alternative = "two.sided".
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek (symulacja) przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Progi .10, .30 i .50 dla każdej tabeli. Dotyczą tabel 2 × 2; dla większych tabel progi są niższe (Kim, 2017).
- Porównywanie V między tabelami różnej wielkości lub z bardzo różnych prób bez uwzględnienia obciążenia – w małych próbach i dużych tabelach V bywa wyraźnie zawyżone (Bergsma, 2013).
- Brak informacji, którą wersję podajesz – klasyczne V (SPSS, wzór) czy skorygowane (domyślnie w effectsize).
- Czytanie V jak korelacji ze znakiem. V nie wskazuje kierunku. Gdy obie zmienne są porządkowe i interesuje Cię zależność monotoniczna, lepiej sprawdzą się korelacja Spearmana lub tau-b Kendalla.
- Mylenie związku ze zgodnością. Gdy dwóch oceniających klasyfikuje te same osoby, wysokie V nie oznacza, że wybierali te same kategorie – do zgodności służy kappa Cohena.
- Samo V bez tabeli i testu – czytelnik potrzebuje też χ², df, N i procentów, by ocenić wynik (zob. wielkość efektu).
Najczęstsze pytania
Co to jest V Craméra?
V Craméra to miara siły związku między dwiema zmiennymi jakościowymi (najczęściej nominalnymi), obliczana ze statystyki χ² testu niezależności. Przyjmuje wartości od 0, gdy zmienne są niezależne, do 1 przy pełnej zależności. Uzupełnia test chi-kwadrat, który mówi tylko o istotności związku.
Jak obliczyć V Craméra?
Podziel statystykę χ² przez iloczyn liczebności próby i (k − 1), gdzie k to mniejsza z liczb wierszy i kolumn, a wynik spierwiastkuj: V = √[χ² / (N(k − 1))]. Na przykład dla χ² = 19.19, N = 320 i tabeli 4 × 3: V = √(19.19 / 640) = .17. W R: DescTools::CramerV(tab).
Jak interpretować V Craméra?
Progi zależą od wielkości tabeli. Dla tabeli 2 × 2 przyjmuje się .10, .30 i .50 (efekt mały, średni i duży), dla tabel z k − 1 = 2 (np. 3 × 3) – .07, .21 i .35, a dla k − 1 = 3 – .06, .17 i .29. Różni autorzy stosują jednak różne skale, więc podaj też przedział ufności i porównaj wynik z badaniami w swojej dziedzinie.
Czym różni się V Craméra od współczynnika phi?
Współczynnik φ = √(χ² / N) stosuje się do tabel 2 × 2, gdzie może mieć znak. W większych tabelach φ może przekroczyć 1, dlatego V Craméra dzieli go przez √(k − 1). W tabeli 2 × 2 obie miary mają tę samą wartość bezwzględną: V = |φ|.
Dlaczego R i SPSS dają różne V Craméra?
Najczęściej dlatego, że funkcja cramers_v() z pakietu effectsize domyślnie stosuje korektę obciążenia Bergsmy, a SPSS podaje klasyczne V. W przykładzie z tego hasła klasyczne V = .17, a skorygowane – .14. Wersję klasyczną w effectsize uzyskasz argumentem adjust = FALSE.
Jak zapisać V Craméra w APA?
Podaj V bez zera przed kropką, zaraz po wyniku testu χ², najlepiej z 95% przedziałem ufności, np. χ²(6, N = 320) = 19.19, p = .004, V = .17, 95% CI [.06, .23]. Jeśli podajesz wersję skorygowaną o obciążenie, napisz to wprost.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wielkość efektu: jak ocenić znaczenie wyniku poza wartością p
Wielkość efektu wyjaśniona praktycznie: Cohen d, Hedges g, r, R², iloraz szans, eta², przedziały ufności i znaczenie praktyczne.
Czytaj →PoradnikAnaliza ankiety do pracy licencjackiej i magisterskiej
Analiza ankiety do pracy dyplomowej: przygotowanie bazy, kodowanie pytań, skale, testy, modele i raport wyników do licencjatu lub magisterki.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Akoglu, H. (2018). User's guide to correlation coefficients. Turkish Journal of Emergency Medicine, 18(3), 91–93. https://doi.org/10.1016/j.tjem.2018.08.001 ● Otwarty dostęp
- Bergsma, W. (2013). A bias-correction for Cramér’s V and Tschuprow’s T. Journal of the Korean Statistical Society, 42(3), 323–328. https://doi.org/10.1016/j.jkss.2012.10.002
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press. https://doi.org/10.1515/9781400883868
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- McHugh, M. L. (2013). The chi-square test of independence. Biochemia Medica, 23(2), 143–149. https://doi.org/10.11613/BM.2013.018 ● Otwarty dostęp
Cytowania BibTeX
@article{akoglu2018users, author={Akoglu, Haldun}, title={{User's guide to correlation coefficients}}, journal={Turkish Journal of Emergency Medicine}, year={2018}, volume={18}, number={3}, pages={91--93}, doi={10.1016/j.tjem.2018.08.001}}@article{bergsma2013bias, author={Bergsma, Wicher}, title={{A bias-correction for Cramér’s V and Tschuprow’s T}}, journal={Journal of the Korean Statistical Society}, year={2013}, volume={42}, number={3}, pages={323--328}, doi={10.1016/j.jkss.2012.10.002}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@book{cramer1946mathematical, author={Cramér, Harald}, title={{Mathematical methods of statistics}}, year={1946}, publisher={Princeton University Press}, doi={10.1515/9781400883868}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{mchugh2013chi, author={McHugh, Mary L.}, title={{The chi-square test of independence}}, journal={Biochemia Medica}, year={2013}, volume={23}, number={2}, pages={143--149}, doi={10.11613/bm.2013.018}}