Co to jest przedział ufności?
Przedział ufności (ang. confidence interval, CI) to zakres wartości obliczony z próby za pomocą procedury, która – gdyby badanie powtarzać wiele razy na nowych próbach – obejmowałaby prawdziwą wartość parametru w populacji w określonym odsetku przypadków. Ten odsetek to poziom ufności, najczęściej 95%. Przedział ufności jest podstawowym narzędziem estymacji przedziałowej: uzupełnia oszacowanie punktowe (np. średnią czy różnicę średnich) o informację, jak precyzyjne jest to oszacowanie.
Dla średniej i różnicy średnich przedział buduje się z błędu standardowego:
gdzie tkr to wartość krytyczna rozkładu t (dla dużych prób bliska 1.96, czyli wartości z rozkładu normalnego), a SE – błąd standardowy oszacowania. Przedział jest tym węższy, im mniejsze zróżnicowanie wyników, im większa próba i im niższy poziom ufności.
Najważniejsze dla interpretacji: „95%” opisuje procedurę, a nie pojedynczy, już obliczony przedział. Parametr populacji jest stały – konkretny przedział albo go obejmuje, albo nie. Morey i in. (2016) pokazują, że poziom ufności nie wyraża prawdopodobieństwa, że parametr leży w konkretnym przedziale.
Co znaczy „95%”? Symulacja 50 prób
Wyobraź sobie populację, w której średni wynik w skali satysfakcji z życia SWLS (zakres 5–35) wynosi μ = 21, a odchylenie standardowe 6. Wylosowaliśmy z niej 50 prób po 25 osób i w każdej policzyliśmy 95% przedział ufności dla średniej (rysunek 1).
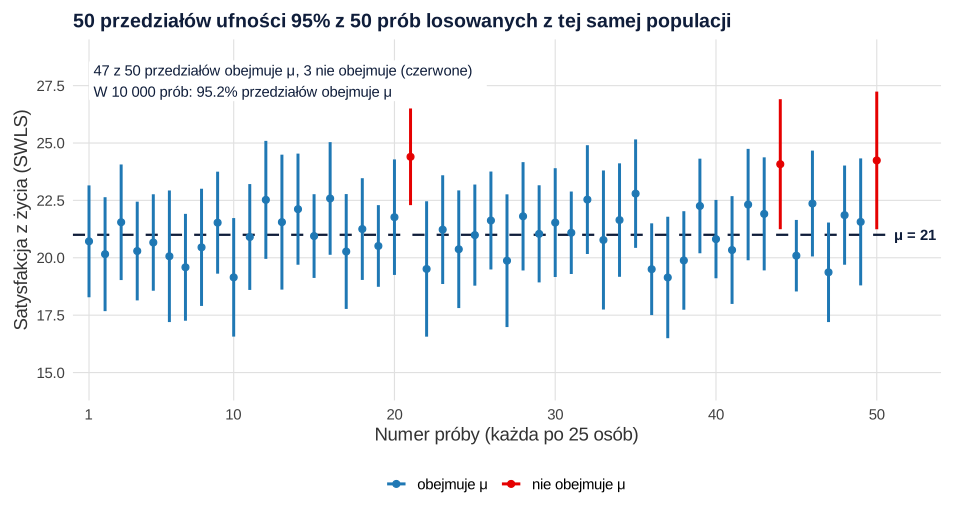
Przedziały „tańczą” – każda próba daje inną średnią i inną szerokość przedziału (od 3.12 do 6.06 punktu, bo w każdej próbie inne jest odchylenie standardowe). 47 z 50 przedziałów objęło prawdziwą średnią, a 3 jej nie objęły. Gdy powtórzyliśmy losowanie 10 000 razy, μ znalazła się w 95.2% przedziałów – tyle, ile obiecuje poziom ufności. W prawdziwym badaniu masz jednak tylko jeden przedział i nie wiesz, czy jest jednym z niebieskich, czy z czerwonych.
Przykład: satysfakcja z życia a uprawianie sportu
W badaniu 80 osób (dane symulowane) porównano satysfakcję z życia (SWLS) osób regularnie uprawiających sport (n = 40; M = 24.60, SD = 6.10) i nieuprawiających sportu (n = 40; M = 21.38, SD = 6.33). Różnica średnich wynosi 3.23 punktu, a jej błąd standardowy 1.390. Wartość krytyczna t dla 78 stopni swobody to 1.991:
Dane są więc zgodne z przewagą osób aktywnych wynoszącą od około pół punktu do sześciu punktów. Przedział nie obejmuje zera, co odpowiada istotnemu wynikowi testu t dla prób niezależnych: t(78) = 2.32, p = .023; wielkość efektu d = 0.52. To jednak schemat korelacyjny – przedział nie mówi nic o tym, czy sport podnosi satysfakcję z życia.
Ten sam zbiór danych daje różne przedziały przy różnych poziomach ufności:
| Poziom ufności | Przedział dla różnicy | Szerokość | Czy obejmuje 0? |
|---|---|---|---|
| 90% | [0.91, 5.54] | 4.63 | nie |
| 95% | [0.46, 5.99] | 5.54 | nie |
| 99% | [−0.45, 6.90] | 7.34 | tak |
Wyższy poziom ufności to szerszy przedział. Tabela pokazuje też związek z wartością p: 95% CI nie obejmuje zera i zarazem p < .05, a 99% CI obejmuje zero i zarazem p > .01. Tak samo jest przy każdym teście, któremu odpowiada dany przedział (np. teście t i przedziale dla różnicy średnich): jeśli 100(1 − α)% CI wyklucza wartość z hipotezy zerowej, test dwustronny odrzuca H0 na poziomie istotności α.
Jak interpretować przedział ufności?
Poprawnie możesz powiedzieć trzy rzeczy:
- O procedurze: przedziały liczone tą metodą obejmują prawdziwy parametr w 95% prób.
- O zgodności z danymi: wartości wewnątrz 95% CI to te, których dwustronny test na poziomie α = .05 by nie odrzucił – w przykładzie różnice od 0.46 do 5.99 punktu. Amrhein i in. (2019) proponują dlatego nazywać przedziały ufności „przedziałami zgodności” (ang. compatibility intervals) i omawiać praktyczne konsekwencje wszystkich wartości w ich obrębie.
- O precyzji: szeroki przedział oznacza, że dane są zgodne z bardzo różnymi wielkościami efektu.
Błędne interpretacje są powszechne. Hoekstra i in. (2014) pokazali, że 120 badaczy i 442 studentów psychologii akceptowało średnio ponad trzy z sześciu fałszywych stwierdzeń o przedziale ufności, a deklarowane doświadczenie statystyczne badaczy nie wiązało się z lepszymi wynikami.
| Błędnie | Poprawnie |
|---|---|
| „Z prawdopodobieństwem 95% prawdziwa różnica leży między 0.46 a 5.99” | 95% to odsetek trafień procedury w długiej serii prób. Prawdopodobieństwo dla parametru daje dopiero podejście bayesowskie (przedział wiarygodności). |
| „95% osób ma wynik w tym przedziale” | Przedział dotyczy parametru (np. średniej), a nie wyników osób. Rozproszenie wyników opisuje odchylenie standardowe. |
| „W replikacji 95% średnich trafi do mojego przedziału” | W naszej symulacji średnia z powtórzonego badania trafiała do pierwotnego 95% CI w 84.1% przypadków. |
| „Przedział obejmuje 0, więc efektu nie ma” | Dane są zgodne z zerem, ale też z innymi wartościami w przedziale – czasem z dużymi efektami (Amrhein i in., 2019). |
| „Przedziały dwóch grup nachodzą na siebie, więc grupy się nie różnią” | Nakładanie się przedziałów grup nie rozstrzyga o różnicy – zob. rysunek 2. |
Czytanie przedziałów „na oko”: pułapka nakładania się
Cumming i Finch (2005) zaproponowali siedem „reguł oka” do odczytywania rycin z przedziałami ufności, m.in. dotyczących zachodzenia na siebie przedziałów dla średnich z grup niezależnych. Rysunek 2 pokazuje, dlaczego to ważne.
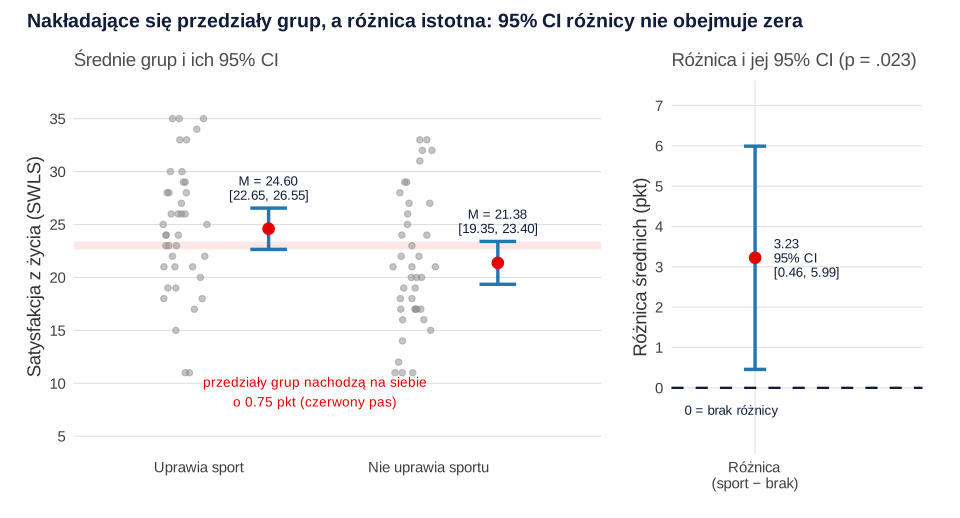
Przedziały obu grup nachodzą na siebie o 0.75 punktu, a mimo to 95% CI różnicy nie obejmuje zera. Gdy dwie niezależne grupy mają podobne błędy standardowe, przedziały nachodzące na siebie o połowę marginesu błędu odpowiadają p ≈ .038, a przedziały, które tylko się stykają – p ≈ .006 (nasze obliczenia dla dużych prób). Brak nakładania się to więc kryterium dużo surowsze niż p < .05, a nakładanie się nie dowodzi braku różnicy. Porównując grupy, patrz na przedział dla różnicy. W planach z powtarzanym pomiarem przedziały dla poszczególnych pomiarów nie pokazują precyzji oszacowania zmiany – potrzebny jest przedział dla różnic.
Przedział ufności czy wartość p?
Najlepiej oba. Du Prel i in. (2009) wyjaśniają, że wartość p służy do decyzji o odrzuceniu hipotezy zerowej sformułowanej przed badaniem, a przedział ufności informuje o zakresie wartości efektu, jego kierunku i sile, co pozwala ocenić znaczenie praktyczne wyniku. Dlatego zalecają raportowanie obu miar jako informacji uzupełniających się. Cumming (2014) idzie dalej i proponuje „nową statystykę”: zamiast skupiać się na testowaniu istotności – szacować wielkości efektów z przedziałami ufności i łączyć wyniki badań w metaanalizach. Więcej o ocenie wielkości efektu przeczytasz w poradniku Wielkość efektu: jak ocenić znaczenie wyniku poza wartością p.
Jak zapisać przedział ufności w pracy (APA)
Zapisuj poziom ufności, skrót CI i granice w nawiasie kwadratowym, oddzielone przecinkiem: 95% CI [0.46, 5.99]. Przedział podawaj bezpośrednio po oszacowaniu, którego dotyczy, z tą samą liczbą miejsc dziesiętnych. W tabelach stosuj kolumny „95% CI” z podziałem na dolną (LL) i górną (UL) granicę.
Gotowe zdania dla innych analiz znajdziesz we wpisie Jak opisać wyniki w pracy – gotowe zdania w stylu APA.
Przykład w R
Kod liczy 95% przedział ufności dla różnicy średnich z funkcji t.test() i „ręcznie”, porównuje trzy poziomy ufności i sprawdza w symulacji, jaki odsetek przedziałów obejmuje prawdziwą średnią.
Przedział ufności dla różnicy średnich i jego pokrycie
R
set.seed(2)
sport <- pmin(pmax(round(rnorm(40, 24, 5.5)), 5), 35)    # SWLS: osoby uprawiające sport
brak  <- pmin(pmax(round(rnorm(40, 21.5, 5.5)), 5), 35)  # SWLS: osoby nieuprawiające sportu
t.test(sport, brak, var.equal = TRUE)                     # różnica średnich i jej 95% CI

# to samo „ręcznie”: różnica ± t_kr × SE
roznica <- mean(sport) - mean(brak)
SE <- sqrt((var(sport) + var(brak)) / 2) * sqrt(2 / 40)
round(c(roznica = roznica, SE = SE, t_kr = qt(.975, df = 78)), 3)
round(roznica + c(-1, 1) * qt(.975, df = 78) * SE, 2)

# trzy poziomy ufności dla tych samych danych
ci <- sapply(c(.90, .95, .99), function(k) t.test(sport, brak, var.equal = TRUE, conf.level = k)$conf.int)
dimnames(ci) <- list(c("dolna", "górna"), c("90%", "95%", "99%"))
round(ci, 2)

# pokrycie: jaki odsetek 95% CI z 10 000 prób (n = 25) obejmuje μ = 21?
set.seed(2026)
mean(replicate(10000, {
  x <- rnorm(25, mean = 21, sd = 6)
  ci <- mean(x) + c(-1, 1) * qt(.975, df = 24) * sd(x) / sqrt(25)
  ci[1] <= 21 & 21 <= ci[2]
}))
Wynik w R
	Two Sample t-test

data:  sport and brak
t = 2.3198, df = 78, p-value = 0.02297
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 0.4573099 5.9926901
sample estimates:
mean of x mean of y
   24.600    21.375

roznica      SE    t_kr
  3.225   1.390   1.991
[1] 0.46 5.99
       90%  95%   99%
dolna 0.91 0.46 -0.45
górna 5.54 5.99  6.90
[1] 0.9517
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Przedział bez poziomu ufności – zapis „CI [0.46, 5.99]” nie mówi, czy to 90%, 95% czy 99%.
- Słupki błędów bez opisu – słupek ±1 SE jest mniej więcej dwa razy węższy niż 95% CI; w podpisie zawsze napisz, co pokazują słupki (zob. błąd standardowy).
- Przedział dla każdej grupy zamiast dla różnicy – wniosek o różnicy opieraj na przedziale różnicy, a nie na nakładaniu się przedziałów grup.
- Ignorowanie szerokości przedziału – wynik „istotny” z przedziałem [0.46, 5.99] jest mało precyzyjny. Planując badanie, oprócz mocy testu zaplanuj też oczekiwaną szerokość przedziału (zob. dobór liczebności próby).
Najczęstsze pytania
Co to jest przedział ufności?
Przedział ufności to zakres wartości obliczony z próby, który pokazuje, jak precyzyjnie oszacowano parametr populacji, np. średnią lub różnicę średnich. Procedura 95% CI w długiej serii powtórzeń obejmuje prawdziwy parametr w 95% prób. Przedział buduje się zwykle jako oszacowanie ± wartość krytyczna × błąd standardowy.
Jak interpretować 95% przedział ufności?
Najbezpieczniej: przedziały liczone tą metodą obejmują prawdziwy parametr w 95% prób, a wartości wewnątrz przedziału są zgodne z danymi (dwustronny test na poziomie α = .05 by ich nie odrzucił). Szeroki przedział oznacza małą precyzję – dane są zgodne z bardzo różnymi wielkościami efektu.
Czy 95% przedział ufności oznacza 95% prawdopodobieństwa, że parametr w nim leży?
W podejściu częstościowym nie. Parametr populacji jest stały, a konkretny przedział albo go obejmuje, albo nie – 95% to odsetek trafień procedury w długiej serii prób (Morey i in., 2016). Prawdopodobieństwo dla parametru wyraża przedział wiarygodności w podejściu bayesowskim.
Jak zapisać przedział ufności w APA?
Podaj poziom ufności, skrót CI i granice w nawiasie kwadratowym: 95% CI [0.46, 5.99]. Przedział umieść zaraz po oszacowaniu, którego dotyczy, np. „różnica wyniosła 3.23 punktu, 95% CI [0.46, 5.99]”, i zachowaj tę samą liczbę miejsc dziesiętnych.
Co oznacza, że przedział ufności obejmuje zero?
Że wartość zero – brak różnicy lub brak związku – jest zgodna z danymi, więc test dwustronny na odpowiadającym poziomie istotności nie odrzuci H0. Nie dowodzi to jednak braku efektu: przedział może obejmować również duże efekty. Oceń jego szerokość i oba krańce.
Od czego zależy szerokość przedziału ufności?
Od zróżnicowania wyników, liczebności próby i poziomu ufności. Większa próba i mniejsze odchylenie standardowe dają węższy przedział, a wyższy poziom ufności – szerszy. W przykładzie z tej strony ta sama różnica ma przedział o szerokości 4.63 przy 90%, 5.54 przy 95% i 7.34 przy 99%.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Przedział ufności w obrazkach
Sto przedziałów na jednym wykresie, szerokość a liczebność, poziom ufności, skośne dane, SD i przedział predykcji – sześć symulacji z kodem R.
Czytaj →PoradnikPrzedziały ufności w pracy dyplomowej
Zapis APA, wybór przedziału dla średniej, odsetka, różnicy, korelacji i OR, poprawne i błędne zdania, nakładanie się przedziałów i słupki błędów – z tabelą wyników w R.
Czytaj →PoradnikLiczebność próby z precyzji (AIPE)
Planowanie liczebności na szerokość przedziału ufności dla proporcji, d Cohena i korelacji, z pewnością osiągnięcia celu i kodem R.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Amrhein, V., Greenland, S., & McShane, B. (2019). Scientists rise up against statistical significance. Nature, 567(7748), 305–307. https://doi.org/10.1038/d41586-019-00857-9 ● Otwarty dostęp
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- du Prel, J.-B., Hommel, G., Röhrig, B., & Blettner, M. (2009). Confidence interval or p-value? Part 4 of a series on evaluation of scientific publications. Deutsches Ärzteblatt International, 106(19), 335–339. https://doi.org/10.3238/arztebl.2009.0335 ● Otwarty dostęp: pełny tekst
- Hoekstra, R., Morey, R. D., Rouder, J. N., & Wagenmakers, E.-J. (2014). Robust misinterpretation of confidence intervals. Psychonomic Bulletin & Review, 21(5), 1157–1164. https://doi.org/10.3758/s13423-013-0572-3 ● Otwarty dostęp: pełny tekst
- Morey, R. D., Hoekstra, R., Rouder, J. N., Lee, M. D., & Wagenmakers, E.-J. (2016). The fallacy of placing confidence in confidence intervals. Psychonomic Bulletin & Review, 23(1), 103–123. https://doi.org/10.3758/s13423-015-0947-8 ● Otwarty dostęp
Cytowania BibTeX
@article{amrhein2019scientists, author={Amrhein, Valentin and Greenland, Sander and McShane, Blake}, title={{Scientists rise up against statistical significance}}, journal={Nature}, year={2019}, volume={567}, number={7748}, pages={305--307}, doi={10.1038/d41586-019-00857-9}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{cumming2005inference, author={Cumming, Geoff and Finch, Sue}, title={{Inference by eye: Confidence intervals and how to read pictures of data}}, journal={American Psychologist}, year={2005}, volume={60}, number={2}, pages={170--180}, doi={10.1037/0003-066x.60.2.170}}@article{duprel2009confidence, author={du Prel, Jean-Baptist and Hommel, Gerhard and Röhrig, Bernd and Blettner, Maria}, title={{Confidence interval or p-value? Part 4 of a series on evaluation of scientific publications}}, journal={Deutsches Ärzteblatt International}, year={2009}, volume={106}, number={19}, pages={335--339}, doi={10.3238/arztebl.2009.0335}}@article{hoekstra2014robust, author={Hoekstra, Rink and Morey, Richard D. and Rouder, Jeffrey N. and Wagenmakers, Eric-Jan}, title={{Robust misinterpretation of confidence intervals}}, journal={Psychonomic Bulletin \& Review}, year={2014}, volume={21}, number={5}, pages={1157--1164}, doi={10.3758/s13423-013-0572-3}}@article{morey2016fallacy, author={Morey, Richard D. and Hoekstra, Rink and Rouder, Jeffrey N. and Lee, Michael D. and Wagenmakers, Eric-Jan}, title={{The fallacy of placing confidence in confidence intervals}}, journal={Psychonomic Bulletin \& Review}, year={2016}, volume={23}, number={1}, pages={103--123}, doi={10.3758/s13423-015-0947-8}}