Co to jest estymacja przedziałowa?
Estymacja przedziałowa (ang. interval estimation) to szacowanie parametru populacji zakresem wartości obliczonym z próby – tak, by procedura w ustalonym odsetku prób obejmowała prawdziwą wartość parametru. Tym odsetkiem jest poziom ufności, najczęściej 95%, a wynikiem – przedział ufności. Estymacja przedziałowa uzupełnia estymację punktową: obok odpowiedzi „ile?” daje odpowiedź „z jaką precyzją?”. Cumming (2014) stawia oszacowania z przedziałami ufności w centrum „nowej statystyki”, która ma zastąpić skupienie na samym testowaniu istotności.
Co dokładnie znaczy „95%” i jak czytać gotowy przedział, wyjaśniamy w haśle o przedziale ufności. Pamiętaj tylko, że poziom ufności opisuje procedurę, a nie prawdopodobieństwo, że parametr leży w Twoim konkretnym przedziale (Morey i in., 2016). Tutaj zajmujemy się konstrukcją: jak zbudować przedział dla średniej, odsetka, różnicy średnich i korelacji.
Ogólny przepis i jego cztery wersje
Większość przedziałów powstaje według jednego wzoru:
Składniki to: oszacowanie punktowe, jego błąd standardowy i wartość krytyczna z rozkładu z albo t dla wybranego poziomu ufności (1.96 dla 95% w rozkładzie normalnym). Przepis działa dobrze, gdy rozkład oszacowania z prób jest w przybliżeniu normalny i symetryczny. Odsetek i korelacja mają jednak ograniczony zakres (odsetek od 0 do 1, korelacja od −1 do 1) i blisko tych granic ich rozkład z prób staje się asymetryczny. Dlatego dla nich stosuje się zmodyfikowane metody.
| Parametr | Oszacowanie | Błąd standardowy | Wartość krytyczna | Uwagi |
|---|---|---|---|---|
| Średnia μ | M | SD / √n | t(n − 1) | Przedział symetryczny |
| Różnica średnich μ1 − μ2 | M1 − M2 | √(SD1²/n1 + SD2²/n2) | t(df Welcha) | Nie zakłada równych wariancji |
| Odsetek π | p̂ = k / n | Metoda Wilsona (wzór niżej) | z = 1.96 | Przedział asymetryczny, zawsze w granicach 0–1 |
| Korelacja ρ | z′ = atanh(r) | 1 / √(n − 3) | z = 1.96 | Liczony na skali z′, granice przelicza się na r |
Przy średniej i różnicy średnich wartość krytyczną bierze się z rozkładu t z odpowiednią liczbą stopni swobody. Dla różnicy dwóch niezależnych średnich domyślnym wyborem jest wariant Welcha: Delacre i in. (2017) pokazują, że lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy wariancje są równe (zob. test Welcha). W planie z powtarzanym pomiarem buduje się przedział dla średniej różnic między pomiarami, jak w teście t dla prób zależnych.
Przykład: cztery przedziały z jednego badania
W badaniu 120 osób studiujących (dane symulowane) zmierzono nasilenie objawów lęku uogólnionego skalą GAD-7 (0–21 punktów) i zapytano o przeciętną długość snu. 48 osób pracowało zarobkowo w trakcie studiów (M = 8.94, SD = 4.44), a 72 nie pracowały (M = 6.69, SD = 4.04). Wynik co najmniej 10 punktów traktujemy w tym przykładzie jako próg podwyższonego lęku.
| Parametr | Oszacowanie | SE | Wartość krytyczna | 95% CI |
|---|---|---|---|---|
| Średni wynik GAD-7 | M = 7.59 | 0.395 | t(119) = 1.980 | [6.81, 8.37] |
| Odsetek osób z wynikiem ≥ 10 | 36 / 120 = .300 | metoda Wilsona | z = 1.960 | [.225, .387] |
| Różnica: pracujący − niepracujący | 2.24 | 0.798 | t(94.22) = 1.985 | [0.66, 3.83] |
| Korelacja GAD-7 z długością snu | r = −.33 (z′ = −0.346) | 0.092 (skala z′) | z = 1.960 | [−.48, −.16] |
Dla średniej rachunek jest prosty: 7.59 ± 1.980 × 0.395. Różnica średnich ma większy błąd standardowy niż każda ze średnich z osobna, bo sumują się w nim niepewności obu grup; przedział [0.66, 3.83] nie obejmuje zera, więc dane są zgodne z przewagą osób pracujących wynoszącą od 0.66 do 3.83 punktu. Badanie jest korelacyjne, więc przedział nie mówi, czy praca zarobkowa nasila lęk. Dwa ostatnie wiersze wymagają osobnego komentarza.
Odsetek: metoda Wilsona zamiast Walda
W podręcznikach najczęściej pojawia się przedział Walda: p̂ ± 1.96 × √[p̂(1 − p̂) / n]. Brown i in. (2001) pokazali, że jego rzeczywiste pokrycie zmienia się chaotycznie znacznie uporczywiej, niż się powszechnie sądzi, a popularne reguły „bezpiecznego” stosowania zawodzą. Zalecają przedział Wilsona (albo Jeffreysa) przy małych próbach i przedział Agrestiego–Coulla przy większych. Przedział Wilsona ma środek przesunięty w stronę 50% i nie wychodzi poza zakres od 0 do 1:
Rysunek 1 pokazuje, jaki odsetek nominalnie 95% przedziałów obu metod naprawdę obejmuje prawdziwy odsetek π. Pokrycie policzyliśmy dokładnie z rozkładu dwumianowego, bez losowania.
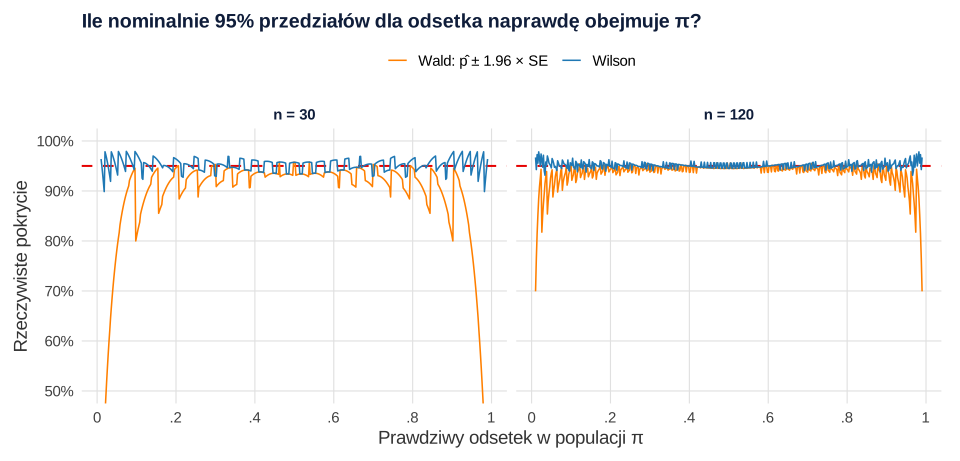
Przy 30 osobach średnie pokrycie przedziału Walda (dla π od .01 do .99) wyniosło 88.8%, a dla π = .05 tylko 78.2%; przedział Wilsona dał średnio 95.3% i nigdy nie spadł poniżej 89.9%. Przy 120 osobach przedział Walda poprawia się (średnio 93.6%), ale na krańcach nadal spada nawet do 69.9%. W naszym przykładzie (36 osób ze 120) obie metody dają podobne wyniki – [.218, .382] i [.225, .387] – bo odsetek jest daleko od zera, a próba spora. Inaczej jest w małej podgrupie: dla 1 osoby z 15 przedział Walda wynosi [−.060, .193], czyli zawiera niemożliwe ujemne odsetki, a przedział Wilsona – [.012, .298].
Korelacja: przedział na skali Fishera
Rozkład współczynnika korelacji Pearsona z prób jest asymetryczny, tym bardziej, im bliżej ±1 leży korelacja w populacji. Dlatego przedział buduje się w trzech krokach: zamień r na z′ (transformacja Fishera), zbuduj zwykły przedział na skali z′, a jego granice przelicz z powrotem na r:
W przykładzie z′ = −0.346, a SE = 1/√117 = 0.092, więc przedział na skali z′ wynosi −0.346 ± 1.96 × 0.092, a po przeliczeniu na r – [−.48, −.16]. Rysunek 2 pokazuje, co daje ta transformacja dla trzech korelacji z prób po 30 osób.
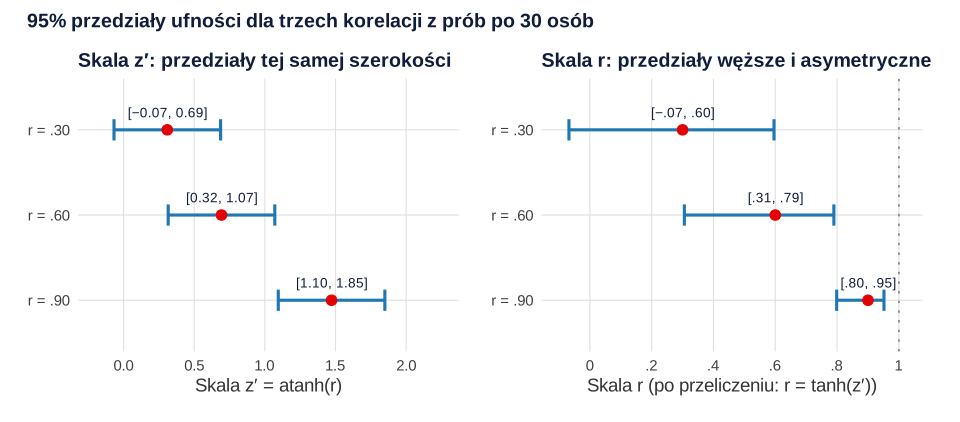
Na skali z′ każdy przedział ma tę samą szerokość (0.754). Na skali r przedział dla r = .90 sięga od .80 do .95: w dół rozciąga się o .101, a w górę tylko o .052. Wzór „r ± 1.96 × SE” dałby przedział symetryczny, który przy silnych korelacjach może przekroczyć 1. Transformacja Fishera zakłada jednak, że obie zmienne mają w przybliżeniu łączny rozkład normalny. Bishara i Hittner (2017) pokazali w symulacji, że przy danych nienormalnych rzeczywiste pokrycie nominalnie 95% przedziału Fishera spadało nawet do 68%, a sygnałem ostrzegawczym była kurtoza próby co najmniej 2 lub bezwzględna skośność co najmniej 1. W takich danych rozważ metody rangowe, np. przedział dla korelacji Spearmana.
Jak opisać przedziały w pracy (APA)
Podawaj poziom ufności i granice w nawiasie kwadratowym zaraz po oszacowaniu, z tą samą liczbą miejsc dziesiętnych. W podrozdziale o analizie danych napisz, jakimi metodami liczono przedziały:
Opis wyników z przykładu:
Więcej gotowych zdań znajdziesz w poradniku Jak opisać wyniki w stylu APA – gotowe zdania, a o tym, jak oceniać szerokość przedziału wokół wielkości efektu – w poradniku Wielkość efektu: jak ocenić znaczenie wyniku poza wartością p.
Przykład w R
Kod liczy wszystkie cztery przedziały z przykładu „ręcznie” ze wzorów i sprawdza je funkcjami wbudowanymi: prop.test() bez poprawki na ciągłość daje przedział Wilsona, t.test() domyślnie stosuje wariant Welcha, a cor.test() – transformację Fishera.
Przedziały dla średniej, odsetka, różnicy i korelacji
R
set.seed(654)
n <- 120
pracuje <- rep(c("pracuje", "nie pracuje"), times = c(48, 72))
sen <- round(rnorm(n, 6.8, 1.0), 1)                                       # godziny snu
gad <- pmin(pmax(round(7.2 + 1.8 * (pracuje == "pracuje") - 1.4 * (sen - 6.8) + rnorm(n, 0, 4.2)), 0), 21)   # GAD-7 (0–21)
z <- qnorm(0.975)                                                         # wartość krytyczna z dla 95%

# 1. Średnia: M ± t_kr × SD / √n
M <- mean(gad); SE <- sd(gad) / sqrt(n); t_kr <- qt(0.975, df = n - 1)
round(c(M = M, SD = sd(gad), SE = SE, t_kr = t_kr, dolna = M - t_kr * SE, gorna = M + t_kr * SE), 3)

# 2. Odsetek osób z wynikiem co najmniej 10 pkt: przedział Walda i Wilsona
k <- sum(gad >= 10); p <- k / n
wald <- p + c(-1, 1) * z * sqrt(p * (1 - p) / n)
srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
pol <- z / (1 + z^2 / n) * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))
round(c(k = k, p = p, wald = wald, wilson = srodek + c(-1, 1) * pol), 3)
round(prop.test(k, n, correct = FALSE)$conf.int[1:2], 3)                  # Wilson w funkcji wbudowanej
round(1/15 + c(-1, 1) * z * sqrt((1/15) * (14/15) / 15), 3)               # mała podgrupa, 1 osoba z 15: Wald
round(prop.test(1, 15, correct = FALSE)$conf.int[1:2], 3)                 # ta sama podgrupa: Wilson

# 3. Różnica średnich (test Welcha): pracujący − niepracujący
round(sapply(split(gad, pracuje), function(x) c(n = length(x), M = mean(x), SD = sd(x))), 2)
w <- t.test(gad[pracuje == "pracuje"], gad[pracuje == "nie pracuje"])
round(c(roznica = unname(diff(rev(w$estimate))), SE = w$stderr, df = unname(w$parameter),
        t_kr = qt(0.975, w$parameter), dolna = w$conf.int[1], gorna = w$conf.int[2],
        t = unname(w$statistic), p = w$p.value), 3)

# 4. Korelacja (transformacja Fishera): GAD-7 a długość snu
r <- cor(gad, sen); zr <- atanh(r); SEz <- 1 / sqrt(n - 3)
round(c(r = r, z = zr, SE_z = SEz, dolna = tanh(zr - z * SEz), gorna = tanh(zr + z * SEz)), 3)
kor <- cor.test(gad, sen)                                                 # to samo w cor.test()
round(c(dolna = kor$conf.int[1], gorna = kor$conf.int[2], t = unname(kor$statistic), p = kor$p.value), 4)
Wynik w R
    M    SD    SE  t_kr dolna gorna
7.592 4.326 0.395 1.980 6.810 8.374
      k       p   wald1   wald2 wilson1 wilson2
 36.000   0.300   0.218   0.382   0.225   0.387
[1] 0.225 0.387
[1] -0.060  0.193
[1] 0.012 0.298
   nie pracuje pracuje
n        72.00   48.00
M         6.69    8.94
SD        4.04    4.44
roznica      SE      df    t_kr   dolna   gorna       t       p
  2.243   0.798  94.223   1.985   0.659   3.827   2.812   0.006
     r      z   SE_z  dolna  gorna
-0.333 -0.346  0.092 -0.483 -0.163
  dolna   gorna       t       p
-0.4830 -0.1630 -3.8300  0.0002
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Przedział Walda dla odsetka w małej próbie – przy 1 osobie z 15 daje ujemną dolną granicę; przy skrajnych odsetkach jego pokrycie bywa dużo niższe niż 95% (Brown i in., 2001). Używaj metody Wilsona.
- Symetryczny przedział dla korelacji – „r ± 1.96 × SE” ignoruje asymetrię rozkładu r i może wyjść poza ±1. Licz przedział na skali z′.
- Wartość 1.96 zamiast t przy średniej z małej próby – przedział jest wtedy za wąski; wartość krytyczną bierz z rozkładu t.
- Przedział dla każdej grupy zamiast przedziału dla różnicy – o różnicy wnioskuj z przedziału dla różnicy, a nie z tego, czy przedziały grup na siebie nachodzą (zob. przedział ufności).
- Transformacja Fishera przy wyraźnie nienormalnych danych – sprawdź skośność i kurtozę; przy dużych odchyleniach od normalności przedział może być mylący (Bishara i Hittner, 2017).
- Brak poziomu ufności i metody – zapis „CI [.225, .387]” nie mówi, czy to 90%, 95%, czy 99% i czy liczono go metodą Walda, czy Wilsona.
Najczęstsze pytania
Co to jest estymacja przedziałowa?
Estymacja przedziałowa to szacowanie parametru populacji – np. średniej, odsetka czy korelacji – przedziałem wartości zamiast jedną liczbą. Przedział liczy się procedurą, która w ustalonym odsetku prób (zwykle 95%) obejmuje prawdziwy parametr. Jego szerokość pokazuje, jak precyzyjne jest oszacowanie.
Jaki jest wzór na przedział ufności?
Ogólnie: oszacowanie ± wartość krytyczna × błąd standardowy. Dla średniej: M ± t(n − 1) × SD/√n, np. 7.59 ± 1.980 × 0.395 = [6.81, 8.37]. Dla odsetka i korelacji stosuje się zmodyfikowane metody: Wilsona i transformację Fishera.
Jak obliczyć przedział ufności dla odsetka (proporcji)?
Najlepiej metodą Wilsona, a nie podręcznikowym wzorem Walda (odsetek ± 1.96 × SE), który w małych próbach i przy skrajnych odsetkach ma za niskie pokrycie i może dać ujemną granicę. W R: prop.test(k, n, correct = FALSE)$conf.int. Dla 36 osób ze 120 daje to [.225, .387].
Jak policzyć przedział ufności dla r transformacją Fishera?
Zamień r na z′ = atanh(r), zbuduj przedział z′ ± 1.96/√(n − 3) i przelicz jego granice z powrotem funkcją tanh. Taki przedział jest asymetryczny i nie wychodzi poza ±1. W R robi to automatycznie funkcja cor.test().
Czym różni się estymacja przedziałowa od punktowej?
Estymacja punktowa daje jedną liczbę (np. M = 7.59), a przedziałowa – zakres wartości zgodnych z danymi (np. 95% CI [6.81, 8.37]). Przedział pokazuje precyzję oszacowania: im jest szerszy, tym mniej wiemy o parametrze.
Kiedy w przedziale ufności użyć z, a kiedy t?
Dla średnich i różnic średnich bierz wartość krytyczną z rozkładu t z odpowiednią liczbą stopni swobody, bo odchylenie standardowe szacuje się z próby. Wartość z = 1.96 stosuje się m.in. w przedziale Wilsona dla odsetka i w przedziale dla korelacji na skali Fishera. Przy dużych próbach wartości t i z są bardzo bliskie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Przedział ufności w obrazkach
Sto przedziałów na jednym wykresie, szerokość a liczebność, poziom ufności, skośne dane, SD i przedział predykcji – sześć symulacji z kodem R.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bishara, A. J., & Hittner, J. B. (2017). Confidence intervals for correlations when data are not normal. Behavior Research Methods, 49(1), 294–309. https://doi.org/10.3758/s13428-016-0702-8 ● Otwarty dostęp
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Morey, R. D., Hoekstra, R., Rouder, J. N., Lee, M. D., & Wagenmakers, E.-J. (2016). The fallacy of placing confidence in confidence intervals. Psychonomic Bulletin & Review, 23(1), 103–123. https://doi.org/10.3758/s13423-015-0947-8 ● Otwarty dostęp
Cytowania BibTeX
@article{bishara2017confidence, author={Bishara, Anthony J. and Hittner, James B.}, title={{Confidence intervals for correlations when data are not normal}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={1}, pages={294--309}, doi={10.3758/s13428-016-0702-8}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{morey2016fallacy, author={Morey, Richard D. and Hoekstra, Rink and Rouder, Jeffrey N. and Lee, Michael D. and Wagenmakers, Eric-Jan}, title={{The fallacy of placing confidence in confidence intervals}}, journal={Psychonomic Bulletin \& Review}, year={2016}, volume={23}, number={1}, pages={103--123}, doi={10.3758/s13423-015-0947-8}}