Co to są testy post hoc?
Testy post hoc (łac. post hoc – „po tym”) to porównania par grup wykonywane po teście ogólnym, najczęściej po ANOVA albo po teście Kruskala–Wallisa. Test ogólny mówi tylko, że nie wszystkie średnie są równe; test post hoc wskazuje, które grupy się różnią, i jednocześnie kontroluje łączne prawdopodobieństwo błędu I rodzaju w całej rodzinie porównań. Tę lukę opisał już Tukey (1949), proponując prostą procedurę dzielenia średnich na grupy rozróżnialne, gdy test F wskazuje jedynie, że nie wszystkie średnie są równe.
Testy post hoc odróżnia się od porównań planowanych (kontrastów a priori), czyli kilku porównań wynikających wprost z hipotez i zapisanych przed zebraniem danych. Midway i in. (2020) na podstawie przeglądu 17 testów i symulacji dziewięciu z nich zalecają porównania planowane zamiast nieplanowanych, test Scheffégo dla dowolnych kombinacji liniowych średnich oraz test HSD Tukeya lub poprawki Bonferroniego i Dunna–Šidáka dla porównań parami.
Przegląd najważniejszych testów post hoc
| Test | Kiedy | Założenia | W R | W SPSS |
|---|---|---|---|---|
| HSD Tukeya (Tukeya–Kramera) | Wszystkie pary średnich | Równe wariancje; nierówne liczebności – wersja Tukeya–Kramera | TukeyHSD() | Tukey |
| Games–Howell | Wszystkie pary przy nierównych wariancjach lub liczebnościach | Nie zakłada równych wariancji (stopnie swobody Welcha) | rstatix::games_howell_test() | Games-Howell |
| Bonferroni, Holm | Niewielki zestaw wybranych porównań | Takie jak test bazowy, np. test t Welcha | pairwise.t.test() | Bonferroni (Holm – np. w R) |
| Scheffé | Wszystkie kontrasty, także złożone (np. średnia dwóch grup vs trzecia) | Równe wariancje; dla samych par bardzo zachowawczy | DescTools::ScheffeTest() | Scheffe |
| Dunnett | Każda grupa tylko z jedną grupą kontrolną | Równe wariancje | DescTools::DunnettTest() | Dunnett |
| Dunn | Pary grup po teście Kruskala–Wallisa | Porównuje sumy rang, nie średnie | rstatix::dunn_test() | porównania parami w testach nieparametrycznych |
Test Dunna (Dunn, 1964) wykorzystuje rangi ze wspólnego rangowania wszystkich grup – tych samych, na których opiera się test Kruskala–Wallisa – zamiast rangować osobno każdą parę; ma przybliżenie normalne i uwzględnia rangi wiązane. Korekty Bonferroniego i Holma omawiamy osobno w haśle korekta Bonferroniego i porównania wielokrotne.
Jak wybrać test post hoc?
- Masz konkretne hipotezy? Przetestuj zaplanowane kontrasty zamiast wszystkich par – mniej porównań oznacza mniejszą korektę i większą moc.
- Porównujesz wszystkie pary, a wariancje mogą być nierówne (lub liczebności grup są różne)? Wybierz test Gamesa–Howella. Games i Howell (1976) w symulacji Monte Carlo pokazali, że przy nierównych liczebnościach lub wariancjach (i co najmniej 6 osobach w grupie) tylko statystyka Behrensa–Fishera, na której opiera się ten test, zadowalająco kontrolowała błąd I rodzaju – zarówno dla całej rodziny porównań, jak i dla pojedynczych kontrastów. Lee i Lee (2018) przy naruszonej równości wariancji zalecają test Gamesa–Howella, T2 Tamhane’a oraz T3 i C Dunnetta.
- Wariancje i liczebności są zbliżone? Test HSD Tukeya jest standardem i daje nieco węższe przedziały.
- Interesuje Cię tylko porównanie z grupą kontrolną? Test Dunnetta wykonuje mniej porównań niż Tukey, więc ma większą moc.
- Analizujesz rangi (test Kruskala–Wallisa)? Użyj testu Dunna z korektą Holma.
Sauder i DeMars (2019) porównali w symulacji 18 procedur porównań parami dostępnych w SPSS. Błąd I rodzaju właściwie kontrolowały jedynie cztery testy zaprojektowane na wypadek naruszenia założeń (nierównych liczebności i wariancji); ich moc była zbliżona, nieco najwyższa dla testu Gamesa–Howella. Dlatego gdy nie masz pewności co do równości wariancji, wybierz test Gamesa–Howella – podobnie jak test F Welcha dla testu ogólnego (zob. test Welcha). Nie uzależniaj przy tym wyboru od wyniku testu Levene’a. Jeśli porównujesz nie grupy po ANOVA, lecz wiele wskaźników albo hipotez, przegląd poprawek znajdziesz we wpisie Poprawki na wielokrotne porównania.
Przykład: cztery formy wsparcia
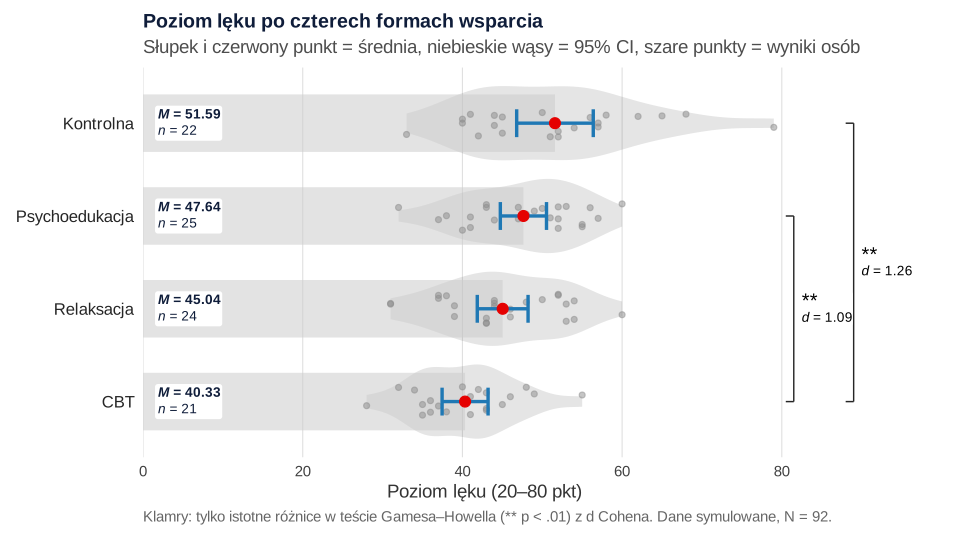
Dziewięćdziesiąt dwie osoby z podwyższonym lękiem przydzielono losowo do czterech warunków: grupy kontrolnej (lista oczekujących), psychoedukacji, treningu relaksacji i terapii poznawczo-behawioralnej (CBT). Po ośmiu tygodniach zmierzono poziom lęku (20–80 punktów; dane symulowane). Średnie (SD) wyniosły: kontrolna 51.59 (10.82), psychoedukacja 47.64 (7.01), relaksacja 45.04 (7.53), CBT 40.33 (6.33). Test ogólny (test F Welcha) był istotny: F(3, 47.89) = 7.50, p < .001, ω² = .17, 95% CI [.04, .30]. Tabela pokazuje, co mówią o tych samych danych różne procedury:
| Porównanie | Różnica | Tukey | Games–Howell | Holm (t Welcha) | Scheffé | Dunn (Holm) |
|---|---|---|---|---|---|---|
| Kontrolna – psychoedukacja | −3.95 | .344 | .469 | .304 | .428 | .551 |
| Kontrolna – relaksacja | −6.55 | .036 | .102 | .094 | .063 | .162 |
| Kontrolna – CBT | −11.26 | < .001 | .001 | .001 | < .001 | < .001 |
| Psychoedukacja – relaksacja | −2.60 | .675 | .599 | .304 | .737 | .551 |
| Psychoedukacja – CBT | −7.31 | .015 | .003 | .003 | .030 | .009 |
| Relaksacja – CBT | −4.71 | .215 | .119 | .094 | .290 | .162 |
Dwie różnice są istotne w każdej procedurze: CBT obniża lęk w porównaniu z grupą kontrolną (o 11.26 punktu, d = 1.26) i z psychoedukacją (o 7.31 punktu, d = 1.09). Najciekawsza jest para kontrolna – relaksacja: test Tukeya daje p = .036, a test Dunnetta (tylko trzy porównania z grupą kontrolną) p = .020, natomiast Games–Howell (.102), Holm (.094), Scheffé (.063) i Dunn (.162) nie wskazują istotnej różnicy. Powód widać w danych: grupa kontrolna ma największą wariancję (117.02 wobec 40.03–56.74 w pozostałych grupach), a Tukey i Dunnett używają jednej, wspólnej wariancji błędu (65.24), przez co zaniżają błąd standardowy różnic z tą grupą. Test Gamesa–Howella liczy błąd osobno dla każdej pary.
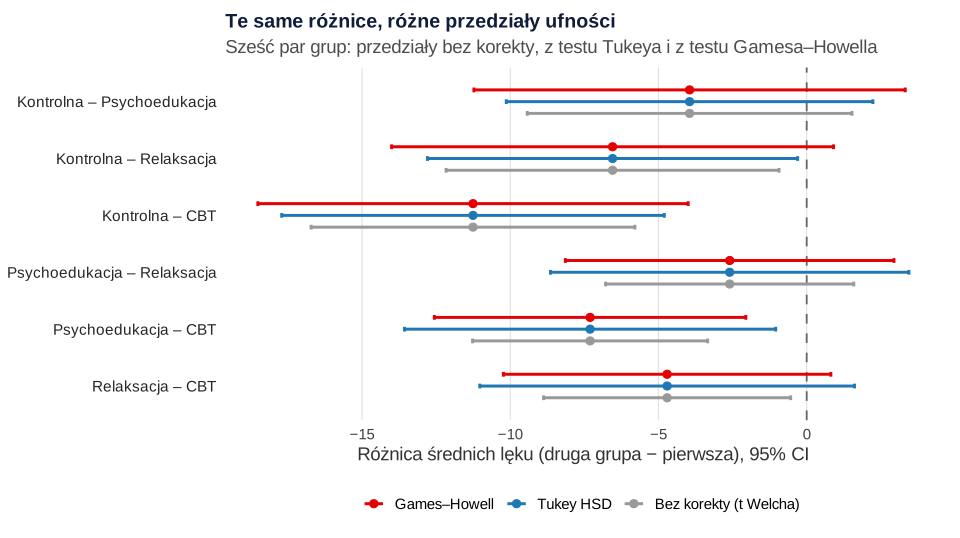
Rysunek 2 pokazuje to samo od strony przedziałów ufności. Korekta na porównania wielokrotne poszerza przedziały w stosunku do pojedynczych testów t. Dla pary kontrolna – relaksacja przedział bez korekty i przedział Tukeya nie obejmują zera, a przedział Gamesa–Howella [−14.00, 0.91] już tak.
Wniosek praktyczny: procedurę post hoc wybierz przed analizą (najlepiej w planie analiz lub prerejestracji). Sprawdzanie kolejnych testów, aż któryś da p < .05, to p-hacking.
Jak opisać testy post hoc (APA)
Podaj nazwę testu, różnice średnich z przedziałami ufności, skorygowane wartości p i wielkość efektu dla par:
W tabelach APA wyniki post hoc często zaznacza się literami w indeksie dolnym przy średnich (średnie z różnymi literami różnią się istotnie) – wzór znajdziesz w haśle tabela ANOVA w APA. Cały proces – od założeń po opis – pokazujemy w poradniku ANOVA krok po kroku.
Testy post hoc w R
Kod wykonuje test ogólny Welcha i sześć procedur porównań parami na tych samych danych. Wartości w tabeli, opisie i na rysunkach pochodzą z tych obliczeń.
Tukey, Games–Howell, Holm, Scheffé, Dunnett i Dunn
R
library(rstatix)     # games_howell_test(), dunn_test()
library(DescTools)   # ScheffeTest(), DunnettTest()

# Dane symulowane: poziom lęku (20–80 pkt) po czterech formach wsparcia
set.seed(116)
n <- c(22, 25, 24, 21)
grupa <- factor(rep(c("Kontrolna", "Psychoedukacja", "Relaksacja", "CBT"), n),
                levels = c("Kontrolna", "Psychoedukacja", "Relaksacja", "CBT"))
lek <- unlist(mapply(function(n, m, s) pmin(pmax(round(rnorm(n, m, s)), 20), 80),
                     n, c(52, 48, 45, 41), c(9.5, 8, 7, 6)))
dane <- data.frame(grupa, lek)
model <- aov(lek ~ grupa, data = dane)

oneway.test(lek ~ grupa, data = dane)                # test ogólny: F Welcha
TukeyHSD(model)                                       # Tukey HSD (Tukey–Kramer)
as.data.frame(games_howell_test(dane, lek ~ grupa))   # Games–Howell
pairwise.t.test(dane$lek, dane$grupa,                 # testy t Welcha z korektą Holma
                p.adjust.method = "holm", pool.sd = FALSE)
ScheffeTest(model)                                    # Scheffé
DunnettTest(lek ~ grupa, data = dane)                 # każda grupa vs kontrolna
as.data.frame(dunn_test(dane, lek ~ grupa, p.adjust.method = "holm"))  # Dunn (po Kruskalu–Wallisie)
Wynik w R
	One-way analysis of means (not assuming equal variances)

data:  lek and grupa
F = 7.5005, num df = 3.000, denom df = 47.892, p-value = 0.000326

  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = lek ~ grupa, data = dane)

$grupa
                                diff        lwr        upr     p adj
Psychoedukacja-Kontrolna   -3.950909 -10.134098  2.2322801 0.3438581
Relaksacja-Kontrolna       -6.549242 -12.792437 -0.3060474 0.0360152
CBT-Kontrolna             -11.257576 -17.710524 -4.8046274 0.0000926
Relaksacja-Psychoedukacja  -2.598333  -8.642931  3.4462638 0.6747184
CBT-Psychoedukacja         -7.306667 -13.567674 -1.0456593 0.0154390
CBT-Relaksacja             -4.708333 -11.028608  1.6119411 0.2147068

  .y.         group1         group2   estimate   conf.low  conf.high p.adj
1 lek      Kontrolna Psychoedukacja  -3.950909 -11.226734  3.3249159 0.469
2 lek      Kontrolna     Relaksacja  -6.549242 -14.003611  0.9051262 0.102
3 lek      Kontrolna            CBT -11.257576 -18.515707 -3.9994442 0.001
4 lek Psychoedukacja     Relaksacja  -2.598333  -8.141179  2.9445127 0.599
5 lek Psychoedukacja            CBT  -7.306667 -12.559898 -2.0534354 0.003
6 lek     Relaksacja            CBT  -4.708333 -10.231191  0.8145247 0.119
  p.adj.signif
1           ns
2           ns
3          ***
4           ns
5           **
6           ns

	Pairwise comparisons using t tests with non-pooled SD

data:  dane$lek and dane$grupa

               Kontrolna Psychoedukacja Relaksacja
Psychoedukacja 0.3041    -              -
Relaksacja     0.0939    0.3041         -
CBT            0.0011    0.0029         0.0939

P value adjustment method: holm

  Posthoc multiple comparisons of means: Scheffe Test
    95% family-wise confidence level

$grupa
                                diff     lwr.ci     upr.ci   pval
Psychoedukacja-Kontrolna   -3.950909 -10.680811  2.7789924 0.4281
Relaksacja-Kontrolna       -6.549242 -13.344455  0.2459706 0.0634 .
CBT-Kontrolna             -11.257576 -18.281088 -4.2340633 0.0003 ***
Relaksacja-Psychoedukacja  -2.598333  -9.177389  3.9807219 0.7374
CBT-Psychoedukacja         -7.306667 -14.121267 -0.4920664 0.0303 *
CBT-Relaksacja             -4.708333 -11.587441  2.1707744 0.2901

---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1


  Dunnett's test for comparing several treatments with a control :
    95% family-wise confidence level

$Kontrolna
                               diff     lwr.ci    upr.ci    pval
Psychoedukacja-Kontrolna  -3.950909  -9.588422  1.686604  0.2289
Relaksacja-Kontrolna      -6.549242 -12.241466 -0.857019  0.0197 *
CBT-Kontrolna            -11.257576 -17.141041 -5.374110 3.9e-05 ***

---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

  .y.         group1         group2 n1 n2  statistic            p        p.adj
1 lek      Kontrolna Psychoedukacja 22 25 -0.9731377 3.304849e-01 0.5509167633
2 lek      Kontrolna     Relaksacja 22 24 -2.0196714 4.341748e-02 0.1617635096
3 lek      Kontrolna            CBT 22 21 -3.9611068 7.460314e-05 0.0004476188
4 lek Psychoedukacja     Relaksacja 25 24 -1.0905785 2.754584e-01 0.5509167633
5 lek Psychoedukacja            CBT 25 21 -3.1214982 1.799333e-03 0.0089966670
6 lek     Relaksacja            CBT 24 21 -2.0492172 4.044088e-02 0.1617635096
  p.adj.signif
1           ns
2           ns
3          ***
4           ns
5           **
6           ns
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i ggtext. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggtext (wersja 0.1.2): Wilke, C. O., & Wiernik, B. M. (2022). ggtext: Improved text rendering support for ggplot2 [R package]. https://doi.org/10.32614/CRAN.package.ggtext
Najczęstsze błędy
- Seria zwykłych testów t bez korekty zamiast testu post hoc – przy sześciu parach ryzyko co najmniej jednego fałszywego alarmu rośnie wielokrotnie (dla sześciu niezależnych testów do .265).
- Test Tukeya przy wyraźnie nierównych wariancjach – jak w przykładzie, może wskazać różnicę, której nie potwierdza test odporny na nierówne wariancje.
- Szukanie „najlepszego” testu po fakcie – sprawdzanie kilku procedur i raportowanie tej, która dała istotny wynik.
- Brak nazwy testu i metody korekty w raporcie – czytelnik nie wie, jak interpretować wartości p.
- Raportowanie samych gwiazdek zamiast różnic z przedziałami ufności, dokładnych p i wielkości efektu (d Cohena).
- Testy post hoc dla czynnika w modelu z istotną interakcją – wtedy porównuj grupy osobno na poziomach drugiego czynnika (efekty proste), a nie średnie brzegowe.
Najczęstsze pytania
Co to jest test post hoc?
To porównanie par grup wykonywane po teście ogólnym, np. ANOVA, który mówi tylko, że nie wszystkie średnie są równe. Test post hoc wskazuje, które grupy się różnią, i kontroluje łączne prawdopodobieństwo fałszywego alarmu we wszystkich porównaniach – dlatego nie zastępuje się go serią zwykłych testów t.
Jaki test post hoc wybrać po ANOVA?
Przy równych wariancjach – test HSD Tukeya; przy nierównych wariancjach lub liczebnościach – test Gamesa–Howella, który w symulacjach dobrze kontroluje błąd I rodzaju (Sauder i DeMars, 2019). Do porównań z jedną grupą kontrolną użyj testu Dunnetta, a po teście Kruskala–Wallisa – testu Dunna.
Czym się różni test Tukeya od testu Gamesa–Howella?
Test Tukeya używa jednej, wspólnej wariancji błędu dla wszystkich par, więc zakłada równość wariancji. Test Gamesa–Howella liczy błąd standardowy i stopnie swobody osobno dla każdej pary (jak test Welcha). W przykładzie z tego hasła Tukey wskazał różnicę między grupą kontrolną a relaksacją (p = .036), a Games–Howell już nie (p = .102).
Czy test post hoc można wykonać bez istotnej ANOVA?
Większość procedur, np. Tukeya i Gamesa–Howella, samodzielnie kontroluje łączny błąd I rodzaju, więc formalnie nie wymaga istotnego testu ogólnego. W pracach dyplomowych zwykle wykonuje się je jednak po istotnym F. Jeśli masz konkretne hipotezy, lepiej od razu zaplanować kontrasty (Midway i in., 2020).
Jak opisać testy post hoc w APA?
Podaj nazwę testu, różnice średnich z 95% przedziałami ufności, skorygowane wartości p i wielkość efektu, np. „różnica = −11.26 pkt, 95% CI [−18.52, −4.00], p = .001, d = 1.26 (test Gamesa–Howella)”. W tabeli możesz oznaczyć średnie literami w indeksie dolnym.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA w obrazkach
Te same średnie przy małym i dużym rozrzucie, sumy kwadratów jako odcinki, F i η² na słupkach, F przy rosnącym n i przedziały Tukeya – pięć rysunków z R.
Czytaj →PoradnikKontrasty planowane i analiza trendu
Od hipotez do wag kontrastów: trend liniowy i kwadratowy, kontrast interakcyjny, korekty, moc i tabela APA – na danych do pobrania, z kodem R.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikJaki test statystyczny do jakiej hipotezy?
Tabela doboru: typ hipotezy, test, alternatywa nieparametryczna i miara efektu. Cztery przykłady w R z gotowym zapisem APA.
Czytaj →PoradnikTesty post hoc – który wybrać?
Tabela sytuacja → test, Tukey, Games–Howell, Dunnett, Scheffé i Dunn na jednym przykładzie oraz symulacja błędu I rodzaju i mocy w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.3102/10769986001002113
- Lee, S., & Lee, D. K. (2018). What is the proper way to apply the multiple comparison test? Korean Journal of Anesthesiology, 71(5), 353–360. https://doi.org/10.4097/kja.d.18.00242 ● Otwarty dostęp
- Midway, S., Robertson, M., Flinn, S., & Kaller, M. (2020). Comparing multiple comparisons: Practical guidance for choosing the best multiple comparisons test. PeerJ, 8, Article e10387. https://doi.org/10.7717/peerj.10387 ● Otwarty dostęp
- Sauder, D. C., & DeMars, C. E. (2019). An updated recommendation for multiple comparisons. Advances in Methods and Practices in Psychological Science, 2(1), 26–44. https://doi.org/10.1177/2515245918808784 ● Otwarty dostęp
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
Cytowania BibTeX
@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@article{games1976pairwise, author={Games, Paul A. and Howell, John F.}, title={{Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study}}, journal={Journal of Educational Statistics}, year={1976}, volume={1}, number={2}, pages={113--125}, doi={10.3102/10769986001002113}}@article{lee2018what, author={Lee, Sangseok and Lee, Dong Kyu}, title={{What is the proper way to apply the multiple comparison test?}}, journal={Korean Journal of Anesthesiology}, year={2018}, volume={71}, number={5}, pages={353--360}, doi={10.4097/kja.d.18.00242}}@article{midway2020comparing, author={Midway, Stephen and Robertson, Matthew and Flinn, Shane and Kaller, Michael}, title={{Comparing multiple comparisons: Practical guidance for choosing the best multiple comparisons test}}, journal={PeerJ}, year={2020}, volume={8}, eid={e10387}, doi={10.7717/peerj.10387}}@article{sauder2019updated, author={Sauder, Derek C. and DeMars, Christine E.}, title={{An updated recommendation for multiple comparisons}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={1}, pages={26--44}, doi={10.1177/2515245918808784}}@article{tukey1949comparing, author={Tukey, John W.}, title={{Comparing individual means in the analysis of variance}}, journal={Biometrics}, year={1949}, volume={5}, number={2}, pages={99--114}, doi={10.2307/3001913}}