Co to jest poziom istotności α?
Poziom istotności (α, alfa; ang. significance level) to próg ustalany przed badaniem: maksymalne dopuszczalne prawdopodobieństwo odrzucenia hipotezy zerowej, gdy jest ona prawdziwa. Taka pomyłka to błąd I rodzaju – fałszywy alarm. W psychologii najczęściej przyjmuje się α = .05.
Poziom istotności wyznacza regułę decyzyjną: odrzucasz H0, gdy wartość p jest mniejsza niż α – albo, równoważnie, gdy statystyka testu przekracza wartość krytyczną. W teście dwustronnym α dzieli się po równo na oba ogony rozkładu (po .025 przy α = .05). Poziom istotności łączy się też z przedziałem ufności: 95% CI odpowiada α = .05, a 99% CI – α = .01.
α jest cechą procedury, a nie pojedynczego wyniku: mówi, jak często reguła „odrzucam H0, gdy p < α” myli się w długiej serii badań, w których H0 jest prawdziwa. Nie mówi, z jakim prawdopodobieństwem konkretny wynik istotny jest fałszywym alarmem.
α jako odsetek fałszywych alarmów: symulacja
Zasymulowaliśmy 10 000 badań, w których H0 jest prawdziwa: dwie grupy po 30 osób losowane z tej samej populacji i porównywane testem t. Każdy wynik istotny jest więc fałszywym alarmem. Rysunek 1 pokazuje, jak zmieniał się odsetek takich wyników w miarę przybywania badań.
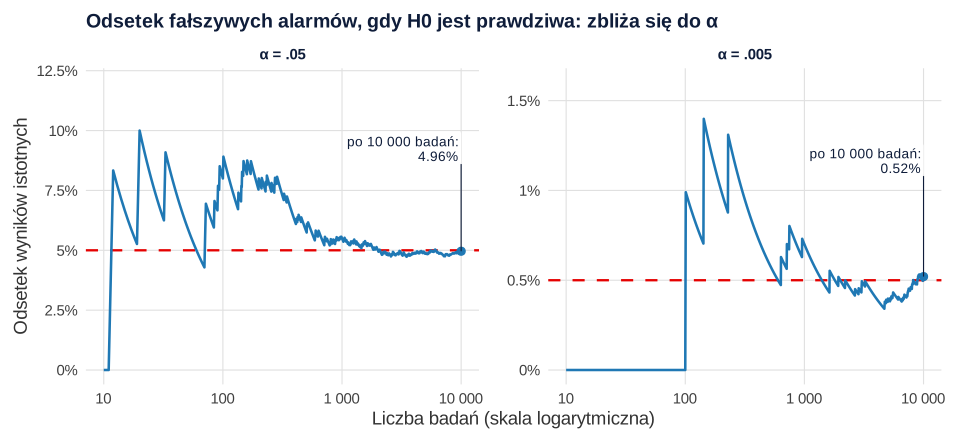
Na początku odsetek mocno skacze: po 20 badaniach wynosił 10%, po 100 – 8%, a przy α = .005 przez pierwsze sto badań nie było ani jednego fałszywego alarmu. Dopiero w długiej serii ustalił się przy wartości nominalnej: 496 z 10 000 badań (4.96%) dało p < .05, a 52 (0.52%) – p < .005. Tak właśnie należy rozumieć α: jako częstość błędu procedury w wielu powtórzeniach, a nie jako cechę jednego badania.
Poziom istotności a wartość p
| Cecha | Poziom istotności α | Wartość p |
|---|---|---|
| Kiedy powstaje | Przed zebraniem danych (w planie badania) | Po analizie danych |
| Czego dotyczy | Procedury decyzyjnej i jej długookresowej częstości błędu I rodzaju | Konkretnych danych: jak bardzo są niezgodne z H0 |
| Kto ją ustala | Badacz (i powinien to uzasadnić) | Wynika z danych i modelu |
| Zapis w pracy | „przyjęto α = .05” | dokładnie: p = .031 albo p < .001 |
Dlaczego .05? Propozycja .005 i uzasadnianie α
Wartość .05 to konwencja, a nie prawo natury, i od lat budzi spory. Benjamin i in. (2018) – zespół 72 autorów – zaproponowali, by domyślny próg istotności dla twierdzeń o nowych odkryciach obniżyć z .05 do .005. W odpowiedzi Lakens i in. (2018) postulowali, by zamiast jednego uniwersalnego progu badacze przejrzyście raportowali i uzasadniali wszystkie decyzje projektowe – w tym wybór α. Maier i Lakens (2022) opisują dwa praktyczne sposoby takiego uzasadnienia: minimalizowanie lub równoważenie łącznego ryzyka błędów I i II rodzaju oraz obniżanie α wraz ze wzrostem liczebności próby. Amrhein i in. (2019) idą najdalej i apelują o porzucenie dychotomicznego podziału wyników na „istotne” i „nieistotne”.
Co realnie zmienia obniżenie α? Zestawienie z naszej symulacji i obliczeń mocy (test t, dwie grupy, efekt d = 0.5):
| Wynik | α = .05 | α = .005 |
|---|---|---|
| Fałszywe alarmy w 10 000 badań przy prawdziwej H0 | 4.96% | 0.52% |
| Choć jeden fałszywy alarm w rodzinie 10 testów (teoria) | 39.7% (40.1%) | 4.7% (4.9%) |
| Wartość krytyczna t(58), test dwustronny | 2.00 | 2.92 |
| Moc przy 64 osobach w grupie | 80.1% | 49.1% |
| Liczebność potrzebna do mocy 80% | 64 osoby w grupie | 109 osób w grupie (+70%) |
Niższe α to mniej fałszywych alarmów, ale przy tej samej próbie – niższa moc, czyli częstsze przeoczenie prawdziwego efektu. Żeby utrzymać moc 80%, trzeba zbadać o 70% więcej osób. Dlatego wybór α to kompromis między dwoma rodzajami błędów, który warto zaplanować razem z liczebnością próby (zob. analiza mocy a priori w G*Power).
Wiele testów a poziom istotności
α dotyczy jednego testu. Jeśli wykonujesz k niezależnych testów, każdy na poziomie α, a wszystkie hipotezy zerowe są prawdziwe, prawdopodobieństwo choćby jednego fałszywego alarmu wynosi:
Dla dziesięciu testów przy α = .05 to 1 − .9510 = .401; w symulacji 10 000 takich „rodzin” testów choć jeden wynik istotny pojawił się w 39.7% z nich. Sposoby kontroli tego ryzyka – od korekty Bonferroniego (α/k, czyli .005 dla dziesięciu testów) po metodę Holma – opisujemy w haśle korekta Bonferroniego i porównania wielokrotne, a porównania po ANOVA – w haśle testy post hoc. Liczbę testów i sposób korekty ustal w planie analiz, najlepiej w prerejestracji.
Jak opisać poziom istotności w pracy
Poziom istotności podaj raz, w podrozdziale o analizie danych, razem z informacją, czy testy były jedno-, czy dwustronne, i jak kontrolowano wielokrotne porównania. W wynikach podawaj dokładne wartości p, a nie tylko „p < .05”.
Przykład w R
Kod powtarza symulację z rysunku 1, sprawdza ryzyko choćby jednego fałszywego alarmu w rodzinie dziesięciu testów i liczy, ile kosztuje obniżenie α (funkcja power.t.test()). Obliczenia trwają kilka sekund.
Fałszywe alarmy i moc przy α = .05 i α = .005
R
# 10 000 badań (dwie grupy po 30 osób), w których H0 jest prawdziwa
set.seed(2026)
p <- replicate(10000, t.test(rnorm(30), rnorm(30), var.equal = TRUE)$p.value)
c(alfa_05 = mean(p < .05), alfa_005 = mean(p < .005))      # odsetek fałszywych alarmów

# 10 000 rodzin po 10 niezależnych testów: czy choć jeden fałszywy alarm?
set.seed(2027)
rodziny <- matrix(replicate(100000, t.test(rnorm(30), rnorm(30), var.equal = TRUE)$p.value), ncol = 10)
c(alfa_05 = mean(apply(rodziny < .05, 1, any)), alfa_005 = mean(apply(rodziny < .005, 1, any)))
1 - (1 - c(.05, .005))^10                                    # wartości teoretyczne

# koszt niższego α: moc (n = 64 w grupie) i liczebność dla mocy .80 przy d = 0.5
sapply(c(.05, .005), function(a) power.t.test(n = 64, delta = 0.5, sig.level = a)$power)
sapply(c(.05, .005), function(a) power.t.test(power = .80, delta = 0.5, sig.level = a)$n)
Wynik w R
 alfa_05 alfa_005
  0.0496   0.0052
 alfa_05 alfa_005
  0.3966   0.0471
[1] 0.40126306 0.04888987
[1] 0.8014586 0.4909081
[1]  63.76576 108.48335
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Wybór α po obejrzeniu wyników – zmiana progu na .10, bo wyszło p = .07, przekreśla kontrolę błędu I rodzaju. Simmons i in. (2011) pokazali, że taka elastyczność w zbieraniu i analizie danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych (zob. p-hacking).
- „Prawdopodobieństwo, że mój wynik jest fałszywy, wynosi 5%” – α dotyczy badań z prawdziwą H0, a nie wyników istotnych. Odsetek fałszywych alarmów wśród wyników istotnych zależy też od mocy i od tego, jak często badane hipotezy są prawdziwe.
- Ignorowanie liczby testów – dwadzieścia testów bez korekty to prawie pewny fałszywy alarm: 1 − .9520 = .64.
- Mylenie dwóch „alf” – poziom istotności α nie ma nic wspólnego z alfą Cronbacha, która jest miarą rzetelności skali (zob. alfa Cronbacha).
Najczęstsze pytania
Co to jest poziom istotności?
Poziom istotności α to próg ustalany przed badaniem: maksymalne dopuszczalne prawdopodobieństwo odrzucenia hipotezy zerowej, gdy jest ona prawdziwa (błąd I rodzaju). Hipotezę zerową odrzucasz, gdy wartość p jest mniejsza niż α. Najczęściej przyjmuje się α = .05.
Dlaczego poziom istotności wynosi zwykle .05?
To konwencja, a nie wartość wynikająca z matematyki. Część badaczy proponuje obniżenie progu do .005 dla twierdzeń o nowych odkryciach (Benjamin i in., 2018), inni – uzasadnianie α w każdym badaniu, z uwzględnieniem kosztów obu rodzajów błędów (Lakens i in., 2018).
Czym różni się poziom istotności od wartości p?
Poziom istotności α ustalasz przed badaniem – opisuje procedurę i jej długookresową częstość fałszywych alarmów. Wartość p obliczasz z danych po badaniu – mówi, jak bardzo dane są niezgodne z H0. H0 odrzucasz, gdy p < α. Więcej w haśle wartość p.
Czy mogę przyjąć poziom istotności .10 albo .01?
Tak, jeśli zrobisz to przed zebraniem danych i uzasadnisz wybór, np. kosztami fałszywego alarmu i przeoczenia efektu. Wyższe α zwiększa ryzyko fałszywych alarmów, a niższe – przy tej samej próbie – obniża moc. Zmiana α po obejrzeniu wyników jest niedopuszczalna.
Jak liczba testów wpływa na poziom istotności?
Przy wielu testach rośnie szansa choćby jednego fałszywego alarmu: dla dziesięciu niezależnych testów na poziomie α = .05 wynosi ona około 40%. Dlatego przy rodzinie testów stosuje się korekty, np. Bonferroniego (α/k) albo Holma – zob. korekta Bonferroniego.
Czy alfa w poziomie istotności to to samo co alfa Cronbacha?
Nie. Poziom istotności α to próg decyzyjny w testowaniu hipotez, a alfa Cronbacha to współczynnik rzetelności (spójności wewnętrznej) skali. Łączy je tylko grecka litera.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wartość p: co naprawdę oznacza i jak ją poprawnie interpretować
Wartość p bez mitów: definicja, interpretacja, typowe błędy oraz sposób raportowania wraz z wielkością efektu i przedziałem ufności.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →PoradnikStatystyka do pracy magisterskiej: od planu do raportu
Kompletny proces analizy statystycznej do pracy magisterskiej: plan, przygotowanie danych, psychometria, modele, interpretacja i materiały do obrony.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Amrhein, V., Greenland, S., & McShane, B. (2019). Scientists rise up against statistical significance. Nature, 567(7748), 305–307. https://doi.org/10.1038/d41586-019-00857-9 ● Otwarty dostęp
- Benjamin, D. J., Berger, J. O., Johannesson, M., Nosek, B. A., Wagenmakers, E.-J., Berk, R., Bollen, K. A., Brembs, B., Brown, L., Camerer, C., Cesarini, D., Chambers, C. D., Clyde, M., Cook, T. D., De Boeck, P., Dienes, Z., Dreber, A., Easwaran, K., Efferson, C., . . . Johnson, V. E. (2018). Redefine statistical significance. Nature Human Behaviour, 2(1), 6–10. https://doi.org/10.1038/s41562-017-0189-z ● Otwarty dostęp
- Lakens, D., Adolfi, F. G., Albers, C. J., Anvari, F., Apps, M. A. J., Argamon, S. E., Baguley, T., Becker, R. B., Benning, S. D., Bradford, D. E., Buchanan, E. M., Caldwell, A. R., Van Calster, B., Carlsson, R., Chen, S.-C., Chung, B., Colling, L. J., Collins, G. S., Crook, Z., . . . Zwaan, R. A. (2018). Justify your alpha. Nature Human Behaviour, 2(3), 168–171. https://doi.org/10.1038/s41562-018-0311-x ● Otwarty dostęp: pełny tekst
- Maier, M., & Lakens, D. (2022). Justify your alpha: A primer on two practical approaches. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221080396. https://doi.org/10.1177/25152459221080396 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
Cytowania BibTeX
@article{amrhein2019scientists, author={Amrhein, Valentin and Greenland, Sander and McShane, Blake}, title={{Scientists rise up against statistical significance}}, journal={Nature}, year={2019}, volume={567}, number={7748}, pages={305--307}, doi={10.1038/d41586-019-00857-9}}@article{benjamin2018redefine, author={Benjamin, Daniel J. and Berger, James O. and Johannesson, Magnus and Nosek, Brian A. and Wagenmakers, Eric-Jan and Berk, Richard and Bollen, Kenneth A. and Brembs, Björn and Brown, Lawrence and Camerer, Colin and Cesarini, David and Chambers, Christopher D. and Clyde, Merlise and Cook, Thomas D. and De Boeck, Paul and Dienes, Zoltan and Dreber, Anna and Easwaran, Kenny and Efferson, Charles and others}, title={{Redefine statistical significance}}, journal={Nature Human Behaviour}, year={2018}, volume={2}, number={1}, pages={6--10}, doi={10.1038/s41562-017-0189-z}}@article{lakens2018justify, author={Lakens, Daniël and Adolfi, Federico G. and Albers, Casper J. and Anvari, Farid and Apps, Matthew A. J. and Argamon, Shlomo E. and Baguley, Thom and Becker, Raymond B. and Benning, Stephen D. and Bradford, Daniel E. and Buchanan, Erin M. and Caldwell, Aaron R. and Van Calster, Ben and Carlsson, Rickard and Chen, Sau-Chin and Chung, Bryan and Colling, Lincoln J. and Collins, Gary S. and Crook, Zander and others}, title={{Justify your alpha}}, journal={Nature Human Behaviour}, year={2018}, volume={2}, number={3}, pages={168--171}, doi={10.1038/s41562-018-0311-x}}@article{maier2022justify, author={Maier, Maximilian and Lakens, Daniël}, title={{Justify your alpha: A primer on two practical approaches}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221080396}, doi={10.1177/25152459221080396}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}