Po co wielkość efektu, skoro jest wartość p?
Wartość p odpowiada na wąskie pytanie: jak bardzo dane są niezgodne z hipotezą zerową. Nie mówi, jak duża jest różnica albo związek ani czy ma znaczenie w praktyce. Przy dużej próbie nawet znikomy efekt daje p < .001, a przy małej ważny efekt może dać p = .20. Dlatego wynik testu uzupełniasz o wielkość efektu (ang. effect size) i jej przedział ufności. Cumming (2014) nazywa to przejściem od testowania istotności do estymacji: pytasz nie „czy jest efekt?”, ale „jak duży jest efekt i jak dokładnie go oszacowaliśmy?”. Co dokładnie oznacza p i jak go nie odczytywać, wyjaśniamy we wpisie wartość p – interpretacja.
Wielkość efektu jest też walutą nauki skumulowanej. Z niej planuje się liczebność kolejnych badań (zob. dobór liczebności próby) i łączy wyniki w metaanalizach. Lakens (2013) pisze swój praktyczny przewodnik właśnie z tej perspektywy: raportuj efekty tak, żeby inni mogli ich użyć.
W tym wpisie pracujemy na jednym przykładzie (dane symulowane). 128 studentów losowo przydzielono do 6-tygodniowego programu radzenia sobie ze stresem albo do grupy kontrolnej z listy oczekujących, po 64 osoby. Po 6 tygodniach zmierzono poziom stresu na skali 0–40 (więcej punktów = większy stres). Dane: wielkosc-efektu-dane-przyklad.csv.
Wynik testu: w grupie programu średni stres wyniósł M = 16.88 (SD = 7.17), w grupie kontrolnej M = 21.09 (SD = 5.75). Test t Welcha: t(120.32) = −3.67, p < .001. Sama wartość p mówi tylko tyle, że takiego wyniku trudno się spodziewać, gdyby program nie działał. Reszta tego wpisu odpowiada na pytanie: ile to jest?
Trzy rodziny miar wielkości efektu
Miar są dziesiątki, ale większość należy do trzech rodzin. Wybór zależy od planu badania i rodzaju zmiennych, a nie od tego, która wartość „ładniej wygląda”.
| Rodzina | Miary | Typowy plan badania | Co mówi |
|---|---|---|---|
| Różnica średnich (rodzina d) | d Cohena, g Hedgesa, Δ Glassa, dz dla prób zależnych | dwie grupy, pomiar przed i po | o ile odchyleń standardowych różnią się średnie |
| Związek (rodzina r) | r Pearsona, korelacja punktowo-dwuseryjna, η², ω², R² | korelacje, ANOVA, regresja | siłę związku albo odsetek wyjaśnionej wariancji |
| Wyniki dwuwartościowe | iloraz szans (OR), ryzyko względne (RR), różnica ryzyka, NNT, φ, V Craméra | tabele krzyżowe, regresja logistyczna | o ile zmienia się szansa lub ryzyko zdarzenia |
Do tego dochodzi czwarta, często pomijana grupa: miary w jednostkach surowych. Różnica 4.22 punktu na skali 0–40 albo spadek bólu o 2 punkty w skali 0–10 bywa bardziej zrozumiała niż jakakolwiek miara standaryzowana. Zawsze, gdy skala ma znaczenie dla czytelnika, podawaj obie.
Przykład: jedna różnica, wiele liczb
Policzmy wszystkie popularne miary dla tego samego porównania programu z grupą kontrolną. Znak minus oznacza, że w grupie programu stres był niższy.
| Miara | Wartość [95% CI] | Jak ją czytać |
|---|---|---|
| Różnica średnich (punkty) | −4.22 [−6.49, −1.94] | stres niższy średnio o ok. 4 punkty na skali 0–40 |
| d Cohena | −0.65 [−1.00, −0.29] | różnica równa 0.65 połączonego SD |
| g Hedgesa | −0.65 [−1.00, −0.29] | jak d, z poprawką na małą próbę (przy 128 osobach bez zmiany) |
| Δ Glassa | −0.73 [−1.13, −0.32] | różnica w jednostkach SD grupy kontrolnej |
| r punktowo-dwuseryjne | −.31 | korelacja przynależności do programu ze stresem |
| η² / ω² | .10 / .09 | ok. 10% wariancji stresu wiąże się z grupą |
| Prawdopodobieństwo przewagi | .32 [.24, .42] | losowa osoba z programu ma wyższy stres niż losowa osoba z kontroli w 32% par |
| U3 Cohena | .26 [.16, .38] | 26% osób z programu ma stres wyższy niż średnia grupy kontrolnej (74% – niższy) |
| Nakładanie się rozkładów | .75 [.62, .88] | rozkłady obu grup pokrywają się w 75% |
Kilka obserwacji z tej tabeli.
- d i g różnią się dopiero w małych próbach. Hedges (1981) pokazał, że d w małych próbach jest obciążony, i podał estymator nieobciążony. Przy 128 osobach poprawka nie zmienia wyniku na drugim miejscu po kropce.
- Δ Glassa jest większa niż d, bo wariancja w grupie kontrolnej była mniejsza (SD = 5.75 wobec 7.17). Gdy interwencja może zmieniać zróżnicowanie wyników, Δ z SD grupy kontrolnej bywa łatwiejsza do obrony. Napisz jednak, który mianownik wybrałeś i dlaczego.
- η² = .10 brzmi skromnie, a d = 0.65 – całkiem poważnie. To ta sama różnica. Funder i Ozer (2019) zaliczają podnoszenie r do kwadratu do najczęstszych błędów, które sprawiają, że efekty wyglądają na mniejsze, niż są.
- Miary „języka potocznego” (prawdopodobieństwo przewagi, U3, nakładanie się rozkładów) dobrze sprawdzają się w dyskusji i na obronie. Pokazują też, że nawet przy wyraźnym efekcie rozkłady obu grup w dużej części się pokrywają.
Dla porównań więcej niż dwóch grup i w planach z powtarzanymi pomiarami miary z rodziny η² zachowują się inaczej. Olejnik i Algina (2003) pokazali, że cząstkowe η² zależy od schematu badania, i zaproponowali uogólnione η², porównywalne między schematami. Szczegóły – w hasłach o eta kwadrat i omega kwadrat.
Ten sam efekt jako wynik „tak/nie”: OR, RR i NNT
Załóżmy, że promotor prosi o odsetek osób z wysokim stresem, czyli co najmniej 25 punktów (próg przyjęty tylko na potrzeby przykładu). W grupie programu takich osób było 10 z 64 (15.6%), w grupie kontrolnej 17 z 64 (26.6%).
- Iloraz szans: OR = 0.51, 95% CI [0.21, 1.23] – szansa wysokiego stresu w grupie programu była o połowę mniejsza.
- Ryzyko względne: RR = 0.59, 95% CI [0.29, 1.18] – ryzyko było o 41% niższe.
- Różnica ryzyka: −10.9 punktu procentowego, 95% CI [−24.9, 3.1].
- NNT = 1 / 0.109 ≈ 9.1 – trzeba objąć programem około 9 osób, żeby jedna mniej miała wysoki stres. Ponieważ przedział dla różnicy ryzyka obejmuje zero, przedział dla NNT obejmuje nieskończoność, więc samo NNT bez przedziału byłoby mylące.
Zwróć uwagę na dwie rzeczy. Po pierwsze, OR i RR to nie to samo: przy częstym zdarzeniu OR jest dalej od 1 niż RR i łatwo przesadzić z interpretacją. Po drugie, podział wyniku ciągłego na dwie kategorie zabrał informację. Ta sama różnica, która jako wynik ciągły dała p < .001, po podziale ma przedziały obejmujące brak efektu. Przeliczona z OR daje d = −0.37 zamiast −0.65. Dlatego dzielenie zmiennych ilościowych na kategorie – podobnie jak podział medianą – stosuj tylko wtedy, gdy kategorie mają samodzielne znaczenie, a główną analizę rób na wyniku ciągłym.
Konwersje: d, r, OR i prawdopodobieństwo przewagi
Miary z różnych rodzin można przeliczać, co przydaje się przy porównywaniu badań i w metaanalizach. Przeliczenia zakładają jednak określony model danych: rozkład normalny i równe wariancje dla d → r, a rozkład logistyczny dla d → OR.
d = ln(OR) × √3 / π ≈ ln(OR) / 1.81
Drugi wzór to metoda Chinna (2000), który pokazał, że logarytm ilorazu szans można przeliczyć na wielkość efektu, dzieląc go przez 1.81. Tabela poniżej pokazuje te same wartości d w innych miarach.
| d | r (grupy 50/50) | r (grupy 90/10) | η² | OR | Prawdop. przewagi | U3 |
|---|---|---|---|---|---|---|
| 0.20 | .10 | .06 | .01 | 1.44 | .56 | .58 |
| 0.50 | .24 | .15 | .06 | 2.48 | .64 | .69 |
| 0.65 | .31 | .19 | .10 | 3.25 | .68 | .74 |
| 0.80 | .37 | .24 | .14 | 4.27 | .71 | .79 |
| 1.20 | .51 | .34 | .27 | 8.82 | .80 | .89 |
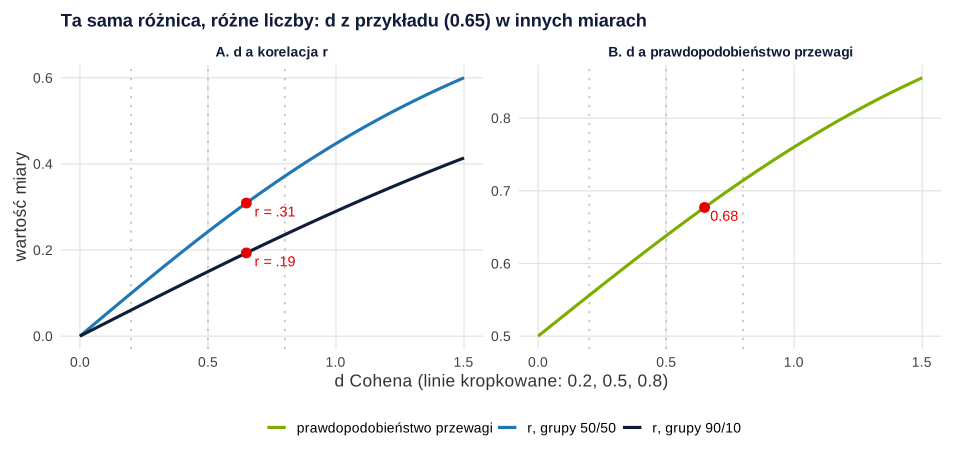
Najważniejsza lekcja z rysunku: ta sama różnica średnich daje różne r w zależności od proporcji grup. Przy d = 0.65 i grupach równolicznych r = .31, a przy podziale 90/10 – tylko .19. McGrath i Meyer (2006) pokazują, że z tego powodu r i d mogą prowadzić do różnych wniosków o wielkości efektu, i radzą świadomie uwzględniać proporcje grup. Podobnie z OR: Chen i in. (2010) wyliczyli, że przy częstości choroby 1% wartości OR = 1.68, 3.47 i 6.71 odpowiadają d równemu 0.2, 0.5 i 0.8. Przy innej częstości te progi się przesuwają.
Przedział ufności dla wielkości efektu
Wielkość efektu z jednej próby to oszacowanie obarczone błędem, tak samo jak średnia. W przykładzie d = −0.65, ale 95% CI [−1.00, −0.29] mieści zarówno efekty, które większość badaczy nazwałaby małymi, jak i bardzo duże. Uczciwy wniosek brzmi więc: „program obniżał stres, a dane są zgodne zarówno z efektem małym (0.29), jak i dużym (1.00)”.
Szerokość przedziału zależy głównie od liczebności. Dla prawdziwego d = 0.50 i dwóch równych grup przybliżony 95% CI wynosi:
| Osób w grupie | 95% CI dla d = 0.50 | Szerokość |
|---|---|---|
| 20 | [−0.13, 1.13] | 1.26 |
| 50 | [0.10, 0.90] | 0.80 |
| 100 | [0.22, 0.78] | 0.56 |
| 200 | [0.30, 0.70] | 0.40 |
| 500 | [0.37, 0.63] | 0.25 |
Przy 20 osobach w grupie przedział sięga od efektu lekko ujemnego do bardzo dużego, więc o wielkości efektu niewiele wiadomo, nawet gdy p < .05. Dopiero przy kilkuset osobach w grupie da się odróżnić efekt mały od umiarkowanego. To dobry argument, by planować badanie pod kątem precyzji, a nie tylko mocy.
Dlaczego opublikowane efekty bywają zawyżone
Jest jeszcze jeden powód, by nie ufać pojedynczej wartości d. Zasymulowaliśmy 10 000 badań po 30 osób w grupie, w których prawdziwy efekt wynosił d = 0.30. Moc takiego badania to tylko .21: wynik istotny w oczekiwanym kierunku dało 21.1% badań. Średnie d ze wszystkich badań wyniosło 0.31, czyli prawie dokładnie tyle, ile powinno. Ale średnie d z badań istotnych wyniosło 0.67 – ponad dwa razy więcej niż prawda. Najmniejsze istotne d to 0.52, więc żadne istotne badanie nie mogło pokazać prawdziwej wartości.
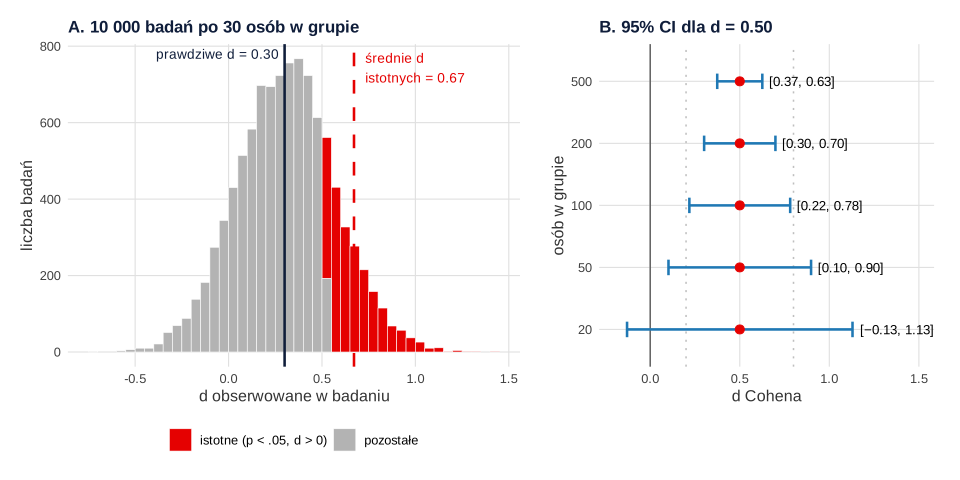
Button i in. (2013) opisują ten mechanizm jako jeden ze skutków niskiej mocy: zawyżone oszacowania efektów i słabą replikowalność. Jeśli czasopisma publikują głównie wyniki istotne (efekt szuflady), a badania mają małą moc, literatura systematycznie przecenia efekty. To jedno ze źródeł kryzysu replikacyjnego. Planując własne badanie na podstawie jednego opublikowanego d, przyjmij raczej mniejszą wartość albo oprzyj się na metaanalizie – zob. jak wykonać metaanalizę.
Dlaczego progi Cohena to nie reguła
Wartości d = 0.2, 0.5 i 0.8 („mały”, „średni”, „duży” efekt) oraz r = .10, .30 i .50 pochodzą z prac Cohena. W jego zestawieniu z 1992 roku służą jako konwencjonalne punkty odniesienia, m.in. do tabel liczebności potrzebnych dla mocy .80 (Cohen, 1992). W pracach dyplomowych stały się jednak automatycznym słownikiem: „d = 0.48, czyli efekt mały”. Z trzech powodów to za mało.
- Progi nie uwzględniają dziedziny. Funder i Ozer (2019) proponują dla psychologii inne odniesienia: r = .05 to efekt bardzo mały dla pojedynczych zdarzeń, ale potencjalnie ważny w dłuższej perspektywie, .10 – mały, .20 – średni, .30 – duży. Wartość r ≥ .40 uznają za prawdopodobnie zawyżoną i rzadko potwierdzaną w dużych próbach i replikacjach. Według progów Cohena r = .30 to dopiero efekt „średni”.
- Progi nie uwzględniają kosztów i skali. Ten sam efekt bywa ogromny albo trywialny: mały wpływ taniej interwencji w całej populacji studentów może mieć większe znaczenie niż duży wpływ drogiej terapii dla nielicznych.
- Progi ignorują niepewność. d = 0.65 z przedziałem [0.29, 1.00] (w wartościach bezwzględnych) obejmuje efekty od „małego” do „dużego”. Etykieta przypisana samemu oszacowaniu punktowemu sugeruje precyzję, której nie ma.
Jeśli używasz etykiet Cohena, podaj źródło i zaznacz, że to konwencja. Lepiej jednak porównać wynik z czymś konkretnym: z efektami podobnych interwencji, z najmniejszą różnicą ważną dla badanych albo z kosztem uzyskania efektu.
Interpretacja w kontekście: SESOI i MCID
Najlepsze pytanie interpretacyjne brzmi: czy efekt jest większy niż najmniejszy efekt, który miałby dla nas znaczenie? W badaniach podstawowych mówi się o najmniejszym interesującym efekcie (SESOI), a w badaniach klinicznych – o minimalnej istotnej klinicznie różnicy (MCID). Skąd wziąć taki próg?
- Metoda zakotwiczona. Anvari i Lakens (2021) pokazali, jak wyznaczyć najmniejszą subiektywnie odczuwaną zmianę: pyta się badanych, czy czują się inaczej, i sprawdza, jakiej zmianie wyniku skali odpowiada ta odpowiedź.
- Reguła połowy odchylenia standardowego. Norman i in. (2003) w przeglądzie 38 badań jakości życia stwierdzili, że minimalna istotna różnica wynosiła zwykle około 0.5 SD. To przydatny punkt wyjścia, gdy brakuje lepszych danych, ale nie uniwersalne prawo.
- Uzasadnienie praktyczne – koszt, czas, porównanie z efektem standardowego postępowania.
W przykładzie przyjmijmy, że różnica 3 punktów na skali stresu jest najmniejszą, jaką uznalibyśmy za ważną (wartość założona). Połowa SD grupy kontrolnej to 2.87 punktu, więc oba kryteria są zbliżone. Obserwowana różnica wyniosła 4.22 punktu, ale 95% CI [1.94, 6.49] (w wartościach bezwzględnych) obejmuje też wartości poniżej 3. Jednostronny test, czy efekt jest większy niż 3 punkty, daje p = .145. Wniosek: program obniżał stres, ale dane nie pozwalają stwierdzić, że efekt na pewno przekraczał próg ważności. Ten sam tok rozumowania, odwrócony, służy do wykazywania braku efektu – to test równoważności TOST. Jak użyć go przy wyniku nieistotnym, pokazujemy we wpisie hipoteza się nie potwierdziła.
Pomaga też przełożenie efektu na osoby: poniżej mediany grupy kontrolnej (21 punktów) znalazło się 70.3% osób z programu wobec 48.4% osób z grupy kontrolnej. Takie zdanie czytelnik zrozumie bez znajomości d.
Jak opisać wielkość efektu w pracy (APA)
Podaj miarę, jej wartość i 95% CI, a dla skal o znanym sensie – także różnicę w jednostkach surowych. Interpretację oprzyj na kontekście, nie tylko na etykiecie. Ogólne zasady zapisu – w poradniku jak opisać wyniki w stylu APA.
Tabelę z wieloma porównaniami i wielkościami efektu przygotujesz według wzorów z wpisu tabele APA – wzory i przykłady. Jeśli nie wiesz, którą miarę wybrać dla swojego planu badania albo jak ją zinterpretować, sprawdzimy to w ramach analiz statystycznych dla studentów.
Wielkość efektu w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Pobierz plik wielkosc-efektu-dane-przyklad.csv i zapisz go w katalogu roboczym R. Przepisy 1, 2 i 5 wczytują dane samodzielnie, przepisy 3 i 4 ich nie potrzebują. Symulacja w przepisie 4 trwa kilka sekund.
1. Różnica średnich i miary wielkości efektu
R
library(effectsize)   # cohens_d(), hedges_g(), glass_delta(), p_superiority(), cohens_u3(), p_overlap()

dane <- read.csv("wielkosc-efektu-dane-przyklad.csv")
dane$grupa <- factor(dane$grupa, levels = c("program", "kontrola"))   # różnica = program − kontrola

# Opis grup i surowa różnica średnich z 95% CI (test t Welcha)
aggregate(stres ~ grupa, data = dane, FUN = function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
tt <- t.test(stres ~ grupa, data = dane)
round(c(roznica = unname(diff(rev(tt$estimate))), CI_dolna = tt$conf.int[1], CI_gorna = tt$conf.int[2],
        t = unname(tt$statistic), df = unname(tt$parameter)), 3)
signif(tt$p.value, 3)   # dokładne p (w APA: p < .001)

# Rodzina d: d Cohena (pooled SD), g Hedgesa (poprawka na małą próbę), Δ Glassa (SD grupy kontrolnej)
cohens_d(stres ~ grupa, data = dane)
hedges_g(stres ~ grupa, data = dane)
glass_delta(stres ~ grupa, data = dane)

# Rodzina r: korelacja punktowo-dwuseryjna i eta kwadrat z tego samego porównania
dane$program <- as.numeric(dane$grupa == "program")
round(cor(dane$program, dane$stres), 3)
eta_squared(aov(stres ~ grupa, data = dane), partial = FALSE)
omega_squared(aov(stres ~ grupa, data = dane), partial = FALSE)

# Miary „języka potocznego”: prawdopodobieństwo przewagi, U3 Cohena, nakładanie się rozkładów
p_superiority(stres ~ grupa, data = dane, parametric = TRUE)
cohens_u3(stres ~ grupa, data = dane)
p_overlap(stres ~ grupa, data = dane)
Wynik w R
     grupa stres.n stres.M stres.SD
1  program   64.00   16.88     7.17
2 kontrola   64.00   21.09     5.75
 roznica CI_dolna CI_gorna        t       df
  -4.219   -6.493   -1.945   -3.673  120.320
[1] 0.000359
Cohen's d |         95% CI
--------------------------
-0.65     | [-1.00, -0.29]

- Estimated using pooled SD.Hedges' g |         95% CI
--------------------------
-0.65     | [-1.00, -0.29]

- Estimated using pooled SD.Glass' delta (adj.) |         95% CI
------------------------------------
-0.73               | [-1.13, -0.32]
[1] -0.311
# Effect Size for ANOVA (Type I)

Parameter | Eta2 |       95% CI
-------------------------------
grupa     | 0.10 | [0.03, 1.00]

- One-sided CIs: upper bound fixed at [1.00].# Effect Size for ANOVA (Type I)

Parameter | Omega2 |       95% CI
---------------------------------
grupa     |   0.09 | [0.03, 1.00]

- One-sided CIs: upper bound fixed at [1.00].Pr(superiority) |       95% CI
------------------------------
0.32            | [0.24, 0.42]
Cohen's U3 |       95% CI
-------------------------
0.26       | [0.16, 0.38]
Overlap |       95% CI
----------------------
0.75    | [0.62, 0.88]
2. Wynik dwuwartościowy: OR, RR, różnica ryzyka i NNT
R
library(effectsize)   # oddsratio(), riskratio(), oddsratio_to_d()

dane <- read.csv("wielkosc-efektu-dane-przyklad.csv")
# Wysoki stres: co najmniej 25 punktów (próg przyjęty tylko na potrzeby przykładu)
dane$wysoki <- factor(ifelse(dane$stres >= 25, "tak", "nie"), levels = c("tak", "nie"))
dane$grupa <- factor(dane$grupa, levels = c("program", "kontrola"))
tab <- table(dane$grupa, dane$wysoki)
tab
round(100 * prop.table(tab, 1), 1)

# Iloraz szans, ryzyko względne, różnica ryzyka i NNT (program względem kontroli)
# effectsize oczekuje grup w kolumnach, a wyniku w wierszach – dlatego tabela jest transponowana
oddsratio(t(tab))
riskratio(t(tab))
p1 <- tab["program", "tak"] / sum(tab["program", ]); p0 <- tab["kontrola", "tak"] / sum(tab["kontrola", ])
rd <- prop.test(tab[, "tak"], rowSums(tab), correct = FALSE)$conf.int   # przedział Walda dla różnicy dwóch proporcji
round(c(ryzyko_program = p1, ryzyko_kontrola = p0, RR = p1 / p0, roznica_ryzyka = p1 - p0,
        CI_dolna = rd[1], CI_gorna = rd[2], NNT = 1 / abs(p1 - p0)), 3)

# Przeliczenie OR na d (Chinn, 2000: d = ln(OR) × √3 / π) i porównanie z d z wyniku ciągłego
OR <- oddsratio(t(tab))$Odds_ratio
round(c(OR = OR, d_z_OR = oddsratio_to_d(OR), d_reczne = log(OR) * sqrt(3) / pi), 3)
Wynik w R
           tak nie
  program   10  54
  kontrola  17  47

            tak  nie
  program  15.6 84.4
  kontrola 26.6 73.4
Odds ratio |       95% CI
-------------------------
0.51       | [0.21, 1.23]
Risk ratio |       95% CI
-------------------------
0.59       | [0.29, 1.18]
 ryzyko_program ryzyko_kontrola              RR  roznica_ryzyka        CI_dolna
          0.156           0.266           0.588          -0.109          -0.249
       CI_gorna             NNT
          0.031           9.143
      OR   d_z_OR d_reczne
   0.512   -0.369   -0.369
3. Przeliczenia między miarami
R
library(effectsize)   # d_to_r(), d_to_oddsratio(), d_to_p_superiority(), d_to_u3()

# Jedna wartość d w różnych miarach (rozkłady normalne, równe wariancje)
d <- c(0.2, 0.5, 0.65, 0.8, 1.2)
round(data.frame(d,
  r_grupy_rowne   = d_to_r(d),                      # grupy 50/50
  r_grupy_90_10   = d_to_r(d, n1 = 90, n2 = 10),    # te same d, ale grupy 90/10
  eta2_rowne      = d_to_r(d)^2,
  OR_logit        = d_to_oddsratio(d),              # przeliczenie przez rozkład logistyczny (Chinn, 2000)
  P_przewagi      = d_to_p_superiority(d),
  U3              = d_to_u3(d)), 3)

# Odwrotnie: r = .10, .20, .30 (Funder i Ozer, 2019) wyrażone jako d przy równych grupach
round(data.frame(r = c(.05, .10, .20, .30, .40), d = r_to_d(c(.05, .10, .20, .30, .40))), 2)
Wynik w R
     d r_grupy_rowne r_grupy_90_10 eta2_rowne OR_logit P_przewagi    U3
1 0.20         0.100         0.060      0.010    1.437      0.556 0.579
2 0.50         0.243         0.150      0.059    2.477      0.638 0.691
3 0.65         0.309         0.193      0.096    3.251      0.677 0.742
4 0.80         0.371         0.236      0.138    4.268      0.714 0.788
5 1.20         0.514         0.342      0.265    8.816      0.802 0.885
     r    d
1 0.05 0.10
2 0.10 0.20
3 0.20 0.41
4 0.30 0.63
5 0.40 0.87
4. Precyzja d i zawyżenie efektów w badaniach istotnych
R
# (a) Jak szeroki jest 95% CI dla d przy różnej liczebności? (d = 0.50, równe grupy, przybliżenie Hedgesa i Olkina)
n <- c(20, 50, 100, 200, 500)
se_d <- sqrt(2 / n + 0.5^2 / (4 * n))
round(data.frame(n_w_grupie = n, CI_dolna = 0.5 - 1.96 * se_d, CI_gorna = 0.5 + 1.96 * se_d, szerokosc = 2 * 1.96 * se_d), 2)

# (b) Selekcja na istotność: 10 000 badań, prawdziwe d = 0.30, 30 osób w grupie
set.seed(2016)
sym <- t(replicate(10000, {
  x <- rnorm(30, 0.3); y <- rnorm(30, 0)
  sp <- sqrt((var(x) + var(y)) / 2)
  c(d = (mean(x) - mean(y)) / sp, p = t.test(x, y, var.equal = TRUE)$p.value)
}))
istotne <- sym[, "p"] < .05 & sym[, "d"] > 0
round(c(moc = mean(sym[, "p"] < .05), moc_w_kierunku = mean(istotne), sr_d_wszystkie = mean(sym[, "d"]), sr_d_istotne = mean(sym[sym[, "p"] < .05 & sym[, "d"] > 0, "d"]),
        min_d_istotne = min(sym[istotne, "d"]), proc_istotnych_d_ponad_0.5 = 100 * mean(sym[istotne, "d"] > 0.5)), 3)
# Moc analitycznie, dla porównania
power.t.test(n = 30, delta = 0.3, sd = 1)$power
Wynik w R
  n_w_grupie CI_dolna CI_gorna szerokosc
1         20    -0.13     1.13      1.26
2         50     0.10     0.90      0.80
3        100     0.22     0.78      0.56
4        200     0.30     0.70      0.40
5        500     0.37     0.63      0.25
                       moc             moc_w_kierunku
                     0.212                      0.211
            sr_d_wszystkie               sr_d_istotne
                     0.309                      0.671
             min_d_istotne proc_istotnych_d_ponad_0.5
                     0.517                    100.000
[1] 0.2068937
5. Efekt na tle najmniejszej ważnej różnicy
R
dane <- read.csv("wielkosc-efektu-dane-przyklad.csv")
dane$grupa <- factor(dane$grupa, levels = c("program", "kontrola"))
tt <- t.test(stres ~ grupa, data = dane)
sd_kontrola <- sd(dane$stres[dane$grupa == "kontrola"])

# Kontekst 1: najmniejsza istotna zmiana przyjęta w przykładzie = 3 punkty skali 0–40 (wartość założona)
# Kontekst 2: reguła „połowy SD” (Norman i in., 2003) liczona z SD grupy kontrolnej
round(c(roznica = unname(diff(rev(tt$estimate))), CI_dolna = tt$conf.int[1], CI_gorna = tt$conf.int[2],
        pol_SD = 0.5 * sd_kontrola), 2)

# Ilu osobom w każdej grupie wynik spadł poniżej mediany grupy kontrolnej?
med_k <- median(dane$stres[dane$grupa == "kontrola"])
round(c(mediana_kontroli = med_k,
        proc_program_ponizej = 100 * mean(dane$stres[dane$grupa == "program"] < med_k),
        proc_kontrola_ponizej = 100 * mean(dane$stres[dane$grupa == "kontrola"] < med_k)), 1)

# Test przeciw SESOI: czy efekt jest większy niż 3 punkty? (test jednostronny, H0: różnica ≥ −3)
t.test(stres ~ grupa, data = dane, mu = -3, alternative = "less")$p.value
Wynik w R
 roznica CI_dolna CI_gorna   pol_SD
   -4.22    -6.49    -1.94     2.87
     mediana_kontroli  proc_program_ponizej proc_kontrola_ponizej
                 21.0                  70.3                  48.4
[1] 0.1453702
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy przy wielkości efektu
- Brak wielkości efektu przy wyniku nieistotnym. Właśnie wtedy jest najbardziej potrzebna: pokazuje, czy brak istotności wynika z małego efektu, czy z małej precyzji.
- Wielkość efektu bez przedziału ufności i etykieta „duży efekt” przyklejona do oszacowania punktowego.
- Nienazwana wersja miary. d z połączonym SD, dz dla prób zależnych i Δ Glassa to różne liczby. Napisz, którą liczysz (Lakens, 2013).
- Wybór miary po wyniku. Raportowanie tej z miar, która wygląda najkorzystniej, to ten sam problem co wybieranie testu po p.
- Mylenie η² z cząstkowym η² w ANOVA wieloczynnikowej – cząstkowe jest zwykle większe i nie sumuje się do 1.
- Interpretowanie OR jak RR („szansa dwa razy większa” to nie „dwa razy częściej”) przy częstych zdarzeniach.
- Przeliczanie d na r bez uwzględnienia proporcji grup i porównywanie wyników z badań o różnych proporcjach (McGrath i Meyer, 2006).
- Planowanie próby na podstawie jednego opublikowanego efektu – zwłaszcza z małego badania, gdzie efekt jest najpewniej zawyżony.
Najczęstsze pytania
Jak przeliczyć d Cohena na korelację r?
Przy dwóch równolicznych grupach r = d / √(d² + 4), np. d = 0.50 odpowiada r = .24. Gdy grupy są nierówne, liczba 4 zmienia się na (n1 + n2)² / (n1n2) i ta sama wartość d daje mniejsze r – przy podziale 90/10 dla d = 0.50 tylko .15. Dlatego przy przeliczeniach podaj proporcje grup.
Jak przeliczyć iloraz szans na d Cohena?
Najprostsza metoda to d = ln(OR) × √3 / π, czyli logarytm naturalny OR podzielony przez około 1.81 (Chinn, 2000). Na przykład OR = 2.48 odpowiada d ≈ 0.50. Przeliczenie zakłada, że wynik dwuwartościowy powstał z podziału zmiennej ciągłej o rozkładzie logistycznym, więc traktuj je jako przybliżenie.
Czy wielkość efektu trzeba podawać, gdy wynik jest nieistotny?
Tak – wtedy jest szczególnie potrzebna. Wielkość efektu z przedziałem ufności pokazuje, czy wynik nieistotny wynika z efektu bliskiego zera (wąski przedział wokół zera), czy z małej precyzji (szeroki przedział obejmujący także duże efekty). Bez niej czytelnik nie odróżni tych sytuacji.
Dlaczego η² jest dużo mniejsze niż d Cohena dla tych samych danych?
Bo to inne skale: η² to odsetek wyjaśnionej wariancji, czyli w przybliżeniu kwadrat korelacji. Dla dwóch równych grup d = 0.65 odpowiada η² ≈ .10, a d = 0.20 – η² ≈ .01. Kwadrat korelacji sprawia, że efekty wyglądają na mniejsze, niż są, dlatego nie porównuj η² wprost z d.
Jak zinterpretować wielkość efektu bez progów Cohena?
Porównaj ją z czymś konkretnym: z najmniejszą różnicą ważną dla badanych (SESOI, MCID), z efektami podobnych interwencji w metaanalizach albo z kosztem uzyskania efektu. Przełóż ją też na język potoczny, np. odsetek osób z grupy eksperymentalnej, które wypadły lepiej niż przeciętna osoba z grupy kontrolnej. Zawsze uwzględnij przedział ufności, a nie tylko oszacowanie punktowe.
Powiązane hasła
Przeczytaj też
Wielkość efektu w obrazkach: d = 0.2, 0.5 i 0.8
Nakładanie rozkładów, U3 i przewaga sprawdzone symulacją, d z małej i dużej próby, r na wykresie rozrzutu i OR jako słupki ryzyka – z kodem R.
Czytaj →PoradnikPorównanie wyników z literaturą
Jak przeliczyć średnie i SD, t, F, r i OR z artykułów na g Hedgesa z przedziałem ufności, zestawić je z własnym wynikiem na jednym wykresie i napisać o tym w dyskusji – z przykładem w R.
Czytaj →PoradnikHipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →PoradnikWartość p – interpretacja
Błędne odczytania p na jednym przykładzie, symulacja p pod H0 i H1, replikacje, p a przedział ufności i wielkość efektu – z kodem R.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →Nie wiesz, jaką miarę efektu podać i jak ją opisać?
Dobierzemy miarę wielkości efektu do planu Twojego badania, policzymy ją z przedziałem ufności i wyjaśnimy, jak ją zinterpretować w pracy i na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Anvari, F., & Lakens, D. (2021). Using anchor-based methods to determine the smallest effect size of interest. Journal of Experimental Social Psychology, 96, Article 104159. https://doi.org/10.1016/j.jesp.2021.104159 ● Otwarty dostęp
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475 ● Otwarty dostęp
- Chen, H., Cohen, P., & Chen, S. (2010). How big is a big odds ratio? Interpreting the magnitudes of odds ratios in epidemiological studies. Communications in Statistics—Simulation and Computation, 39(4), 860–864. https://doi.org/10.1080/03610911003650383
- Chinn, S. (2000). A simple method for converting an odds ratio to effect size for use in meta-analysis. Statistics in Medicine, 19(22), 3127–3131. https://doi.org/10.1002/1097-0258(20001130)19:22<3127::aid-sim784>3.0.co;2-m
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Funder, D. C., & Ozer, D. J. (2019). Evaluating effect size in psychological research: Sense and nonsense. Advances in Methods and Practices in Psychological Science, 2(2), 156–168. https://doi.org/10.1177/2515245919847202 ● Otwarty dostęp
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- McGrath, R. E., & Meyer, G. J. (2006). When effect sizes disagree: The case of r and d. Psychological Methods, 11(4), 386–401. https://doi.org/10.1037/1082-989X.11.4.386
- Norman, G. R., Sloan, J. A., & Wyrwich, K. W. (2003). Interpretation of changes in health-related quality of life: The remarkable universality of half a standard deviation. Medical Care, 41(5), 582–592. https://doi.org/10.1097/01.mlr.0000062554.74615.4c
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
Cytowania BibTeX
@article{anvari2021using, author={Anvari, Farid and Lakens, Daniël}, title={{Using anchor-based methods to determine the smallest effect size of interest}}, journal={Journal of Experimental Social Psychology}, year={2021}, volume={96}, eid={104159}, doi={10.1016/j.jesp.2021.104159}}@article{button2013power, author={Button, Katherine S. and Ioannidis, John P. A. and Mokrysz, Claire and Nosek, Brian A. and Flint, Jonathan and Robinson, Emma S. J. and Munafò, Marcus R.}, title={{Power failure: Why small sample size undermines the reliability of neuroscience}}, journal={Nature Reviews Neuroscience}, year={2013}, volume={14}, number={5}, pages={365--376}, doi={10.1038/nrn3475}}@article{chen2010how, author={Chen, Henian and Cohen, Patricia and Chen, Sophie}, title={{How big is a big odds ratio? Interpreting the magnitudes of odds ratios in epidemiological studies}}, journal={Communications in Statistics—Simulation and Computation}, year={2010}, volume={39}, number={4}, pages={860--864}, doi={10.1080/03610911003650383}}@article{chinn2000simple, author={Chinn, Susan}, title={{A simple method for converting an odds ratio to effect size for use in meta-analysis}}, journal={Statistics in Medicine}, year={2000}, volume={19}, number={22}, pages={3127--3131}, doi={10.1002/1097-0258(20001130)19:22<3127::aid-sim784>3.0.co;2-m}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{funder2019evaluating, author={Funder, David C. and Ozer, Daniel J.}, title={{Evaluating effect size in psychological research: Sense and nonsense}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={2}, pages={156--168}, doi={10.1177/2515245919847202}}@article{hedges1981distribution, author={Hedges, Larry V.}, title={{Distribution theory for Glass’s estimator of effect size and related estimators}}, journal={Journal of Educational Statistics}, year={1981}, volume={6}, number={2}, pages={107--128}, doi={10.3102/10769986006002107}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{mcgrath2006when, author={McGrath, Robert E. and Meyer, Gregory J.}, title={{When effect sizes disagree: The case of r and d}}, journal={Psychological Methods}, year={2006}, volume={11}, number={4}, pages={386--401}, doi={10.1037/1082-989x.11.4.386}}@article{norman2003interpretation, author={Norman, Geoffrey R. and Sloan, Jeff A. and Wyrwich, Kathleen W.}, title={{Interpretation of changes in health-related quality of life: The remarkable universality of half a standard deviation}}, journal={Medical Care}, year={2003}, volume={41}, number={5}, pages={582--592}, doi={10.1097/01.mlr.0000062554.74615.4c}}@article{olejnik2003generalized, author={Olejnik, Stephen and Algina, James}, title={{Generalized eta and omega squared statistics: Measures of effect size for some common research designs}}, journal={Psychological Methods}, year={2003}, volume={8}, number={4}, pages={434--447}, doi={10.1037/1082-989x.8.4.434}}