Statystyka w pracy z psychologii: co jest w niej szczególnego
Praca dyplomowa z psychologii ma kilka cech, które odróżniają ją od prac z innych kierunków. Prawie zawsze mierzysz konstrukty, których nie widać bezpośrednio – lęk, samoocenę, wypalenie – za pomocą kwestionariuszy i testów. Te narzędzia mają klucze, normy i znane parametry psychometryczne, a promotor oczekuje, że będziesz z nich korzystać poprawnie. Do tego dochodzi styl APA, który w psychologii jest standardem, oraz coraz częstsze pytania o wielkość efektu i rzetelność pomiaru w Twojej próbie.
Ten poradnik dotyczy praktyki: jakie projekty powstają w pracach z psychologii, jak przejść od odpowiedzi na pozycje do wyniku skali, jak ocenić rzetelność, jak korzystać z norm, jak przeanalizować prosty eksperyment i jak to wszystko opisać. O tym, co statystyka daje psychologii jako nauce i jakie ma ograniczenia, piszemy osobno w tekście statystyka dla psychologów. Jeśli dopiero zaczynasz przygodę ze statystyką, zacznij od przewodnika statystyka dla studenta.
Przykłady liczbowe pochodzą z dwóch symulowanych badań: kwestionariuszowego (150 studentów, fikcyjna Skala Samooceny Akademickiej) i eksperymentalnego (84 osoby, dwa warunki informacji zwrotnej). Plik do pobrania: statystyka-dla-psychologa-dane.xlsx – arkusze Kwestionariusz, Eksperyment i Instrukcja. Skala SSA i jej normy są wymyślone na potrzeby przykładu; w pracy korzystasz z prawdziwego narzędzia i jego podręcznika.
Pięć typowych projektów prac z psychologii
Większość prac licencjackich i magisterskich z psychologii to jeden z pięciu projektów. Każdy ma swoje pytanie, swoją główną analizę i swoje pułapki.
| Projekt | Przykładowe pytanie | Główna analiza | Na co uważać | Poradnik |
|---|---|---|---|---|
| Kwestionariuszowy korelacyjny | Czy samoocena wiąże się ze średnią ocen? | korelacja Pearsona lub Spearmana, regresja wieloraka | przyczynowość, wspólna wariancja metody | korelacja krok po kroku |
| Porównanie grup naturalnych | Czy studenci psychologii i informatyki różnią się empatią? | test t Welcha, ANOVA | grupy różnią się wieloma cechami naraz | test t krok po kroku |
| Moderacja lub mediacja | Czy wsparcie osłabia związek stresu z wypaleniem? | regresja z interakcją, model mediacji z bootstrapem | mediacja w badaniu przekrojowym nie dowodzi procesu | statystyka do pracy magisterskiej |
| Eksperyment | Czy negatywna informacja zwrotna podnosi stan lęku? | test t Welcha, ANOVA, ANCOVA | sprawdzenie manipulacji, etyka, debriefing | ANOVA krok po kroku |
| Adaptacja lub walidacja narzędzia | Czy polska wersja skali ma strukturę oryginału? | CFA, rzetelność, trafność zbieżna | licencja, tłumaczenie, inwariancja | adaptacja kwestionariusza |
Dwa pierwsze projekty dominują w licencjatach, trzy kolejne – częściej w magisterkach. Moderację i mediację omawiamy krok po kroku na przykładzie w tekście o pracy magisterskiej, a także w poradnikach analiza moderacji i analiza mediacji. Hayes i Rockwood (2017), omawiając te analizy w badaniach klinicznych, obalają kilka popularnych mitów – warto po ten tekst sięgnąć, zanim napiszesz rozdział o modelu.
W każdym z tych projektów kluczowe jest jednak to samo: dobrze policzony wynik kwestionariusza. Od tego zaczniemy.
Od odpowiedzi na pozycje do wyniku skali
Każdy kwestionariusz psychologiczny ma klucz: które pozycje tworzą skalę, które trzeba odwrócić i czy wynik to suma, czy średnia. Klucz bierzesz z podręcznika testu albo z artykułu, w którym opublikowano polską wersję – nigdy nie ustalasz go sam(a). Trzy decyzje, które musisz podjąć i opisać:
- Odwrócenie pozycji odwróconych. Przy skali 1–4 nowa wartość to 5 − odpowiedź; ogólnie: (minimum + maksimum) − odpowiedź.
- Suma czy średnia. Jeśli podręcznik podaje normy dla sumy, licz sumę – inaczej nie porównasz wyników z normami. Średnia jest wygodna, gdy skale mają różną liczbę pozycji albo zdarzają się pojedyncze braki. Więcej w haśle wynik skali: średnia czy suma.
- Braki odpowiedzi. Ustal regułę z góry (np. wynik liczony, gdy brakuje najwyżej jednej pozycji) i podaj ją w metodzie. Sumy z brakującymi pozycjami są zaniżone.
W przykładzie fikcyjna Skala Samooceny Akademickiej (SSA) ma 10 pozycji z odpowiedziami 1–4; pozycje 3, 5, 8 i 10 są sformułowane negatywnie. Po ich odwróceniu wynik surowy (suma, zakres możliwy 10–40) wyniósł w próbie 150 studentów średnio 25.15 punktu (SD = 6.06, zakres 11–38).
Rzetelność: alfa, omega i analiza pozycji
W pracy z psychologii podajesz rzetelność narzędzia w swojej próbie, a nie tylko wartości z podręcznika. Najczęściej jest to alfa Cronbacha, coraz częściej – także omega McDonalda. W przykładzie:
- alfa Cronbacha wyniosła .83, a omega z modelu jednoczynnikowego – .84;
- skorygowane korelacje pozycji z resztą skali wynosiły od .43 do .66 – z wyjątkiem pozycji 7, której korelacja wyniosła tylko .20, a ładunek czynnikowy .24;
- po usunięciu pozycji 7 alfa wzrosłaby z .83 do .84.
Dlaczego dwie miary? McNeish (2018) pokazuje, że alfa ma nierealistyczne założenia (m.in. równe ładunki wszystkich pozycji), które zwykle prowadzą do zaniżania rzetelności, i omawia omegę jako alternatywę. Dunn i in. (2014) pokazują, jak obliczyć omegę wraz z przedziałem ufności w darmowym oprogramowaniu. Gdy ładunki są podobne, obie miary dają zbliżone wyniki; gdy jedna pozycja odstaje – jak tutaj pozycja 7 – różnica rośnie. Szczegóły znajdziesz w poradniku alfa Cronbacha – jak oceniać rzetelność i w haśle omega McDonalda.
Co zrobić ze słabą pozycją? W pracy dyplomowej z gotowym, opublikowanym narzędziem nie usuwaj pozycji tylko po to, żeby podnieść alfę. Zmieniłbyś(-łabyś) narzędzie, a Twoich wyników nie dałoby się porównać z normami ani z innymi badaniami. Zamiast tego podaj wynik analizy pozycji i omów go w ograniczeniach. Flake i Fried (2020) nazywają nieujawnione decyzje dotyczące pomiaru wątpliwymi praktykami pomiarowymi, które uniemożliwiają ocenę trafności wniosków. Jeśli więc mimo wszystko modyfikujesz skalę, napisz to wprost i pokaż wyniki dla obu wersji. Clark i Watson (1995) przypominają też, że celem budowy skali jest jednowymiarowość, a nie maksymalna spójność wewnętrzna – bardzo wysoka alfa może oznaczać pozycje, które powtarzają tę samą treść. Gotowe zdania do raportowania rzetelności, także w trudnych przypadkach, zebraliśmy we wpisie wzór raportowania alfy Cronbacha.
Wyniki surowe, normy i steny
Wynik surowy „25 punktów” sam w sobie nic nie mówi. Znaczenia nabiera dopiero w porównaniu z grupą odniesienia, czyli z normami testowymi. Podręczniki testów podają tabele, które przeliczają wynik surowy na wynik standaryzowany: steny (1–10, średnia 5.5, SD = 2), wyniki tenowe (średnia 50, SD = 10) albo centyle. Standardy testowania wymagają, by normy odnosiły się do jasno opisanej populacji, a raport z normalizacji podawał m.in. sposób doboru próby i daty badania (American Educational Research Association i in., 2014).
W praktyce pracy dyplomowej oznacza to trzy zasady:
- Korzystaj z tabel z podręcznika, a nie ze wzoru. Tabele uwzględniają kształt rozkładu i często osobne normy dla płci i wieku. Wzór sten = 5.5 + 2z to tylko przybliżenie dla rozkładu normalnego.
- Dobierz właściwą grupę normalizacyjną. Normy dla dorosłych nie pasują do licealistów, a normy sprzed 20 lat mogą nie pasować do dzisiejszych studentów. Napisz, z których norm korzystasz.
- Analizy statystyczne licz na wynikach surowych. Steny są skalą o 10 kategoriach i tracą informację. Przydają się do opisu („31.3% badanych uzyskało wyniki niskie”), a nie do korelacji i testów.
W przykładzie przeliczyliśmy wyniki SSA na steny według umownych norm (M = 27, SD = 5). W grupie normalizacyjnej o rozkładzie normalnym wyniki niskie (steny 1–3) i wysokie (8–10) powinna mieć po 15.9% osób, a przeciętne (4–7) – 68.3%. W naszej próbie wyniki niskie miało 31.3% studentów, przeciętne – 52.7%, wysokie – 16.0%. Rozkład różnił się od normatywnego, χ²(2) = 27.97, p < .001. Rysunek 1 pokazuje to szczegółowo.
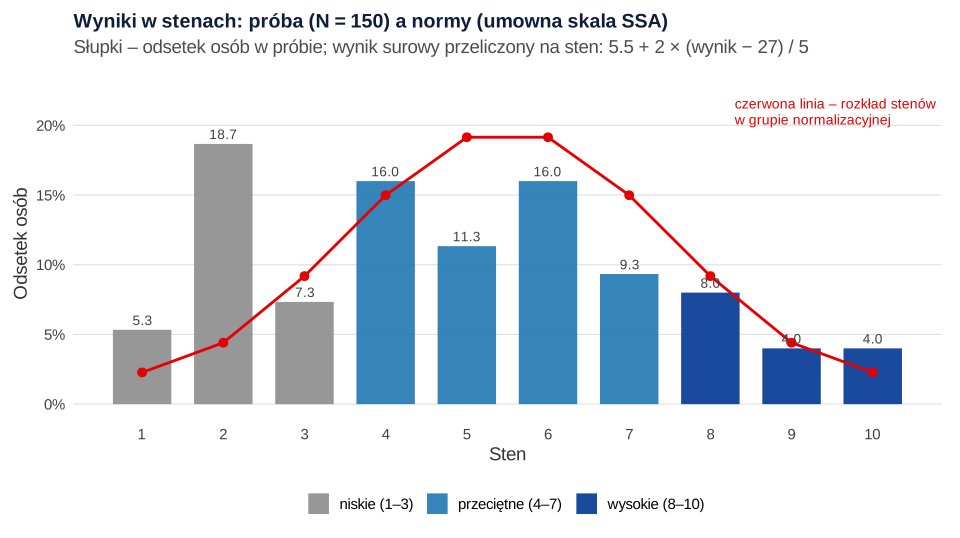
Jak to opisać? Ostrożnie. Różnica może oznaczać, że studenci mają niższą samoocenę akademicką niż populacja normalizacyjna, ale równie dobrze – że normy są nieaktualne, dotyczą innej grupy albo że Twoja próba nie jest reprezentatywna (np. ankietę częściej wypełniały osoby w trudniejszej sytuacji). Zauważ też nierówne słupki: na jeden sten przypadają dwa albo trzy wyniki surowe, więc przy krótkiej skali rozkład stenów bywa „schodkowy”. To kolejny powód, by analizy liczyć na wynikach surowych. Więcej o skalach standaryzowanych piszemy w hasłach skala stenowa i skala tenowa.
Korelacja i wielkość efektu w psychologii
Wynik SSA korelował ze średnią ocen: r(148) = .23, 95% CI [.07, .37], p = .005. Czy to dużo? Według popularnych progów Cohena byłby to efekt „mały”. Funder i Ozer (2019) proponują jednak ocenę na tle tego, co realnie obserwuje się w psychologii, i konsekwencji praktycznych. W ich ujęciu rzetelnie oszacowane r = .20 to efekt średni, użyteczny już w krótkim okresie, r = .30 – duży, a r ≥ .40 w badaniach psychologicznych to najpewniej przeszacowanie, które rzadko się replikuje. Za mylące uznają też podnoszenie r do kwadratu, czyli opis w rodzaju „samoocena wyjaśnia tylko kilka procent wariancji ocen”.
Nasz przedział ufności [.07, .37] obejmuje jednak zarówno efekty bardzo małe, jak i duże. To typowa sytuacja przy 150 osobach i powód, by zawsze podawać przedział, a nie tylko p. Szerzej o interpretacji miar efektu piszemy w poradniku wielkość efektu – jak ocenić znaczenie wyniku.
Moderacja i mediacja: kiedy po nie sięgać w pracy z psychologii
Psychologia rzadko pyta tylko „czy X wiąże się z Y”. Częściej pyta „dla kogo” i „dlaczego”. Pierwsze pytanie prowadzi do moderacji: związek zależy od trzeciej zmiennej, np. stres silniej wiąże się z wypaleniem u osób z małym wsparciem. Drugie prowadzi do mediacji: związek przebiega przez zmienną pośredniczącą, np. stres wiąże się z wypaleniem częściowo przez ruminację. To różne hipotezy i różne modele – zanim wybierzesz analizę, nazwij, o które pytanie chodzi.
Trzy zasady, które oszczędzają nerwów na obronie:
- Hipoteza musi wynikać z teorii. Moderator lub mediator dobierasz na podstawie literatury, a nie dlatego, że „wyszło istotnie”. Testowanie po kolei wszystkich zmiennych z ankiety jako moderatorów to prosta droga do przypadkowych wyników.
- Mediacja w badaniu jednorazowym nie pokazuje procesu w czasie. Jeśli wszystkie zmienne mierzysz jednym kwestionariuszem w jednym momencie, wynik jest „zgodny z mediacją”, ale nie dowodzi, że X wpływa na M, a M na Y. Dochodzi do tego wspólna wariancja metody, która może zawyżać związki między skalami samoopisowymi.
- Efekt pośredni testuj bezpośrednio. Zamiast sekwencji kroków sprawdzaj przedział ufności efektu pośredniego, najczęściej metodą bootstrap. Hayes i Rockwood (2017) pokazują, jak wykonać mediację, moderację i ich połączenie w ramach jednej regresji.
Kompletny przykład obu analiz – z centrowaniem, efektami prostymi, przedziałem Johnsona–Neymana, bootstrapem i gotowymi zdaniami APA – znajdziesz w poradniku o statystyce w pracy magisterskiej, do którego prowadzi tabela projektów powyżej.
Eksperyment: sprawdzenie manipulacji i porównanie warunków
W drugim przykładzie 84 osoby losowo przydzielono do dwóch warunków: po wykonaniu zadania otrzymywały negatywną albo neutralną informację zwrotną, a następnie oceniały swój stan lęku (0–100). To klasyczny schemat eksperymentalny: dzięki randomizacji różnicę między grupami można przypisać manipulacji.
Najpierw sprawdzenie manipulacji. Osoby w warunku negatywnym oceniały otrzymaną informację jako bardziej negatywną (M = 5.02, SD = 1.26) niż osoby w warunku neutralnym (M = 2.76, SD = 1.14), t(81.25) = 8.62, p < .001. Manipulacja zadziałała. Kusi, by wykluczyć osoby, u których „nie zadziałała”, ale Aronow i in. (2019) pokazują, że wykluczanie uczestników na podstawie sprawdzenia manipulacji po przydziale do warunku może poważnie obciążyć oszacowanie efektu. Analizuj wszystkich przydzielonych.
Potem hipoteza główna. Stan lęku był wyższy po negatywnej informacji zwrotnej (M = 51.43, SD = 13.11) niż po neutralnej (M = 39.17, SD = 14.58). Test t Welcha – zalecany jako domyślny, bo nie zakłada równych wariancji (Delacre i in., 2017) – dał t(81.09) = 4.05, p < .001. Różnica wyniosła 12.26 punktu, 95% CI [6.24, 18.28], a g Hedgesa = 0.88, 95% CI [0.43, 1.32].
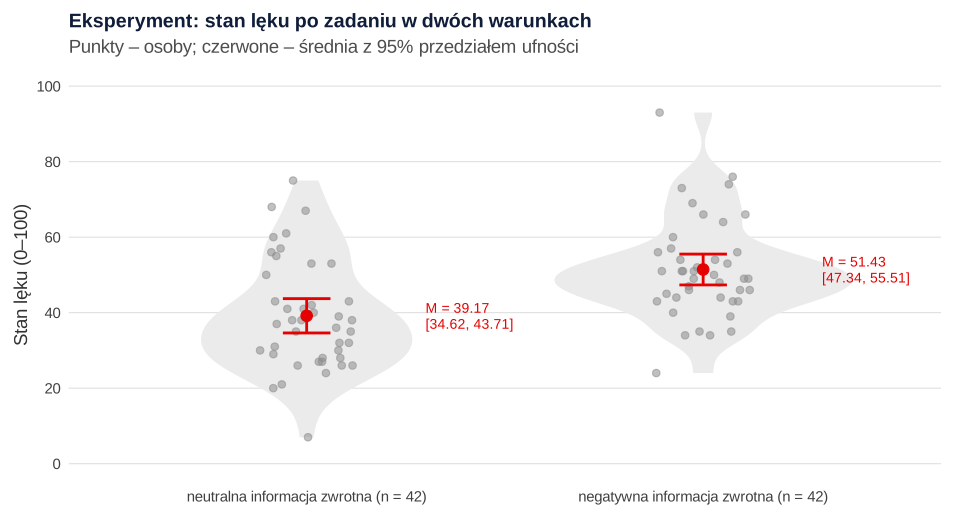
Efekt jest duży, ale przedział ufności dla g sięga od 0.43 do 1.32 – przy 42 osobach w grupie precyzja jest ograniczona. Pamiętaj też o etyce: manipulacja negatywną informacją zwrotną wymaga zgody komisji etycznej i rzetelnego debriefingu po badaniu. Gdy w eksperymencie masz pomiar przed i po albo kowariant, rozważ ANCOVA – opisujemy ją w poradniku ANCOVA w badaniu przed i po.
Raport w stylu APA: co napisać o narzędziach i wynikach
Standardy raportowania APA dla badań ilościowych (JARS-Quant) dzielą hipotezy i analizy na pierwszorzędowe, drugorzędowe i eksploracyjne oraz przewidują moduły dla różnych schematów badań (Appelbaum i in., 2018). W pracy dyplomowej z psychologii przekłada się to na kilka konkretów. W opisie każdego narzędzia podaj: nazwę i autorów (także polskiej adaptacji), co mierzy, liczbę pozycji i skalę odpowiedzi, przykładową pozycję (jeśli licencja na to pozwala), sposób liczenia wyniku i rzetelność w Twojej próbie. Gdzie szukać narzędzi i jak uzyskać zgodę na ich użycie, piszemy w poradniku gdzie znaleźć kwestionariusze psychologiczne.
Ogólne zasady zapisu statystyk znajdziesz w poradniku jak opisać wyniki w stylu APA, a wzory tabel – w tekście tabele APA w pracy z psychologii. W opisie norm zastąp słowa „według norm dla studentów podanych w podręczniku” dokładnym odwołaniem do podręcznika Twojego narzędzia.
Błędy typowe dla prac z psychologii
- Wynik skali policzony bez klucza – pozycje odwrócone pozostawione bez zmiany albo suma zamiast średniej, gdy normy dotyczą średniej (lub odwrotnie).
- Usuwanie pozycji „dla lepszej alfy” w opublikowanym narzędziu, bez informacji w tekście.
- Normy z niewłaściwej grupy – np. normy dla dorosłych zastosowane do nastolatków, bez wzmianki, z których norm korzystano.
- Korelacje i testy liczone na stenach zamiast na wynikach surowych.
- Interpretacja r = .23 jako „związku słabego, bez znaczenia” wyłącznie na podstawie progów Cohena.
- Brak sprawdzenia manipulacji w eksperymencie albo wykluczanie osób, u których manipulacja „nie zadziałała”.
- Pytania kwestionariusza w aneksie bez zgody właściciela praw do narzędzia.
- Diagnozy w pracy dyplomowej – opis „30% badanych ma niską samoocenę” jest dopuszczalny, ale wynik przesiewowego kwestionariusza to nie diagnoza kliniczna.
Konsultacja analizy w pracy z psychologii
Jeśli Twoja praca łączy kilka kwestionariuszy, normy i model z interakcją albo efektem pośrednim, warto skonsultować plan analiz, zanim zbierzesz dane. W ramach oferty analiz statystycznych dla studentów przeliczamy skale według kluczy, oceniamy rzetelność, wykonujemy analizy hipotez i wyjaśniamy wyniki tak, abyś umiał(a) je samodzielnie opisać i obronić. Autorem lub autorką pracy pozostajesz Ty: musisz rozumieć każdy wynik i ujawnić pomoc zgodnie z zasadami uczelni.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu i rysunków. Pobierz plik statystyka-dla-psychologa-dane.xlsx, zapisz go w katalogu roboczym R i uruchom przepisy 2 i 3. Przepis 1 pokazuje, jak powstały dane (nie musisz go uruchamiać).
1. Dane symulowane: kwestionariusz i eksperyment
R
# P30 – dane symulowane do dwóch przykładów z pracy z psychologii. Tworzy plik XLSX do pobrania.
# Arkusz Kwestionariusz: 150 studentów, fikcyjna Skala Samooceny Akademickiej (SSA, 10 pozycji 1–4;
#   pozycje 3, 5, 8 i 10 sformułowane negatywnie, zapisane tak, jak odpowiadano) + średnia ocen.
# Arkusz Eksperyment: 84 osoby losowo przydzielone do negatywnej albo neutralnej informacji zwrotnej;
#   sprawdzenie manipulacji (1–7) i stan lęku po zadaniu (0–100).
library(writexl)
set.seed(3010)
N <- 150
samoocena <- rnorm(N)
lad <- c(.70, .66, .62, .72, .58, .68, .22, .64, .70, .60)       # pozycja 7 słabo mierzy samoocenę
odwrocone <- c(3, 5, 8, 10)
odp <- sapply(seq_along(lad), function(j) {
  x <- lad[j] * samoocena + rnorm(N, sd = sqrt(1 - lad[j]^2))
  k <- as.integer(cut(x, breaks = c(-Inf, -1.0, 0.0, 0.95, Inf)))  # odpowiedzi 1–4
  if (j %in% odwrocone) 5L - k else k                               # zapis „surowy”, przed odwróceniem
})
colnames(odp) <- paste0("SSA", 1:10)
srednia_ocen <- round(pmin(pmax(4.0 + 0.30 * (0.27 * samoocena + rnorm(N, sd = sqrt(1 - 0.27^2))) / 1, 3.0), 5.0), 2)
kwest <- data.frame(id = 1:N, plec = sample(c("K", "M"), N, TRUE, c(.75, .25)), odp, srednia_ocen)

n_g <- 42
grupa <- rep(c("neutralna", "negatywna"), each = n_g)
manipulacja <- pmin(pmax(round(rnorm(2 * n_g, mean = ifelse(grupa == "negatywna", 5.1, 3.0), sd = 1.2)), 1), 7)
lek <- round(pmin(pmax(rnorm(2 * n_g, mean = ifelse(grupa == "negatywna", 48, 41), sd = ifelse(grupa == "negatywna", 16, 14)), 0), 100))
eksp <- data.frame(id = 1:(2 * n_g), grupa, manipulacja, lek)
write_xlsx(list(Kwestionariusz = kwest, Eksperyment = eksp,
                Instrukcja = data.frame(Opis = c(
                  "Dane symulowane do wpisu metodolog.pl: Statystyka dla psychologa – analizy w pracy dyplomowej z psychologii.",
                  "Skala Samooceny Akademickiej (SSA) jest narzędziem fikcyjnym; normy w przykładzie są umowne.",
                  "Kwestionariusz: SSA1–SSA10 (1 = zdecydowanie nie, 4 = zdecydowanie tak); pozycje 3, 5, 8, 10 trzeba odwrócić (5 − odpowiedź).",
                  "Eksperyment: grupa (neutralna/negatywna informacja zwrotna), manipulacja (1–7: jak negatywna była informacja), lek (0–100)."))),
           "statystyka-dla-psychologa-dane.xlsx")
sapply(readxl::excel_sheets("statystyka-dla-psychologa-dane.xlsx"),
       function(s) dim(readxl::read_excel("statystyka-dla-psychologa-dane.xlsx", sheet = s)))
Wynik w R
     Kwestionariusz Eksperyment Instrukcja
[1,]            150          84          4
[2,]             13           4          1
2. Kwestionariusz: pozycje odwrócone, alfa i omega, steny, korelacja
R
# P30 – przykład 1: od odpowiedzi na pozycje do wyniku skali, rzetelności, stenów i korelacji
library(readxl)   # read_excel()
library(psych)    # alpha(): alfa Cronbacha i analiza pozycji
library(lavaan)   # cfa(): model jednoczynnikowy do omegi

kw <- read_excel("statystyka-dla-psychologa-dane.xlsx", sheet = "Kwestionariusz")

# 1. Odwrócenie pozycji sformułowanych negatywnie (skala 1–4: nowa = 5 − stara)
odwrocone <- c("SSA3", "SSA5", "SSA8", "SSA10")
kw[odwrocone] <- 5 - kw[odwrocone]
poz <- kw[paste0("SSA", 1:10)]

# 2. Rzetelność: alfa Cronbacha, korelacje pozycja–reszta skali, alfa po usunięciu pozycji
a <- alpha(as.data.frame(poz))
round(a$total$raw_alpha, 2)
round(data.frame(r_poz_reszta = a$item.stats$r.drop, alfa_bez_pozycji = a$alpha.drop$raw_alpha,
                 row.names = names(poz)), 2)

# 3. Omega (model jednoczynnikowy): (suma ładunków)² / [(suma ładunków)² + suma wariancji błędów]
model <- paste("SSA =~", paste(names(poz), collapse = " + "))
fit <- cfa(model, data = kw, std.lv = TRUE)
ss <- standardizedSolution(fit)
l <- ss$est.std[ss$op == "=~"]
round(c(omega = sum(l)^2 / (sum(l)^2 + sum(1 - l^2)), lad_min = min(l), lad_max = max(l),
        lad_SSA7 = l[7]), 2)

# 4. Wynik surowy (suma 10–40) i przeliczenie na steny według umownych norm (M = 27, SD = 5)
kw$ssa_suma <- rowSums(poz)
round(c(M = mean(kw$ssa_suma), SD = sd(kw$ssa_suma), min = min(kw$ssa_suma), max = max(kw$ssa_suma)), 2)
norma_M <- 27; norma_SD <- 5
kw$sten <- pmin(pmax(round(5.5 + 2 * (kw$ssa_suma - norma_M) / norma_SD), 1), 10)
table(factor(kw$sten, levels = 1:10))
kat <- cut(kw$sten, c(0, 3, 7, 10), labels = c("niskie (1–3)", "przeciętne (4–7)", "wysokie (8–10)"))
oczekiwane <- c(pnorm(-1), pnorm(1) - pnorm(-1), 1 - pnorm(1))     # rozkład stenów w populacji normalizacyjnej
round(100 * cbind(proba = as.vector(prop.table(table(kat))), norma = oczekiwane), 1)
chisq.test(table(kat), p = oczekiwane)

# 5. Samoocena a średnia ocen: korelacja Pearsona z 95% CI
r <- cor.test(kw$ssa_suma, kw$srednia_ocen)
round(c(r = unname(r$estimate), df = unname(r$parameter), p = r$p.value, CI_dolna = r$conf.int[1], CI_gorna = r$conf.int[2]), 3)
round(c(r = unname(r$estimate), CI_dolna = r$conf.int[1], CI_gorna = r$conf.int[2]), 2)   # do zapisu APA (dwa miejsca)
Wynik w R
[1] 0.83
      r_poz_reszta alfa_bez_pozycji
SSA1          0.62             0.80
SSA2          0.48             0.82
SSA3          0.51             0.81
SSA4          0.66             0.80
SSA5          0.52             0.81
SSA6          0.66             0.80
SSA7          0.20             0.84
SSA8          0.43             0.82
SSA9          0.62             0.80
SSA10         0.50             0.82
   omega  lad_min  lad_max lad_SSA7
    0.84     0.24     0.73     0.24
    M    SD   min   max
25.15  6.06 11.00 38.00

 1  2  3  4  5  6  7  8  9 10
 8 28 11 24 17 24 14 12  6  6
     proba norma
[1,]  31.3  15.9
[2,]  52.7  68.3
[3,]  16.0  15.9

	Chi-squared test for given probabilities

data:  table(kat)
X-squared = 27.97, df = 2, p-value = 8.439e-07

       r       df        p CI_dolna CI_gorna
   0.228  148.000    0.005    0.071    0.375
       r CI_dolna CI_gorna
    0.23     0.07     0.37
3. Eksperyment: sprawdzenie manipulacji, test t Welcha i g Hedgesa
R
# P30 – przykład 2: eksperyment z dwiema grupami (negatywna a neutralna informacja zwrotna)
library(readxl)
library(effectsize)   # hedges_g(): g Hedgesa z 95% CI

ek <- read_excel("statystyka-dla-psychologa-dane.xlsx", sheet = "Eksperyment")
ek$grupa <- factor(ek$grupa, levels = c("negatywna", "neutralna"))

# 1. Sprawdzenie manipulacji: czy informację negatywną oceniano jako bardziej negatywną?
aggregate(manipulacja ~ grupa, data = ek, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
tm <- t.test(manipulacja ~ grupa, data = ek)
round(c(t = unname(tm$statistic), df = unname(tm$parameter), p = tm$p.value), 3)
round(c(t = unname(tm$statistic), df = unname(tm$parameter)), 2)          # do zapisu APA (dwa miejsca)

# 2. Główna hipoteza: stan lęku po zadaniu, test t Welcha i g Hedgesa
aggregate(lek ~ grupa, data = ek, FUN = function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
tl <- t.test(lek ~ grupa, data = ek)
round(c(t = unname(tl$statistic), df = unname(tl$parameter), p = tl$p.value,
        roznica = unname(diff(rev(tl$estimate))), CI_dolna = tl$conf.int[1], CI_gorna = tl$conf.int[2]), 3)
round(c(t = unname(tl$statistic), df = unname(tl$parameter), roznica = unname(diff(rev(tl$estimate))),
        CI_dolna = tl$conf.int[1], CI_gorna = tl$conf.int[2]), 2)              # do zapisu APA (dwa miejsca)
g <- hedges_g(lek ~ grupa, data = ek, pooled_sd = FALSE)
round(c(g = g$Hedges_g, CI_dolna = g$CI_low, CI_gorna = g$CI_high), 2)
Wynik w R
      grupa manipulacja.M manipulacja.SD
1 negatywna          5.02           1.26
2 neutralna          2.76           1.14
     t     df      p
 8.619 81.255  0.000
    t    df
 8.62 81.25
      grupa lek.n lek.M lek.SD
1 negatywna 42.00 51.43  13.11
2 neutralna 42.00 39.17  14.58
       t       df        p  roznica CI_dolna CI_gorna
   4.052   81.091    0.000   12.262    6.241   18.283
       t       df  roznica CI_dolna CI_gorna
    4.05    81.09    12.26     6.24    18.28
       g CI_dolna CI_gorna
    0.88     0.43     1.32
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- writexl (wersja 1.5.4): Ooms, J. (2025). writexl: Export data frames to Excel 'xlsx' format [R package]. https://doi.org/10.32614/CRAN.package.writexl
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Jakie analizy statystyczne są typowe dla pracy z psychologii?
Najczęściej korelacje i regresja w badaniach kwestionariuszowych, test t Welcha i ANOVA przy porównaniach grup i w eksperymentach, a w pracach magisterskich także moderacja, mediacja i konfirmacyjna analiza czynnikowa. Prawie zawsze dochodzą do tego wyniki skal liczone według klucza i rzetelność narzędzi w badanej próbie.
Czy w pracy z psychologii liczyć analizy na stenach czy na wynikach surowych?
Na wynikach surowych. Steny mają tylko 10 kategorii i tracą część informacji, a ich przeliczenie zależy od wybranych norm. Steny przydają się do opisu, np. jaki odsetek badanych ma wyniki niskie, przeciętne i wysokie w porównaniu z grupą normalizacyjną.
Czy można usunąć pozycję z kwestionariusza, żeby poprawić alfę Cronbacha?
W opublikowanym narzędziu raczej nie: zmieniasz wtedy narzędzie, a wyników nie da się porównać z normami ani innymi badaniami. Podaj analizę pozycji, omów słabą pozycję w ograniczeniach, a jeśli mimo to modyfikujesz skalę, napisz to wprost i pokaż wyniki dla obu wersji.
Co to jest sprawdzenie manipulacji w eksperymencie psychologicznym?
To pomiar, który pokazuje, czy manipulacja wywołała zamierzony stan – np. czy osoby z warunku negatywnej informacji zwrotnej rzeczywiście oceniły ją jako bardziej negatywną. Wynik sprawdzenia raportujesz przed hipotezą główną, ale nie wykluczasz na jego podstawie uczestników, bo może to obciążyć oszacowanie efektu.
Czy korelacja r = .20 w psychologii to słaby wynik?
Niekoniecznie. Według Fundera i Ozera (2019) rzetelnie oszacowana korelacja .20 to w psychologii efekt średni, użyteczny także praktycznie, a .30 – duży. Oceniaj efekt na tle wyników podobnych badań i jego konsekwencji oraz podawaj 95% przedział ufności.
Powiązane hasła
Przeczytaj też
Jak napisać pracę z psychologii
Od teorii i konstruktu przez hipotezy kierunkowe, narzędzia i mediację po wkład teoretyczny w dyskusji – na fikcyjnym przykładzie o wypaleniu.
Czytaj →PoradnikStatystyka dla psychologów
Co statystyka daje psychologii, gdzie ma granice i jak jej nie nadużywać: wartość p, moc, replikacje, braki danych, metody odporne i symulacja w R.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikGdzie znaleźć kwestionariusze psychologiczne
Polskie adaptacje, wydawca testów, bazy i IPIP; jak ocenić skalę, kiedy potrzebna jest zgoda autora, wzór e-maila i zasady tłumaczenia narzędzi.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →Piszesz pracę z psychologii z kilkoma kwestionariuszami?
Przeliczymy skale według kluczy, ocenimy rzetelność, wykonamy analizy hipotez i wyjaśnimy wyniki tak, abyś umiał(a) je samodzielnie opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Aronow, P. M., Baron, J., & Pinson, L. (2019). A note on dropping experimental subjects who fail a manipulation check. Political Analysis, 27(4), 572–589. https://doi.org/10.1017/pan.2019.5
- Clark, L. A., & Watson, D. (1995). Constructing validity: Basic issues in objective scale development. Psychological Assessment, 7(3), 309–319. https://doi.org/10.1037/1040-3590.7.3.309
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Dunn, T. J., Baguley, T., & Brunsden, V. (2014). From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation. British Journal of Psychology, 105(3), 399–412. https://doi.org/10.1111/bjop.12046 ● Otwarty dostęp: pełny tekst
- Flake, J. K., & Fried, E. I. (2020). Measurement schmeasurement: Questionable measurement practices and how to avoid them. Advances in Methods and Practices in Psychological Science, 3(4), 456–465. https://doi.org/10.1177/2515245920952393 ● Otwarty dostęp: pełny tekst
- Funder, D. C., & Ozer, D. J. (2019). Evaluating effect size in psychological research: Sense and nonsense. Advances in Methods and Practices in Psychological Science, 2(2), 156–168. https://doi.org/10.1177/2515245919847202 ● Otwarty dostęp
- Hayes, A. F., & Rockwood, N. J. (2017). Regression-based statistical mediation and moderation analysis in clinical research: Observations, recommendations, and implementation. Behaviour Research and Therapy, 98, 39–57. https://doi.org/10.1016/j.brat.2016.11.001
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{aronow2019note, author={Aronow, Peter M. and Baron, Jonathon and Pinson, Lauren}, title={{A note on dropping experimental subjects who fail a manipulation check}}, journal={Political Analysis}, year={2019}, volume={27}, number={4}, pages={572--589}, doi={10.1017/pan.2019.5}}@article{clark1995constructing, author={Clark, Lee Anna and Watson, David}, title={{Constructing validity: Basic issues in objective scale development}}, journal={Psychological Assessment}, year={1995}, volume={7}, number={3}, pages={309--319}, doi={10.1037/1040-3590.7.3.309}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{dunn2014alpha, author={Dunn, Thomas J. and Baguley, Thom and Brunsden, Vivienne}, title={{From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation}}, journal={British Journal of Psychology}, year={2014}, volume={105}, number={3}, pages={399--412}, doi={10.1111/bjop.12046}}@article{flake2020measurement, author={Flake, Jessica Kay and Fried, Eiko I.}, title={{Measurement schmeasurement: Questionable measurement practices and how to avoid them}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={456--465}, doi={10.1177/2515245920952393}}@article{funder2019evaluating, author={Funder, David C. and Ozer, Daniel J.}, title={{Evaluating effect size in psychological research: Sense and nonsense}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={2}, pages={156--168}, doi={10.1177/2515245919847202}}@article{hayes2017regression, author={Hayes, Andrew F. and Rockwood, Nicholas J.}, title={{Regression-based statistical mediation and moderation analysis in clinical research: Observations, recommendations, and implementation}}, journal={Behaviour Research and Therapy}, year={2017}, volume={98}, pages={39--57}, doi={10.1016/j.brat.2016.11.001}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}