Statystyka w pracy z fizjoterapii: trzy pytania, na które musisz odpowiedzieć
Typowa praca z fizjoterapii ocenia terapię albo program ćwiczeń: mierzysz ból, zakres ruchu lub wynik testu funkcjonalnego przed terapią i po niej, a potem sprawdzasz, czy coś się zmieniło. Kusi, żeby policzyć test t, zobaczyć p < .05 i napisać „terapia okazała się skuteczna”. Promotor albo recenzent zapyta jednak o trzy rzeczy:
- Czy zmiana jest większa niż błąd pomiaru? Ten sam pacjent zmierzony dwukrotnie nie uzyska identycznego wyniku.
- Czy zmiana ma znaczenie dla pacjenta? Spadek bólu o pół punktu może być istotny statystycznie i zupełnie nieodczuwalny.
- Czy zmiana wynika z terapii? Ból przewlekły zmienia się także sam z siebie, część poprawy daje regresja do średniej, a część – efekty niespecyficzne, takie jak uwaga terapeuty czy oczekiwania pacjenta.
Ten poradnik pokazuje, jak odpowiedzieć na każde z tych pytań i jak dobrać analizę do schematu badania. Pracujemy na jednym przykładzie (dane symulowane). 60 osób z przewlekłym bólem krzyża, u których ból przy kwalifikacji wynosił co najmniej 4 punkty w skali NRS, losowo przydzielono do nowego programu ćwiczeń (grupa A) albo standardowej fizjoterapii (grupa B), po 30 osób. Ból mierzono przed terapią (T0), po 4 tygodniach (T1) i po 12 tygodniach (T2); w grupie A trzy osoby nie przyszły na ostatni pomiar. Osobno 30 osób zmierzyło dwóch fizjoterapeutów, by ocenić rzetelność pomiaru zakresu ruchu. Liczby nie mówią nic o skuteczności jakiejkolwiek terapii – służą wyłącznie do pokazania analizy, a wszystkie pochodzą z kodu z sekcji Przykład w R.
Plik do pobrania: statystyka-dla-fizjoterapeuty-dane-przyklad.xlsx – arkusze Badanie (60 osób, trzy pomiary bólu), Rzetelnosc_ROM (30 osób, dwóch badających) i Instrukcja (12 KB).
Trzy schematy badania i co z nich wynika
Zanim wybierzesz test, nazwij schemat badania. To on decyduje, jakie wnioski są w ogóle możliwe.
| Schemat | Przykład | Główna analiza | Na co uważać |
|---|---|---|---|
| Jedna grupa, pomiar przed i po | ból przed programem i po 4 tygodniach | test t dla prób zależnych albo test Wilcoxona, wielkość efektu, odsetek osób z poprawą ≥ MCID | brak grupy kontrolnej: naturalny przebieg, regresja do średniej, efekty niespecyficzne |
| Dwie grupy, pomiar przed i po | nowy program a standardowa fizjoterapia | ANCOVA z pomiarem wyjściowym jako kowariantem | dwa osobne testy przed–po zamiast porównania grup |
| Trzy pomiary lub więcej | przed, po 4 i po 12 tygodniach | ANOVA z powtarzanymi pomiarami, test Friedmana albo model mieszany | osoby bez kompletu pomiarów, sferyczność |
Badanie jednej grupy przed i po to schemat quasi-eksperymentalny o najsłabszej trafności wewnętrznej: pokazuje, że ból się zmienił, ale nie pokazuje dlaczego. Najmocniejsze wnioski daje schemat eksperymentalny z losowym przydziałem do grupy terapii i grupy porównawczej.
Co mierzysz: NRS, VAS, zakres ruchu, testy funkcjonalne i kwestionariusze
- Skala numeryczna NRS (0–10) – pacjent podaje liczbę całkowitą od 0 („brak bólu”) do 10 („najsilniejszy ból, jaki można sobie wyobrazić”). Formalnie to skala porządkowa, ale przy 11 punktach i analizie różnic u tych samych osób zwykle traktuje się ją jak skalę ilościową. Test Wilcoxona możesz wtedy podać jako analizę uzupełniającą.
- Skala wzrokowo-analogowa VAS – odcinek 100 mm; progi istotnej zmiany są inne niż dla NRS (o tym niżej).
- Zakres ruchu (goniometr, inklinometr) – wynik w stopniach, czyli skala ilościowa, ale silnie zależny od osoby mierzącej i sposobu ustawienia pacjenta. Dlatego potrzebujesz oceny rzetelności.
- Testy funkcjonalne – czas w sekundach, dystans w metrach, liczba powtórzeń. Przy powtarzaniu testu wynik może się poprawić także dzięki wprawie, a część testów ma efekt sufitu lub podłogi.
- Kwestionariusze niepełnosprawności, np. Oswestry Disability Index (ODI), kwestionariusz Rolanda–Morrisa, Neck Disability Index, DASH czy WOMAC. Używaj oficjalnej polskiej wersji, sprawdź licencję i nie kopiuj pytań do aneksu bez zgody właściciela praw – więcej w poradniku gdzie znaleźć kwestionariusze i jak uzyskać zgodę.
Jeśli w pracy jest też ankieta wiedzy pacjentów, jej punktację i analizę opisujemy osobno w poradniku ankieta wiedzy – analiza krok po kroku.
Rzetelność pomiaru: ICC, SEM i minimalna wykrywalna zmiana
Zanim uznasz zmianę za poprawę, sprawdź, jak duży jest błąd samego pomiaru. Standardowym narzędziem jest współczynnik korelacji wewnątrzklasowej (ICC). Istnieje kilka jego form, dlatego Koo i Li (2016) wymagają, by w pracy podać model, typ i definicję ICC, a wynik interpretować na podstawie 95% przedziału ufności: poniżej .50 – rzetelność słaba, .50–.75 – umiarkowana, .75–.90 – dobra, powyżej .90 – doskonała. Weir (2005) zwraca uwagę na najważniejszą różnicę: ICC(2,1) uwzględnia błąd systematyczny, a ICC(3,1) go pomija.
W przykładzie dwóch fizjoterapeutów zmierzyło zakres zgięcia tułowia u 30 osób. Drugi z nich mierzył systematycznie szerzej – średnio o 2.60°, 95% CI [1.25, 3.95], p < .001. Dlatego zgodność bezwzględna, ICC(2,1) = .95, 95% CI [.82, .98], była nieco niższa niż spójność, ICC(3,1) = .97, 95% CI [.93, .98]. Jeśli pomiary przed i po terapii mogą wykonywać różne osoby, raportuj ICC(2,1). Przedział od .82 do .98 oznacza rzetelność od dobrej do doskonałej.
ICC opisuje rzetelność w grupie, ale nie mówi, o ile może się „przesunąć” wynik jednego pacjenta. Do tego służy standardowy błąd pomiaru (SEM). Weir (2005) pokazuje, jak z niego wyznaczyć najmniejszą zmianę, przy której można uznać, że u danej osoby zaszła rzeczywista zmiana – minimalną wykrywalną zmianę (MDC):
MDC95 = 1.96 × √2 × SEM
W przykładzie SD wszystkich pomiarów wyniosło 13.94°, więc SEM = 3.07°, a MDC95 = 8.51°. Jeśli zakres ruchu pacjenta zmienił się o mniej niż około 8.5°, nie odróżnisz tej zmiany od błędu pomiaru, gdy mierzą różne osoby. Gdy ten sam fizjoterapeuta mierzy dwukrotnie, policz rzetelność test–retest w ten sam sposób. Pamiętaj też, że MDC i MCID to różne progi: pierwszy wynika z precyzji narzędzia, drugi – z oceny pacjentów.
Jedna grupa przed i po: test t dla prób zależnych czy test Wilcoxona?
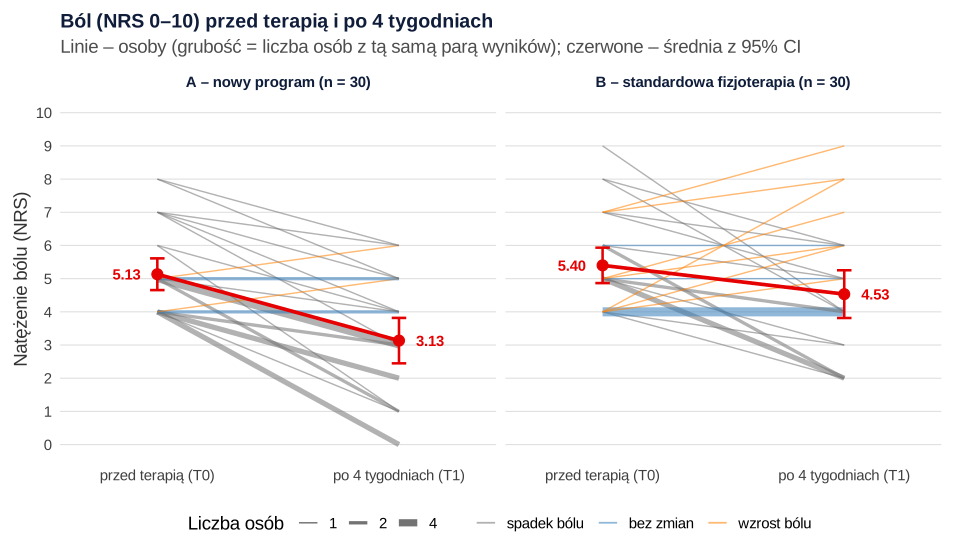
W grupie A średni ból wynosił przed terapią M = 5.13 (SD = 1.28), a po 4 tygodniach M = 3.13 (SD = 1.83). Analiza dotyczy jednak różnic u tych samych osób, a nie dwóch średnich. Różnica „po − przed” wyniosła średnio −2.00 punktu (SD = 1.60, mediana −2). U 24 osób ból się zmniejszył, u 4 się nie zmienił, a u 2 wzrósł o 1 punkt. Rysunek 1 pokazuje każdą osobę osobno.
Test t dla prób zależnych to w istocie test t dla jednej próby wykonany na różnicach. Dlatego założenie normalności dotyczy różnic, a nie surowych wyników. Test Shapiro–Wilka nie wykazał odchylenia od normalności (W = 0.94, p = .090), ale przy małej próbie ważniejszy jest wykres – zob. jak sprawdzić normalność rozkładu. Wynik: t(29) = −6.86, p < .001, średnia zmiana −2.00 punktu, 95% CI [−2.60, −1.40].
Do wyniku testu dołącz wielkość efektu. Dla prób zależnych istnieje kilka wersji d Cohena, a Lakens (2013) omawia, czym różnią się miary wielkości efektu w schematach wewnątrzosobowych i międzyosobowych. Najczęściej podaje się:
- dz = średnia różnica / SD różnic = −1.25;
- dav = średnia różnica / średnie SD obu pomiarów = −1.29.
dz rośnie wraz z korelacją między pomiarami, więc nie porównuj go z d z badań dwóch niezależnych grup. Zawsze napisz, którą wersję liczysz.
Test Wilcoxona dla par (test znakowanych rang) nie zakłada normalności różnic. W przykładzie: V = 7, z = −4.32, p < .001. V to suma rang różnic dodatnich, czyli tutaj wzrostów bólu. R domyślnie pomija 4 osoby bez zmiany, a inne programy mogą traktować zera inaczej, więc podaj ich liczbę. Wielkość efektu to korelacja rangowo-dwuseryjna, rrb = −.96: Kerby (2014) liczy ją jako różnicę między sumą rang zmian w jedną i w drugą stronę, podzieloną przez sumę wszystkich rang. Wartość bliska −1 oznacza, że prawie wszystkie niezerowe zmiany to spadki bólu. Oba testy prowadzą tu do tego samego wniosku. Wybierz jeden przed analizą – Wilcoxona zwłaszcza wtedy, gdy różnice są wyraźnie skośne albo próba jest bardzo mała.
MCID: czy poprawa ma znaczenie dla pacjenta?
Minimalna klinicznie istotna różnica (MCID, ang. minimal clinically important difference) to najmniejsza zmiana wyniku, którą pacjenci uznają za odczuwalną poprawę. Jaeschke i in. (1989) zaproponowali, by MCID wyznaczać przez porównanie zmian wyniku kwestionariusza z globalną oceną zmiany dokonaną przez samych pacjentów. Dla bólu mierzonego skalą NRS Farrar i in. (2001) na danych 2724 osób z 10 badań bólu przewlekłego stwierdzili, że klinicznie istotnej poprawie odpowiadał spadek o około 2 punkty albo o około 30%. Ostelo i in. (2008) zaproponowali dla bólu krzyża progi 2 punktów dla NRS, 15 punktów dla VAS (0–100), 5 punktów dla kwestionariusza Rolanda–Morrisa i 10 punktów dla ODI, a przy uwzględnieniu wyniku wyjściowego – poprawę o 30%. Autorzy zastrzegają, że to punkt wyjścia, a nie ostateczna odpowiedź. MCID nie jest jedną liczbą dla wszystkich: zależy od populacji, metody wyznaczania i bólu wyjściowego, dlatego w pracy podaj, skąd wziął się Twój próg.
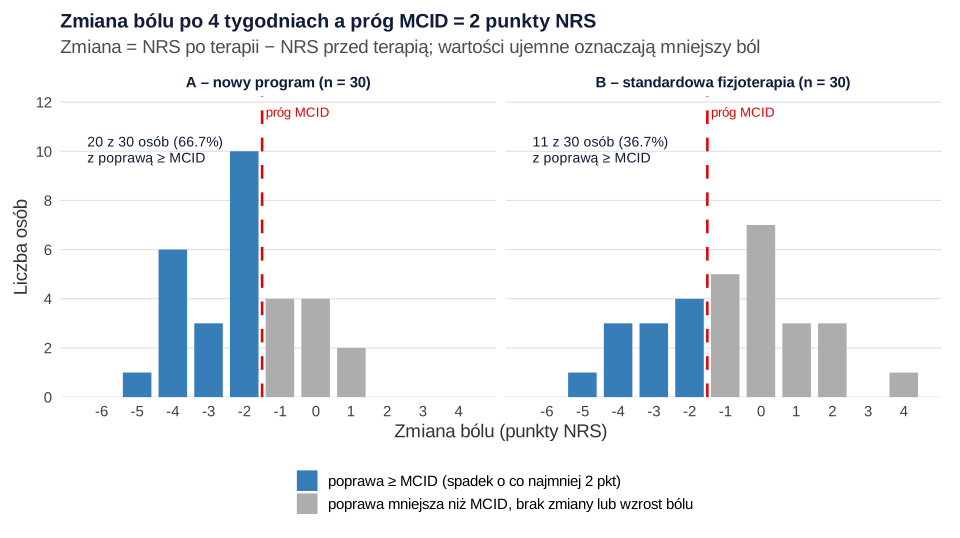
W grupie A ból zmniejszył się o co najmniej 2 punkty u 20 z 30 osób – 66.7%, 95% CI [48.8, 80.8] – a o co najmniej 30% u 60.0% osób. Szeroki przedział to skutek małej próby. Zauważ też, że średnia zmiana równa MCID nie oznacza, że „typowy pacjent” poprawił się w sposób istotny klinicznie – zmiany wahały się od −5 do +1 punktu. Rysunek 2 pokazuje rozkład zmian w obu grupach na tle progu.
Odsetek osób z poprawą ≥ MCID przemawia do klinicystów, ale nie zastąpi analizy wyniku ciągłego. Snapinn i Jiang (2007) pokazują, że dzielenie pacjentów na „reagujących” i „niereagujących” może znacznie obniżać efektywność statystyczną i nie dowodzi klinicznej istotności efektu. Zalecają osobno ocenić istotność statystyczną (na wyniku ciągłym), a osobno – znaczenie kliniczne. W pracy podaj więc obie informacje: średnią zmianę z 95% CI i odsetek osób z poprawą ≥ MCID.
Regresja do średniej: poprawa, której nie było
Regresja do średniej sprawia, że naturalna zmienność powtarzanych pomiarów wygląda jak rzeczywista zmiana: po nietypowo wysokim wyniku zwykle przychodzi wynik bliższy średniej. Barnett i in. (2005) podkreślają, że efekt jest tym silniejszy, im większy błąd pomiaru, i że szczególnie wyraźnie widać go wtedy, gdy kolejne pomiary analizuje się tylko u osób wybranych na podstawie wartości wyjściowej. A tak właśnie rekrutuje się pacjentów: do badania trafia ktoś, kogo „teraz bardzo boli”.
Symulacja w przepisie 5 pokazuje skalę zjawiska. 100 000 osób zmierzono dwa razy w odstępie czterech tygodni, bez żadnej terapii. Średnia zmiana w całej grupie wyniosła 0.00 punktu. Gdy jednak „do badania” zakwalifikowano tylko osoby z bólem co najmniej 6 punktów w pierwszym pomiarze (30.2% wszystkich), ich średni ból spadł z 6.77 do 5.87 punktu, czyli o 0.90. Aż 34.9% z nich „poprawiło się” o co najmniej 2 punkty, czyli o wartość MCID. W naszym badaniu warunkiem udziału był ból co najmniej 4 punkty, więc część spadku bólu w obu grupach może wynikać z tego samego mechanizmu.
Co z tym zrobić? Pomaga grupa kontrolna z tym samym kryterium kwalifikacji – w niej również pojawi się regresja do średniej, więc porównanie grup ją znosi. Pomaga też analiza z pomiarem wyjściowym jako kowariantem; według Vickersa i Altmana (2001) analiza wskaźników zmiany nie kontroluje nierównowagi wyjściowej właśnie z powodu regresji do średniej. Możesz też kwalifikować pacjentów na podstawie jednego pomiaru, a jako wartość wyjściową przyjąć kolejny albo średnią z dwóch pomiarów – losowe wahania się wtedy częściowo znoszą.
Mała próba i brak grupy kontrolnej – co możesz napisać
Badanie jednej grupy przed i po pokazuje, że ból się zmienił. Nie pokazuje, ile tej zmiany przypada na terapię, a ile na naturalny przebieg dolegliwości, regresję do średniej, efekty niespecyficzne, inne leczenie w tym samym czasie czy wprawę w wykonywaniu testu. W grupie standardowej fizjoterapii ból również się zmniejszył – średnio o 0.87 punktu – a 36.7% osób osiągnęło poprawę ≥ MCID. Bez tej grupy cały wynik grupy A (66.7%) przypisalibyśmy nowemu programowi.
Planując liczebność, policz moc testu przed zebraniem danych. Przy założeniu, że średnia zmiana wyniesie 1 punkt, a SD zmian – 2 punkty (dz = 0.5), test t dla prób zależnych osiąga moc .80 przy 34 osobach. Porównanie takiej zmiany między dwiema grupami wymaga już 64 osób w każdej grupie, gdy analizujesz same zmiany. Uwzględnienie pomiaru wyjściowego w ANCOVA zwiększa moc w badaniach z losowym przydziałem (Van Breukelen, 2006). Szerzej piszemy o tym w poradniku dobór liczebności próby.
Ograniczenia opisz konkretnie, a nie formułką „badanie miało ograniczenia”:
Dwie grupy z pomiarem przed i po: ANCOVA z pomiarem wyjściowym
Gdy masz grupę porównawczą, pytanie badawcze brzmi: czy po terapii ból w grupie A był niższy niż w grupie B u osób, które zaczynały z takim samym bólem? Na tych samych danych można policzyć trzy analizy i każda da inną odpowiedź:
| Analiza | Różnica A − B [95% CI] | Test | p |
|---|---|---|---|
| Porównanie samego pomiaru po terapii | −1.40 [−2.37, −0.43] | t(58) = −2.88 | .005 |
| Porównanie zmian (po − przed) | −1.13 [−2.10, −0.17] | t(58) = −2.34 | .023 |
| ANCOVA z bólem przed terapią jako kowariantem | −1.26 [−2.18, −0.35] | t(57) = −2.76 | .008 |
Skąd te różnice? Grupa B zaczynała z nieco wyższym bólem (M = 5.40 wobec 5.13 w grupie A). Porównanie samego pomiaru końcowego tę różnicę przenosi na wynik, a porównanie zmian ją „przekorygowuje”, bo zakłada, że ból po terapii zmienia się punkt w punkt z bólem wyjściowym. Tymczasem nachylenie dla pomiaru wyjściowego wyniosło w ANCOVA tylko 0.51, a korelacja pomiaru przed i po – r = .38.
Wybierz ANCOVA przed zobaczeniem wyników. Vickers i Altman (2001) nazywają ją preferowanym ogólnym podejściem: ma zwykle większą moc niż pozostałe analizy i daje tę samą odpowiedź niezależnie od przypadkowej nierównowagi wyjściowej. Wybieranie tej analizy, która dała najmniejsze p, nazywają błędem. Clifton i Clifton (2019) dodają, że analiza zmian nie rozwiązuje problemu regresji do średniej ani nierównowagi wyjściowej, a pomiar wyjściowy trzeba uwzględnić w ANCOVA niezależnie od tego, czy zmienną zależną jest zmiana, czy wynik końcowy. Van Breukelen (2006) pokazał, że w badaniach z losowym przydziałem obie metody są nieobciążone, ale ANCOVA ma większą moc. W badaniach bez losowego przydziału, gdy grupy różnią się już na starcie, metody mogą dawać sprzeczne wyniki, bo ANCOVA zakłada brak różnic wyjściowych. Wtedy żadna analiza nie zastąpi ostrożnej interpretacji.
W przykładzie założenie jednorodności nachyleń było spełnione (interakcja grupa × ból wyjściowy: F(1, 56) = 1.60, p = .211). Średnie skorygowane wyniosły 3.20 punktu w grupie A, 95% CI [2.55, 3.85], i 4.47 w grupie B, 95% CI [3.82, 5.11]. Różnica −1.26 punktu jest istotna, p = .008, a cząstkowe η² = .12.
A ANOVA mieszana 2 (grupa) × 2 (pomiar)? Jej interakcja grupa × pomiar, F(1, 58) = 5.49, p = .023, to dokładnie ten sam test co test t na zmianach: 2.34² = 5.49. To więc nie trzecia metoda, tylko analiza zmian w innym zapisie. Najczęstszy błąd to jednak co innego: dwa osobne testy przed–po, w każdej grupie z osobna. Wynik „istotny w grupie A, nieistotny w grupie B” nie dowodzi, że grupy się różnią – do tego potrzebny jest bezpośredni test różnicy między grupami.
Odsetki osób z poprawą ≥ MCID też porównuj bezpośrednio: 66.7% w grupie A i 36.7% w grupie B to różnica 30.0 punktu procentowego, 95% CI [4.8, 50.4], dokładny test Fishera p = .038.
Trzy pomiary: ANOVA z powtarzanymi pomiarami, test Friedmana albo model mieszany
W grupie A ból zmierzono jeszcze raz po 12 tygodniach. Średnie wyniosły: przed terapią 5.13 (SD = 1.28), po 4 tygodniach 3.13 (SD = 1.83), po 12 tygodniach 3.33 (SD = 1.88; n = 27). Pytanie brzmi: czy ból zmieniał się między pomiarami i czy poprawa się utrzymała?
ANOVA z powtarzanymi pomiarami wymaga kompletu pomiarów, więc objęła 27 osób. Test Mauchly’ego nie wskazał na naruszenie założenia sferyczności, W = 0.996, p = .948, a wynik z poprawką Greenhouse’a–Geissera był istotny: F(1.99, 51.78) = 24.64, p < .001. Jako wielkość efektu podaj uogólnione eta kwadrat, η²G = .21, które zaleca Bakeman (2005), bo pozwala porównywać efekty między różnymi schematami. Porównania parami z korektą Holma (u tych samych 27 osób, dlatego spadek po 4 tygodniach jest nieco mniejszy niż 2.00 punktu policzone dla 30 osób):
- przed terapią a po 4 tygodniach: spadek o 1.85 punktu, t(26) = 6.07, p < .001;
- przed terapią a po 12 tygodniach: spadek o 1.78 punktu, t(26) = 6.15, p < .001;
- po 4 a po 12 tygodniach: różnica −0.07 punktu, t(26) = −0.25, p = .808 – poprawa się utrzymała.
Nieparametryczną alternatywą jest test Friedmana: χ²(2) = 25.28, p < .001, W Kendalla = .47. Oba testy pomijają jednak trzy osoby bez ostatniego pomiaru. Gdy brakuje pomiarów, lepszy jest model mieszany, który wykorzystuje wszystkie dostępne dane. W przykładzie objął 30 osób: F(2, 55.74) = 29.96, p < .001, a szacowane średnie wyniosły 5.13, 3.13 i 3.30 punktu. Kiedy wybrać ANOVA, a kiedy model mieszany – także dla dwóch grup i wielu pomiarów – wyjaśniamy w poradniku pomiary powtarzane – ANOVA czy model mieszany.
Jak opisać wyniki w pracy z fizjoterapii (APA)
Podawaj średnie i odchylenia standardowe w każdym pomiarze, zmianę z 95% CI, test, wielkość efektu i odsetek osób z poprawą ≥ MCID ze źródłem progu. Ogólne zasady zapisu znajdziesz w poradniku jak opisać wyniki w stylu APA, a sposób opisania całego rozdziału – we wpisie wyniki badań własnych – przykład.
Jeśli przygotowujesz eksperyment fizjoterapeutyczny i chcesz, żeby ktoś sprawdził plan analizy albo wyjaśnił Ci wyniki, zajrzyj do oferty analiz statystycznych dla studentów – analizujemy pomiary przed terapią i po niej, porównujemy grupy i opisujemy zmianę w czasie. Wyniki omawiamy tak, abyś umiał(a) samodzielnie je obronić, a pomoc ujawniasz zgodnie z zasadami uczelni.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Pobierz plik statystyka-dla-fizjoterapeuty-dane-przyklad.xlsx, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – przepisy 2–4 korzystają z ramki badanie i pakietu readxl wczytanych w przepisie 1. Symulacja w przepisie 5 obejmuje 100 000 osób i trwa około sekundy.
1. Jedna grupa przed i po: test t, test Wilcoxona i MCID
R
library(readxl)   # read_excel()
library(coin)     # wilcoxsign_test(): wartość z dla testu Wilcoxona

badanie <- read_excel("statystyka-dla-fizjoterapeuty-dane-przyklad.xlsx", sheet = "Badanie")
A <- badanie[badanie$grupa == "A", ]           # jedna grupa: pomiar przed (T0) i po 4 tygodniach (T1)
roznica <- A$nrs_t1 - A$nrs_t0                 # wartość ujemna = mniejszy ból po terapii

opis <- function(x) round(c(M = mean(x), SD = sd(x), Mdn = median(x),
                            Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75))), 2)
rbind(przed = opis(A$nrs_t0), po = opis(A$nrs_t1), roznica = opis(roznica))
table(roznica)
shapiro.test(roznica)                          # normalność sprawdzamy dla różnic, nie dla surowych wyników

# Test t dla prób zależnych: średnia różnica z 95% CI
tt <- t.test(A$nrs_t1, A$nrs_t0, paired = TRUE)
round(c(t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value,
        M_roznicy = unname(tt$estimate), CI_dolna = tt$conf.int[1], CI_gorna = tt$conf.int[2]), 4)

# Wielkość efektu: d_z (SD różnic) i d_av (średnie SD obu pomiarów)
round(c(d_z = mean(roznica) / sd(roznica), d_av = mean(roznica) / mean(c(sd(A$nrs_t0), sd(A$nrs_t1)))), 2)

# Test Wilcoxona dla par (zera pominięte, jak w wilcox.test) i korelacja rangowo-dwuseryjna
w  <- wilcox.test(A$nrs_t1, A$nrs_t0, paired = TRUE, exact = FALSE)
wz <- wilcoxsign_test(A$nrs_t1 ~ A$nrs_t0, zero.method = "Wilcoxon")
niezerowe <- roznica[roznica != 0]
rangi <- rank(abs(niezerowe))
T_plus <- sum(rangi[niezerowe > 0]); T_minus <- sum(rangi[niezerowe < 0])
round(c(V = unname(w$statistic), z = statistic(wz), p = pvalue(wz), zera = sum(roznica == 0),
        r_rb = (T_plus - T_minus) / (T_plus + T_minus)), 4)

# MCID: poprawa o co najmniej 2 punkty NRS (oraz wariant: o co najmniej 30% wartości wyjściowej)
poprawa_2pkt  <- roznica <= -2
poprawa_30proc <- (A$nrs_t0 - A$nrs_t1) / A$nrs_t0 >= 0.30
ci <- prop.test(sum(poprawa_2pkt), length(roznica), correct = FALSE)$conf.int   # przedział Wilsona
round(c(n = sum(poprawa_2pkt), proc = 100 * mean(poprawa_2pkt), CI_dolna = 100 * ci[1], CI_gorna = 100 * ci[2],
        proc_30 = 100 * mean(poprawa_30proc), pogorszenie = sum(roznica > 0)), 1)
Wynik w R
            M   SD Mdn Q1    Q3
przed    5.13 1.28   5  4  5.75
po       3.13 1.83   3  2  4.75
roznica -2.00 1.60  -2 -3 -1.00
roznica
-5 -4 -3 -2 -1  0  1
 1  6  3 10  4  4  2

	Shapiro-Wilk normality test

data:  roznica
W = 0.93976, p-value = 0.0896

        t        df         p M_roznicy  CI_dolna  CI_gorna
  -6.8576   29.0000    0.0000   -2.0000   -2.5965   -1.4035
  d_z  d_av
-1.25 -1.29
      V       z       p    zera    r_rb
 7.0000 -4.3214  0.0000  4.0000 -0.9601
          n        proc    CI_dolna    CI_gorna     proc_30 pogorszenie
       20.0        66.7        48.8        80.8        60.0         2.0
2. Dwie grupy: ANCOVA z pomiarem wyjściowym, analiza zmian i odsetki poprawy
R
library(emmeans)     # emmeans(): średnie skorygowane
library(afex)        # aov_ez(): ANOVA mieszana 2 × 2
library(DescTools)   # BinomDiffCI(): przedział dla różnicy odsetków

badanie$grupa <- factor(badanie$grupa, levels = c("A", "B"))   # A – nowy program, B – standardowa fizjoterapia
round(do.call(rbind, lapply(split(badanie, badanie$grupa), function(d)
  c(n = nrow(d), M_T0 = mean(d$nrs_t0), SD_T0 = sd(d$nrs_t0), M_T1 = mean(d$nrs_t1), SD_T1 = sd(d$nrs_t1),
    M_zmiana = mean(d$nrs_t1 - d$nrs_t0), SD_zmiana = sd(d$nrs_t1 - d$nrs_t0)))), 2)
round(cor(badanie$nrs_t0, badanie$nrs_t1), 2)                    # korelacja pomiaru wyjściowego i końcowego

# ANCOVA: pomiar po terapii wyjaśniany grupą przy kontroli pomiaru wyjściowego
anova(lm(nrs_t1 ~ grupa * nrs_t0, data = badanie))["grupa:nrs_t0", ]   # jednorodność nachyleń (interakcja)
ancova <- lm(nrs_t1 ~ grupa + nrs_t0, data = badanie)
round(cbind(coef(summary(ancova)), confint(ancova)), 3)
sr_skor <- emmeans(ancova, ~ grupa)                               # średnie skorygowane przy średnim T0
sr_skor
confint(pairs(sr_skor))                                           # różnica skorygowana A − B z 95% CI
ss <- car::Anova(ancova, type = 2)
round(c(eta2_cz = ss["grupa", "Sum Sq"] / (ss["grupa", "Sum Sq"] + ss["Residuals", "Sum Sq"])), 3)

# Dla porównania: test t na różnicach (zmianach) i na samym pomiarze końcowym
zmiana <- t.test(I(nrs_t1 - nrs_t0) ~ grupa, data = badanie, var.equal = TRUE)
koniec <- t.test(nrs_t1 ~ grupa, data = badanie, var.equal = TRUE)
round(rbind(
  zmiana = c(roznica = unname(-diff(zmiana$estimate)), CI_dolna = zmiana$conf.int[1], CI_gorna = zmiana$conf.int[2],
             t = unname(zmiana$statistic), p = zmiana$p.value),
  koniec = c(roznica = unname(-diff(koniec$estimate)), CI_dolna = koniec$conf.int[1], CI_gorna = koniec$conf.int[2],
             t = unname(koniec$statistic), p = koniec$p.value)), 3)

# ANOVA mieszana 2 (grupa) × 2 (pomiar): interakcja to ten sam test co t na różnicach (F = t²)
dl <- data.frame(id = rep(badanie$id, 2), grupa = rep(badanie$grupa, 2),
                 pomiar = factor(rep(c("T0", "T1"), each = nrow(badanie))), nrs = c(badanie$nrs_t0, badanie$nrs_t1))
aov_ez(id = "id", dv = "nrs", data = dl, between = "grupa", within = "pomiar")
round(unname(zmiana$statistic)^2, 2)

# Odsetek osób z poprawą ≥ 2 pkt NRS (MCID) w obu grupach
popr <- tapply(badanie$nrs_t1 - badanie$nrs_t0 <= -2, badanie$grupa, sum)
round(100 * popr / 30, 1)
round(100 * BinomDiffCI(popr[["A"]], 30, popr[["B"]], 30, method = "score"), 1)   # różnica A − B z 95% CI (Newcombe)
round(fisher.test(matrix(c(popr, 30 - popr), 2))$p.value, 3)
Wynik w R
   n M_T0 SD_T0 M_T1 SD_T1 M_zmiana SD_zmiana
A 30 5.13  1.28 3.13  1.83    -2.00      1.60
B 30 5.40  1.43 4.53  1.93    -0.87      2.11
[1] 0.38
Analysis of Variance Table

Response: nrs_t1
             Df Sum Sq Mean Sq F value Pr(>F)
grupa:nrs_t0  1 4.9393  4.9393  1.6026 0.2108
            Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)    0.531      0.934   0.569    0.572 -1.340  2.403
grupaB         1.265      0.458   2.762    0.008  0.348  2.182
nrs_t0         0.507      0.171   2.966    0.004  0.165  0.849
 grupa emmean    SE df lower.CL upper.CL
 A       3.20 0.323 57     2.55     3.85
 B       4.47 0.323 57     3.82     5.11

Confidence level used: 0.95
 contrast estimate    SE df lower.CL upper.CL
 A - B       -1.26 0.458 57    -2.18   -0.348

Confidence level used: 0.95
eta2_cz
  0.118
       roznica CI_dolna CI_gorna      t     p
zmiana  -1.133   -2.101   -0.165 -2.344 0.023
koniec  -1.400   -2.372   -0.428 -2.885 0.005
Anova Table (Type 3 tests)

Response: nrs
        Effect    df  MSE         F  ges p.value
1        grupa 1, 58 3.62    5.76 * .063    .020
2       pomiar 1, 58 1.75 35.14 *** .165   <.001
3 grupa:pomiar 1, 58 1.75    5.49 * .030    .023
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1
[1] 5.49
   A    B
66.7 36.7
     est lwr.ci upr.ci
[1,]  30    4.8   50.4
[1] 0.038
3. Trzy pomiary: ANOVA z powtarzanymi pomiarami, test Friedmana i model mieszany
R
library(afex)       # aov_ez(): ANOVA z powtarzanymi pomiarami
library(emmeans)    # porównania pomiarów z korektą Holma
library(lmerTest)   # lmer(): model mieszany z testami F (Satterthwaite)

A <- badanie[badanie$grupa == "A", ]           # grupa A: przed (T0), po 4 tygodniach (T1), po 12 tygodniach (T2)
dlA <- data.frame(id = rep(A$id, 3), pomiar = factor(rep(c("T0", "T1", "T2"), each = nrow(A))),
                  nrs = c(A$nrs_t0, A$nrs_t1, A$nrs_t2))
round(sapply(split(dlA$nrs, dlA$pomiar), function(x) c(n = sum(!is.na(x)), M = mean(x, na.rm = TRUE),
                                                     SD = sd(x, na.rm = TRUE))), 2)

# ANOVA z powtarzanymi pomiarami – tylko osoby z kompletem trzech pomiarów
pelne <- dlA[dlA$id %in% A$id[!is.na(A$nrs_t2)], ]
length(unique(pelne$id))
rm_anova <- aov_ez(id = "id", dv = "nrs", data = pelne, within = "pomiar")
summary(rm_anova)$sphericity.tests            # test Mauchly'ego
rm_anova                                      # F z poprawką Greenhouse'a–Geissera i uogólnione eta² (ges)
pairs(emmeans(rm_anova, ~ pomiar), adjust = "holm")

# Test Friedmana (nieparametryczny odpowiednik) i W Kendalla
szer <- as.matrix(A[!is.na(A$nrs_t2), c("nrs_t0", "nrs_t1", "nrs_t2")])
fr <- friedman.test(szer)
round(c(chi2 = unname(fr$statistic), df = unname(fr$parameter), p = fr$p.value,
        W_Kendalla = unname(fr$statistic) / (nrow(szer) * (3 - 1))), 4)

# Model mieszany: wszystkie 30 osób, także trzy bez pomiaru T2
mm <- lmer(nrs ~ pomiar + (1 | id), data = dlA)
anova(mm)
emmeans(mm, ~ pomiar)
Wynik w R
      T0    T1    T2
n  30.00 30.00 27.00
M   5.13  3.13  3.33
SD  1.28  1.83  1.88
[1] 27
       Test statistic p-value
pomiar        0.99577 0.94836
Anova Table (Type 3 tests)

Response: nrs
  Effect          df  MSE         F  ges p.value
1 pomiar 1.99, 51.78 1.21 24.64 *** .208   <.001
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
 contrast estimate    SE df t.ratio p.value
 T0 - T1    1.8519 0.305 26   6.067 <0.0001
 T0 - T2    1.7778 0.289 26   6.150 <0.0001
 T1 - T2   -0.0741 0.302 26  -0.246  0.8079

P value adjustment: holm method for 3 tests
      chi2         df          p W_Kendalla
   25.2842     2.0000     0.0000     0.4682
Type III Analysis of Variance Table with Satterthwaite's method
       Sum Sq Mean Sq NumDF  DenDF F value    Pr(>F)
pomiar 72.743  36.371     2 55.736  29.958 1.464e-09 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 pomiar emmean    SE   df lower.CL upper.CL
 T0       5.13 0.306 52.1     4.52     5.75
 T1       3.13 0.306 52.1     2.52     3.75
 T2       3.30 0.316 56.2     2.66     3.93

Degrees-of-freedom method: kenward-roger
Confidence level used: 0.95
4. Rzetelność pomiaru: ICC, SEM i minimalna wykrywalna zmiana
R
library(psych)   # ICC()

rom <- read_excel("statystyka-dla-fizjoterapeuty-dane-przyklad.xlsx", sheet = "Rzetelnosc_ROM")
round(c(n = nrow(rom), M_fizjo1 = mean(rom$fizjo1), M_fizjo2 = mean(rom$fizjo2)), 2)
roz <- t.test(rom$fizjo2, rom$fizjo1, paired = TRUE)          # czy drugi badający mierzy systematycznie inaczej?
round(c(roznica = unname(roz$estimate), CI_dolna = roz$conf.int[1], CI_gorna = roz$conf.int[2], p = roz$p.value), 4)

icc <- ICC(rom[, c("fizjo1", "fizjo2")])
round(icc$results[c("Single_raters_absolute", "Single_random_raters", "Single_fixed_raters"),
                  c("ICC", "lower bound", "upper bound")], 3)

# SEM i minimalna wykrywalna zmiana (MDC95) dla ICC(2,1) – zgodność bezwzględna
sd_pomiarow <- sd(c(rom$fizjo1, rom$fizjo2))
icc21 <- icc$results["Single_random_raters", "ICC"]
sem <- sd_pomiarow * sqrt(1 - icc21)
round(c(SD = sd_pomiarow, ICC_2_1 = icc21, SEM = sem, MDC95 = 1.96 * sqrt(2) * sem), 2)
Wynik w R
       n M_fizjo1 M_fizjo2
   30.00    53.47    56.07
 roznica CI_dolna CI_gorna        p
  2.6000   1.2533   3.9467   0.0005
                         ICC lower bound upper bound
Single_raters_absolute 0.951       0.901       0.976
Single_random_raters   0.951       0.819       0.982
Single_fixed_raters    0.967       0.931       0.984
     SD ICC_2_1     SEM   MDC95
  13.94    0.95    3.07    8.51
5. Regresja do średniej i liczebność próby
R
# Regresja do średniej: 100 000 osób, dwa pomiary bólu cztery tygodnie od siebie i ŻADNEJ terapii
set.seed(2026)
n <- 100000
typowy_bol <- rnorm(n, 4.5, 1.5)                                     # stały poziom bólu danej osoby
nrs <- function(x) pmin(pmax(round(x), 0), 10)
pomiar1 <- nrs(typowy_bol + rnorm(n, 0, 1.2))                        # wahania z dnia na dzień
pomiar2 <- nrs(typowy_bol + rnorm(n, 0, 1.2))
kwalifikacja <- pomiar1 >= 6                                         # do „badania” trafiają osoby z NRS ≥ 6
zmiana <- pomiar2 - pomiar1
round(c(proc_zakwalifikowanych = 100 * mean(kwalifikacja), M_przed = mean(pomiar1[kwalifikacja]),
        M_po = mean(pomiar2[kwalifikacja]), M_zmiany = mean(zmiana[kwalifikacja]),
        proc_poprawa_2pkt = 100 * mean(zmiana[kwalifikacja] <= -2), M_zmiany_wszyscy = mean(zmiana)), 2)

# Ile osób potrzebujesz? (moc .80, α = .05, test dwustronny)
ceiling(power.t.test(delta = 1, sd = 2, power = .80, type = "paired")$n)   # jedna grupa, przed–po: d_z = 0.5
ceiling(power.t.test(delta = 1, sd = 2, power = .80)$n)                    # dwie grupy, porównanie zmian: na grupę
Wynik w R
proc_zakwalifikowanych                M_przed                   M_po
                 30.19                   6.77                   5.87
              M_zmiany      proc_poprawa_2pkt       M_zmiany_wszyscy
                 -0.90                  34.91                   0.00
[1] 34
[1] 64
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- coin (wersja 1.4.3): Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2006). A Lego system for conditional inference. The American Statistician, 60(3), 257–263. https://doi.org/10.1198/000313006X118430
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- afex (wersja 1.5.1): Singmann, H., Bolker, B., Westfall, J., Aust, F., & Ben-Shachar, M. S. (2025). afex: Analysis of factorial experiments [R package]. https://doi.org/10.32614/CRAN.package.afex
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Te same analizy w SPSS – ogólne kroki
Nazwy menu podajemy w angielskiej wersji programu, według dokumentacji IBM SPSS Statistics 30 (IBM, b.d.). Dane powinny być w formacie szerokim: jeden wiersz to jedna osoba, a każdy pomiar to osobna kolumna.
- Test t dla prób zależnych: Analyze → Compare Means → Paired-Samples T Test; jako parę wskaż pomiar po i przed terapią.
- Test Wilcoxona: Analyze → Nonparametric Tests → Legacy Dialogs → 2 Related Samples, test Wilcoxon.
- ANCOVA: Analyze → General Linear Model → Univariate; pomiar po terapii to zmienna zależna, grupa – czynnik stały (Fixed Factor), pomiar przed terapią – kowariant (Covariate). Jednorodność nachyleń sprawdź, dodając tymczasowo do modelu interakcję grupy z pomiarem wyjściowym.
- ANOVA z powtarzanymi pomiarami: Analyze → General Linear Model → Repeated Measures; nazwij czynnik wewnątrzobiektowy (np. „pomiar”), podaj liczbę poziomów (3), kliknij Add i Define, a potem przypisz kolumny pomiarów. Test Mauchly’ego program pokazuje automatycznie; jeśli sferyczność jest naruszona, odczytaj wynik z poprawką Greenhouse’a–Geissera.
- Test Friedmana: Analyze → Nonparametric Tests → Legacy Dialogs → K Related Samples, testy Friedman i Kendall's W.
- ICC: Analyze → Scale → Reliability Analysis, w oknie Statistics zaznacz Intraclass correlation coefficient, model Two-Way Random i typ Absolute Agreement – w wydruku odczytaj wynik dla pojedynczego pomiaru.
Odczytywanie typowych tabel wydruku wyjaśniamy w poradniku jak czytać wyniki z SPSS.
Najczęstsze błędy w pracach z fizjoterapii
- „p < .05, więc terapia działa” w badaniu bez grupy kontrolnej. Istotna zmiana przed–po nie oddziela terapii od naturalnego przebiegu i regresji do średniej.
- Dwa osobne testy przed–po zamiast porównania grup. Różnicę między grupami testuje się bezpośrednio – najlepiej ANCOVA z pomiarem wyjściowym.
- Wybór analizy po zobaczeniu wyników. Pomiar końcowy, zmiana i ANCOVA dają różne p; wybierz metodę w planie analizy (Vickers i Altman, 2001).
- Samo p bez wielkości zmiany. Podaj średnią zmianę z 95% CI i wielkość efektu, z informacją, czy to dz, czy dav.
- Średnia zmiana ≥ MCID jako dowód, że „pacjenci poprawili się klinicznie”. Pokaż rozkład zmian i odsetek osób z poprawą ≥ MCID, a główną analizę zrób na wyniku ciągłym (Snapinn i Jiang, 2007).
- Mylenie MCID z MDC. MDC mówi, jaka zmiana przekracza błąd pomiaru, a MCID – jaka zmiana jest ważna dla pacjenta. Jeśli MDC jest większe od MCID, narzędzie nie pozwala ocenić istotnej klinicznie zmiany u pojedynczej osoby.
- ICC bez podanej formy albo korelacja Pearsona jako miara rzetelności. Korelacja nie wykryje, że jeden fizjoterapeuta mierzy systematycznie szerzej; ICC(2,1) – tak.
- Ciche pomijanie osób bez kompletu pomiarów. Podaj, ile osób i w którym pomiarze brakuje, a przy brakach rozważ model mieszany.
- Wiele wyników bez planu. Wskaż z góry wynik główny, a pozostałe oznacz jako drugorzędowe albo skoryguj p.
Na obronie pytania o grupę kontrolną, regresję do średniej i MCID padają bardzo często – przygotuj się z wpisem pytania na obronie z metodologii i statystyki. Jak opisać ograniczenia i znaczenie praktyczne wyników, pokazujemy w poradniku jak napisać dyskusję wyników.
Najczęstsze pytania
Jaki test statystyczny wybrać w pracy z fizjoterapii?
To zależy od schematu badania. Pomiar przed i po w jednej grupie analizuj testem t dla prób zależnych (albo testem Wilcoxona, gdy różnice są wyraźnie skośne lub próba jest bardzo mała), dwie grupy z pomiarem przed i po – ANCOVA z pomiarem wyjściowym jako kowariantem, a trzy pomiary lub więcej – ANOVA z powtarzanymi pomiarami, testem Friedmana albo modelem mieszanym. Do każdego testu dołącz wielkość efektu i 95% przedział ufności.
Jak policzyć odsetek pacjentów z poprawą klinicznie istotną?
Dla każdej osoby policz zmianę wyniku (po − przed) i sprawdź, czy przekracza przyjęty próg MCID – dla bólu w skali NRS często 2 punkty albo 30% wartości wyjściowej. Podaj liczbę i odsetek takich osób z 95% przedziałem ufności, a w badaniu z dwiema grupami – różnicę odsetków. Odsetek traktuj jako uzupełnienie analizy wyniku ciągłego, a nie jej zamiennik.
Czym różni się MCID od MDC?
MDC (minimalna wykrywalna zmiana) mówi, jaka zmiana przekracza błąd pomiaru – liczy się ją ze standardowego błędu pomiaru: MDC95 = 1.96 × √2 × SEM. MCID (minimalna klinicznie istotna różnica) mówi, jaka zmiana jest odczuwalna i ważna dla pacjenta, i wyznacza się ją m.in. przez porównanie z oceną zmiany dokonaną przez pacjentów. Zmiana u pacjenta powinna przekraczać oba progi.
Czy bez grupy kontrolnej można stwierdzić, że terapia jest skuteczna?
Nie wprost. Badanie jednej grupy przed i po pokazuje, że wynik się zmienił, ale zmiana może wynikać także z naturalnego przebiegu dolegliwości, regresji do średniej, efektów niespecyficznych czy innego leczenia. W takiej pracy pisz o zmianie obserwowanej po terapii i omów te wyjaśnienia w ograniczeniach.
Jak porównać dwie grupy pacjentów z pomiarem przed i po terapii?
Najlepiej analizą kowariancji (ANCOVA): pomiar po terapii jest zmienną zależną, grupa – czynnikiem, a pomiar przed terapią – kowariantem. W badaniach z losowym przydziałem ma ona zwykle większą moc niż porównanie zmian i nie zależy od przypadkowej nierównowagi wyjściowej. Nie wykonuj dwóch osobnych testów przed–po w każdej grupie – nie sprawdzają one różnicy między grupami.
Czy skalę bólu NRS analizować testem t czy testem Wilcoxona?
NRS to formalnie skala porządkowa, ale przy 11 punktach i analizie różnic u tych samych osób zwykle stosuje się test t dla prób zależnych. Gdy rozkład różnic jest wyraźnie skośny, próba bardzo mała albo jest dużo rang wiązanych, wybierz test Wilcoxona – albo podaj go jako analizę uzupełniającą. Test wybierz przed analizą, a nie po porównaniu wyników obu.
Powiązane hasła
Przeczytaj też
Jak napisać pracę z fizjoterapii
Opis interwencji według TIDieR, mapa ICF, rzetelność pomiaru, MDC i MCID, brak grupy kontrolnej i dyskusja – na fikcyjnym programie ćwiczeń w bólu lędźwiowym, z gotowymi akapitami.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikAnkieta wiedzy – analiza krok po kroku
Punktacja z „nie wiem”, poziomy wiedzy, KR-20, analiza pozycji, testy rangowe i źródła wiedzy – na danych do pobrania, z kodem R i opisem APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Analizujesz pomiary przed terapią i po niej?
Pomożemy dobrać analizę do schematu Twojego badania, policzyć wyniki i wyjaśnić je tak, abyś umiał(a) samodzielnie obronić je przed komisją.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707 ● Otwarty dostęp
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Clifton, L., & Clifton, D. A. (2019). The correlation between baseline score and post-intervention score, and its implications for statistical analysis. Trials, 20(1), Article 43. https://doi.org/10.1186/s13063-018-3108-3 ● Otwarty dostęp
- Farrar, J. T., Young, J. P., Jr., LaMoreaux, L., Werth, J. L., & Poole, R. M. (2001). Clinical importance of changes in chronic pain intensity measured on an 11-point numerical pain rating scale. Pain, 94(2), 149–158. https://doi.org/10.1016/s0304-3959(01)00349-9
- IBM. (b.d.). IBM SPSS Statistics 30.0.0 documentation. Pobrano 8 listopada 2026 z https://www.ibm.com/docs/en/spss-statistics/30.0.0 ● Otwarty dostęp
- Jaeschke, R., Singer, J., & Guyatt, G. H. (1989). Measurement of health status: Ascertaining the minimal clinically important difference. Controlled Clinical Trials, 10(4), 407–415. https://doi.org/10.1016/0197-2456(89)90005-6
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Ostelo, R. W. J. G., Deyo, R. A., Stratford, P., Waddell, G., Croft, P., Von Korff, M., Bouter, L. M., & de Vet, H. C. (2008). Interpreting change scores for pain and functional status in low back pain: Towards international consensus regarding minimal important change. Spine, 33(1), 90–94. https://doi.org/10.1097/brs.0b013e31815e3a10 ● Otwarty dostęp: pełny tekst
- Snapinn, S. M., & Jiang, Q. (2007). Responder analyses and the assessment of a clinically relevant treatment effect. Trials, 8(1), Article 31. https://doi.org/10.1186/1745-6215-8-31 ● Otwarty dostęp
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
- Vickers, A. J., & Altman, D. G. (2001). Analysing controlled trials with baseline and follow up measurements. BMJ, 323(7321), 1123–1124. https://doi.org/10.1136/bmj.323.7321.1123 ● Otwarty dostęp
- Weir, J. P. (2005). Quantifying test-retest reliability using the intraclass correlation coefficient and the SEM. Journal of Strength and Conditioning Research, 19(1), 231–240. https://doi.org/10.1519/15184.1
Cytowania BibTeX
@article{bakeman2005recommended, author={Bakeman, Roger}, title={{Recommended effect size statistics for repeated measures designs}}, journal={Behavior Research Methods}, year={2005}, volume={37}, number={3}, pages={379--384}, doi={10.3758/bf03192707}}@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{clifton2019correlation, author={Clifton, Lei and Clifton, David A.}, title={{The correlation between baseline score and post-intervention score, and its implications for statistical analysis}}, journal={Trials}, year={2019}, volume={20}, number={1}, eid={43}, doi={10.1186/s13063-018-3108-3}}@article{farrar2001clinical, author={Farrar, John T. and Young, James P., Jr. and LaMoreaux, Linda and Werth, John L. and Poole, Michael R.}, title={{Clinical importance of changes in chronic pain intensity measured on an 11-point numerical pain rating scale}}, journal={Pain}, year={2001}, volume={94}, number={2}, pages={149--158}, doi={10.1016/s0304-3959(01)00349-9}}@misc{ibmndspssdokumentacja, author={{IBM}}, title={{IBM SPSS Statistics 30.0.0 documentation}}, url={https://www.ibm.com/docs/en/spss-statistics/30.0.0}}@article{jaeschke1989measurement, author={Jaeschke, Roman and Singer, Joel and Guyatt, Gordon H.}, title={{Measurement of health status: Ascertaining the minimal clinically important difference}}, journal={Controlled Clinical Trials}, year={1989}, volume={10}, number={4}, pages={407--415}, doi={10.1016/0197-2456(89)90005-6}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{ostelo2008interpreting, author={Ostelo, Raymond W. J. G. and Deyo, Rick A. and Stratford, P. and Waddell, Gordon and Croft, Peter and Von Korff, Michael and Bouter, Lex M. and de Vet, Henrica C.}, title={{Interpreting change scores for pain and functional status in low back pain: Towards international consensus regarding minimal important change}}, journal={Spine}, year={2008}, volume={33}, number={1}, pages={90--94}, doi={10.1097/brs.0b013e31815e3a10}}@article{snapinn2007responder, author={Snapinn, Steven M. and Jiang, Qi}, title={{Responder analyses and the assessment of a clinically relevant treatment effect}}, journal={Trials}, year={2007}, volume={8}, number={1}, eid={31}, doi={10.1186/1745-6215-8-31}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}@article{vickers2001analysing, author={Vickers, Andrew J. and Altman, Douglas G.}, title={{Analysing controlled trials with baseline and follow up measurements}}, journal={BMJ}, year={2001}, volume={323}, number={7321}, pages={1123--1124}, doi={10.1136/bmj.323.7321.1123}}@article{weir2005quantifying, author={Weir, Joseph P.}, title={{Quantifying test-retest reliability using the intraclass correlation coefficient and the SEM}}, journal={Journal of Strength and Conditioning Research}, year={2005}, volume={19}, number={1}, pages={231--240}, doi={10.1519/15184.1}}