Co to jest wielkość efektu?
Wielkość efektu to ilościowa miara siły zjawiska: różnicy między grupami, związku między zmiennymi albo odsetka wyjaśnianej wariancji. Odpowiada na pytanie „jak bardzo?”, a nie tylko „czy w ogóle?”. W polskiej literaturze używa się zamiennie nazw wielkość efektu i siła efektu.
Wielkość efektu jest niezbędna z trzech powodów (Lakens, 2013):
- Interpretacja praktyczna — wartość p zależy od liczebności próby. Przy 10 000 osób nawet różnica bez znaczenia praktycznego będzie „istotna”, a przy 20 osobach duży efekt może być nieistotny (Sullivan i Feinn, 2012).
- Planowanie badań — z oczekiwanej wielkości efektu wylicza się potrzebną liczebność próby w analizie mocy (Brysbaert, 2019).
- Kumulacja wiedzy — wielkości efektu z różnych badań można porównywać i łączyć w metaanalizie.
Rodzaje miar wielkości efektu
Miarę dobiera się do pytania badawczego i rodzaju zmiennych. Większość miar należy do dwóch rodzin: rodziny d (standaryzowane różnice średnich) i rodziny r (siła związku i procent wyjaśnianej wariancji). Osobną grupę tworzą miary dla zmiennych dychotomicznych: iloraz szans (OR) i ryzyko względne (RR).
| Pytanie badawcze | Miara | Mały | Średni | Duży | Więcej |
|---|---|---|---|---|---|
| Różnica dwóch średnich | d Cohena, g Hedgesa | 0,20 | 0,50 | 0,80 | d Cohena |
| Związek dwóch zmiennych ilościowych | r Pearsona | 0,10 | 0,30 | 0,50 | korelacja Pearsona |
| Różnice między kilkoma grupami (ANOVA) | η², ω² | 0,01 | 0,06 | 0,14 | eta kwadrat |
| Regresja wieloraka | f² Cohena (z R²) | 0,02 | 0,15 | 0,35 | R² |
| Dwie zmienne jakościowe (tabela 2×2) | φ (w Cohena) | 0,10 | 0,30 | 0,50 | tabela krzyżowa |
Wszystkie te miary da się przeliczać na siebie (przy pewnych założeniach), co wykorzystuje metaanaliza i kalkulator niżej. Szczegóły interpretacji poszczególnych miar opisuje poradnik wielkość efektu — interpretacja.
Wielkość efektu w eksperymencie: co zmieniła manipulacja?
W eksperymencie badacz sam wywołuje różnicę między warunkami za pomocą manipulacji eksperymentalnej. Wielkość efektu odpowiada wtedy na pytanie, o ile odchyleń standardowych manipulacja przesunęła wyniki grupy eksperymentalnej względem kontrolnej.
Przykład. Uczestników losowo przydzielono do indukcji nastroju pozytywnego (n = 42) lub neutralnego (n = 42), a następnie zmierzono kreatywność (0–40 punktów). Po indukcji pozytywnej wyniki były wyższe (M = 25,42; SD = 7,06) niż po neutralnej (M = 21,40; SD = 5,55), t(82) = 2,90, p = 0,005.
- d Cohena = 0,63, 95% CI [0,19; 1,07] — średnia grupy eksperymentalnej leży o 0,63 odchylenia standardowego wyżej;
- g Hedgesa (z poprawką na małą próbę) = 0,63, 95% CI [0,19; 1,06];
- w przeliczeniu: r = 0,31, a prawdopodobieństwo, że losowa osoba z warunku pozytywnego ma wyższy wynik niż losowa osoba z warunku neutralnego, wynosi 67,3%.
Efekt jest „średni” według konwencji Cohena, ale przedział ufności jest szeroki: dane są zgodne zarówno z efektem małym (0,19), jak i dużym (1,07). Przy 42 osobach w grupie tak właśnie wygląda precyzja oszacowania. Więcej o d i jego przedziale znajdziesz w haśle d Cohena — interpretacja.
Trzy warunki. Gdy dodamy trzeci warunek (indukcja nastroju negatywnego, M = 19,88; SD = 4,48), wynik ANOVA wynosi F(2, 123) = 10,25, p < 0,001. Manipulacja wyjaśnia η² = 0,14 wariancji kreatywności (95% CI [0,05; 1,00]), a mniej obciążona omega kwadrat wynosi ω² = 0,13. Przedziały są jednostronne, bo η² i ω² nie mogą być ujemne.
Od czego zależy wielkość efektu w eksperymencie?
Wielkość efektu opisuje konkretne badanie, a nie samo zjawisko. Ten sam proces psychologiczny może dać d = 0,2 albo d = 0,8 w zależności od:
- siły manipulacji — silniejsza indukcja nastroju zwykle daje większy efekt; dlatego warto sprawdzać skuteczność manipulacji (tzw. sprawdzenie manipulacji);
- rzetelności pomiaru — błąd pomiaru zaniża efekty (por. rzetelność);
- jednorodności próby — w jednorodnej próbie SD jest mniejsze, więc ta sama różnica średnich daje większe d;
- schematu badania — w schemacie wewnątrzobiektowym d liczone z różnic (dz) bywa znacznie większe niż d dla grup niezależnych, dlatego zawsze trzeba podać, którą wersję policzono (Lakens, 2013).
Wielkość efektu w metaanalizie
Metaanaliza łączy wyniki wielu badań tego samego zjawiska. Ponieważ badania używają różnych narzędzi i skal, ich wyniki najpierw sprowadza się do wspólnej miary — najczęściej g Hedgesa, r lub logarytmu ilorazu szans — a następnie uśrednia z wagami odwrotnie proporcjonalnymi do wariancji, czyli większą wagę dostają badania bardziej precyzyjne (Borenstein i in., 2010).
Przykład. Osiem badań (przykładowe dane) sprawdzało tę samą manipulację nastroju. Z ich średnich, SD i liczebności policzono g Hedgesa i połączono je w modelu efektów losowych w pakiecie metafor (Viechtbauer, 2010). Jak przeprowadzić taką analizę samodzielnie, pokazuje bezpłatny podręcznik internetowy Harrer i in. (2021).
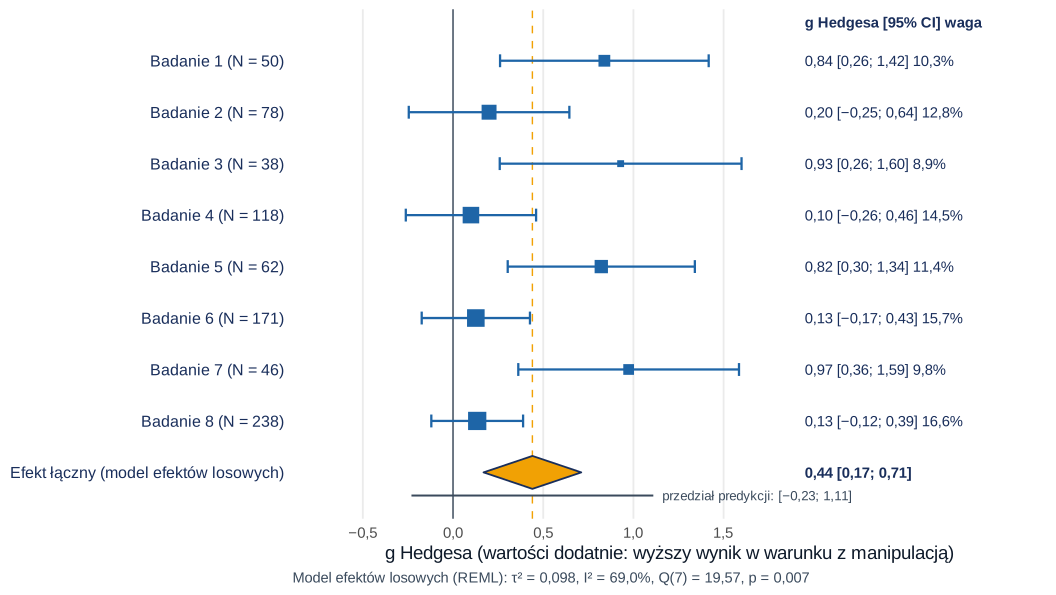
- Efekt łączny: g = 0,44, 95% CI [0,17; 0,71], z = 3,18, p = 0,001 — przeciętnie manipulacja podnosi wyniki o niecałe pół odchylenia standardowego.
- Heterogeniczność: Q(7) = 19,57, p = 0,007; I² = 69,0%, τ = 0,31. Prawie 70% zmienności wyników to rzeczywiste różnice między badaniami, a nie błąd losowy.
- Przedział predykcji [−0,23; 1,11] pokazuje, jakiego efektu można się spodziewać w kolejnym podobnym badaniu: od braku efektu do efektu dużego. To ważniejsza informacja praktyczna niż sam efekt łączny.
Warto też spojrzeć na wzór w danych: cztery małe badania (N od 38 do 62) dały g od 0,82 do 0,97, a cztery duże (N od 78 do 238) — od 0,10 do 0,20. Taki efekt małych badań może wynikać z efektu szuflady: małe badania z wynikiem nieistotnym rzadziej trafiają do publikacji. Porównanie 15 metaanaliz z prerejestrowanymi replikacjami wielolaboratoryjnymi tych samych efektów pokazało, że efekty metaanalityczne były średnio prawie trzykrotnie większe (Kvarven i in., 2020). Pełną procedurę opisuje poradnik jak wykonać metaanalizę.
Jak interpretować wielkość efektu?
- Zawsze z przedziałem ufności. Sama wartość punktowa ukrywa niepewność — w przykładzie d = 0,63 mogło oznaczać zarówno efekt mały, jak i duży.
- W odniesieniu do dziedziny. Progi Cohena są umowne. Funder i Ozer (2019) proponują dla psychologii progi r = 0,05 (bardzo mały), 0,10 (mały), 0,20 (średni) i 0,30 (duży), a wartości r ≥ 0,40 uznają za prawdopodobnie zawyżone; podkreślają też, że małe efekty mogą mieć duże znaczenie, gdy kumulują się w czasie lub dotyczą wielu osób. Schäfer i Schwarz (2019) pokazali, że mediana efektów w badaniach nieprerejestrowanych wynosiła r = 0,36, a w prerejestrowanych — tylko r = 0,16.
- W odniesieniu do najmniejszego efektu, który ma znaczenie (SESOI). Przed badaniem warto określić, jaki efekt byłby praktycznie istotny, i sprawdzić, czy przedział ufności go wyklucza lub obejmuje (Lakens i in., 2018; Anvari i Lakens, 2021).
- Z uwzględnieniem jakości badania. Efekty z małych, nieprerejestrowanych badań są często zawyżone: w dużym projekcie replikacyjnym efekty z replikacji były średnio o połowę mniejsze niż w badaniach oryginalnych (Open Science Collaboration, 2015).
Przelicznik wielkości efektu: d, r, iloraz szans
Przelicz jedną miarę wielkości efektu na inne
Wybierz, co znasz (d Cohena, statystykę t testu dla grup niezależnych, korelację r albo iloraz szans), i wpisz wartość. Liczebności grup są potrzebne do przeliczenia t oraz dokładniejszego przeliczenia d ↔ r.
Wpisz wartość i kliknij „Przelicz”. Kalkulator wymaga włączonej obsługi JavaScriptu.
Kalkulator stosuje te same wzory co pakiet effectsize w R: r = d / √(d² + h), gdzie h = (n₁ + n₂ − 2) / n₁ + (n₁ + n₂ − 2) / n₂ (bez liczebności h = 4), ln(OR) = d · π / √3 oraz d = t · √(1/n₁ + 1/n₂). Dla d = 0,633 i n = 42 w grupach daje r = 0,305 i OR = 3,153, tak jak R. Pełny kalkulator d z przedziałem ufności znajdziesz w haśle d Cohena.
Przykład w R
Pierwszy fragment liczy wielkość efektu w eksperymencie (dwie i trzy grupy), drugi — metaanalizę ośmiu badań. Wszystkie liczby w tekście, na rysunku i w kalkulatorze pochodzą z tych obliczeń.
Eksperyment: d Cohena, g Hedgesa, η² i ω²
R
library(effectsize)
# Eksperyment: manipulacja nastrojem (indukcja pozytywna vs neutralna), wynik: kreatywność (0–40)
set.seed(813)
grupa <- factor(rep(c("pozytywny", "neutralny"), each = 42), levels = c("pozytywny", "neutralny"))
wynik <- c(rnorm(42, 24.5, 6), rnorm(42, 21.5, 6))
t.test(wynik ~ grupa, var.equal = TRUE)
cohens_d(wynik ~ grupa)      # d z przedziałem ufności 95%
hedges_g(wynik ~ grupa)      # g: d z poprawką na małą próbę
# Trzy warunki eksperymentalne: eta² i omega² z jednoczynnikowej ANOVA
warunek <- factor(rep(c("pozytywny", "neutralny", "negatywny"), each = 42))
wynik3  <- c(wynik, rnorm(42, 19.5, 6))
model <- aov(wynik3 ~ warunek)
summary(model)
eta_squared(model, partial = FALSE)
omega_squared(model, partial = FALSE)
Wynik w R
	Two Sample t-test

data:  wynik by grupa
t = 2.9014, df = 82, p-value = 0.004769
alternative hypothesis: true difference in means between group pozytywny and group neutralny is not equal to 0
95 percent confidence interval:
 1.264110 6.778339
sample estimates:
mean in group pozytywny mean in group neutralny
               25.41750                21.39628

Cohen's d |       95% CI
------------------------
0.63      | [0.19, 1.07]

- Estimated using pooled SD.Hedges' g |       95% CI
------------------------
0.63      | [0.19, 1.06]

- Estimated using pooled SD.             Df Sum Sq Mean Sq F value   Pr(>F)
warunek       2    688   344.2   10.25 7.65e-05 ***
Residuals   123   4132    33.6
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type I)

Parameter | Eta2 |       95% CI
-------------------------------
warunek   | 0.14 | [0.05, 1.00]

- One-sided CIs: upper bound fixed at [1.00].# Effect Size for ANOVA (Type I)

Parameter | Omega2 |       95% CI
---------------------------------
warunek   |   0.13 | [0.04, 1.00]

- One-sided CIs: upper bound fixed at [1.00].
Metaanaliza: g Hedgesa i model efektów losowych
R
library(metafor)
# Osiem przykładowych badań tej samej manipulacji: średnie, SD i liczebności w grupach
bad <- data.frame(badanie = paste("Badanie", 1:8),
  m1 = c(26.4, 23.2, 27.9, 22.3, 26.6, 22.9, 27.0, 22.2), sd1 = c(6.2, 5.8, 6.9, 6.1, 5.5, 6.4, 6.0, 5.9), n1 = c(25, 40, 18, 60, 32, 85, 22, 120),
  m2 = c(21.2, 22.0, 21.5, 21.7, 21.9, 22.1, 20.9, 21.4), sd2 = c(6.0, 6.1, 6.6, 5.9, 5.8, 6.2, 6.3, 6.0), n2 = c(25, 38, 20, 58, 30, 86, 24, 118))
es  <- escalc(measure = "SMD", m1i = m1, sd1i = sd1, n1i = n1, m2i = m2, sd2i = sd2, n2i = n2, data = bad)  # g Hedgesa
res <- rma(yi, vi, data = es, method = "REML", slab = badanie)
res                       # efekt łączny, tau², I² i test heterogeniczności
predict(res)              # przedział ufności i przedział predykcji
Wynik w R
Random-Effects Model (k = 8; tau^2 estimator: REML)

tau^2 (estimated amount of total heterogeneity): 0.0979 (SE = 0.0806)
tau (square root of estimated tau^2 value):      0.3129
I^2 (total heterogeneity / total variability):   68.99%
H^2 (total variability / sampling variability):  3.23

Test for Heterogeneity:
Q(df = 7) = 19.5657, p-val = 0.0066

Model Results:

estimate      se    zval    pval   ci.lb   ci.ub
  0.4399  0.1382  3.1838  0.0015  0.1691  0.7108  **

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


   pred     se  ci.lb  ci.ub   pi.lb  pi.ub
 0.4399 0.1382 0.1691 0.7108 -0.2304 1.1103
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- metafor (wersja 5.0-1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Jak raportować wielkość efektu (APA)
Najczęstsze błędy
- Podawanie samej wartości p. „Wynik istotny” nie mówi nic o tym, czy efekt jest duży.
- Brak przedziału ufności. Przy małych próbach wartość punktowa jest bardzo niepewna.
- Mechaniczne stosowanie progów Cohena bez odniesienia do dziedziny i znaczenia praktycznego.
- Mieszanie wersji d (dla grup niezależnych, dz, dav) bez informacji, którą policzono — to uniemożliwia metaanalizę.
- Raportowanie cząstkowego η² jako „procentu wariancji wyjaśnianej przez czynnik” w złożonych schematach — cząstkowe η² z różnych schematów nie są porównywalne.
- Traktowanie efektu łącznego z metaanalizy jako „prawdziwego” efektu bez sprawdzenia heterogeniczności i efektu małych badań.
Najczęstsze pytania
Co to jest wielkość efektu?
Wielkość efektu (siła efektu, ang. effect size) to liczba, która mówi, jak duża jest różnica między grupami albo jak silny jest związek między zmiennymi. W przeciwieństwie do wartości p nie zależy od liczebności próby, dlatego pozwala ocenić praktyczne znaczenie wyniku i porównywać wyniki różnych badań.
Czym różni się wielkość efektu od istotności statystycznej?
Istotność (wartość p) mówi, czy wynik byłby mało prawdopodobny przy założeniu braku efektu, i silnie zależy od liczebności próby. Wielkość efektu mówi, jak duży jest efekt. Przy bardzo dużej próbie nawet znikomy efekt bywa istotny, a przy małej — duży efekt może być nieistotny.
Jaka wielkość efektu jest duża?
Według konwencji Cohena (1988) d = 0,20 to efekt mały, 0,50 — średni, a 0,80 — duży; dla korelacji r odpowiednio 0,10, 0,30 i 0,50. Sam Cohen traktował te progi jako ostateczność. Lepiej porównać wynik z efektami z wcześniejszych badań w danej dziedzinie i z najmniejszym efektem, który miałby znaczenie praktyczne.
Dlaczego metaanaliza opiera się na wielkościach efektu?
Bo badania używają różnych narzędzi i skal, więc ich surowych wyników nie da się bezpośrednio uśrednić. Wielkość efektu (np. g Hedgesa) sprowadza wyniki do wspólnej, standaryzowanej miary, którą można ważyć precyzją każdego badania i połączyć w efekt łączny.
Czy wielkość efektu trzeba raportować w pracy?
Tak. Standardy APA (Appelbaum i in., 2018) wymagają podawania wielkości efektu z przedziałami ufności dla głównych wyników. Ułatwia to interpretację, analizę mocy w kolejnych badaniach i włączenie wyników do metaanaliz.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wielkość efektu: jak ocenić znaczenie wyniku poza wartością p
Wielkość efektu wyjaśniona praktycznie: Cohen d, Hedges g, r, R², iloraz szans, eta², przedziały ufności i znaczenie praktyczne.
Czytaj →PoradnikMetaanaliza: jak rzetelnie połączyć wyniki wielu badań
Metaanaliza krok po kroku: pytanie badawcze, protokół, wyszukiwanie, wielkości efektu, heterogeniczność, model losowy i raport PRISMA 2020.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →PoradnikJak napisać przegląd literatury – z AI i bez
Rodzaje przeglądów, zapytania z operatorami Boole’a, selekcja, tabela ekstrakcji i macierz pojęć – oraz to, w czym AI pomaga, a w czym szkodzi.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikJak sprawdzić, czy AI nie zmyśliło bibliografii
Ile odwołań zmyślają modele językowe i jak w sześciu krokach sprawdzić każdą pozycję: DOI, Crossref, OpenAlex, abstrakt. Z przykładem, kodem R i checklistą.
Czytaj →PoradnikJak napisać dyskusję wyników – wzory zdań
Osiem elementów dyskusji z gotowymi zdaniami: interpretacja, wyniki nieistotne, konkretne ograniczenia, granice uogólniania, implikacje i wnioski.
Czytaj →PoradnikHipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →PoradnikPoprawki promotora w rozdziale wyników
15 najczęstszych uwag do rozdziału wyników z przykładami „przed → po”, wzorem tabeli poprawek do pobrania i wiadomością do promotora.
Czytaj →PoradnikPytania na obronie z metodologii i statystyki
38 pytań komisji o hipotezy, schemat, próbę, narzędzia, analizy i wyniki – z przykładowymi odpowiedziami, ściągą na jedną stronę i planem przygotowania.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →PoradnikP value krok po kroku
Jak powstaje wartość p: rozkład z prób, centralne twierdzenie graniczne, błąd standardowy, statystyka Z i pole pod krzywą – z przykładem i tablicą Z.
Czytaj →PoradnikPoprawki na wielokrotne porównania
Bonferroni, Holm, Hochberg, BH i BY na jednym przykładzie: co kontroluje każda poprawka, kiedy którą wybrać i jak opisać wynik w pracy.
Czytaj →PoradnikTest t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikTesty nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikStatystyka dla studenta
Po co statystyka na studiach, jak się jej uczyć w siedmiu etapach, które analizy są w pracach dyplomowych i gdzie szukać pomocy – z symulacją w R.
Czytaj →PoradnikOpis metod statystycznych w pracy
Jak napisać podrozdział „Analiza statystyczna”: program, przygotowanie danych, założenia, testy dla hipotez, poziom istotności, korekty i gotowe wzory zdań.
Czytaj →PoradnikKonwerter wielkości efektu
Przelicz t na d Cohena, d na r i iloraz szans, η² na f albo d na NNT. Wzory ze źródłami, przykład w R i gotowe zdania do pracy.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →PoradnikTesty statystyczne – przewodnik po wyborze
Schemat wyboru testu i osiem etapów od hipotezy do zapisu APA: test t, ANOVA, testy nieparametryczne, chi-kwadrat, korelacje, regresja i poprawki.
Czytaj →PoradnikWnioski i rekomendacje – jak napisać
Od wyniku do wniosku i rekomendacji: tabela śledzenia wniosków, siła zaleceń zależna od schematu badania, przykłady przesady i wzory zdań.
Czytaj →PoradnikCzy korelacja .30 to dużo?
Jak ocenić r = .30: konwencja Cohena a typowe korelacje w psychologii, R² = .09, przedział ufności przy różnej liczebności próby i wzór opisu APA.
Czytaj →PoradnikWynik istotny, ale efekt mały
Dlaczego przy dużej próbie słaby efekt daje p < .001, jak ocenić jego znaczenie praktyczne i jak go uczciwie opisać w pracy – przykład w R.
Czytaj →PoradnikEfekty skrzyżowane: uczestnicy × bodźce
Skrzyżowane efekty losowe osób i bodźców w lme4, maksymalna struktura, symulacja błędu I rodzaju, moc zależna od liczby bodźców i opis APA.
Czytaj →PoradnikKreator: jaki test statystyczny wybrać?
Kilka pytań o hipotezę, zmienną i układ badania, a w wyniku test główny, alternatywa, miara efektu i linki do poradnika oraz kalkulatora.
Czytaj →PoradnikWielkość efektu w testach nieparametrycznych
r = Z/√N, korelacja rangowo-biseryjna, delta Cliffa, A Varghi–Delaneya, ε² i W Kendalla: co mierzą, jak je przeliczać i podać z CI – z kodem R.
Czytaj →PoradnikPrezentacja wyników na obronie
Ile slajdów i liczb, wykres zamiast tabeli z SPSS, wynik nieistotny jako efekt z przedziałem ufności – z dwiema parami slajdów „źle / dobrze” zrobionych w R.
Czytaj →PoradnikAnaliza na małej próbie
Moc i szerokość CI przy 10–30 osobach, przeszacowane efekty, test permutacyjny, Fisher i bootstrap oraz wzór opisu ograniczenia – na pilotażu 10 + 10 w R.
Czytaj →PoradnikPodsumowanie wyników w pracy – jak napisać
Trzy miejsca podsumowania, różnica względem wniosków, tabela „hipoteza – test – wynik – werdykt”, wynik nieistotny i akapity wzorcowe dla trzech typów prac.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Sullivan, G. M., & Feinn, R. (2012). Using effect size—or why the P value is not enough. Journal of Graduate Medical Education, 4(3), 279–282. https://doi.org/10.4300/JGME-D-12-00156.1 ● Otwarty dostęp
- Funder, D. C., & Ozer, D. J. (2019). Evaluating effect size in psychological research: Sense and nonsense. Advances in Methods and Practices in Psychological Science, 2(2), 156–168. https://doi.org/10.1177/2515245919847202 ● Otwarty dostęp
- Schäfer, T., & Schwarz, M. A. (2019). The meaningfulness of effect sizes in psychological research: Differences between sub-disciplines and the impact of potential biases. Frontiers in Psychology, 10, Article 813. https://doi.org/10.3389/fpsyg.2019.00813 ● Otwarty dostęp
- Brysbaert, M. (2019). How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables. Journal of Cognition, 2(1), Article 16. https://doi.org/10.5334/joc.72 ● Otwarty dostęp
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963 ● Otwarty dostęp
- Anvari, F., & Lakens, D. (2021). Using anchor-based methods to determine the smallest effect size of interest. Journal of Experimental Social Psychology, 96, Article 104159. https://doi.org/10.1016/j.jesp.2021.104159 ● Otwarty dostęp
- Borenstein, M., Hedges, L. V., Higgins, J. P. T., & Rothstein, H. R. (2010). A basic introduction to fixed-effect and random-effects models for meta-analysis. Research Synthesis Methods, 1(2), 97–111. https://doi.org/10.1002/jrsm.12
- Kvarven, A., Strømland, E., & Johannesson, M. (2020). Comparing meta-analyses and preregistered multiple-laboratory replication projects. Nature Human Behaviour, 4(4), 423–434. https://doi.org/10.1038/s41562-019-0787-z
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), Article aac4716. https://doi.org/10.1126/science.aac4716 ● Otwarty dostęp: pełny tekst
- Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03 ● Otwarty dostęp
- Harrer, M., Cuijpers, P., Furukawa, T. A., & Ebert, D. D. (2021). Doing meta-analysis with R: A hands-on guide. Chapman & Hall/CRC. https://doi.org/10.1201/9781003107347 ● Otwarty dostęp: pełny tekst
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
Cytowania BibTeX
@article{lakens2013calculating, author={Lakens, Dani{\"e}l}, title={Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{sullivan2012using, author={Sullivan, Gail M. and Feinn, Richard}, title={Using effect size—or why the P value is not enough}, journal={Journal of Graduate Medical Education}, year={2012}, volume={4}, number={3}, pages={279--282}, doi={10.4300/JGME-D-12-00156.1}}@article{funder2019evaluating, author={Funder, David C. and Ozer, Daniel J.}, title={Evaluating effect size in psychological research: Sense and nonsense}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={2}, pages={156--168}, doi={10.1177/2515245919847202}}@article{schafer2019the, author={Sch{\"a}fer, Thomas and Schwarz, Marcus A.}, title={The meaningfulness of effect sizes in psychological research: Differences between sub-disciplines and the impact of potential biases}, journal={Frontiers in Psychology}, year={2019}, volume={10}, eid={813}, doi={10.3389/fpsyg.2019.00813}}@article{brysbaert2019how, author={Brysbaert, Marc}, title={How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables}, journal={Journal of Cognition}, year={2019}, volume={2}, number={1}, eid={16}, doi={10.5334/joc.72}}@article{lakens2018equivalence, author={Lakens, Dani{\"e}l and Scheel, Anne M. and Isager, Peder M.}, title={Equivalence testing for psychological research: A tutorial}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={259--269}, doi={10.1177/2515245918770963}}@article{anvari2021using, author={Anvari, Farid and Lakens, Dani{\"e}l}, title={Using anchor-based methods to determine the smallest effect size of interest}, journal={Journal of Experimental Social Psychology}, year={2021}, volume={96}, eid={104159}, doi={10.1016/j.jesp.2021.104159}}@article{borenstein2010a, author={Borenstein, Michael and Hedges, Larry V. and Higgins, Julian P. T. and Rothstein, Hannah R.}, title={A basic introduction to fixed-effect and random-effects models for meta-analysis}, journal={Research Synthesis Methods}, year={2010}, volume={1}, number={2}, pages={97--111}, doi={10.1002/jrsm.12}}@article{kvarven2020comparing, author={Kvarven, Amanda and Str{\o}mland, Eirik and Johannesson, Magnus}, title={Comparing meta-analyses and preregistered multiple-laboratory replication projects}, journal={Nature Human Behaviour}, year={2020}, volume={4}, number={4}, pages={423--434}, doi={10.1038/s41562-019-0787-z}}@article{opensciencecollaboration2015estimating, author={{Open Science Collaboration}}, title={Estimating the reproducibility of psychological science}, journal={Science}, year={2015}, volume={349}, number={6251}, eid={aac4716}, doi={10.1126/science.aac4716}}@article{viechtbauer2010conducting, author={Viechtbauer, Wolfgang}, title={Conducting meta-analyses in R with the metafor package}, journal={Journal of Statistical Software}, year={2010}, volume={36}, number={3}, pages={1--48}, doi={10.18637/jss.v036.i03}}@book{harrer2021doing, author={Harrer, Mathias and Cuijpers, Pim and Furukawa, Toshi A. and Ebert, David D.}, title={Doing Meta-Analysis with {R}: A Hands-On Guide}, publisher={Chapman \& Hall/CRC}, address={Boca Raton, FL}, year={2021}, doi={10.1201/9781003107347}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@book{cohen1988statistical, author={Cohen, Jacob}, title={Statistical Power Analysis for the Behavioral Sciences}, edition={2}, publisher={Lawrence Erlbaum Associates}, address={Hillsdale, NJ}, year={1988}, doi={10.4324/9780203771587}}