Co to jest korelacja?
Korelacja (ang. correlation) to współzmienność dwóch zmiennych: gdy jedna przyjmuje wyższe wartości, druga ma tendencję do przyjmowania wyższych (korelacja dodatnia) albo niższych wartości (korelacja ujemna). Kierunek i siłę tego związku opisuje współczynnik korelacji – liczba od −1 do +1. Wartości bliskie ±1 oznaczają silny związek, a wartości bliskie 0 – brak związku określonego typu, najczęściej liniowego.
Słowo „korelacja” nie wskazuje jednego wzoru, tylko całą rodzinę współczynników. Wybór zależy od skali pomiaru i kształtu związku. Schober i in. (2018) przypominają, że korelację Pearsona stosuje się zwykle do danych o rozkładzie zbliżonym do dwuwymiarowego normalnego, a przy danych porządkowych, nienormalnych lub z obserwacjami odstającymi – korelację rang Spearmana, która mierzy związek monotoniczny. Najczęściej używany współczynnik, r Pearsona, to kowariancja podzielona przez iloczyn odchyleń standardowych, czyli kowariancja wyrażona bez jednostek. Korelację jako miarę odróżnij też od schematu korelacyjnego – planu badania, w którym zmiennych się nie manipuluje, tylko je mierzy.
Rodzaje współczynników korelacji – który wybrać?
Tabela zbiera sytuacje najczęstsze w pracach z psychologii. Współczynniki z własnym hasłem w słowniku mają tam pełny opis, wzór i przykład.
| Zmienne i kształt związku | Współczynnik | Więcej |
|---|---|---|
| Dwie zmienne ilościowe, związek liniowy | r Pearsona | korelacja Pearsona |
| Dane porządkowe, związek monotoniczny, obserwacje odstające | ρ (rs) Spearmana | korelacja Spearmana |
| Dane porządkowe, mała próba, dużo rang wiązanych | τ Kendalla | korelacja tau Kendalla |
| Zmienna ilościowa i dychotomiczna (np. pracuje: tak/nie) | rpb punktowo-dwuseryjna | niżej |
| Dwie zmienne dychotomiczne | φ (phi) | niżej; V Craméra |
| Pozycje porządkowe (np. Likerta) jako przejaw ciągłej cechy ukrytej | korelacja polichoryczna (dla dwóch dychotomii – tetrachoryczna) | niżej |
| Zgodność ocen lub pomiarów tej samej cechy | ICC | ICC |
| Związek dwóch zmiennych po kontroli trzeciej | korelacja cząstkowa lub semicząstkowa | cząstkowa, semicząstkowa |
| Jedna zmienna a zestaw predyktorów | R wielokrotne | współczynnik determinacji |
Korelacja punktowo-dwuseryjna to zwykłe r Pearsona policzone dla zmiennej ilościowej i zmiennej dychotomicznej zakodowanej 0/1. Jej test jest tożsamy z testem t dla prób niezależnych z założeniem równych wariancji. W przykładzie z tego hasła praca zarobkowa w trakcie studiów korelowała ze stresem na poziomie rpb = .31, 95% CI [.18, .43], t(198) = 4.57. Test t porównujący osoby pracujące i niepracujące daje tę samą wartość statystyki – jej znak zależy tylko od kolejności grup.
Współczynnik φ (phi) to r Pearsona dla dwóch zmiennych 0/1; jego kwadrat równa się χ²/N z tabeli 2 × 2. Dla pracy zarobkowej i zaległych zaliczeń φ = .18, χ²(1) = 6.77, p = .009 (zob. test chi-kwadrat niezależności). Akoglu (2018) przypomina, że w tabelach większych niż 2 × 2 odpowiednikiem φ jest V Craméra.
Korelacja polichoryczna szacuje korelację między ciągłymi cechami ukrytymi, które – jak się zakłada – stoją za odpowiedziami na skali porządkowej. Dla dwóch pozycji skali 1–5 z przykładu r Pearsona wyniosło .45, a korelacja polichoryczna .50, bo podział odpowiedzi na kategorie zaniża zwykły współczynnik. Macierze korelacji polichorycznych stosuje się w analizie czynnikowej pozycji porządkowych, np. z estymatorem WLSMV.
Kierunek i siła korelacji
Znak współczynnika mówi o kierunku, a wartość bezwzględna – o tym, jak ściśle punkty na wykresie rozrzutu układają się wokół prostej (Pearson) albo wokół krzywej, która stale rośnie lub maleje (Spearman, Kendall). Rysunek 1 pokazuje korelacje różnej siły przy 100 obserwacjach.
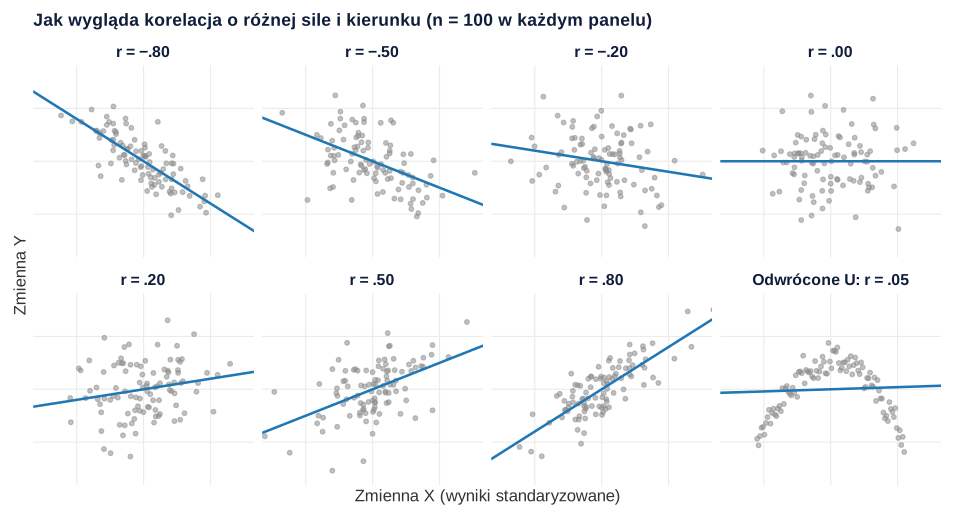
Z rysunku warto zapamiętać dwie rzeczy. Po pierwsze, korelacja .20 – typowa dla wielu związków w psychologii – jest na wykresie ledwie widoczna. Po drugie, r bliskie zera nie oznacza braku związku: w ostatnim panelu zależność jest silna, ale ma kształt odwróconego U, więc prosta jej nie opisuje.
Do opisu siły używa się konwencji, które jednak się różnią. Cohen (1992) uznał r = .10, .30 i .50 za efekt mały, średni i duży. Mukaka (2012) przytacza z kolei regułę kciuka, według której wartości od .30 do .50 to korelacja niska, a poniżej .30 – pomijalna. Akoglu (2018) zwraca uwagę, że różni autorzy różnie nazywają te same wartości współczynników. Dlatego podawaj liczbę z 95% przedziałem ufności, porównuj ją z wynikami podobnych badań i pamiętaj o r² – odsetku wspólnej wariancji (zob. wielkość efektu). Istotność statystyczna zależy przy tym od liczebności: przy α = .05 istotne jest już |r| ≥ .14 w próbie 200 osób, ale dopiero |r| ≥ .36 w próbie 30 osób. Istotna korelacja nie musi być silna.
Przykład: macierz korelacji pięciu zmiennych
Dwustu studentów (dane symulowane) wypełniło skale stresu (0–40), wsparcia społecznego (1–7), objawów lęku (0–21) i dobrostanu (0–25) oraz podało średnią liczbę godzin snu na dobę. Pięć zmiennych tworzy 10 par, a więc 10 korelacji – najwygodniej pokazać je w macierzy (rysunek 2).
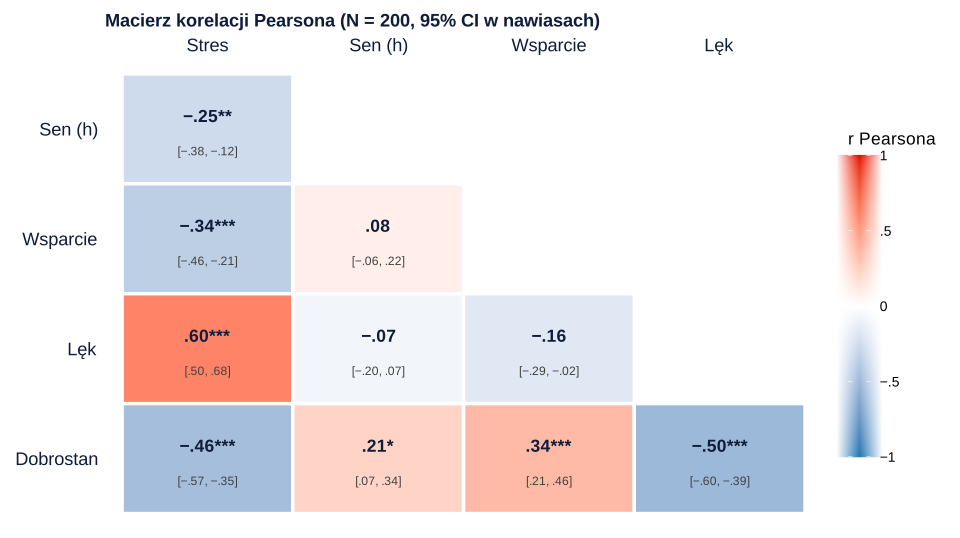
Najsilniej korelowały stres i lęk, r(198) = .60, 95% CI [.50, .68], p < .001, a najsilniej ujemnie – lęk i dobrostan, r(198) = −.50, 95% CI [−.60, −.39], p < .001. Długość snu nie była związana z lękiem, r(198) = −.07, 95% CI [−.20, .07]. Przy wielu testach rośnie ryzyko fałszywego alarmu, dlatego wartości p skorygowano metodą Holma (zob. korekta Bonferroniego). Zwróć uwagę na parę wsparcie–lęk: r = −.16 ma nieskorygowany 95% CI [−.29, −.02], który nie obejmuje zera, ale po korekcie p = .066. W opisie zaznacz więc, czego dotyczy korekta.
Ten sam związek różne współczynniki opisują nieco innymi liczbami. Dla stresu i snu r Pearsona wyniosło −.25, ρ Spearmana −.27, a τ Kendalla −.18. Tau jest liczbowo mniejsze, choć opisuje ten sam związek – nie oceniaj go według progów przyjętych dla r.
Korelacja a przyczynowość
Korelacja stresu ze snem (r = −.25) jest zgodna z co najmniej trzema wyjaśnieniami:
- stres → sen: napięcie utrudnia zasypianie;
- sen → stres: niewyspanie podnosi stres;
- wspólna przyczyna: praca zarobkowa w trakcie studiów może jednocześnie zwiększać stres i skracać sen. Związek wytworzony przez trzecią zmienną nazywamy korelacją pozorną, a samą tę zmienną – zmienną zakłócającą.
Rohrer (2018) pokazuje, jak porządkować takie sytuacje za pomocą graficznych modeli przyczynowych. Kontrola zmiennej zakłócającej, np. korelacją cząstkową albo w regresji, przybliża oszacowanie do efektu przyczynowego. Kontrolowanie mediatora albo tzw. zderzacza (ang. collider) – także pośrednio, przez badanie niereprezentatywnej próby – może je natomiast od niego oddalić. Wnioski przyczynowe z danych korelacyjnych zawsze opierają się na założeniach; najmocniejszą podstawę daje schemat eksperymentalny.
Jak opisać korelację w pracy (APA)
Napisz, jaki współczynnik obliczono, i podaj go ze stopniami swobody (N − 2), 95% przedziałem ufności i dokładnym p, bez zera przed kropką. Przy kilku korelacjach podaj metodę korekty, a całą macierz przedstaw w tabeli – wzór z M, SD i przedziałami ufności znajdziesz w haśle tabela korelacji w APA.
Korelacje w R
Kod tworzy dane z przykładu i liczy macierz korelacji Pearsona z przedziałami ufności i korektą Holma, trzy współczynniki dla jednej pary zmiennych, korelację punktowo-dwuseryjną, φ, korelację polichoryczną oraz najmniejsze istotne |r| dla różnych liczebności. Liczby w tekście i na rysunku 2 pochodzą z tego kodu.
Macierz korelacji i współczynniki dla różnych typów zmiennych
R
library(MASS)          # mvrnorm(): symulacja danych skorelowanych
library(correlation)   # macierz korelacji z 95% CI i korektą Holma
library(psych)         # polychoric(): korelacja polichoryczna

# Dane symulowane: 200 studentów; zmienne ukryte o zadanych korelacjach zamieniamy na wyniki skal
set.seed(82)
R <- matrix(c( 1.00, -0.30, -0.30,  0.60, -0.50,  0.25,  0.15,  0.50,  0.45,
              -0.30,  1.00,  0.10, -0.25,  0.30, -0.20,  0.00, -0.15, -0.15,
              -0.30,  0.10,  1.00, -0.25,  0.40,  0.00,  0.00, -0.20, -0.20,
               0.60, -0.25, -0.25,  1.00, -0.50,  0.10,  0.10,  0.45,  0.45,
              -0.50,  0.30,  0.40, -0.50,  1.00, -0.10, -0.10, -0.35, -0.35,
               0.25, -0.20,  0.00,  0.10, -0.10,  1.00,  0.30,  0.10,  0.10,
               0.15,  0.00,  0.00,  0.10, -0.10,  0.30,  1.00,  0.05,  0.05,
               0.50, -0.15, -0.20,  0.45, -0.35,  0.10,  0.05,  1.00,  0.55,
               0.45, -0.15, -0.20,  0.45, -0.35,  0.10,  0.05,  0.55,  1.00), 9)
Z <- mvrnorm(200, mu = rep(0, 9), Sigma = R)
dane <- data.frame(
  stres      = pmin(pmax(round(19 + 6 * Z[, 1]), 0), 40),            # skala 0–40
  sen        = pmin(pmax(round(6.9 + 0.9 * Z[, 2], 1), 4), 10),      # godziny snu na dobę
  wsparcie   = pmin(pmax(round(5.2 + 1.0 * Z[, 3], 2), 1), 7),       # skala 1–7
  lek        = pmin(pmax(round(7 + 4.2 * Z[, 4]), 0), 21),           # skala 0–21
  dobrostan  = pmin(pmax(round(13 + 4.8 * Z[, 5]), 0), 25),          # skala 0–25
  praca      = as.numeric(Z[, 6] > 0.25),                           # 1 = pracuje zarobkowo
  zaleglosci = as.numeric(Z[, 7] > 0.80),                           # 1 = ma zaległe zaliczenia
  pozycja1   = cut(Z[, 8], c(-Inf, -1.2, -0.3, 0.5, 1.3, Inf), labels = FALSE),   # odpowiedzi 1–5
  pozycja2   = cut(Z[, 9], c(-Inf, -0.9, 0.0, 0.8, 1.6, Inf), labels = FALSE))

# 1. Macierz korelacji Pearsona z 95% CI (p skorygowane metodą Holma dla 10 testów)
skale <- dane[, c("stres", "sen", "wsparcie", "lek", "dobrostan")]
round(cor(skale), 2)
kor <- correlation(skale, method = "pearson", p_adjust = "holm")
as.data.frame(kor)[, c("Parameter1", "Parameter2", "r", "CI_low", "CI_high", "t", "df_error", "p")]

# 2. Ta sama para zmiennych – trzy współczynniki
with(dane, c(pearson = cor(stres, sen), spearman = cor(stres, sen, method = "spearman"),
             kendall = cor(stres, sen, method = "kendall")))

# 3. Punktowo-dwuseryjna: zmienna 0/1 i ilościowa (= r Pearsona; ten sam test co t dla dwóch grup)
cor.test(dane$praca, dane$stres)
t.test(stres ~ praca, data = dane, var.equal = TRUE)$statistic

# 4. Phi: dwie zmienne 0/1 (= r Pearsona dla kodów 0/1; φ² = χ²/N)
tab <- table(praca = dane$praca, zaleglosci = dane$zaleglosci)
tab
phi <- cor(dane$praca, dane$zaleglosci)
chi <- chisq.test(tab, correct = FALSE)
round(c(phi = phi, chi2 = unname(chi$statistic), phi_z_chi2 = sqrt(unname(chi$statistic) / nrow(dane)), p = chi$p.value), 4)

# 5. Dwie pozycje Likerta (1–5): r Pearsona a korelacja polichoryczna
cor(dane$pozycja1, dane$pozycja2)
polychoric(dane[, c("pozycja1", "pozycja2")])$rho

# 6. Najmniejsze |r| istotne przy α = .05 (test dwustronny) dla różnych liczebności próby
N <- c(30, 100, 200, 1000)
t_kr <- qt(0.975, N - 2)
round(setNames(t_kr / sqrt(t_kr^2 + N - 2), N), 3)
Wynik w R
          stres   sen wsparcie   lek dobrostan
stres      1.00 -0.25    -0.34  0.60     -0.46
sen       -0.25  1.00     0.08 -0.07      0.21
wsparcie  -0.34  0.08     1.00 -0.16      0.34
lek        0.60 -0.07    -0.16  1.00     -0.50
dobrostan -0.46  0.21     0.34 -0.50      1.00
   Parameter1 Parameter2           r      CI_low     CI_high          t
1       stres        sen -0.25090915 -0.37654221 -0.11621369 -3.6472788
2       stres   wsparcie -0.34124550 -0.45828894 -0.21256848 -5.1083846
3       stres        lek  0.60140816  0.50478652  0.68314737 10.5922126
4       stres  dobrostan -0.46446705 -0.56669019 -0.34816180 -7.3799700
5         sen   wsparcie  0.08398778 -0.05539877  0.22016333  1.1860033
6         sen        lek -0.06549941 -0.20240112  0.07391328 -0.9236419
7         sen  dobrostan  0.21125206  0.07470047  0.34002711  3.0412153
8    wsparcie        lek -0.16183033 -0.29397096 -0.02361963 -2.3075716
9    wsparcie  dobrostan  0.34076958  0.21205422  0.45786340  5.1003235
10        lek  dobrostan -0.50181375 -0.59886079 -0.39024224 -8.1634033
   df_error            p
1       198 1.694140e-03
2       198 5.331966e-06
3       198 4.657487e-20
4       198 3.417758e-11
5       198 4.740845e-01
6       198 4.740845e-01
7       198 1.070061e-02
8       198 6.616959e-02
9       198 5.331966e-06
10      198 3.367456e-13
   pearson   spearman    kendall
-0.2509091 -0.2675453 -0.1822361

	Pearson's product-moment correlation

data:  dane$praca and dane$stres
t = 4.5701, df = 198, p-value = 8.569e-06
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.1777785 0.4292452
sample estimates:
      cor
0.3089004

        t
-4.570119
     zaleglosci
praca   0   1
    0 108  14
    1  58  20
       phi       chi2 phi_z_chi2          p
    0.1839     6.7666     0.1839     0.0093
[1] 0.449944
          pozycja1  pozycja2
pozycja1 1.0000000 0.4950335
pozycja2 0.4950335 1.0000000
   30   100   200  1000
0.361 0.197 0.139 0.062
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- correlation (wersja 0.8.8): Makowski, D., Ben-Shachar, M. S., Patil, I., & Lüdecke, D. (2020). Methods and algorithms for correlation analysis in R. Journal of Open Source Software, 5(51), 2306. https://doi.org/10.21105/joss.02306
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Współczynnik bez wykresu. To samo r może opisywać prostą, krzywą albo efekt jednej skrajnej obserwacji.
- „Brak korelacji” zamiast „brak związku liniowego”. Zależność w kształcie litery U albo odwróconego U może dać r bliskie zera (rysunek 1).
- Przyczynowy język w badaniu korelacyjnym – „stres obniża dobrostan” zamiast „wyższy stres wiązał się z niższym dobrostanem”.
- Siła oceniana po wartości p. W próbie 200 osób istotna jest już korelacja .14, która odpowiada 2% wspólnej wariancji.
- Duża macierz bez korekty albo z korektą, o której nie napisano.
- Dzielenie zmiennych ilościowych na kategorie, aby policzyć φ albo test chi-kwadrat – tracisz informację, a współczynnik maleje.
Najczęstsze pytania
Co to jest korelacja?
Korelacja to związek dwóch zmiennych polegający na tym, że ich wartości zmieniają się razem: przy korelacji dodatniej wyższym wynikom jednej zmiennej towarzyszą zwykle wyższe wyniki drugiej, a przy ujemnej – niższe. Współczynnik korelacji przyjmuje wartości od −1 do +1; im dalej od zera, tym silniejszy związek.
Jaki współczynnik korelacji wybrać?
Dla dwóch zmiennych ilościowych i związku liniowego – r Pearsona. Dla danych porządkowych, związków monotonicznych i wyników z obserwacjami odstającymi – ρ Spearmana albo τ Kendalla. Dla zmiennej dychotomicznej i ilościowej – r punktowo-dwuseryjną, a dla dwóch dychotomicznych – φ.
Jak opisać siłę korelacji w pracy?
Według konwencji Cohena r = .10, .30 i .50 to efekt mały, średni i duży, ale inne reguły nazywają te same wartości inaczej. Podawaj współczynnik z 95% przedziałem ufności i porównuj go z wynikami podobnych badań, zamiast opierać się wyłącznie na etykiecie.
Czy z samej korelacji można wnioskować o przyczynie?
Nie. Korelacja jest zgodna z kilkoma wyjaśnieniami: X wpływa na Y, Y wpływa na X albo obie zmienne zależą od trzeciej (korelacja pozorna). Wnioski przyczynowe wymagają planu eksperymentalnego albo jawnych założeń i kontroli zmiennych zakłócających.
Jak zapisać korelację w APA?
Podaj rodzaj współczynnika, jego wartość ze stopniami swobody (N − 2), 95% CI i p, bez zera przed kropką, np. r(198) = .60, 95% CI [.50, .68], p < .001. Wiele korelacji zbierz w macierzy według wzoru tabeli korelacji w APA.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Korelacja Pearsona i Spearmana krok po kroku
Wybór miary, wykres rozrzutu, przedział ufności z transformacji Fishera, siła r, korelacja cząstkowa, macierz w APA i opis wyników z kodem R.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Akoglu, H. (2018). User's guide to correlation coefficients. Turkish Journal of Emergency Medicine, 18(3), 91–93. https://doi.org/10.1016/j.tjem.2018.08.001 ● Otwarty dostęp
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Mukaka, M. M. (2012). Statistics corner: A guide to appropriate use of correlation coefficient in medical research. Malawi Medical Journal, 24(3), 69–71. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC3576830/ ● Otwarty dostęp
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Schober, P., Boer, C., & Schwarte, L. A. (2018). Correlation coefficients: Appropriate use and interpretation. Anesthesia & Analgesia, 126(5), 1763–1768. https://doi.org/10.1213/ANE.0000000000002864 ● Otwarty dostęp
Cytowania BibTeX
@article{akoglu2018users, author={Akoglu, Haldun}, title={{User's guide to correlation coefficients}}, journal={Turkish Journal of Emergency Medicine}, year={2018}, volume={18}, number={3}, pages={91--93}, doi={10.1016/j.tjem.2018.08.001}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{mukaka2012guide, author={Mukaka, M. M.}, title={{Statistics corner: A guide to appropriate use of correlation coefficient in medical research}}, journal={Malawi Medical Journal}, year={2012}, volume={24}, number={3}, pages={69--71}, url={https://www.ncbi.nlm.nih.gov/pmc/articles/PMC3576830/}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{schober2018correlation, author={Schober, Patrick and Boer, Christa and Schwarte, Lothar A.}, title={{Correlation coefficients: Appropriate use and interpretation}}, journal={Anesthesia \& Analgesia}, year={2018}, volume={126}, number={5}, pages={1763--1768}, doi={10.1213/ane.0000000000002864}}