Co to jest korelacja semicząstkowa?
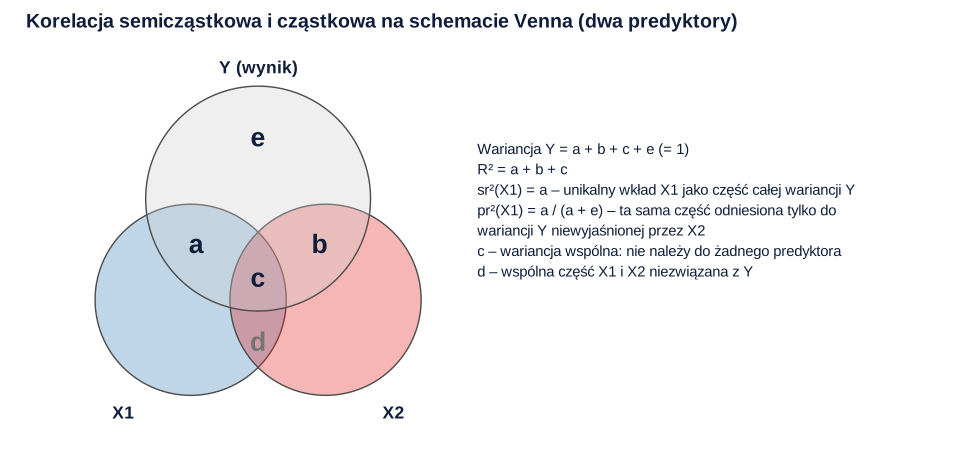
Korelacja semicząstkowa (ang. semipartial correlation albo part correlation; oznaczenie sr) to korelacja zmiennej zależnej Y z tą częścią predyktora X1, której nie wyjaśniają pozostałe predyktory. Wpływ innych zmiennych usuwa się więc tylko z predyktora, a Y zostaje w całości. Tym różni się od korelacji cząstkowej, która „oczyszcza” obie zmienne.
Najważniejsze zastosowanie ma kwadrat tej korelacji. sr² to odsetek całej wariancji Y, który wyjaśnia wyłącznie dany predyktor – o tyle spadłoby R², gdyby usunąć go z modelu. Dlatego sr² służy do opisu unikalnego wkładu predyktorów w regresji wielorakiej i do oceny przyrostu ΔR² w regresji hierarchicznej. W SPSS korelacje semicząstkowe pokazuje kolumna part w tabeli współczynników regresji.
Wzór i interpretacja sr²
Dla dwóch predyktorów korelację semicząstkową X1 liczy się z trzech zwykłych korelacji:
W mianowniku jest tylko √(1 − r12²), bo wpływ X2 usuwa się wyłącznie z X1; w korelacji cząstkowej dochodzi jeszcze czynnik √(1 − rY2²). Przy dowolnej liczbie predyktorów najprościej skorzystać z różnicy dwóch modeli:
Test istotności sr jest tym samym testem co test t dla współczynnika b tego predyktora w pełnym modelu. Różnicę między sr² i pr² najłatwiej zobaczyć na schemacie Venna (rysunek 1): obie miary mają w liczniku ten sam unikalny fragment a, ale sr² odnosi go do całej wariancji Y, a pr² – tylko do wariancji, której nie wyjaśnia drugi predyktor. Dlatego korelacja cząstkowa jest co do wartości bezwzględnej zawsze co najmniej tak duża jak semicząstkowa.
Przykład: co wyjaśnia satysfakcję z życia?
220 dorosłych (dane symulowane) wypełniło skalę satysfakcji z życia (5–35 pkt; M = 22.50, SD = 5.71) oraz miary wsparcia społecznego (1–7), samotności (20–80) i optymizmu (0–24). Wszystkie trzy predyktory korelowały z satysfakcją (od |r| = .42 do .53), ale także ze sobą (od |r| = .29 do .44). Model regresji z trzema predyktorami wyjaśniał 38.7% wariancji satysfakcji, R² = .387, skorygowane R² = .379, F(3, 216) = 45.52, p < .001 (tabela 1).
Tabela 1
Regresja wieloraka satysfakcji z życia z korelacjami zerowego rzędu i kwadratami korelacji semicząstkowych
| Predyktor | b | SE | β | t | p | r | sr² |
|---|---|---|---|---|---|---|---|
| Stała | 20.84 | 3.13 | — | 6.66 | < .001 | — | — |
| Wsparcie społeczne | 1.35 | 0.37 | 0.22 | 3.69 | < .001 | .45 | .039 |
| Samotność | −0.22 | 0.04 | −0.36 | −5.78 | < .001 | −.53 | .095 |
| Optymizm | 0.32 | 0.08 | 0.23 | 4.05 | < .001 | .42 | .047 |
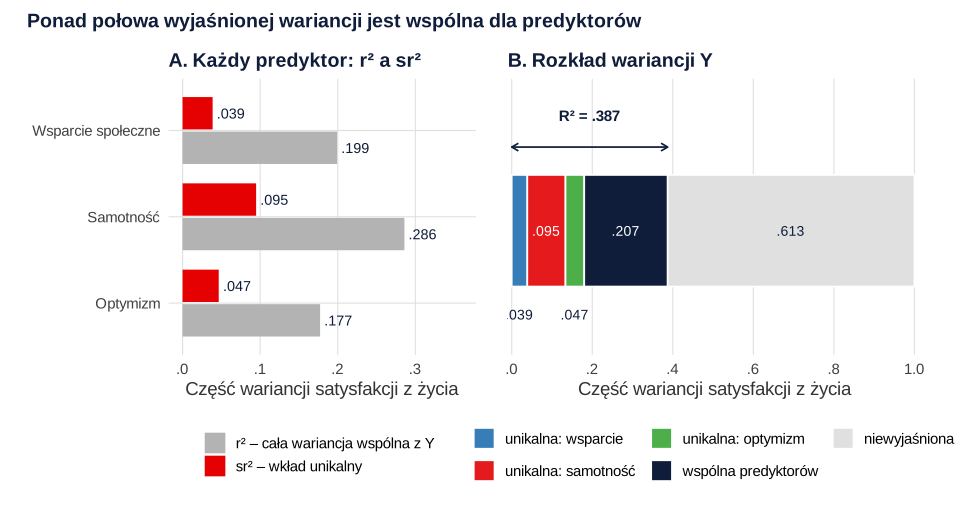
Uwaga. N = 220. R² = .387, skorygowane R² = .379, F(3, 216) = 45.52, p < .001. r = korelacja zerowego rzędu z satysfakcją z życia; sr² = kwadrat korelacji semicząstkowej (unikalny wkład predyktora). Suma sr² wynosi .180; pozostałe .207 wyjaśnianej wariancji jest wspólne dla predyktorów.
Najwięcej unikalnej wariancji wnosiła samotność: sr = −.31, czyli sr² = .095 – sama wyjaśniała 9.5% zmienności satysfakcji. Jej kwadrat korelacji zerowego rzędu wynosił jednak .286, więc większość związku samotności z satysfakcją dzieliła ze wsparciem i optymizmem. Wsparcie społeczne wnosiło unikalnie 3.9% (sr = .20), a optymizm 4.7% (sr = .22). Korelacje cząstkowe były wyższe (odpowiednio −.37, .24 i .27), bo odnoszą unikalną część do wariancji satysfakcji, której nie wyjaśniają pozostałe predyktory.
Najważniejszy wniosek daje suma: unikalne wkłady to razem .180, a R² = .387. Ponad połowa wyjaśnianej wariancji (53.5%) jest wspólna i nie da się jej przypisać żadnemu predyktorowi (rysunek 2). Gdy predyktory są skorelowane, suma sr² jest mniejsza od R² – tylko przy predyktorach zupełnie nieskorelowanych obie wielkości są równe.
Korelacja semicząstkowa, cząstkowa i β
| Miara | Z czego usuwa się pozostałe predyktory | Co mówi |
|---|---|---|
| Korelacja semicząstkowa sr | Tylko z predyktora | sr² – jaka część całej wariancji Y przypada wyłącznie na ten predyktor |
| Korelacja cząstkowa pr | Z predyktora i z Y | Siła związku przy stałych pozostałych predyktorach, na tle niewyjaśnionej wariancji Y |
| Współczynnik β | Kontroluje pozostałe predyktory w modelu | O ile odchyleń standardowych zmienia się Y przy wzroście predyktora o 1 SD; to nie jest udział w wariancji |
Nathans i in. (2012) zwracają uwagę, że interpretacja regresji zbyt często opiera się wyłącznie na wagach β, i proponują przewodnik po uzupełniających się miarach ważności predyktorów. Kraha i in. (2012) opisują analizę wspólności (ang. commonality analysis), która rozkłada R² na części unikalne i wspólne, a ujemne współczynniki wspólności traktują jako sygnał supresji. Velicer (1978) zaproponował definicję supresji opartą na relacji korelacji semicząstkowej do korelacji zerowego rzędu – w naszym przykładzie każda korelacja semicząstkowa ma ten sam znak co zwykła i jest od niej mniejsza co do wartości bezwzględnej, więc nic nie wskazuje na supresję. Jeśli chcesz podzielić całe R² między predyktory, sr² nie wystarczy; Johnson i LeBreton (2004) jako najlepsze dostępne miary ważności względnej wskazują analizę dominacji i wagi względne.
Jak opisać korelację semicząstkową w pracy (APA)
Podaj sr² w tabeli regresji (jak w tabeli 1) i opisz w tekście unikalny wkład najważniejszych predyktorów oraz część wspólną. Wzór dla przykładu:
Ogólne zasady budowy takiej tabeli znajdziesz w haśle tabela regresji w APA, a cały tok analizy – w poradniku regresja wieloraka krok po kroku.
Przykład w R
Kod szacuje model z trzema predyktorami, liczy korelacje semicząstkowe z reszt, ich kwadraty jako spadek R² po usunięciu predyktora, korelacje cząstkowe i część wspólną, a na końcu sprawdza wynik funkcją spcor() z pakietu ppcor (Kim, 2015). W SPSS: Analiza → Regresja → Liniowa, a w oknie Statystyki zaznacz korelacje cząstkowe i semicząstkowe – tabela „Współczynniki” pokaże korelację zerowego rzędu, cząstkową i semicząstkową (w angielskiej wersji: Zero-order, Partial, Part); sr² to kwadrat ostatniej z nich.
Korelacje semicząstkowe i rozkład R²
R
# Wsparcie społeczne, samotność, optymizm i satysfakcja z życia. Dane symulowane, N = 220
library(MASS)     # mvrnorm()
library(ppcor)    # spcor(), pcor()
set.seed(145)
R <- matrix(c( 1,   .45, -.50,  .40,
              .45,  1,   -.45,  .30,
             -.50, -.45,  1,   -.35,
              .40,  .30, -.35,  1), 4, byrow = TRUE)
z <- mvrnorm(220, mu = rep(0, 4), Sigma = R)
dane <- data.frame(satysfakcja = pmin(35, pmax(5, round(23 + 6 * z[, 1]))),      # 5–35 pkt
                   wsparcie    = pmin(7, pmax(1, round(5.2 + 1.1 * z[, 2], 2))),  # 1–7
                   samotnosc   = pmin(80, pmax(20, round(42 + 10 * z[, 3]))),     # 20–80 pkt
                   optymizm    = pmin(24, pmax(0, round(14 + 4 * z[, 4]))))       # 0–24 pkt
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(dane), 3)

model <- lm(satysfakcja ~ wsparcie + samotnosc + optymizm, data = dane)
summary(model)
R2 <- summary(model)$r.squared
pred <- c("wsparcie", "samotnosc", "optymizm")
beta <- coef(lm(satysfakcja ~ ., data = as.data.frame(scale(dane))))[pred]

# Korelacja semicząstkowa: korelacja Y z tą częścią predyktora, której nie wyjaśniają pozostałe predyktory
sr <- sapply(pred, function(v) cor(dane$satysfakcja, resid(lm(reformulate(setdiff(pred, v), v), data = dane))))
# sr² = spadek R² po usunięciu predyktora z modelu, czyli jego unikalny wkład
dR2 <- sapply(pred, function(v) R2 - summary(lm(reformulate(setdiff(pred, v), "satysfakcja"), data = dane))$r.squared)
# Korelacja cząstkowa: predyktor i Y oczyszczone z pozostałych predyktorów
pr <- pcor(dane)$estimate["satysfakcja", pred]
round(rbind(r = cor(dane)["satysfakcja", pred], beta = beta, sr = sr, sr2 = sr^2, dR2 = dR2, pr = pr, pr2 = pr^2), 3)
round(c(R2 = R2, suma_sr2 = sum(sr^2), wspolna = R2 - sum(sr^2), odsetek_wspolnej = (R2 - sum(sr^2)) / R2), 3)

# To samo w pakiecie ppcor: wiersz satysfakcja, predyktor oczyszczony z pozostałych predyktorów
round(spcor(dane)$estimate["satysfakcja", pred], 3)
Wynik w R
   satysfakcja wsparcie samotnosc optymizm
M        22.50     4.99     42.83    13.59
SD        5.71     0.94      9.20     4.16
            satysfakcja wsparcie samotnosc optymizm
satysfakcja       1.000    0.446    -0.535    0.421
wsparcie          0.446    1.000    -0.442    0.288
samotnosc        -0.535   -0.442     1.000   -0.348
optymizm          0.421    0.288    -0.348    1.000

Call:
lm(formula = satysfakcja ~ wsparcie + samotnosc + optymizm, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-14.8425  -2.7299  -0.1289   2.9953  10.2674

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 20.84095    3.12904   6.660 2.23e-10 ***
wsparcie     1.35086    0.36561   3.695 0.000279 ***
samotnosc   -0.22037    0.03812  -5.781 2.58e-08 ***
optymizm     0.31979    0.07890   4.053 7.06e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 4.499 on 216 degrees of freedom
Multiple R-squared:  0.3873,	Adjusted R-squared:  0.3788
F-statistic: 45.52 on 3 and 216 DF,  p-value: < 2.2e-16

     wsparcie samotnosc optymizm
r       0.446    -0.535    0.421
beta    0.222    -0.355    0.233
sr      0.197    -0.308    0.216
sr2     0.039     0.095    0.047
dR2     0.039     0.095    0.047
pr      0.244    -0.366    0.266
pr2     0.059     0.134    0.071
              R2         suma_sr2          wspolna odsetek_wspolnej
           0.387            0.180            0.207            0.535
 wsparcie samotnosc  optymizm
    0.197    -0.308     0.216
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; dane wygenerowano funkcją mvrnorm() z pakietu MASS, korelacje sprawdzono w pakiecie ppcor, a rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ppcor (wersja 1.1): Kim, S. (2015). ppcor: An R package for a fast calculation to semi-partial correlation coefficients. Communications for Statistical Applications and Methods, 22(6), 665–674. https://doi.org/10.5351/CSAM.2015.22.6.665
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Sumowanie sr² i traktowanie wyniku jako R². Przy skorelowanych predyktorach suma unikalnych wkładów jest mniejsza od R² – w przykładzie .180 wobec .387.
- Utożsamianie β² z udziałem w wariancji. Kwadrat współczynnika β nie jest ani sr², ani r²; przy współliniowości β może nawet przekraczać 1.
- Mylenie part z partial w wydruku SPSS. Do opisu unikalnego wkładu w wariancję Y służy part (semicząstkowa), a nie partial (cząstkowa).
- Wniosek „predyktor jest nieważny”, bo ma małe sr². Mały unikalny wkład może oznaczać, że predyktor dzieli wariancję z innymi, a nie że nie wiąże się z wynikiem – samotność miała r² = .286 i tylko .095 unikalnie.
- Interpretacja przyczynowa unikalnego wkładu. sr² opisuje podział wariancji w danym modelu i zmienia się po dodaniu lub usunięciu predyktorów.
Najczęstsze pytania
Co to jest korelacja semicząstkowa?
To korelacja zmiennej zależnej Y z „oczyszczoną” częścią predyktora – tą, której nie wyjaśniają pozostałe predyktory w modelu. Wpływ innych zmiennych usuwa się tylko z predyktora, a nie z Y. W SPSS nazywa się ją korelacją części (part).
Jak interpretować sr² w regresji?
sr² to odsetek całej wariancji Y, który wyjaśnia wyłącznie dany predyktor – tyle straciłoby R², gdyby usunąć go z modelu. Na przykład sr² = .095 oznacza, że predyktor unikalnie wyjaśnia 9.5% zmienności wyniku, niezależnie od pozostałych predyktorów.
Czym różni się korelacja semicząstkowa od cząstkowej?
Korelacja cząstkowa usuwa wpływ pozostałych predyktorów z obu zmiennych, a semicząstkowa – tylko z predyktora. Obie mają ten sam licznik, ale sr² odnosi unikalną wariancję do całej wariancji Y, a pr² – tylko do wariancji niewyjaśnionej przez inne predyktory. Dlatego korelacja cząstkowa jest zawsze co najmniej tak duża jak semicząstkowa.
Dlaczego suma sr² jest mniejsza niż R²?
Bo skorelowane predyktory wyjaśniają część wariancji Y wspólnie, a ta wspólna część nie trafia do sr² żadnego z nich. W przykładzie z tego hasła suma sr² wynosiła .180, a R² = .387 – ponad połowa wyjaśnianej wariancji była wspólna. Suma sr² równa się R² tylko przy nieskorelowanych predyktorach.
Jak policzyć korelację semicząstkową w SPSS i R?
W SPSS: Analiza → Regresja → Liniowa → Statystyki → zaznacz korelacje cząstkowe i semicząstkowe; sr to kolumna part, a sr² – jej kwadrat. W R: ppcor::spcor() albo różnica R² modelu pełnego i modelu bez danego predyktora.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikWielkość efektu: jak ocenić znaczenie wyniku poza wartością p
Wielkość efektu wyjaśniona praktycznie: Cohen d, Hedges g, r, R², iloraz szans, eta², przedziały ufności i znaczenie praktyczne.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Johnson, J. W., & LeBreton, J. M. (2004). History and use of relative importance indices in organizational research. Organizational Research Methods, 7(3), 238–257. https://doi.org/10.1177/1094428104266510
- Kim, S. (2015). ppcor: An R package for a fast calculation to semi-partial correlation coefficients. Communications for Statistical Applications and Methods, 22(6), 665–674. https://doi.org/10.5351/csam.2015.22.6.665 ● Otwarty dostęp
- Kraha, A., Turner, H., Nimon, K., Zientek, L. R., & Henson, R. K. (2012). Tools to support interpreting multiple regression in the face of multicollinearity. Frontiers in Psychology, 3, Article 44. https://doi.org/10.3389/fpsyg.2012.00044 ● Otwarty dostęp
- Nathans, L. L., Oswald, F. L., & Nimon, K. (2012). Interpreting multiple linear regression: A guidebook of variable importance. Practical Assessment, Research, and Evaluation, 17, Article 9. https://doi.org/10.7275/5fex-b874 ● Otwarty dostęp: pełny tekst
- Velicer, W. F. (1978). Suppressor variables and the semipartial correlation coefficient. Educational and Psychological Measurement, 38(4), 953–958. https://doi.org/10.1177/001316447803800415
Cytowania BibTeX
@article{johnson2004history, author={Johnson, Jeff W. and LeBreton, James M.}, title={{History and use of relative importance indices in organizational research}}, journal={Organizational Research Methods}, year={2004}, volume={7}, number={3}, pages={238--257}, doi={10.1177/1094428104266510}}@article{kim2015ppcor, author={Kim, Seongho}, title={{ppcor: An R package for a fast calculation to semi-partial correlation coefficients}}, journal={Communications for Statistical Applications and Methods}, year={2015}, volume={22}, number={6}, pages={665--674}, doi={10.5351/csam.2015.22.6.665}}@article{kraha2012tools, author={Kraha, Amanda and Turner, Heather and Nimon, Kim and Zientek, Linda Reichwein and Henson, Robin K.}, title={{Tools to support interpreting multiple regression in the face of multicollinearity}}, journal={Frontiers in Psychology}, year={2012}, volume={3}, eid={44}, doi={10.3389/fpsyg.2012.00044}}@article{nathans2012interpreting, author={Nathans, Laura L. and Oswald, Frederick L. and Nimon, Kim}, title={{Interpreting multiple linear regression: A guidebook of variable importance}}, journal={Practical Assessment, Research, and Evaluation}, year={2012}, volume={17}, eid={9}, doi={10.7275/5fex-b874}}@article{velicer1978suppressor, author={Velicer, Wayne F.}, title={{Suppressor variables and the semipartial correlation coefficient}}, journal={Educational and Psychological Measurement}, year={1978}, volume={38}, number={4}, pages={953--958}, doi={10.1177/001316447803800415}}