Co to jest korelacja cząstkowa?
Korelacja cząstkowa (ang. partial correlation) to korelacja Pearsona między dwiema zmiennymi X i Y po usunięciu z obu z nich liniowego wpływu trzeciej zmiennej Z (albo kilku zmiennych). Zapisuje się ją jako rXY·Z. Odpowiada na pytanie: czy X i Y nadal są ze sobą związane, gdy porównujemy osoby o takim samym poziomie Z?
W psychologii korelację cząstkową stosuje się, gdy podejrzewasz, że związek dwóch zmiennych częściowo wynika ze wspólnej przyczyny – zmiennej zakłócającej. Zwykłą korelację nazywa się wtedy korelacją zerowego rzędu, a korelację z kontrolą jednej zmiennej – korelacją cząstkową pierwszego rzędu. Na korelacjach cząstkowych opiera się też analiza sieci: Epskamp i Fried (2018) opisują sieć korelacji cząstkowych jako najpopularniejszy model sieciowy dla danych psychologicznych, w którym każda krawędź to związek dwóch zmiennych przy kontroli wszystkich pozostałych.
Wzór i logika korelacji cząstkowej
Dla jednej zmiennej kontrolowanej korelację cząstkową można policzyć z trzech zwykłych korelacji:
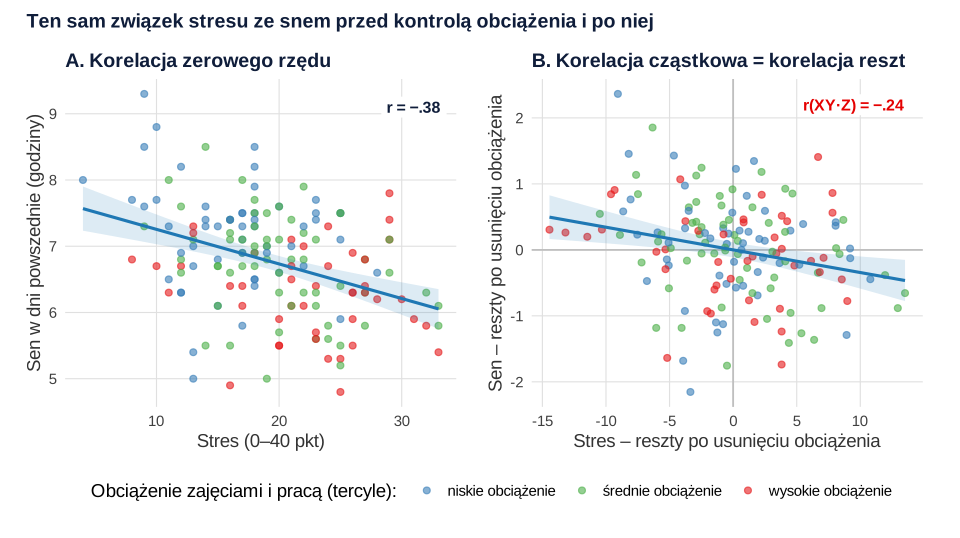
Licznik odejmuje od korelacji X i Y tę jej część, której można się spodziewać z samych związków obu zmiennych z Z. Ten sam wynik daje procedura na resztach regresji: przewiduj X z Z, przewiduj Y z Z, a potem skoreluj obie serie reszt. Reszty to części X i Y, których Z nie wyjaśnia – dlatego korelacja cząstkowa jest korelacją reszt. Przy kilku zmiennych kontrolowanych liczy się ją z macierzy korelacji; pakiet R ppcor (Kim, 2015) liczy korelacje cząstkowe i semicząstkowe dowolnego rzędu razem z testem istotności.
Istotność sprawdza się testem t z n − 2 − k stopniami swobody, gdzie k to liczba kontrolowanych zmiennych, a przedział ufności – transformacją Fishera z błędem standardowym 1/√(n − 3 − k).
Przykład: stres i sen przy kontroli obciążenia zajęciami
160 studentów (dane symulowane) podało tygodniową liczbę godzin zajęć i pracy zarobkowej (M = 37.77, SD = 9.14), wypełniło skalę stresu (0–40 pkt; M = 19.42, SD = 5.93) i oceniło, ile śpi w dni powszednie (M = 6.76 h, SD = 0.82). Bardziej zestresowani studenci spali krócej, r(158) = −.38, 95% CI [−.50, −.23], p < .001. Obciążenie wiązało się jednak z obiema zmiennymi: z większym stresem (r = .44) i z krótszym snem (r = −.40). Osoby z najniższym obciążeniem (10–34 h tygodniowo) miały średnio 16.28 pkt stresu i spały 7.18 h, a osoby z najwyższym (44–59 h) – 22.32 pkt i 6.30 h.
Po podstawieniu do wzoru:
Po kontroli obciążenia związek stresu ze snem osłabł z −.38 do −.24, 95% CI [−.38, −.09], ale pozostał istotny, t(157) = −3.14, p = .002. Część wspólnej zmienności stresu i snu wynikała więc z tego, że obie zmienne zależą od obciążenia, ale nie cała. Rysunek 1 pokazuje to na wykresach rozrzutu.
Korelacja cząstkowa, semicząstkowa i regresja
Korelacja cząstkowa usuwa Z z obu zmiennych. Korelacja semicząstkowa usuwa Z tylko z jednej z nich – w przykładzie z samego stresu, i wynosi −.22. Pierwsza mówi o związku X i Y przy stałym Z, druga – o tym, jaką część całej zmienności Y wyjaśnia unikalna część X; ta druga wchodzi w rozkład R² w regresji wielorakiej.
Korelacja cząstkowa i współczynnik regresji testują tę samą hipotezę. W modelu sen ~ stres + obciążenie statystyka t dla stresu wynosi −3.14, tyle samo co test korelacji cząstkowej. Regresja daje dodatkowo nachylenie w jednostkach skali (tu −0.034 h snu na punkt stresu), a korelacja cząstkowa – miarę siły związku od −1 do 1, którą łatwo zestawić z innymi korelacjami.
Co kontrolować, a czego nie
Korelacja cząstkowa daje sensowny wynik tylko wtedy, gdy Z rzeczywiście jest wspólną przyczyną X i Y. Rohrer (2018) przypomina, że dwóch rodzajów zmiennych nie należy kontrolować: mediatorów (zmiennych, przez które X wpływa na Y) i wspólnych skutków X i Y (ang. colliders), bo taka kontrola oddala wynik od interesującego efektu. Gdyby obciążenie było skutkiem stresu, a nie jego przyczyną, kontrolowanie go usunęłoby część efektu, który chcesz zbadać. Spector i Brannick (2011) nazywają automatyczne dorzucanie zmiennych kontrolnych „miejską legendą metodologiczną” i zalecają, by każdą z nich uzasadnić hipotezą.
Drugi problem to błąd pomiaru zmiennej kontrolowanej. Kontrolujesz zmierzony wynik Z, a nie prawdziwy poziom cechy, więc część zakłócenia zostaje. W symulacji Westfalla i Yarkoniego (2016) kontrola zmiennej o rzetelności .40 pozostawiała fałszywą, istotną korelację cząstkową w 92% powtórzeń, a fałszywe wnioski o „przyrostowej” roli predyktora były najczęstsze przy dużych próbach i umiarkowanej rzetelności. Trzecie ograniczenie dotyczy kształtu związków: korelacja cząstkowa usuwa tylko liniowy wpływ Z, a jej zerowa wartość oznacza warunkową niezależność X i Y tylko przy wielowymiarowym rozkładzie normalnym (Baba i in., 2004).
Jak opisać korelację cząstkową w pracy (APA)
Podaj korelację zerowego rzędu, nazwij kontrolowaną zmienną, a przy korelacji cząstkowej podaj stopnie swobody (n − 2 − k), 95% CI i p. Wzór dla przykładu:
Jeśli raportujesz wiele korelacji, umieść je w tabeli – wzór znajdziesz w haśle tabela korelacji w APA; korelacje cząstkowe oznacz wtedy w nocie.
Przykład w R
Kod liczy korelację cząstkową trzema sposobami – ze wzoru, z reszt regresji i funkcją partial.r() z pakietu psych – a następnie test t, przedział ufności i porównanie z regresją. W SPSS: Analiza → Korelacje → Cząstkowe; stres i sen wpisz jako zmienne, obciążenie – jako zmienną kontrolowaną, a w Opcjach zaznacz korelacje zerowego rzędu, by zobaczyć obie macierze obok siebie.
Korelacja cząstkowa: wzór, reszty i pakiet psych
R
# Stres, długość snu i obciążenie zajęciami. Dane symulowane, N = 160
library(MASS)     # mvrnorm()
library(psych)    # partial.r()
set.seed(1044)
R <- matrix(c(1, -.40, .45,
              -.40, 1, -.50,
              .45, -.50, 1), 3, byrow = TRUE)
z <- mvrnorm(160, mu = c(0, 0, 0), Sigma = R)
dane <- data.frame(stres      = pmin(40, pmax(0, round(20 + 6 * z[, 1]))),  # stres, 0–40 pkt
                   sen        = round(6.8 + 0.9 * z[, 2], 1),                # sen w dni powszednie, h
                   obciazenie = round(38 + 10 * z[, 3]))                     # zajęcia + praca, h/tydzień
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x))), 2)
r <- cor(dane)
round(r, 3)
ct <- cor.test(dane$stres, dane$sen)                       # korelacja zerowego rzędu stres–sen
round(c(r = unname(ct$estimate), ct$conf.int, df = unname(ct$parameter), p = ct$p.value), 4)

# 1. Wzór: r_XY.Z = (r_XY − r_XZ × r_YZ) / √[(1 − r_XZ²)(1 − r_YZ²)]
(r["stres", "sen"] - r["stres", "obciazenie"] * r["sen", "obciazenie"]) /
  sqrt((1 - r["stres", "obciazenie"]^2) * (1 - r["sen", "obciazenie"]^2))

# 2. Reszty: usuń obciążenie ze stresu i ze snu, a potem skoreluj reszty
reszty_stres <- resid(lm(stres ~ obciazenie, data = dane))
reszty_sen   <- resid(lm(sen ~ obciazenie, data = dane))
cor(reszty_stres, reszty_sen)

# 3. Pakiet psych
pr <- partial.r(dane, c("stres", "sen"), "obciazenie")
round(pr, 3)

# Test i 95% CI: df = n − 2 − k, SE(z Fishera) = 1 / √(n − 3 − k), k = liczba kontrolowanych zmiennych
r_cz <- pr["stres", "sen"]; n <- 160; k <- 1
t <- r_cz * sqrt(n - 2 - k) / sqrt(1 - r_cz^2)
round(c(r_czastkowa = r_cz, t = t, df = n - 2 - k, p = 2 * pt(-abs(t), n - 2 - k)), 4)
round(tanh(atanh(r_cz) + c(-1, 1) * qnorm(.975) / sqrt(n - 3 - k)), 3)

# Uwaga: cor.test() na resztach nie wie o kontrolowanej zmiennej i liczy df = n − 2
round(c(df = unname(cor.test(reszty_stres, reszty_sen)$parameter), p = cor.test(reszty_stres, reszty_sen)$p.value), 4)

# Ten sam test daje regresja: t dla stresu w modelu sen ~ stres + obciążenie
round(summary(lm(sen ~ stres + obciazenie, data = dane))$coefficients["stres", ], 4)
Wynik w R
   stres  sen obciazenie
M  19.42 6.76      37.77
SD  5.93 0.82       9.14
            stres    sen obciazenie
stres       1.000 -0.376      0.438
sen        -0.376  1.000     -0.403
obciazenie  0.438 -0.403      1.000
       r                         df        p
 -0.3763  -0.5021  -0.2349 158.0000   0.0000
[1] -0.2431126
[1] -0.2431126
partial correlations
      stres   sen
stres  1.00 -0.24
sen   -0.24  1.00
r_czastkowa           t          df           p
    -0.2431     -3.1404    157.0000      0.0020
[1] -0.384 -0.091
     df       p
158.000   0.002
  Estimate Std. Error    t value   Pr(>|t|)
   -0.0343     0.0109    -3.1404     0.0020
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; dane wygenerowano funkcją mvrnorm() z pakietu MASS, korelację cząstkową policzono też w pakiecie psych, a rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Korelacja cząstkowa jako dowód przyczynowości. Kontrola jednej zmiennej nie usuwa wpływu zmiennych, których nie zmierzono; do wniosków przyczynowych potrzebny jest odpowiedni plan badania (zob. korelacja pozorna).
- Kontrolowanie mediatora lub wspólnego skutku zamiast wspólnej przyczyny – wynik oddala się wtedy od efektu, który chcesz oszacować (Rohrer, 2018).
- Kontrola zmiennej mierzonej nierzetelnie, np. jednym pytaniem – zakłócenie usuwa się tylko częściowo (Westfall i Yarkoni, 2016). Kontroluj możliwie rzetelne miary albo użyj modelu ze zmiennymi latentnymi.
- Zły test korelacji reszt. Funkcja
cor.test()na resztach liczy df = n − 2 zamiast n − 3; w dużej próbie różnica jest kosmetyczna (tu p = .002 w obu wersjach), ale w małej już nie. - Mylenie korelacji cząstkowej z semicząstkową – SPSS w regresji podaje obie (kolumny partial i part); w opisie zawsze napisz, z której zmiennej usunięto wpływ Z.
- Brak korelacji zerowego rzędu w raporcie. Bez niej czytelnik nie wie, o ile kontrola zmieniła wynik.
Najczęstsze pytania
Co to jest korelacja cząstkowa?
To korelacja między dwiema zmiennymi po usunięciu z obu z nich liniowego wpływu trzeciej zmiennej (lub kilku zmiennych). Odpowiada na pytanie, czy X i Y nadal są związane u osób o takim samym poziomie zmiennej kontrolowanej. Zapisuje się ją jako rXY·Z.
Jak obliczyć korelację cząstkową?
Dla jednej zmiennej kontrolowanej: rXY·Z = (rXY − rXZrYZ) / √[(1 − rXZ²)(1 − rYZ²)]. Równoważnie: oblicz reszty z regresji X na Z i Y na Z, a następnie skoreluj je. W SPSS: Analiza → Korelacje → Cząstkowe; w R np. psych::partial.r().
Czym różni się korelacja cząstkowa od semicząstkowej?
Korelacja cząstkowa usuwa wpływ Z z obu zmiennych, a semicząstkowa – tylko z jednej (zwykle z predyktora). Semicząstkowa w kwadracie mówi, jaką część całej wariancji Y wyjaśnia unikalna część X, dlatego służy do opisu udziału predyktorów w regresji. W przykładzie z tego hasła korelacja cząstkowa wynosiła −.24, a semicząstkowa −.22.
Ile stopni swobody ma korelacja cząstkowa?
n − 2 − k, gdzie k to liczba kontrolowanych zmiennych. Przy 160 osobach i jednej zmiennej kontrolowanej to 157. Uważaj na cor.test() zastosowany do reszt – liczy on n − 2 stopni swobody, bo nie wie o kontrolowanej zmiennej.
Czy korelacja cząstkowa pozwala wnioskować o przyczynowości?
Nie. Usuwa tylko wpływ zmiennych, które zmierzono i uwzględniono, i tylko w zakresie, w jakim zmierzono je rzetelnie. Kontrola mediatora lub wspólnego skutku może nawet zniekształcić wynik (Rohrer, 2018). Do wniosków przyczynowych potrzebny jest odpowiedni plan badania, najlepiej eksperymentalny.
Jak zapisać korelację cząstkową w APA?
Podaj korelację zerowego rzędu, nazwę kontrolowanej zmiennej oraz korelację cząstkową ze stopniami swobody, 95% CI i p, np. „po kontroli obciążenia zajęciami związek stresu ze snem był słabszy, ale istotny, r(157) = −.24, 95% CI [−.38, −.09], p = .002”.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Korelacja Pearsona i Spearmana krok po kroku
Wybór miary, wykres rozrzutu, przedział ufności z transformacji Fishera, siła r, korelacja cząstkowa, macierz w APA i opis wyników z kodem R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Baba, K., Shibata, R., & Sibuya, M. (2004). Partial correlation and conditional correlation as measures of conditional independence. Australian & New Zealand Journal of Statistics, 46(4), 657–664. https://doi.org/10.1111/j.1467-842x.2004.00360.x
- Epskamp, S., & Fried, E. I. (2018). A tutorial on regularized partial correlation networks. Psychological Methods, 23(4), 617–634. https://doi.org/10.1037/met0000167 ● Otwarty dostęp: pełny tekst
- Kim, S. (2015). ppcor: An R package for a fast calculation to semi-partial correlation coefficients. Communications for Statistical Applications and Methods, 22(6), 665–674. https://doi.org/10.5351/csam.2015.22.6.665 ● Otwarty dostęp
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Spector, P. E., & Brannick, M. T. (2011). Methodological urban legends: The misuse of statistical control variables. Organizational Research Methods, 14(2), 287–305. https://doi.org/10.1177/1094428110369842
- Westfall, J., & Yarkoni, T. (2016). Statistically controlling for confounding constructs is harder than you think. PLOS ONE, 11(3), Article e0152719. https://doi.org/10.1371/journal.pone.0152719 ● Otwarty dostęp
Cytowania BibTeX
@article{baba2004partial, author={Baba, Kunihiro and Shibata, Ritei and Sibuya, Masaaki}, title={{Partial correlation and conditional correlation as measures of conditional independence}}, journal={Australian \& New Zealand Journal of Statistics}, year={2004}, volume={46}, number={4}, pages={657--664}, doi={10.1111/j.1467-842x.2004.00360.x}}@article{epskamp2018tutorial, author={Epskamp, Sacha and Fried, Eiko I.}, title={{A tutorial on regularized partial correlation networks}}, journal={Psychological Methods}, year={2018}, volume={23}, number={4}, pages={617--634}, doi={10.1037/met0000167}}@article{kim2015ppcor, author={Kim, Seongho}, title={{ppcor: An R package for a fast calculation to semi-partial correlation coefficients}}, journal={Communications for Statistical Applications and Methods}, year={2015}, volume={22}, number={6}, pages={665--674}, doi={10.5351/csam.2015.22.6.665}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{spector2011methodological, author={Spector, Paul E. and Brannick, Michael T.}, title={{Methodological urban legends: The misuse of statistical control variables}}, journal={Organizational Research Methods}, year={2011}, volume={14}, number={2}, pages={287--305}, doi={10.1177/1094428110369842}}@article{westfall2016statistically, author={Westfall, Jacob and Yarkoni, Tal}, title={{Statistically controlling for confounding constructs is harder than you think}}, journal={PLOS ONE}, year={2016}, volume={11}, number={3}, eid={e0152719}, doi={10.1371/journal.pone.0152719}}