Co to jest korelacja pozorna?
Korelacja pozorna (ang. spurious correlation) to związek dwóch zmiennych, który nie wynika z tego, że jedna wpływa na drugą, tylko z czegoś innego – najczęściej ze wspólnej przyczyny, czyli zmiennej zakłócającej. Sam współczynnik korelacji jest wtedy policzony poprawnie i może być wysoki oraz istotny. Pozorna jest nie liczba, tylko jej interpretacja: wniosek, że zmiana X zmieni Y.
Termin ma ciekawą historię. Pearson (1897) opisał pod tą nazwą korelację między wskaźnikami – ilorazami o wspólnym mianowniku – która pojawia się nawet wtedy, gdy zmienne wyjściowe nie są ze sobą powiązane. Simon (1954) pokazał, że o tym, czy korelacja jest „prawdziwa”, czy pozorna, nie rozstrzygnie się bez wprowadzenia dodatkowych zmiennych i założeń o strukturze przyczynowej. Haig (2003) zwraca z kolei uwagę, że związek wywołany przez trzecią zmienną to w gruncie rzeczy korelacja prawdziwa, tylko pośrednia, a pozorne w ścisłym sensie są korelacje przypadkowe. W psychologii „korelacją pozorną” nazywa się zwykle właśnie związek wywołany przez trzecią zmienną i w takim znaczeniu używamy tego terminu tutaj.
Skąd się biorą korelacje pozorne?
| Mechanizm | Jak powstaje związek | Przykład | Co pomaga |
|---|---|---|---|
| Wspólna przyczyna | Z wpływa i na X, i na Y | Nasilenie objawów decyduje o liczbie sesji i o objawach po terapii | Randomizacja; pomiar i kontrola Z |
| Selekcja próby (wspólny skutek) | Do próby trafiają osoby wybrane ze względu na X i Y | Wśród stypendystów zdolności i sumienność korelują ujemnie | Próba z całej populacji; nie kontroluj wspólnego skutku |
| Wspólny mianownik | X/Z i Y/Z korelują, bo dzielą to samo Z | Dwa wskaźniki liczone „na pracownika” albo „na mieszkańca” | Analizuj liczniki, a mianownik dodaj jako predyktor |
| Przypadek | Przy wielu testowanych parach część wyjdzie istotna | Przeszukiwanie macierzy kilkudziesięciu zmiennych | Hipotezy z góry, korekta na wielokrotne testowanie, replikacja |
Ostatni wiersz wiąże się z p-hackingiem: im więcej korelacji sprawdzisz, tym więcej znajdziesz przypadkowych. Trzy pierwsze mechanizmy dają związki powtarzalne – i dlatego bardziej zdradliwe.
Przykład: czy więcej sesji terapii to gorsze samopoczucie?
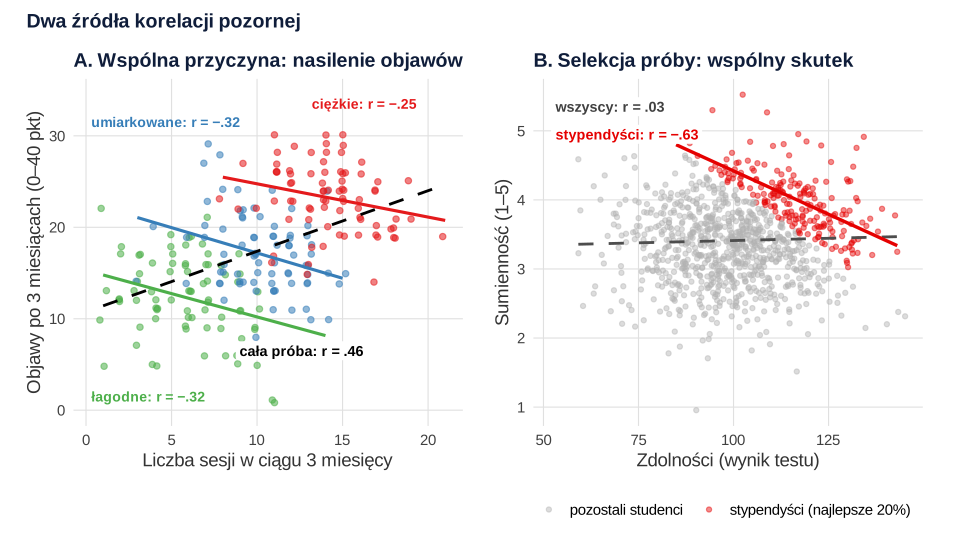
W poradni (dane symulowane) 240 pacjentów zakwalifikowano przy przyjęciu do trzech grup nasilenia objawów depresyjnych: łagodnego, umiarkowanego i ciężkiego (po 80 osób; średnio 11.64, 20.01 i 28.18 pkt na skali 0–40). Liczbę sesji ustalano według kategorii nasilenia: średnio 6.00, 10.32 i 14.20 sesji w ciągu trzech miesięcy. Po tym czasie ponownie zmierzono objawy.
W całej próbie więcej sesji wiązało się z wyższym nasileniem objawów po trzech miesiącach, r(238) = .46, 95% CI [.35, .55], p < .001; każda dodatkowa sesja „oznaczała” wynik wyższy o 0.66 pkt. Naiwny wniosek brzmiałby: terapia szkodzi. Tymczasem w każdej grupie nasilenia związek był ujemny: r = −.32 w grupie łagodnej, −.32 w umiarkowanej i −.25 w ciężkiej. Wspólną przyczyną jest nasilenie objawów przy przyjęciu: osoby w gorszym stanie dostawały więcej sesji (r = .77) i po trzech miesiącach nadal miały więcej objawów (r = .82). Rysunek 1A pokazuje, jak z trzech opadających linii powstaje jedna rosnąca.
Po uwzględnieniu nasilenia objawów przy przyjęciu obraz się odwraca. Korelacja cząstkowa liczby sesji z objawami po trzech miesiącach wyniosła r(237) = −.47, 95% CI [−.56, −.36], p < .001, a w regresji wielorakiej każda dodatkowa sesja wiązała się z wynikiem niższym o 0.60 pkt (SE = 0.07, p < .001) przy tym samym nasileniu wyjściowym. W symulacji prawdziwy efekt sesji wynosił −0.55 pkt, więc model z kontrolą zbliżył się do prawdy, a korelacja surowa wskazywała nawet zły kierunek.
Panel B pokazuje drugi mechanizm. W grupie 1000 studentów zdolności i sumienność były niezależne (r = .03), ale stypendium dostało 20% osób z najwyższą sumą obu cech. Wśród 200 stypendystów korelacja wyniosła −.63: kto miał niższe zdolności, a mimo to dostał stypendium, musiał być bardzo sumienny. Badanie prowadzone tylko na stypendystach „odkryłoby” związek, którego w populacji nie ma. Wspólny mianownik działa podobnie: w symulacji dwóch niezależnych zmiennych (r = −.08) ich ilorazy przez trzecią, losową zmienną korelowały na poziomie .56.
Paradoks Simpsona
Przykład z rysunku 1A to odmiana paradoksu Simpsona: kierunek związku w całej populacji jest odwrotny niż w tworzących ją podgrupach. Kievit i in. (2013) przekonują, że w psychologii zdarza się on częściej, niż się sądzi – przeglądają przykłady z neuronauki poznawczej, genetyki zachowania, psychologii klinicznej, psychologii osobowości, psychologii edukacyjnej i badań nad inteligencją. Paradoks pojawia się najczęściej wtedy, gdy wnioski przenosi się między poziomami wyjaśniania: z populacji na podgrupy albo z podgrup na pojedyncze osoby. Autorzy proponują statystyczne sygnały ostrzegawcze i rozwiązania psychometryczne, w tym narzędzia w R do wykrywania paradoksu.
Jak odróżnić związek przyczynowy od pozornego?
- Zacznij od planu badania. Losowe przydzielenie do warunków (schemat eksperymentalny) zrywa związek między przyczyną a zmiennymi zakłócającymi i najlepiej chroni trafność wewnętrzną. Gdy eksperyment jest niemożliwy, pomiar podłużny przynajmniej ustala kolejność zdarzeń.
- Narysuj przypuszczalne zależności przyczynowe, zanim wybierzesz zmienne kontrolne. Rohrer (2018) pokazuje, że kontrolować trzeba wspólne przyczyny, ale nie mediatory ani wspólne skutki, a niereprezentatywna próba może działać jak niepożądana kontrola – dokładnie tak jak wśród stypendystów.
- Zmierz i uwzględnij zmienne zakłócające – w regresji, w korelacji cząstkowej albo analizując podgrupy osobno. Mierz je rzetelnie: Westfall i Yarkoni (2016) pokazali, że kontrola zmiennej mierzonej z dużym błędem zostawia znaczną część zakłócenia i prowadzi do licznych fałszywie istotnych wniosków.
- Analizuj dane na poziomie, którego dotyczy pytanie – związek między grupami (np. szkołami) nie musi opisywać związku u osób (Kievit i in., 2013).
- Nie licz na samą kontrolę statystyczną. Kontrolujesz tylko to, co zmierzyłeś; wniosek przyczynowy z danych korelacyjnych zawsze opiera się na założeniach, które warto napisać wprost.
Jak opisać wynik w pracy (APA)
Gdy podejrzewasz zmienną zakłócającą, podaj związek przed jej kontrolą i po niej, a w języku opisu trzymaj się słów „wiązał się”, „współwystępował”, a nie „wpływał” czy „powodował”. Wzór dla przykładu:
Więcej o rozdzieleniu związku i przyczynowości w opisie wyników znajdziesz w poradniku jak napisać dyskusję wyników.
Przykład w R
Kod odtwarza trzy symulacje z tekstu: wspólną przyczynę (korelacja w całej próbie, w grupach, korelacja cząstkowa i regresja z kontrolą), selekcję próby i wspólny mianownik. W SPSS korelacje w podgrupach policzysz po podzieleniu pliku według grupy (Dane → Podziel plik, ang. Split File) i wybraniu Analiza → Korelacje → Parami, a korelację cząstkową – w oknie Analiza → Korelacje → Cząstkowe.
Wspólna przyczyna, selekcja próby i wspólny mianownik
R
# 1. Wspólna przyczyna: liczba sesji terapii a objawy po 3 miesiącach. Dane symulowane, N = 240
set.seed(146)
grupa <- factor(rep(c("łagodne", "umiarkowane", "ciężkie"), each = 80),
                levels = c("łagodne", "umiarkowane", "ciężkie"))              # nasilenie przy przyjęciu
start <- round(rnorm(240, rep(c(12, 20, 28), each = 80), 2.5))                # objawy na początku, 0–40 pkt
sesje <- pmax(1, round(rnorm(240, rep(c(6, 10, 14), each = 80), 2.5)))        # liczba sesji zależy od kategorii
po    <- pmax(0, round(4 + 0.95 * start - 0.55 * sesje + rnorm(240, 0, 3)))   # objawy po 3 miesiącach
dane  <- data.frame(grupa, start, sesje, po)
aggregate(cbind(start, sesje, po) ~ grupa, data = dane, FUN = function(x) round(mean(x), 2))

ct <- cor.test(dane$sesje, dane$po)                      # korelacja w całej próbie
round(c(r = unname(ct$estimate), ct$conf.int, p = ct$p.value), 3)
round(sapply(split(dane, dane$grupa), function(d) cor(d$sesje, d$po)), 3)   # korelacje w grupach
round(coef(lm(po ~ sesje, data = dane)), 3)                                  # regresja bez kontroli

# Korelacja cząstkowa z kontrolą objawów na początku terapii (df = n − 3)
r_cz <- cor(resid(lm(sesje ~ start, dane)), resid(lm(po ~ start, dane)))
t <- r_cz * sqrt(240 - 3) / sqrt(1 - r_cz^2)
round(c(r_czastkowa = r_cz, t = t, p = 2 * pt(-abs(t), 240 - 3)), 3)
round(tanh(atanh(r_cz) + c(-1, 1) * qnorm(.975) / sqrt(240 - 4)), 3)
round(summary(lm(po ~ sesje + start, data = dane))$coefficients, 3)   # regresja z kontrolą

# 2. Selekcja próby (wspólny skutek): zdolności i sumienność wśród stypendystów
set.seed(2)
zdolnosci  <- rnorm(1000, 100, 15)
sumiennosc <- rnorm(1000, 3.4, 0.6)
wynik_rekrutacji <- scale(zdolnosci) + scale(sumiennosc)
stypendium <- wynik_rekrutacji > quantile(wynik_rekrutacji, 0.80)  # stypendium dostaje najlepsze 20%
round(c(r_wszyscy = cor(zdolnosci, sumiennosc),
        r_stypendysci = cor(zdolnosci[stypendium], sumiennosc[stypendium])), 3)

# 3. Wspólny mianownik (Pearson, 1897): niezależne X i Y podzielone przez to samo Z
set.seed(3)
X <- rnorm(500, 50, 10); Y <- rnorm(500, 50, 10); Z <- rnorm(500, 50, 10)
round(c(r_XY = cor(X, Y), r_ilorazow = cor(X / Z, Y / Z)), 3)
Wynik w R
        grupa start sesje    po
1     łagodne 11.64  6.00 12.24
2 umiarkowane 20.01 10.32 17.01
3     ciężkie 28.18 14.20 23.23
    r                 p
0.458 0.352 0.552 0.000
    łagodne umiarkowane     ciężkie
     -0.317      -0.316      -0.250
(Intercept)       sesje
     10.751       0.663
r_czastkowa           t           p
     -0.465      -8.094       0.000
[1] -0.559 -0.360
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    4.346      0.598   7.264        0
sesje         -0.600      0.074  -8.094        0
start          0.965      0.043  22.228        0
    r_wszyscy r_stypendysci
        0.034        -0.634
      r_XY r_ilorazow
    -0.084      0.561
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet stats); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Przekonanie, że korelacja pozorna to błąd w obliczeniach. Współczynnik jest poprawny i może się powtarzać w kolejnych badaniach; błędna jest interpretacja przyczynowa.
- Język przyczynowy w badaniu korelacyjnym („liczba sesji pogarsza samopoczucie”) – zamiast niego opisuj związek i jego możliwe wyjaśnienia.
- Kontrolowanie wszystkiego, co jest pod ręką. Kontrola wspólnego skutku albo mediatora może związek wytworzyć lub zniekształcić (Rohrer, 2018).
- Badanie tylko wyselekcjonowanej grupy (np. pacjentów jednej poradni, przyjętych na studia) i uogólnianie związku na całą populację.
- Przenoszenie wniosków między poziomami – z danych zagregowanych (szkoły, kraje) na osoby i odwrotnie (Kievit i in., 2013).
- Korelowanie wskaźników o wspólnym mianowniku bez sprawdzenia, czy związek nie wynika z samego mianownika (Pearson, 1897).
Najczęstsze pytania
Co to jest korelacja pozorna?
To związek dwóch zmiennych, który nie wynika z tego, że jedna wpływa na drugą, tylko z czegoś innego – najczęściej ze wspólnej przyczyny, czyli zmiennej zakłócającej. Współczynnik korelacji jest wtedy policzony poprawnie i może być istotny; błędna byłaby dopiero interpretacja przyczynowa.
Jakie są przykłady korelacji pozornej w psychologii?
Gdy liczbę sesji terapii ustala się według nasilenia objawów, więcej sesji współwystępuje z gorszym stanem po terapii, choć w każdej grupie nasilenia więcej sesji wiąże się z lepszym wynikiem. Innym przykładem jest selekcja: wśród stypendystów wybranych na podstawie zdolności i sumienności obie cechy korelują ujemnie, choć w całej populacji nie są powiązane.
Jak wykryć korelację pozorną?
Zastanów się, co może być wspólną przyczyną obu zmiennych, zmierz te zmienne i sprawdź, czy związek utrzymuje się po ich kontroli – w podgrupach, w regresji wielorakiej albo w korelacji cząstkowej. Sprawdź też, jak dobrano próbę i czy wskaźniki nie mają wspólnego mianownika. Pewność daje dopiero odpowiedni plan badania, najlepiej eksperymentalny.
Czym jest paradoks Simpsona?
To sytuacja, w której kierunek związku w całej próbie jest odwrotny niż w każdej z tworzących ją podgrup. Kievit i in. (2013) pokazują, że w psychologii zdarza się częściej, niż się sądzi, zwłaszcza gdy wnioski przenosi się między poziomami, np. z grup na pojedyncze osoby.
Czy korelacja cząstkowa usuwa korelację pozorną?
Częściowo. Usuwa liniowy wpływ zmierzonej zmiennej zakłócającej, ale nie zmiennych, których nie zmierzono, a przy nierzetelnym pomiarze część zakłócenia zostaje (Westfall i Yarkoni, 2016). Nie wolno też kontrolować wspólnego skutku ani mediatora, bo to może związek wytworzyć lub zniekształcić (Rohrer, 2018).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak napisać dyskusję wyników – wzory zdań
Osiem elementów dyskusji z gotowymi zdaniami: interpretacja, wyniki nieistotne, konkretne ograniczenia, granice uogólniania, implikacje i wnioski.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikStatystyka dla psychologa
Analizy w pracy dyplomowej z psychologii: typowe projekty, wynik kwestionariusza, alfa i omega, normy i steny, eksperyment i raport APA – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Haig, B. D. (2003). What is a spurious correlation? Understanding Statistics, 2(2), 125–132. https://doi.org/10.1207/s15328031us0202_03
- Kievit, R. A., Frankenhuis, W. E., Waldorp, L. J., & Borsboom, D. (2013). Simpson's paradox in psychological science: A practical guide. Frontiers in Psychology, 4, Article 513. https://doi.org/10.3389/fpsyg.2013.00513 ● Otwarty dostęp
- Pearson, K. (1897). Mathematical contributions to the theory of evolution.—On a form of spurious correlation which may arise when indices are used in the measurement of organs. Proceedings of the Royal Society of London, 60(359–367), 489–498. https://doi.org/10.1098/rspl.1896.0076
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Simon, H. A. (1954). Spurious correlation: A causal interpretation. Journal of the American Statistical Association, 49(267), 467–479. https://doi.org/10.1080/01621459.1954.10483515
- Westfall, J., & Yarkoni, T. (2016). Statistically controlling for confounding constructs is harder than you think. PLOS ONE, 11(3), Article e0152719. https://doi.org/10.1371/journal.pone.0152719 ● Otwarty dostęp
Cytowania BibTeX
@article{haig2003what, author={Haig, Brian D.}, title={{What is a spurious correlation?}}, journal={Understanding Statistics}, year={2003}, volume={2}, number={2}, pages={125--132}, doi={10.1207/s15328031us0202_03}}@article{kievit2013simpson, author={Kievit, Rogier A. and Frankenhuis, Willem E. and Waldorp, Lourens J. and Borsboom, Denny}, title={{Simpson's paradox in psychological science: A practical guide}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={513}, doi={10.3389/fpsyg.2013.00513}}@article{pearson1897mathematical, author={Pearson, Karl}, title={{Mathematical contributions to the theory of evolution.—On a form of spurious correlation which may arise when indices are used in the measurement of organs}}, journal={Proceedings of the Royal Society of London}, year={1897}, volume={60}, number={359–367}, pages={489--498}, doi={10.1098/rspl.1896.0076}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{simon1954spurious, author={Simon, Herbert A.}, title={{Spurious correlation: A causal interpretation}}, journal={Journal of the American Statistical Association}, year={1954}, volume={49}, number={267}, pages={467--479}, doi={10.1080/01621459.1954.10483515}}@article{westfall2016statistically, author={Westfall, Jacob and Yarkoni, Tal}, title={{Statistically controlling for confounding constructs is harder than you think}}, journal={PLOS ONE}, year={2016}, volume={11}, number={3}, eid={e0152719}, doi={10.1371/journal.pone.0152719}}