Co to jest korelacja Pearsona?
Korelacja Pearsona (współczynnik korelacji liniowej Pearsona, r; ang. Pearson product-moment correlation) mierzy siłę i kierunek liniowego związku między dwiema zmiennymi ilościowymi. Przyjmuje wartości od −1 do +1: znak mówi o kierunku związku, a wartość bezwzględna – o tym, jak blisko prostej leżą punkty na wykresie rozrzutu. Schober i in. (2018) przypominają, że r Pearsona stosuje się zwykle do danych o dwuwymiarowym rozkładzie normalnym, a przy danych porządkowych, nienormalnych lub z obserwacjami odstającymi lepszym wyborem jest korelacja rang.
W psychologii r to jedna z najczęściej raportowanych miar: opisuje związek samooceny z lękiem, rzetelność test–retest czy trafność kryterialną testu. Jest też miarą wielkości efektu. Ogólne pojęcie i inne rodzaje współczynników opisujemy w haśle korelacja.
Wzór na współczynnik korelacji Pearsona
Licznik to suma iloczynów odchyleń od średnich – dodatnia, gdy wyniki powyżej średniej w X idą w parze z wynikami powyżej średniej w Y. Mianownik standaryzuje ją, dzięki czemu r nie zależy od jednostek pomiaru. W praktyce r to kowariancja podzielona przez iloczyn odchyleń standardowych.
Ten sam współczynnik da się zapisać na wiele sposobów. Rodgers i Nicewander (1988) zebrali 13 wzorów i interpretacji r – między innymi jako szczególnej średniej, stosunku wariancji, nachylenia prostej i cosinusa kąta. Kilka z nich warto znać:
- średnia iloczynów wyników standaryzowanych: r = ΣzXzY / (n − 1);
- nachylenie prostej regresji po standaryzacji obu zmiennych – stąd związek r z regresją liniową;
- średnia geometryczna nachyleń dwóch prostych regresji: Y na X i X na Y;
- cosinus kąta między wektorami odchyleń od średnich;
- r² – odsetek wariancji jednej zmiennej wspólnej z drugą (współczynnik determinacji).
W sekcji z kodem R liczymy r pięcioma sposobami – za każdym razem wychodzi −0.4429.
Jak interpretować r Pearsona?
- Kierunek: r > 0 – wyższym wynikom X towarzyszą zwykle wyższe wyniki Y; r < 0 – niższe.
- Siła: im bliżej ±1, tym ciaśniej punkty skupiają się wokół prostej; r = 0 oznacza brak związku liniowego, ale nie wyklucza związku krzywoliniowego.
- r² zamiast „procentów”: r = .44 nie znaczy „44% wspólnego”; wspólna wariancja to r² = .20, czyli 20%.
- r to nie nachylenie: ten sam r może iść w parze z bardzo różnym przyrostem Y na jednostkę X.
Do opisu siły używa się konwencji, ale różnią się one między sobą. Według Cohena (1992) r = .10, .30 i .50 to efekt mały, średni i duży, więc r = −.44 to efekt średni, bliski dużemu. Reguła kciuka przytaczana przez Mukakę (2012) nazywa wartości od .30 do .50 korelacją niską. Dlatego zawsze podawaj samą liczbę z przedziałem ufności i oceniaj ją na tle badań z danej dziedziny (zob. poradnik wielkość efektu).
Założenia i ograniczenia korelacji Pearsona
- Zmienne ilościowe (przedziałowe lub ilorazowe); przy danych porządkowych wybierz korelację Spearmana albo tau Kendalla.
- Związek liniowy – sprawdź go na wykresie rozrzutu, zanim policzysz r.
- Brak obserwacji wpływowych – pojedyncza obserwacja odstająca potrafi wytworzyć albo ukryć korelację (rysunek 2).
- Do testu i przedziału ufności – niezależne obserwacje i rozkład obu zmiennych zbliżony do dwuwymiarowego rozkładu normalnego.
- Pełny zakres wyników – gdy badasz tylko osoby o wysokich wynikach (np. samych kandydatów przyjętych na studia), r zwykle maleje.
Bewick i in. (2003) omawiają obliczanie i interpretację r, testy i przedziały ufności dla korelacji w populacji, częste nadużycia tej miary oraz skutki niespełnienia założeń. Mukaka (2012) pokazuje na danych symulowanych i rzeczywistych, jak łatwo o niewłaściwe użycie współczynnika korelacji.
Przykład: samoocena a objawy lęku
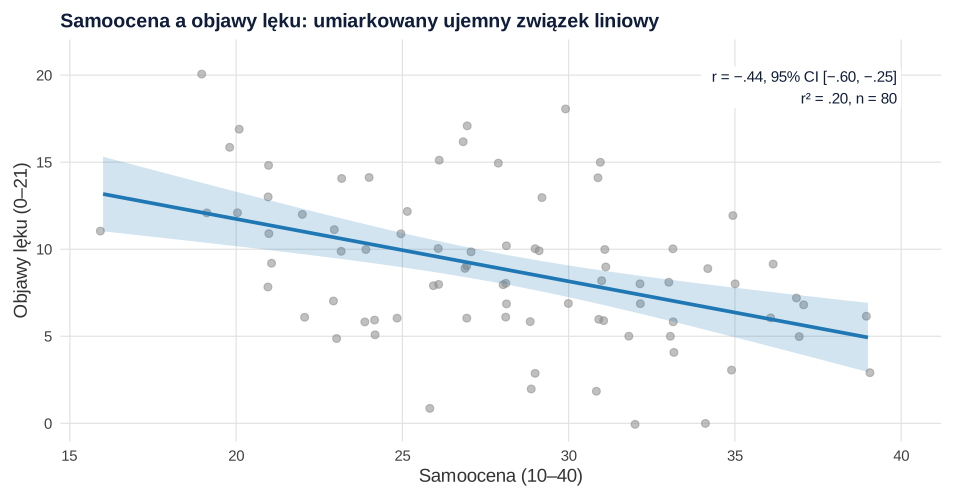
Załóżmy, że 80 studentów (dane symulowane) wypełniło skalę samooceny (10–40; M = 28.02, SD = 5.25) i skalę objawów lęku (0–21; M = 8.86, SD = 4.25). Wyższa samoocena wiązała się z mniejszym nasileniem lęku: r(78) = −.44, 95% CI [−.60, −.25], p < .001. Wspólna wariancja wynosiła r² = .20.
Przedział ufności dla r liczy się przez transformację Fishera, bo rozkład r z prób jest asymetryczny, zwłaszcza daleko od zera. Najpierw zamieniamy r na z′, budujemy przedział na skali z′, a potem przeliczamy granice z powrotem:
95% CI: z′ ± 1.96 × 0.114 → po przeliczeniu na r: [−.604, −.247]
Otrzymujemy dokładnie ten sam przedział, który podaje funkcja cor.test(). Zauważ, że jest on niesymetryczny względem −.44 – dłuższy w stronę zera. Przedział ufności mówi więcej niż sama wartość p (zob. przedział ufności): w populacji korelacja może być zarówno słaba (−.25), jak i silna (−.60).
Wpływ jednej obserwacji odstającej
Korelacja Pearsona opiera się na średnich i odchyleniach, więc jest wrażliwa na skrajne wyniki. W osobnym, małym zbiorze danych (20 osób) czas spędzany w mediach społecznościowych i poczucie samotności nie były ze sobą związane: r = .02, 95% CI [−.43, .46], p = .938. Wystarczyło dodać jedną osobę, która zadeklarowała 14 godzin dziennie i wysoką samotność, by otrzymać „istotną” korelację: r(19) = .52, 95% CI [.12, .78], p = .015.
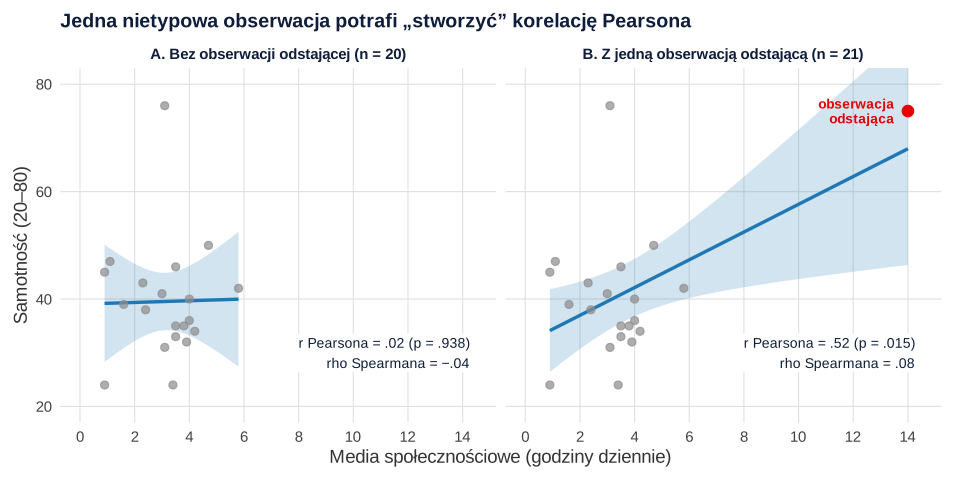
Korelacja rang Spearmana dla tych samych 21 osób wynosi tylko .08 (p = .725), bo dla rang nie ma znaczenia, jak bardzo skrajny jest wynik. Wniosek praktyczny: zawsze oglądaj wykres rozrzutu, sprawdź, skąd wzięła się nietypowa obserwacja (błąd w danych czy prawdziwy przypadek), i jeśli zostaje w analizie, podaj wynik z nią i bez niej.
Korelacja a przyczynowość
Istotna korelacja nie mówi, co jest przyczyną, a co skutkiem. Niska samoocena może nasilać lęk, lęk może obniżać samoocenę, a obie zmienne mogą zależeć od trzeciej, np. doświadczeń w rodzinie. Gdy związek wynika ze wspólnej przyczyny, mówimy o korelacji pozornej. Wpływ podejrzanej zmiennej zakłócającej możesz częściowo kontrolować korelacją cząstkową albo regresją wieloraką, ale do wniosków przyczynowych potrzebny jest odpowiedni plan badania.
Jak opisać korelację Pearsona w pracy (APA)
Podaj r z liczbą stopni swobody (n − 2), 95% przedział ufności i p; r i p zapisuj bez zera przed kropką. Wzór dla przykładu:
Gdy korelacji jest więcej, zbierz je w macierzy – wzór z M, SD i przedziałami ufności znajdziesz w haśle tabela korelacji w APA.
Przykład w R
Kod liczy korelację Pearsona z testem i przedziałem ufności, odtwarza ten przedział przez transformację Fishera, pokazuje pięć sposobów obliczenia tego samego r i wpływ jednej obserwacji odstającej. Liczby w tekście pochodzą z tego kodu (base R, bez dodatkowych pakietów).
Korelacja Pearsona, przedział Fishera i obserwacja odstająca
R
# Dane symulowane: samoocena (10–40) i objawy lęku (0–21), N = 80
set.seed(141)
n <- 80
samoocena <- pmin(pmax(round(rnorm(n, 28, 5.5)), 10), 40)
lek <- pmin(pmax(round(8 - 0.4 * (samoocena - 28) + rnorm(n, sd = 4.3)), 0), 21)
round(c(M_samoocena = mean(samoocena), SD_samoocena = sd(samoocena),
        M_lek = mean(lek), SD_lek = sd(lek)), 2)

# r Pearsona, test t i 95% przedział ufności
cor.test(samoocena, lek)

# Ten sam przedział „ręcznie”: transformacja Fishera z
r <- cor(samoocena, lek)
z <- atanh(r)                     # z = 0.5 * log((1 + r) / (1 - r))
se <- 1 / sqrt(n - 3)
round(c(r = r, z = z, se = se, dolna = tanh(z - qnorm(0.975) * se), gorna = tanh(z + qnorm(0.975) * se)), 3)

# Kilka z „13 sposobów” na ten sam współczynnik (Rodgers i Nicewander, 1988)
zx <- as.numeric(scale(samoocena)); zy <- as.numeric(scale(lek))
b_yx <- unname(coef(lm(lek ~ samoocena))[2]); b_xy <- unname(coef(lm(samoocena ~ lek))[2])
xc <- samoocena - mean(samoocena); yc <- lek - mean(lek)
round(c(kowariancja_przez_SD = cov(samoocena, lek) / (sd(samoocena) * sd(lek)),
        srednia_iloczynow_z = sum(zx * zy) / (n - 1),
        nachylenie_standaryzowane = unname(coef(lm(zy ~ zx))[2]),
        srednia_geometryczna_nachylen = sign(b_yx) * sqrt(b_yx * b_xy),
        cosinus_kata = sum(xc * yc) / sqrt(sum(xc^2) * sum(yc^2))), 4)
round(r^2, 3)                     # odsetek wspólnej wariancji

# Wpływ jednej obserwacji odstającej: media społecznościowe (h/dzień) i samotność (20–80), n = 20
media <- pmin(pmax(round(rnorm(20, 3, 1.2), 1), 0.5), 6)
samotnosc <- pmin(pmax(round(rnorm(20, 42, 9)), 20), 80)
cor.test(media, samotnosc)                                  # bez obserwacji odstającej
cor.test(c(media, 14), c(samotnosc, 75))                    # + 1 osoba: 14 h dziennie, samotność 75
cor.test(c(media, 14), c(samotnosc, 75), method = "spearman", exact = FALSE)
Wynik w R
 M_samoocena SD_samoocena        M_lek       SD_lek
       28.02         5.25         8.86         4.25

	Pearson's product-moment correlation

data:  samoocena and lek
t = -4.3627, df = 78, p-value = 3.891e-05
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.6038441 -0.2472280
sample estimates:
       cor
-0.4428872

     r      z     se  dolna  gorna
-0.443 -0.476  0.114 -0.604 -0.247
         kowariancja_przez_SD           srednia_iloczynow_z
                      -0.4429                       -0.4429
    nachylenie_standaryzowane srednia_geometryczna_nachylen
                      -0.4429                       -0.4429
                 cosinus_kata
                      -0.4429
[1] 0.196

	Pearson's product-moment correlation

data:  media and samotnosc
t = 0.078661, df = 18, p-value = 0.9382
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.4274901  0.4573068
sample estimates:
       cor
0.01853744


	Pearson's product-moment correlation

data:  c(media, 14) and c(samotnosc, 75)
t = 2.6684, df = 19, p-value = 0.01519
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.1167400 0.7783656
sample estimates:
      cor
0.5221147


	Spearman's rank correlation rho

data:  c(media, 14) and c(samotnosc, 75)
S = 1414.1, p-value = 0.7247
alternative hypothesis: true rho is not equal to 0
sample estimates:
       rho
0.08173244
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersję R i użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Liczenie r bez wykresu rozrzutu. Ta sama wartość r może opisywać liniowy związek, krzywą albo efekt jednej skrajnej obserwacji.
- Uznanie r ≈ 0 za brak związku. Pearson wykrywa tylko związki liniowe; zależność w kształcie litery U może dać r bliskie zera.
- Wnioskowanie przyczynowe z korelacji. Korelacja to związek, a nie kierunek wpływu.
- Interpretacja r jako odsetka. Odsetek wspólnej wariancji to r², a nie r.
- Same gwiazdki zamiast przedziałów ufności. W małych próbach przedziały są bardzo szerokie – przy n = 20 nawet brak istotności jest zgodny z umiarkowaną korelacją w populacji.
- Pearson dla danych porządkowych lub z silnie skośnym rozkładem – wtedy rozważ korelację Spearmana albo Kendalla (Schober i in., 2018).
Najczęstsze pytania
Co oznacza współczynnik korelacji Pearsona?
Mówi, jak silnie i w jakim kierunku dwie zmienne ilościowe są związane liniowo. Wartość +1 oznacza idealny związek dodatni, −1 idealny związek ujemny, a 0 brak związku liniowego. Kwadrat współczynnika, r², to odsetek wariancji wspólnej dla obu zmiennych.
Jaka korelacja jest silna?
Często używa się konwencji Cohena: r = .10, .30 i .50 to efekt mały, średni i duży. Inne reguły kciuka nazywają te same wartości inaczej, dlatego podawaj liczbę z 95% przedziałem ufności i porównuj ją z wynikami badań w danej dziedzinie.
Jakie założenia ma korelacja Pearsona?
Obie zmienne powinny być ilościowe, związek liniowy, bez obserwacji nadmiernie wpływowych, a obserwacje niezależne. Do testu istotności i przedziału ufności przyjmuje się też rozkład zbliżony do dwuwymiarowego normalnego. Gdy dane są porządkowe lub związek tylko monotoniczny, użyj korelacji Spearmana.
Jak obliczyć przedział ufności dla korelacji?
Zamień r na z′ transformacją Fishera, z′ = ½ ln[(1 + r)/(1 − r)], dodaj i odejmij 1.96 × 1/√(n − 3), a granice przelicz z powrotem na r. Dla r = −.44 i n = 80 daje to 95% CI [−.60, −.25]. W R przedział podaje funkcja cor.test().
Jak zapisać korelację Pearsona w APA?
Podaj r ze stopniami swobody (n − 2), 95% CI i dokładne p, bez zera przed kropką: r(78) = −.44, 95% CI [−.60, −.25], p < .001. Przy wielu korelacjach użyj tabeli korelacji w APA.
Czy korelacja oznacza związek przyczynowy?
Nie. Korelacja pokazuje, że zmienne współwystępują, ale nie mówi, która wpływa na którą ani czy obie nie zależą od trzeciej zmiennej. Do wniosków przyczynowych potrzebny jest plan eksperymentalny albo silne założenia i kontrola zmiennych zakłócających.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Korelacje na wykresie
Mapa cieplna w dobrej kolejności, korekta zamiast gwiazdek, ggpairs ujawniający próg i sufit oraz korelacje z przedziałami ufności – pięć rysunków z kodem R.
Czytaj →PoradnikKorelacja Pearsona i Spearmana krok po kroku
Wybór miary, wykres rozrzutu, przedział ufności z transformacji Fishera, siła r, korelacja cząstkowa, macierz w APA i opis wyników z kodem R.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikCzy korelacja .30 to dużo?
Jak ocenić r = .30: konwencja Cohena a typowe korelacje w psychologii, R² = .09, przedział ufności przy różnej liczebności próby i wzór opisu APA.
Czytaj →PoradnikJak opisać tabelę korelacji w pracy?
Tabela korelacji w stylu APA, opis wzorca zamiast listy współczynników, korekta przy wielu korelacjach, Pearson obok Spearmana i gotowy wzór opisu.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bewick, V., Cheek, L., & Ball, J. (2003). Statistics review 7: Correlation and regression. Critical Care, 7(6), 451–459. https://doi.org/10.1186/cc2401 ● Otwarty dostęp
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Mukaka, M. M. (2012). Statistics corner: A guide to appropriate use of correlation coefficient in medical research. Malawi Medical Journal, 24(3), 69–71. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC3576830/ ● Otwarty dostęp
- Rodgers, J. L., & Nicewander, W. A. (1988). Thirteen ways to look at the correlation coefficient. The American Statistician, 42(1), 59–66. https://doi.org/10.1080/00031305.1988.10475524
- Schober, P., Boer, C., & Schwarte, L. A. (2018). Correlation coefficients: Appropriate use and interpretation. Anesthesia & Analgesia, 126(5), 1763–1768. https://doi.org/10.1213/ANE.0000000000002864 ● Otwarty dostęp
Cytowania BibTeX
@article{bewick2003statistics, author={Bewick, Viv and Cheek, Liz and Ball, Jonathan}, title={{Statistics review 7: Correlation and regression}}, journal={Critical Care}, year={2003}, volume={7}, number={6}, pages={451--459}, doi={10.1186/cc2401}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{mukaka2012guide, author={Mukaka, M. M.}, title={{Statistics corner: A guide to appropriate use of correlation coefficient in medical research}}, journal={Malawi Medical Journal}, year={2012}, volume={24}, number={3}, pages={69--71}, url={https://www.ncbi.nlm.nih.gov/pmc/articles/PMC3576830/}}@article{rodgers1988thirteen, author={Rodgers, Joseph Lee and Nicewander, W. Alan}, title={{Thirteen ways to look at the correlation coefficient}}, journal={The American Statistician}, year={1988}, volume={42}, number={1}, pages={59--66}, doi={10.1080/00031305.1988.10475524}}@article{schober2018correlation, author={Schober, Patrick and Boer, Christa and Schwarte, Lothar A.}, title={{Correlation coefficients: Appropriate use and interpretation}}, journal={Anesthesia \& Analgesia}, year={2018}, volume={126}, number={5}, pages={1763--1768}, doi={10.1213/ane.0000000000002864}}