Co to jest korelacja Spearmana?
Korelacja Spearmana (współczynnik korelacji rang Spearmana, rho Spearmana, rs lub ρ; ang. Spearman’s rank correlation) mierzy siłę i kierunek monotonicznego związku dwóch zmiennych. Liczy się ją tak samo jak korelację Pearsona, tylko nie na surowych wynikach, lecz na ich rangach. Przyjmuje wartości od −1 do +1. Schober i in. (2018) zalecają ją dla danych nienormalnych, porządkowych lub z obserwacjami odstającymi – jako miarę związku monotonicznego, a nie wyłącznie liniowego.
W psychologii korelację Spearmana stosuje się często do danych ze skal porządkowych (np. pojedynczych pozycji skali Likerta), do wyników o silnie skośnym rozkładzie (czas reakcji, liczba objawów) i do związków, które rosną nierównomiernie, np. krzywych uczenia się. Należy do rodziny metod nieparametrycznych, choć test jej istotności ma własne założenia.
Wzór na korelację Spearmana
Gdy w danych nie ma rang wiązanych (powtarzających się wartości), współczynnik można obliczyć prostym wzorem:
gdzie di to różnica między rangą osoby w zmiennej X i w zmiennej Y, a n – liczba osób. Przykład dla ośmiu osób (czas nauki listy słów i liczba zapamiętanych słów):
| Osoba | Czas (min) | Słowa | Ranga czasu | Ranga słów | d | d² |
|---|---|---|---|---|---|---|
| 1 | 3 | 9 | 1 | 2 | −1 | 1 |
| 2 | 5 | 7 | 2 | 1 | 1 | 1 |
| 3 | 8 | 18 | 3 | 3 | 0 | 0 |
| 4 | 12 | 20 | 4 | 4 | 0 | 0 |
| 5 | 15 | 25 | 5 | 6 | −1 | 1 |
| 6 | 20 | 24 | 6 | 5 | 1 | 1 |
| 7 | 30 | 33 | 7 | 7 | 0 | 0 |
| 8 | 45 | 34 | 8 | 8 | 0 | 0 |
Ten sam wynik daje funkcja cor(x, y, method = "spearman"). Wzór z d² jest skrótem rachunkowym: ogólna definicja to korelacja Pearsona policzona na rangach, i właśnie tak liczą ją programy, zwłaszcza gdy w danych są rangi wiązane.
Związek monotoniczny a liniowy
Związek jest monotoniczny, gdy wraz ze wzrostem jednej zmiennej druga stale rośnie (albo stale maleje), choć niekoniecznie w tym samym tempie. Każdy związek liniowy jest monotoniczny, ale nie odwrotnie. W przykładzie 40 studentów (dane symulowane) uczyło się listy 40 słów przez różny czas (od 2.1 do 52.3 minuty; mediana 10.35). Liczba zapamiętanych słów szybko rosła w pierwszych minutach, a potem zbliżała się do maksimum – to typowa krzywa uczenia się.
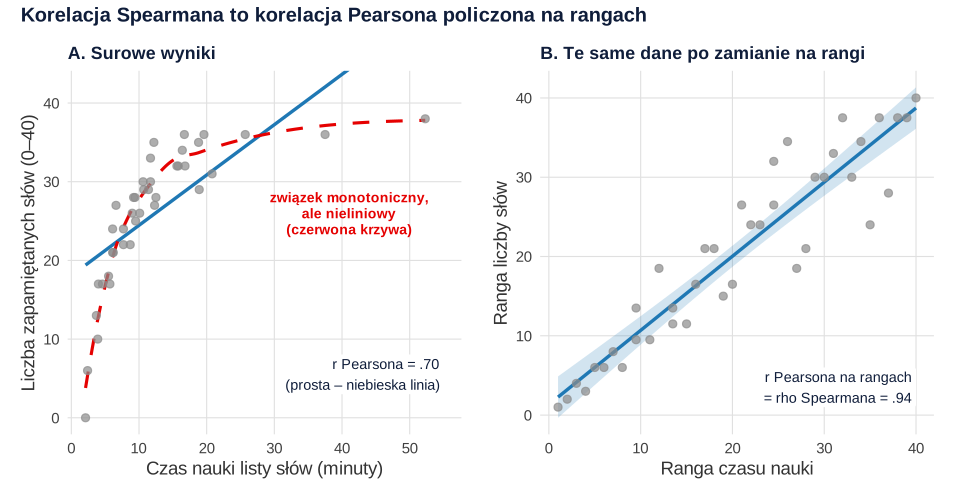
Korelacja Pearsona wyniosła r(38) = .70, 95% CI [.50, .83], bo prosta źle opisuje zakrzywiony związek – dla najdłuższej nauki przewiduje więcej słów, niż liczyła cała lista. Korelacja Spearmana wyniosła rs(38) = .94, 95% CI [.88, .97], p < .001: po zamianie na rangi punkty układają się wzdłuż prostej, bo dłuższa nauka niemal zawsze oznaczała więcej zapamiętanych słów. Spearman nie wykryje natomiast związku niemonotonicznego (np. w kształcie litery U) – dlatego zawsze zaczynaj od wykresu rozrzutu.
Wartość rs interpretuj jako stopień zgodności uporządkowania osób w obu zmiennych: rs = .94 znaczy, że osoby, które uczyły się dłużej, prawie zawsze zapamiętywały więcej słów. Kwadrat rs opisuje wspólną wariancję rang, a nie surowych wyników, więc nie przenoś na niego interpretacji r² z korelacji Pearsona. Siłę związku możesz opisywać tymi samymi konwencjami co dla r, ale zawsze z przedziałem ufności – przy małych próbach bywa on bardzo szeroki.
Kiedy wybrać korelację Spearmana, a kiedy Pearsona?
| Sytuacja | Zalecany współczynnik |
|---|---|
| Dwie zmienne ilościowe, związek liniowy, rozkłady zbliżone do normalnego | r Pearsona |
| Związek monotoniczny, ale nieliniowy | rs Spearmana |
| Dane porządkowe (rangi, pojedyncze pozycje Likerta) | rs Spearmana lub tau Kendalla |
| Obserwacje odstające lub rozkłady o grubych ogonach | rs Spearmana (sprawdź też dane) |
| Mała próba, dużo rang wiązanych | tau Kendalla albo rs – zob. hasło o Kendallu |
Badania symulacyjne doprecyzowują te reguły. De Winter i in. (2016) wykazali, że przy rozkładach normalnych oba współczynniki mają podobne wartości oczekiwane, ale rs jest bardziej zmienny, natomiast przy rozkładach o grubych ogonach – typowych dla danych ankietowych – mniej zmienny jest rs i to on jest preferowany. Bishara i Hittner (2012) porównali 12 metod testowania istotności korelacji przy danych nienormalnych: przy n ≥ 20 błędy I i II rodzaju najlepiej minimalizowało przekształcenie danych do rozkładu normalnego (rankit) przed obliczeniem r Pearsona, a przy bardzo małych i skrajnie nienormalnych próbach – test permutacyjny. Spearman nie jest więc automatycznie najlepszym wyborem przy każdym odstępstwie od rozkładu normalnego. Mukaka (2012) na danych symulowanych i rzeczywistych pokazuje, jak często współczynnik korelacji jest używany niewłaściwie.
Rangi wiązane
Gdy kilka osób ma ten sam wynik, każda otrzymuje rangę średnią z miejsc, które razem zajmują – tak traktował wartości wiązane Kendall (1945). Jeśli dwie osoby zajmują miejsca 2 i 3, obie dostają rangę 2.5; jeśli cztery osoby zajmują miejsca 7–10, każda dostaje 8.5. Przy danych z pozycji skali Likerta wiązań jest bardzo dużo.
W przykładzie z dwiema pozycjami skali 1–5 odpowiedziało 12 osób. Korelacja Spearmana policzona na rangach średnich wyniosła rs(10) = .78, p = .003, a uproszczony wzór z d² dał .79 – przy rangach wiązanych jest on tylko przybliżeniem. R ostrzega też, że przy wiązaniach nie może policzyć dokładnej wartości p („Cannot compute exact p-value with ties”), więc podaje p przybliżone. To nie błąd analizy, ale warto wiedzieć, skąd się bierze.
Jak opisać korelację Spearmana w pracy (APA)
Napisz, że użyto korelacji rang Spearmana i dlaczego, a potem podaj rs ze stopniami swobody (n − 2), 95% CI i p, bez zera przed kropką. Wzór dla przykładu:
Przy wielu zmiennych zbierz współczynniki w macierzy i zaznacz w nocie, że są to korelacje Spearmana – wzór znajdziesz w haśle tabela korelacji w APA.
Przykład w R
Kod porównuje korelację Pearsona i Spearmana na danych z przykładu, liczy przedział ufności dla rs, odtwarza przykład ręczny ze wzorem na d² i pokazuje, co dzieje się przy rangach wiązanych. Liczby w tekście pochodzą z tego kodu.
Korelacja Spearmana: przykład, wzór i rangi wiązane
R
library(correlation)   # cor_test(): rho z 95% przedziałem ufności

# Dane symulowane: czas nauki listy 40 słów (min) i liczba zapamiętanych słów, N = 40
set.seed(491)
n <- 40
czas <- pmin(pmax(round(exp(rnorm(n, log(10), 0.8)), 1), 1), 60)
slowa <- pmin(pmax(round(38 * (1 - exp(-czas / 8)) + rnorm(n, sd = 3)), 0), 40)
dane <- data.frame(czas, slowa)

# Pearson i Spearman dla tych samych danych
cor.test(czas, slowa)                                       # r Pearsona
cor.test(czas, slowa, method = "spearman", exact = FALSE)   # rho Spearmana
cor(rank(czas), rank(slowa))                                # to samo: r Pearsona policzone na rangach
cor_test(dane, "czas", "slowa", method = "spearman")       # rho z 95% CI

# Przykład ręczny bez rang wiązanych: rho = 1 - 6 * suma(d^2) / (n * (n^2 - 1))
x <- c(3, 5, 8, 12, 15, 20, 30, 45)
y <- c(9, 7, 18, 20, 25, 24, 33, 34)
d <- rank(x) - rank(y)
data.frame(x, y, ranga_x = rank(x), ranga_y = rank(y), d, d2 = d^2)
1 - 6 * sum(d^2) / (8 * (8^2 - 1))
cor(x, y, method = "spearman")

# Rangi wiązane: dwie pozycje skali Likerta (1–5), n = 12
p1 <- c(1, 2, 2, 3, 3, 3, 4, 4, 4, 4, 5, 5)
p2 <- c(2, 1, 3, 2, 3, 4, 3, 4, 5, 4, 4, 5)
rank(p1)                                                    # rangi średnie wartości wiązanych
cor.test(p1, p2, method = "spearman")                       # ostrzeżenie: brak dokładnego p
1 - 6 * sum((rank(p1) - rank(p2))^2) / (12 * (12^2 - 1))    # uproszczony wzór – przy wiązaniach niedokładny
Wynik w R
	Pearson's product-moment correlation

data:  czas and slowa
t = 6.0711, df = 38, p-value = 4.548e-07
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.4993309 0.8314596
sample estimates:
      cor
0.7016943


	Spearman's rank correlation rho

data:  czas and slowa
S = 679.64, p-value < 2.2e-16
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.9362441

[1] 0.9362441
Parameter1 | Parameter2 |  rho |       95% CI |      S |         p
------------------------------------------------------------------
czas       |      slowa | 0.94 | [0.88, 0.97] | 679.64 | < .001***

Observations: 40
   x  y ranga_x ranga_y  d d2
1  3  9       1       2 -1  1
2  5  7       2       1  1  1
3  8 18       3       3  0  0
4 12 20       4       4  0  0
5 15 25       5       6 -1  1
6 20 24       6       5  1  1
7 30 33       7       7  0  0
8 45 34       8       8  0  0
[1] 0.952381
[1] 0.952381
 [1]  1.0  2.5  2.5  5.0  5.0  5.0  8.5  8.5  8.5  8.5 11.5 11.5
Warning in cor.test.default(p1, p2, method = "spearman") :
  Cannot compute exact p-value with ties

	Spearman's rank correlation rho

data:  p1 and p2
S = 63.026, p-value = 0.002789
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.7796296

[1] 0.791958
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- correlation (wersja 0.8.8): Makowski, D., Ben-Shachar, M. S., Patil, I., & Lüdecke, D. (2020). Methods and algorithms for correlation analysis in R. Journal of Open Source Software, 5(51), 2306. https://doi.org/10.21105/joss.02306
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Traktowanie Spearmana jako miary każdego związku. Wykrywa związki monotoniczne; zależność w kształcie litery U może dać rs bliskie zera.
- Automatyczne przejście na Spearmana po teście normalności. Przy łagodnych odstępstwach i większych próbach Pearson często działa dobrze, a przy danych nienormalnych istnieją też inne rozwiązania (Bishara i Hittner, 2012).
- Interpretowanie rs jak związku liniowego surowych wyników. rs = .94 nie znaczy, że punkty leżą blisko prostej – leżą blisko krzywej rosnącej.
- Liczenie uproszczonego wzoru przy rangach wiązanych. Używaj korelacji Pearsona na rangach średnich (tak liczą programy).
- Brak informacji o rodzaju korelacji. W tekście i w tabeli zawsze zaznacz, czy podajesz r Pearsona, czy rs Spearmana.
Najczęstsze pytania
Kiedy stosować korelację Spearmana zamiast Pearsona?
Gdy dane są porządkowe (rangi, pojedyncze pozycje skali Likerta), gdy związek jest monotoniczny, ale nieliniowy, oraz gdy w danych są obserwacje odstające albo rozkłady o grubych ogonach. Przy zmiennych ilościowych o związku liniowym i rozkładach zbliżonych do normalnego lepsza jest korelacja Pearsona.
Jak obliczyć korelację Spearmana?
Zamień wyniki obu zmiennych na rangi i policz korelację Pearsona na rangach. Gdy nie ma rang wiązanych, wystarczy wzór rs = 1 − 6Σd² / [n(n² − 1)], gdzie d to różnica rang osoby. W R: cor.test(x, y, method = "spearman").
Co oznacza związek monotoniczny?
Taki, w którym wraz ze wzrostem jednej zmiennej druga stale rośnie albo stale maleje, ale niekoniecznie w tym samym tempie – na przykład szybki przyrost zapamiętanych słów na początku nauki, a potem coraz wolniejszy. Związek liniowy jest szczególnym przypadkiem związku monotonicznego.
Co zrobić z rangami wiązanymi w korelacji Spearmana?
Osobom o tym samym wyniku nadaje się rangę średnią z zajmowanych miejsc (np. 2.5 zamiast 2 i 3), a współczynnik liczy jako korelację Pearsona na rangach. Uproszczony wzór z d² jest wtedy tylko przybliżeniem, a R podaje przybliżoną zamiast dokładnej wartości p.
Jak zapisać korelację Spearmana w APA?
Podaj rs ze stopniami swobody (n − 2), 95% przedział ufności i p, bez zera przed kropką, np. rs(38) = .94, 95% CI [.88, .97], p < .001. W tabeli lub nocie zaznacz, że są to korelacje Spearmana.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Korelacja Pearsona i Spearmana krok po kroku
Wybór miary, wykres rozrzutu, przedział ufności z transformacji Fishera, siła r, korelacja cząstkowa, macierz w APA i opis wyników z kodem R.
Czytaj →PoradnikJaki test statystyczny do jakiej hipotezy?
Tabela doboru: typ hipotezy, test, alternatywa nieparametryczna i miara efektu. Cztery przykłady w R z gotowym zapisem APA.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikKorelacja i regresja – zadania z rozwiązaniami
Dziesięć zadań: kowariancja, Pearson i Spearman, metoda najmniejszych kwadratów, R², przedział predykcji, reszty, punkt wpływowy, regresja wieloraka i kwartet Anscombe’a.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bishara, A. J., & Hittner, J. B. (2012). Testing the significance of a correlation with nonnormal data: Comparison of Pearson, Spearman, transformation, and resampling approaches. Psychological Methods, 17(3), 399–417. https://doi.org/10.1037/a0028087
- de Winter, J. C. F., Gosling, S. D., & Potter, J. (2016). Comparing the Pearson and Spearman correlation coefficients across distributions and sample sizes: A tutorial using simulations and empirical data. Psychological Methods, 21(3), 273–290. https://doi.org/10.1037/met0000079 ● Otwarty dostęp: pełny tekst
- Kendall, M. G. (1945). The treatment of ties in ranking problems. Biometrika, 33(3), 239–251. https://doi.org/10.1093/biomet/33.3.239
- Mukaka, M. M. (2012). Statistics corner: A guide to appropriate use of correlation coefficient in medical research. Malawi Medical Journal, 24(3), 69–71. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC3576830/ ● Otwarty dostęp
- Schober, P., Boer, C., & Schwarte, L. A. (2018). Correlation coefficients: Appropriate use and interpretation. Anesthesia & Analgesia, 126(5), 1763–1768. https://doi.org/10.1213/ANE.0000000000002864 ● Otwarty dostęp
Cytowania BibTeX
@article{bishara2012testing, author={Bishara, Anthony J. and Hittner, James B.}, title={{Testing the significance of a correlation with nonnormal data: Comparison of Pearson, Spearman, transformation, and resampling approaches}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={399--417}, doi={10.1037/a0028087}}@article{dewinter2016comparing, author={de Winter, Joost C. F. and Gosling, Samuel D. and Potter, Jeff}, title={{Comparing the Pearson and Spearman correlation coefficients across distributions and sample sizes: A tutorial using simulations and empirical data}}, journal={Psychological Methods}, year={2016}, volume={21}, number={3}, pages={273--290}, doi={10.1037/met0000079}}@article{kendall1945treatment, author={Kendall, M. G.}, title={{The treatment of ties in ranking problems}}, journal={Biometrika}, year={1945}, volume={33}, number={3}, pages={239--251}, doi={10.1093/biomet/33.3.239}}@article{mukaka2012guide, author={Mukaka, M. M.}, title={{Statistics corner: A guide to appropriate use of correlation coefficient in medical research}}, journal={Malawi Medical Journal}, year={2012}, volume={24}, number={3}, pages={69--71}, url={https://www.ncbi.nlm.nih.gov/pmc/articles/PMC3576830/}}@article{schober2018correlation, author={Schober, Patrick and Boer, Christa and Schwarte, Lothar A.}, title={{Correlation coefficients: Appropriate use and interpretation}}, journal={Anesthesia \& Analgesia}, year={2018}, volume={126}, number={5}, pages={1763--1768}, doi={10.1213/ane.0000000000002864}}