Co to jest efekt interakcji?
Efekt interakcji (ang. interaction effect) to parametr modelu statystycznego, który mówi, o ile efekt jednej zmiennej zmienia się wraz z poziomem drugiej. W planie 2 × 2 jest to różnica różnic: efekt czynnika A na drugim poziomie czynnika B minus efekt A na pierwszym poziomie B. Gdy ta różnica wynosi zero, efekty obu czynników po prostu się sumują (model jest addytywny), a linie na wykresie średnich biegną równolegle.
To hasło dotyczy statystycznej strony zjawiska: jak interakcję testuje się w ANOVA i w regresji, jak ją rozłożyć i ile osób potrzeba, by ją wykryć. Merytoryczny sens zależności typu „to zależy” – jak sformułować hipotezę i dobrać wykres – opisujemy w haśle interakcja zmiennych, a uśrednione efekty czynników w haśle efekt główny. Rosnow i Rosenthal (1989) przypominają, że efekt interakcji to reszta, która zostaje w średnich z komórek po usunięciu efektów głównych – a nie same różnice między średnimi w komórkach.
Jak testuje się interakcję: ANOVA i regresja
Dla planu 2 × 2 interakcję zapisuje się jako kontrast czterech średnich z komórek:
W dwuczynnikowej ANOVA ten kontrast testuje składnik A × B ze statystyką F o (a − 1)(b − 1) stopniach swobody licznika. W regresji ten sam test daje współczynnik iloczynu predyktorów:
Przy kodowaniu 0/1 (dummy coding) b3 jest dokładnie różnicą różnic z pierwszego wzoru. Współczynniki b1 i b2 nie są wtedy efektami głównymi, tylko efektami prostymi: b1 to efekt A przy B = 0, a b2 – efekt B przy A = 0. Gdy interakcja ma jeden stopień swobody, test t dla b3 i test F dla A × B to ten sam test: t² = F. Ta sama logika obejmuje predyktory ilościowe – wtedy b3 mówi, o ile zmienia się nachylenie X przy wzroście drugiej zmiennej o jednostkę (zob. moderacja).
Przykład: powiadomienia z telefonu a trudność zadania
Dwieście osób rozwiązywało łamigłówkę łatwą albo trudną, w ciszy albo przy powiadomieniach przychodzących na telefon (dane symulowane, po 50 osób w komórce). Zmienną zależną był czas rozwiązania w sekundach. Pytanie badawcze brzmi: czy powiadomienia spowalniają pracę bardziej przy trudnym zadaniu?
| Trudność | Cisza: M (SD) | Powiadomienia: M (SD) | Efekt prosty powiadomień [95% CI] |
|---|---|---|---|
| Łatwa łamigłówka | 61.10 (19.51) | 95.42 (29.84) | +34.32 s [19.61, 49.03] |
| Trudna łamigłówka | 114.36 (38.99) | 181.86 (52.67) | +67.50 s [52.79, 82.21] |
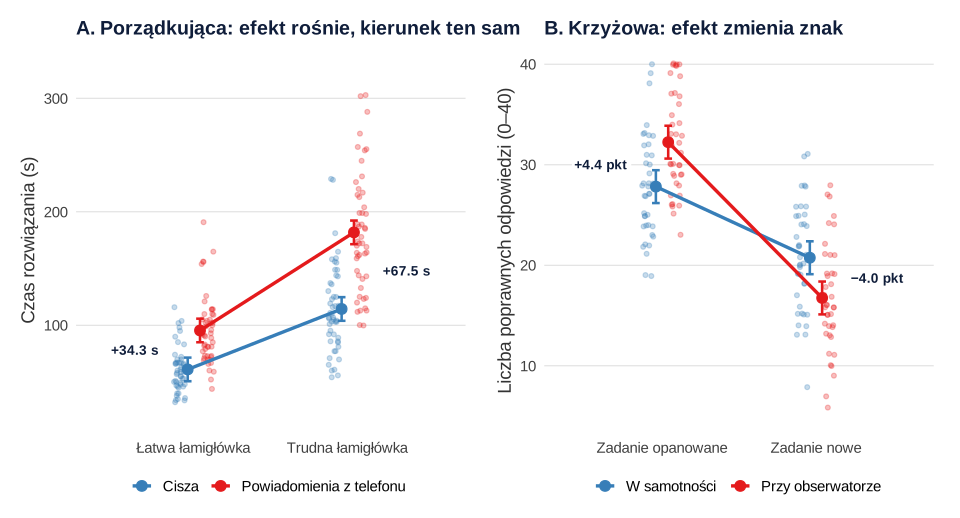
Interakcja rozproszenia i trudności była istotna, F(1, 196) = 9.89, p = .002, η²p = .05, 95% CI [.01, .12]. W regresji z iloczynem zmiennych 0/1 współczynnik interakcji wyniósł b3 = 33.18 s, SE = 10.55, 95% CI [12.37, 53.99], t(196) = 3.14, p = .002 – i rzeczywiście 3.14² ≈ 9.89. To ta sama liczba, którą da odjęcie efektów prostych z tabeli: 67.50 − 34.32 = 33.18 sekundy. Oba efekty główne też były istotne (rozproszenie: F(1, 196) = 93.14; trudność: F(1, 196) = 175.33; oba p < .001), ale przy istotnej interakcji wnioski opiera się na efektach prostych.
Efekt prosty to efekt jednego czynnika przy ustalonym poziomie drugiego. Licz je na średnich z modelu (pakiet emmeans w R, /EMMEANS … COMPARE w SPSS), bo wtedy korzystasz ze wspólnej wariancji błędu i stopni swobody całego modelu. W przykładzie powiadomienia wydłużały rozwiązywanie łatwej łamigłówki o 34.32 s, t(196) = 4.60, p < .001, a trudnej – o 67.50 s, t(196) = 9.05, p < .001. Gdy efektów prostych jest więcej, rozważ korektę Holma albo Bonferroniego (zob. korekta Bonferroniego).
Interakcja porządkująca i krzyżowa
Kształt interakcji opisuje się przez znaki efektów prostych:
- interakcja porządkująca (ang. ordinal) – efekt jednego czynnika ma ten sam kierunek na wszystkich poziomach drugiego, różni się tylko wielkością; w obserwowanym zakresie linie się nie przecinają (rysunek 1A);
- interakcja krzyżowa, nieporządkująca (ang. disordinal, crossover) – efekt zmienia znak; linie się przecinają (rysunek 1B).
Panel B pokazuje drugi zbiór danych (160 osób, dane symulowane): wynik w zadaniu wykonywanym w samotności albo przy obserwatorze. Obecność obserwatora podnosiła wynik w zadaniu dobrze opanowanym o 4.43 pkt, 95% CI [2.11, 6.74], p < .001, a w zadaniu nowym obniżała go o 4.00 pkt, 95% CI [−6.31, −1.69], p < .001. Interakcja była silna, F(1, 156) = 25.88, p < .001, η²p = .14, a efekt główny obserwatora – praktycznie zerowy, F(1, 156) = 0.07, p = .798. Przy interakcji krzyżowej efekt główny może zniknąć, choć oba efekty proste są wyraźne.
Dwie uwagi praktyczne. Po pierwsze, to, czy linie się przecinają, zależy od tego, który czynnik umieścisz na osi X – przykład tej samej interakcji pokazanej na dwa sposoby znajdziesz w haśle interakcja zmiennych. Po drugie, przy predyktorze ilościowym linie zawsze gdzieś się przetną, jeśli nie są równoległe. Liczy się, czy punkt przecięcia leży w zakresie danych. Widaman i in. (2012) pokazali, jak oszacować ten punkt wraz z przedziałem ufności w przeparametryzowanym modelu regresji i w ten sposób formalnie odróżnić interakcję porządkującą od krzyżowej.
Interakcja porządkująca zależy od skali
Interakcję porządkującą często da się „usunąć” rosnącym przekształceniem zmiennej zależnej, np. logarytmem. Wagenmakers i in. (2012), nawiązując do klasycznej pracy Loftusa z 1978 roku, podkreślają, że takie usuwalne interakcje są związane ze skalą pomiaru i nie pozwalają na jednoznaczne wnioski o procesach psychologicznych. Interakcji krzyżowej żadne takie przekształcenie nie usunie.
W przykładzie z powiadomieniami odchylenia standardowe rosną razem ze średnimi (od 19.51 do 52.67 s) – to typowy sygnał, że efekty są proporcjonalne. Po zlogarytmowaniu czasów interakcja znika: F(1, 196) = 0.11, p = .745. Powiadomienia wydłużały rozwiązywanie łatwej łamigłówki 1.57 raza, 95% CI [1.39, 1.77], a trudnej – 1.61 raza, 95% CI [1.43, 1.82]. Wniosek „powiadomienia szkodzą bardziej przy trudnym zadaniu” jest więc prawdziwy w sekundach, ale nie w procentach. Skalę wybierz przed analizą, na podstawie hipotezy (pytasz o różnicę bezwzględną czy względną?), i podaj ją w opisie metody.
Ile osób potrzeba do wykrycia interakcji?
Interakcje wykrywa się trudniej niż efekty główne. Sommet i in. (2023) przeanalizowali 159 badań i ustalili, że mediana mocy wykrycia interakcji typowej wielkości wynosiła zaledwie .18. Przyczyna jest prosta: w zrównoważonym planie 2 × 2 błąd standardowy różnicy różnic jest dwa razy większy niż błąd standardowy efektu głównego, bo do kontrastu wchodzą wszystkie cztery komórki ze współczynnikiem 1, a nie ½. Tabela pokazuje, ile osób potrzeba do mocy .80 (α = .05), gdy efekt prosty w jednej grupie wynosi d = 0.5.
| Kształt interakcji | Efekt prosty w drugiej grupie | Osób w komórce | N łącznie |
|---|---|---|---|
| Odwrócenie (krzyżowa) | d = −0.5 | 32 | 128 |
| Zanik efektu | d = 0 | 127 | 508 |
| Osłabienie o połowę | d = 0.25 | 503 | 2012 |
| Dla porównania: dwie grupy, d = 0.5 | – | 64 w grupie | 128 |
Hipoteza „efekt znika w drugiej grupie” wymaga około czterech razy większej próby niż proste porównanie dwóch grup, a „efekt słabnie o połowę” – około szesnastu razy większej. Przy 200 osobach, jak w naszym przykładzie, moc wykrycia zaniku efektu wynosi zaledwie .42. Brysbaert (2019) szacuje, że przy efekcie d = 0.4 badania z czynnikiem międzygrupowym lub z interakcją wymagają 100, 200 i więcej osób. Sommet i in. (2023) opisują sposoby zwiększenia mocy bez powiększania próby, np. plan mieszany z czynnikiem wewnątrzobiektowym czy prerejestrowane testy jednostronne. Liczebność planuj przed badaniem – pomogą w tym hasło analiza mocy a priori i symulacja mocy w poradniku o moderacji.
Jak opisać efekt interakcji w pracy (APA)
Zacznij od testu interakcji z wielkością efektu, potem opisz efekty proste i różnicę różnic z przedziałami ufności, a efekty główne skomentuj w świetle interakcji. Wzór dla przykładu:
Do opisu dołącz wykres średnich z przedziałami ufności, a pełne wyniki testów F przedstaw w tabeli według wzoru z hasła tabela ANOVA w APA.
Przykład w R
Pierwszy przepis odtwarza przykład z powiadomieniami: test interakcji w ANOVA i w regresji, efekty proste, różnicę różnic oraz analizę na skali logarytmicznej. Drugi liczy liczebności z tabeli mocy. Liczby w tekście i na rysunku 1A pochodzą z tych obliczeń.
Test interakcji, efekty proste i różnica różnic
R
library(emmeans)      # efekty proste i kontrast interakcji
library(effectsize)   # cząstkowe eta kwadrat z 95% CI

# Dane symulowane: plan 2 × 2, po 50 osób w komórce (N = 200)
# Czynnik A: rozproszenie (cisza / powiadomienia z telefonu), czynnik B: trudność łamigłówki (łatwa / trudna)
# Zmienna zależna: czas rozwiązania łamigłówki w sekundach
set.seed(28)
n <- 50
dane <- expand.grid(osoba = 1:n, rozproszenie = c("cisza", "powiadomienia"), trudnosc = c("łatwa", "trudna"))
mu <- log(60) + log(1.5) * (dane$rozproszenie == "powiadomienia") + log(2) * (dane$trudnosc == "trudna")
dane$czas <- round(exp(rnorm(nrow(dane), mu, 0.3)))
aggregate(czas ~ rozproszenie + trudnosc, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))

# 1. ANOVA: test interakcji A × B (kodowanie efektów)
options(contrasts = c("contr.sum", "contr.poly"))
model <- lm(czas ~ rozproszenie * trudnosc, data = dane)
anova(model)
eta_squared(model, partial = TRUE, alternative = "two.sided")

# 2. Ten sam test w regresji: zmienne 0/1 i ich iloczyn
dane$P <- as.numeric(dane$rozproszenie == "powiadomienia")   # 1 = powiadomienia
dane$T <- as.numeric(dane$trudnosc == "trudna")              # 1 = trudna łamigłówka
model_reg <- lm(czas ~ P + T + P:T, data = dane)              # P:T – iloczyn P × T
round(cbind(summary(model_reg)$coefficients, confint(model_reg)), 3)

# 3. Efekty proste rozproszenia i różnica różnic (kontrast interakcji)
emm <- emmeans(model, ~ rozproszenie | trudnosc)
summary(pairs(emm, reverse = TRUE), infer = TRUE)
contrast(emmeans(model, ~ rozproszenie * trudnosc), interaction = "revpairwise", infer = TRUE)

# 4. Ta sama analiza na skali logarytmicznej: czy interakcja zostaje?
model_log <- lm(log(czas) ~ rozproszenie * trudnosc, data = dane)
anova(model_log)
proste_log <- summary(pairs(emmeans(model_log, ~ rozproszenie | trudnosc), reverse = TRUE), infer = TRUE)
round(exp(proste_log[, c("estimate", "lower.CL", "upper.CL")]), 3)   # ilorazy czasów: powiadomienia / cisza
Wynik w R
Welcome to emmeans.
Caution: You lose important information if you filter this package's results.
See '? untidy'
   rozproszenie trudnosc czas.M czas.SD
1         cisza    łatwa  61.10   19.51
2 powiadomienia    łatwa  95.42   29.84
3         cisza   trudna 114.36   38.99
4 powiadomienia   trudna 181.86   52.67
Analysis of Variance Table

Response: czas
                       Df Sum Sq Mean Sq  F value  Pr(>F)
rozproszenie            1 129591  129591  93.1361 < 2e-16 ***
trudnosc                1 243951  243951 175.3254 < 2e-16 ***
rozproszenie:trudnosc   1  13761   13761   9.8902 0.00192 **
Residuals             196 272718    1391
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type I)

Parameter             | Eta2 (partial) |       95% CI
-----------------------------------------------------
rozproszenie          |           0.32 | [0.22, 0.42]
trudnosc              |           0.47 | [0.38, 0.55]
rozproszenie:trudnosc |           0.05 | [0.01, 0.12]
            Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)    61.10      5.275  11.582    0.000 50.696 71.504
P              34.32      7.460   4.600    0.000 19.607 49.033
T              53.26      7.460   7.139    0.000 38.547 67.973
P:T            33.18     10.551   3.145    0.002 12.373 53.987
trudnosc = łatwa:
 contrast              estimate   SE  df lower.CL upper.CL t.ratio p.value
 powiadomienia - cisza     34.3 7.46 196     19.6     49.0   4.600 <0.0001

trudnosc = trudna:
 contrast              estimate   SE  df lower.CL upper.CL t.ratio p.value
 powiadomienia - cisza     67.5 7.46 196     52.8     82.2   9.048 <0.0001

Confidence level used: 0.95
 rozproszenie_revpairwise trudnosc_revpairwise estimate   SE  df lower.CL
 powiadomienia - cisza    trudna - łatwa           33.2 10.6 196     12.4
 upper.CL t.ratio p.value
       54   3.145  0.0019

Confidence level used: 0.95
Analysis of Variance Table

Response: log(czas)
                       Df  Sum Sq Mean Sq  F value Pr(>F)
rozproszenie            1 10.7465 10.7465 112.5953 <2e-16 ***
trudnosc                1 20.0803 20.0803 210.3896 <2e-16 ***
rozproszenie:trudnosc   1  0.0101  0.0101   0.1059 0.7452
Residuals             196 18.7069  0.0954
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  estimate lower.CL upper.CL
1    1.567    1.388    1.770
2    1.613    1.428    1.822
Moc testu interakcji w planie 2 × 2
R
# Moc testu interakcji w planie 2 × 2 (grupy niezależne, α = .05, test dwustronny)
# Efekty proste wyrażone w jednostkach SD (d); interakcja = różnica dwóch efektów prostych
moc_interakcji <- function(n, roznica) {        # n – liczba osób w każdej z 4 komórek
  df <- 4 * n - 4
  ncp <- roznica / sqrt(4 / n)                  # błąd standardowy różnicy różnic = SD × √(4/n)
  t_kr <- qt(0.975, df)
  1 - pt(t_kr, df, ncp) + pt(-t_kr, df, ncp)
}
n_na_komorke <- function(roznica, moc = 0.80) {
  ceiling(uniroot(function(n) moc_interakcji(n, roznica) - moc, c(3, 1e5))$root)
}

# Efekt prosty w jednej grupie d = 0.5, w drugiej: −0.5 (odwrócenie), 0 (zanik), 0.25 (osłabienie o połowę)
uklady <- c(odwrocenie = 0.5 - (-0.5), zanik = 0.5 - 0, oslabienie = 0.5 - 0.25)
n_kom <- sapply(uklady, n_na_komorke)
rbind(n_na_komorke = n_kom, N_lacznie = 4 * n_kom)

# Dla porównania: zwykłe porównanie dwóch grup, d = 0.5
ceiling(power.t.test(delta = 0.5, sd = 1, power = 0.80)$n)

# Moc wykrycia interakcji typu „zanik” przy N = 200 (po 50 osób w komórce)
round(moc_interakcji(50, 0.5), 2)
Wynik w R
             odwrocenie zanik oslabienie
n_na_komorke         32   127        503
N_lacznie           128   508       2012
[1] 64
[1] 0.42
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Wniosek o interakcji z porównania wartości p. To, że efekt jest istotny w jednej grupie, a w drugiej nie, nie dowodzi interakcji – potrzebny jest test różnicy różnic.
- Opisywanie tylko efektów prostych. Efekty proste mieszają interakcję z efektami głównymi; najpierw podaj test interakcji (Rosnow i Rosenthal, 1989).
- Odczytywanie b1 i b2 z modelu z iloczynem jako efektów głównych. To efekty przy zerze drugiej zmiennej.
- Teoretyczne wnioski z interakcji porządkującej bez sprawdzenia skali. Jeśli interakcja znika po logarytmowaniu, może świadczyć o skali pomiaru, a nie o odmiennych procesach (Wagenmakers i in., 2012).
- Zbyt mała próba. Nieistotna interakcja w badaniu z mocą .20–.40 nic nie rozstrzyga; liczebność planuj pod kształt oczekiwanej interakcji (Sommet i in., 2023).
- Wykres bez przedziałów ufności i danych. Dwie linie bez niepewności łatwo przeinterpretować – pokaż średnie z 95% CI i obserwacje, jak na rysunku 1.
Najczęstsze pytania
Co to jest efekt interakcji?
Efekt interakcji opisuje, o ile efekt jednej zmiennej zmienia się w zależności od poziomu drugiej. W planie 2 × 2 jest to różnica różnic: efekt czynnika A przy drugim poziomie B minus efekt A przy pierwszym poziomie B. Gdy wynosi zero, efekty obu czynników się sumują, a linie na wykresie średnich są równoległe.
Jak sprawdzić interakcję w regresji?
Dodaj do modelu iloczyn predyktorów: Y = b0 + b1X + b2W + b3XW. Interakcję testuje współczynnik b3; przy zmiennych 0/1 równa się on różnicy różnic, a jego test t daje to samo p co test F dla A × B w ANOVA (t² = F). W R wystarczy zapis lm(y ~ x * w).
Czym się różni interakcja porządkująca od krzyżowej?
W interakcji porządkującej efekt jednego czynnika ma ten sam kierunek na wszystkich poziomach drugiego i różni się tylko wielkością – linie się nie przecinają. W interakcji krzyżowej efekt zmienia znak, a linie się przecinają. Interakcja porządkująca bywa usuwalna przekształceniem skali (np. logarytmem), krzyżowa – nie.
Jak rozłożyć istotną interakcję w ANOVA na efekty proste?
Opisz efekty proste, czyli efekt jednego czynnika osobno na każdym poziomie drugiego, z 95% przedziałami ufności (w R pakiet emmeans), podaj różnicę różnic i pokaż wykres średnich z przedziałami ufności. Efekty główne interpretuj wtedy ostrożnie – zob. efekt główny.
Ile osób potrzeba, aby wykryć interakcję?
Zwykle znacznie więcej niż do efektu głównego. W planie 2 × 2, gdy efekt d = 0.5 w jednej grupie znika w drugiej, moc .80 daje około 508 osób, a gdy tylko słabnie o połowę – około 2012. Mediana mocy wykrycia interakcji w opublikowanych badaniach wynosiła zaledwie .18 (Sommet i in., 2023).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Moc testu dla interakcji
Dlaczego test interakcji wymaga 4–16 razy większej próby: kształt interakcji, rzetelność iloczynu, symulacja w R i opis analizy mocy.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikInterakcja w ANOVA – jak ją opisać
Co zrobić po istotnej interakcji: wykres, efekty proste na średnich brzegowych, interakcja porządkująca i krzyżowa oraz gotowy wzór opisu APA.
Czytaj →PoradnikSMS i e-mail razem – eksperyment 2 × 2
Sieć gabinetów stomatologicznych: przypomnienie SMS × e-mail, interakcja na dwóch skalach, koszt dodatkowej wizyty i moc dla interakcji – sześć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Brysbaert, M. (2019). How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables. Journal of Cognition, 2(1), Article 16. https://doi.org/10.5334/joc.72 ● Otwarty dostęp
- Rosnow, R. L., & Rosenthal, R. (1989). Definition and interpretation of interaction effects. Psychological Bulletin, 105(1), 143–146. https://doi.org/10.1037/0033-2909.105.1.143
- Sommet, N., Weissman, D. L., Cheutin, N., & Elliot, A. J. (2023). How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction. Advances in Methods and Practices in Psychological Science, 6(3), Article 25152459231178728. https://doi.org/10.1177/25152459231178728 ● Otwarty dostęp
- Wagenmakers, E.-J., Krypotos, A.-M., Criss, A. H., & Iverson, G. (2012). On the interpretation of removable interactions: A survey of the field 33 years after Loftus. Memory & Cognition, 40(2), 145–160. https://doi.org/10.3758/s13421-011-0158-0 ● Otwarty dostęp
- Widaman, K. F., Helm, J. L., Castro-Schilo, L., Pluess, M., Stallings, M. C., & Belsky, J. (2012). Distinguishing ordinal and disordinal interactions. Psychological Methods, 17(4), 615–622. https://doi.org/10.1037/a0030003 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{brysbaert2019how, author={Brysbaert, Marc}, title={{How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables}}, journal={Journal of Cognition}, year={2019}, volume={2}, number={1}, eid={16}, doi={10.5334/joc.72}}@article{rosnow1989definition, author={Rosnow, Ralph L. and Rosenthal, Robert}, title={{Definition and interpretation of interaction effects}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={143--146}, doi={10.1037/0033-2909.105.1.143}}@article{sommet2023how, author={Sommet, Nicolas and Weissman, David L. and Cheutin, Nicolas and Elliot, Andrew J.}, title={{How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction}}, journal={Advances in Methods and Practices in Psychological Science}, year={2023}, volume={6}, number={3}, eid={25152459231178728}, doi={10.1177/25152459231178728}}@article{wagenmakers2012interpretation, author={Wagenmakers, Eric-Jan and Krypotos, Angelos-Miltiadis and Criss, Amy H. and Iverson, Geoff}, title={{On the interpretation of removable interactions: A survey of the field 33 years after Loftus}}, journal={Memory \& Cognition}, year={2012}, volume={40}, number={2}, pages={145--160}, doi={10.3758/s13421-011-0158-0}}@article{widaman2012distinguishing, author={Widaman, Keith F. and Helm, Jonathan L. and Castro-Schilo, Laura and Pluess, Michael and Stallings, Michael C. and Belsky, Jay}, title={{Distinguishing ordinal and disordinal interactions}}, journal={Psychological Methods}, year={2012}, volume={17}, number={4}, pages={615--622}, doi={10.1037/a0030003}}