Statystyka do pracy magisterskiej: czym różni się od licencjatu
W pracy licencjackiej zwykle wystarczą proste testy: porównanie grup, korelacja, chi-kwadrat (pokazujemy to w tekście statystyka do pracy licencjackiej). Praca magisterska stawia wyższą poprzeczkę w trzech miejscach:
- Model zamiast pojedynczej zależności. Hipotezy dotyczą kilku zmiennych naraz: czy predyktor wyjaśnia wynik ponad zmienne kontrolne, czy związek zależy od trzeciej zmiennej (moderacja), czy przebiega przez zmienną pośredniczącą (mediacja).
- Pomiar jako część analizy. Zanim policzysz wyniki skal, sprawdzasz, czy narzędzia mierzą to, co mają mierzyć – zwykle konfirmacyjną analizą czynnikową i współczynnikiem rzetelności.
- Uzasadnienie decyzji. Recenzent zapyta, dlaczego właśnie ten model, te zmienne kontrolne, ten sposób testowania efektu pośredniego. Odpowiedź „tak wyszło w programie” nie wystarczy.
Ten poradnik pokazuje cały proces na jednym przykładzie: plan analiz, liczebność próby, model pomiarowy, regresję hierarchiczną, moderację, mediację, skrócony opis wyników i przygotowanie do obrony. Wszystkie liczby pochodzą z kodu R na końcu strony (dane symulowane), a plik z danymi możesz pobrać i powtórzyć analizę.
Przykładowe badanie i hipotezy
260 studentów wypełniło cztery skale (pozycje 1–5): stresu akademickiego (4 pozycje), ruminacji (4), wypalenia studenckiego (5) i wsparcia społecznego (4). Zebrano też płeć i wiek. Hipotezy brzmią tak:
- H1: Wyższy stres akademicki wiąże się z wyższym wypaleniem, także po uwzględnieniu płci i wieku.
- H2: Ruminacja wyjaśnia dodatkową część zmienności wypalenia ponad stres.
- H3: Wsparcie społeczne moderuje związek stresu z wypaleniem: im wyższe wsparcie, tym słabszy związek.
- H4: Ruminacja pośredniczy w związku stresu z wypaleniem.
Plik do pobrania: statystyka-do-pracy-magisterskiej-dane.csv – 260 wierszy, 20 kolumn (id, płeć, wiek i 17 pozycji skal: STR1–STR4, RUM1–RUM4, WYP1–WYP5, WSP1–WSP4).
Plan analiz przed zebraniem danych
W magisterce plan analiz warto spisać, zanim zobaczysz wyniki – najlepiej jako tabelę dołączoną do konspektu albo wysłaną promotorowi. Nosek i in. (2019) opisują, że rejestrowanie planu z góry pozwala odróżnić analizy zaplanowane od nieplanowanych i ogranicza niezauważoną elastyczność w analizie. Autorzy przyznają przy tym, że podejmowanie decyzji przed analizą wymaga praktyki, a w raporcie trzeba uczciwie opisać zarówno plan, jak i odstępstwa od niego. Nie musisz formalnie rejestrować badania, ale sama tabela daje podobną ochronę. Szczegółowy wzór takiego planu znajdziesz w poradniku plan analizy statystycznej i prerejestracja.
| Krok / hipoteza | Analiza | Kryterium decyzji | Co raportujesz |
|---|---|---|---|
| Pomiar | CFA czterech skal (estymator MLR), omega dla każdej skali | ocena łączna wskaźników dopasowania i ładunków, bez mechanicznych progów | χ², CFI, TLI, RMSEA z 90% CI, SRMR, zakres ładunków, ω |
| H1, H2 | regresja hierarchiczna: blok 1 – płeć i wiek, blok 2 – stres, blok 3 – ruminacja | test F zmiany R² w bloku 2 (H1) i 3 (H2); α = .05 | R², ΔR², F zmiany, b, SE, β, 95% CI, VIF |
| H3 | regresja z interakcją stres × wsparcie (predyktory centrowane) | współczynnik interakcji; efekty proste przy ±1 SD wsparcia | b interakcji z 95% CI, ΔR², efekty proste, przedział Johnsona–Neymana, wykres |
| H4 | model mediacji, efekt pośredni z bootstrapem (5000 prób) | 95% przedział percentylowy efektu pośredniego nie obejmuje zera | ścieżki a, b, c′, efekt pośredni i całkowity z 95% CI |
Zwróć uwagę na kolumnę „Kryterium decyzji”. Zapisanie z góry, co uznasz za potwierdzenie hipotezy, chroni przed pokusą dobierania analizy do wyniku – i jest pierwszą rzeczą, o którą zapyta uważny recenzent.
Ile osób potrzeba do modeli w magisterce
Modele z interakcją i efektem pośrednim wymagają więcej osób niż pojedyncza korelacja. Fritz i MacKinnon (2007) policzyli w symulacjach, ile osób trzeba, by wykryć efekt pośredni z mocą .80. Przy małych ścieżkach a i b bootstrap percentylowy wymagał 558 osób, przy średnich – 78, a przy dużych – 36. Klasyczne podejście kroków przyczynowych wymagało przy małych ścieżkach ponad 20 tysięcy osób. Autorzy zaznaczają, że to dolne granice, bo błąd pomiaru zwiększa potrzebną liczebność. Interakcje w regresji są zwykle małe, więc ich wykrycie także wymaga dużych prób.
W pracy magisterskiej rzadko da się zbadać kilkaset osób. Lakens (2022) wymienia jednak różne prawomocne uzasadnienia liczebności – także ograniczone zasoby – pod warunkiem, że ocenisz, jakie efekty dana próba jest w stanie wykryć. Napisz to wprost w metodzie. Szczegóły i kalkulacje znajdziesz w poradniku dobór liczebności próby i w haśle analiza mocy a priori.
Krok 1. Model pomiarowy: CFA i rzetelność skal
Zanim policzysz wyniki skal, sprawdź, czy pozycje układają się w zakładane czynniki. W przykładzie dopasowano czteroczynnikowy model konfirmacyjnej analizy czynnikowej estymatorem MLR, odpornym na odchylenia od normalności. Wyniki:
- χ²(113) = 134.72, p = .080 (wersja skalowana);
- CFI = .986, TLI = .983, RMSEA = .027, 90% CI [.000, .043], SRMR = .040 (wersje odporne CFI, TLI i RMSEA);
- standaryzowane ładunki od .63 do .79;
- omega: stres .79, ruminacja .80, wypalenie .81, wsparcie .84.
Hu i Bentler (1999) zaproponowali na podstawie symulacji wartości odcięcia bliskie .95 dla CFI i TLI, .06 dla RMSEA i .08 dla SRMR. Zalecili też łączne raportowanie dwóch wskaźników i zauważyli, że przy małych próbach niektóre wskaźniki zbyt często odrzucają prawdziwe modele. Traktuj te wartości jako punkt odniesienia, a nie zero-jedynkowy test – w przykładzie wszystkie wskaźniki wskazują na dobre dopasowanie, więc decyzja jest łatwa. Jak wygląda tabela dopasowania, pokazuje hasło tabela dopasowania modelu CFA w APA, a przejście od analizy eksploracyjnej do konfirmacyjnej – poradnik analiza czynnikowa EFA i CFA.
Jako miarę rzetelności podajemy omegę McDonalda, a nie tylko alfę Cronbacha. McNeish (2018) pokazuje, że nierealistyczne założenia alfy zwykle prowadzą do zaniżania rzetelności, i omawia omegę jako jedną z alternatyw. Korelacje między czynnikami stresu, ruminacji i wypalenia wyniosły od .47 do .56 – są wyraźne, ale na tyle niższe od 1, że skale mierzą różne konstrukty.
Krok 2. Regresja hierarchiczna (H1 i H2)
Wyniki skal policzono jako średnie pozycji. Wypalenie korelowało ze stresem (r = .38) i ruminacją (r = .46), a słabiej i ujemnie ze wsparciem (r = −.17). Regresja hierarchiczna dodaje predyktory blokami i pyta, ile wyjaśnionej wariancji wnosi każdy blok.
| Blok | Predyktory | R² | ΔR² | F zmiany | p |
|---|---|---|---|---|---|
| 1 | płeć, wiek | .014 | – | – | – |
| 2 | + stres | .155 | .141 | F(1, 256) = 48.40 | < .001 |
| 3 | + ruminacja | .257 | .102 | F(1, 255) = 34.86 | < .001 |
W modelu końcowym zarówno stres (b = 0.20, SE = 0.06, 95% CI [0.09, 0.32], β = .22, p < .001), jak i ruminacja (b = 0.35, SE = 0.06, 95% CI [0.23, 0.46], β = .36, p < .001) wiązały się z wypaleniem. Płeć (p = .124) i wiek (p = .282) nie miały znaczenia. Współczynniki VIF nie przekraczały 1.26, więc współliniowość nie stanowiła problemu. Obie hipotezy zostały więc potwierdzone.
Dlaczego płeć i wiek w pierwszym bloku? Nie dlatego, że „tak się robi”. Spector i Brannick (2011) nazywają automatyczne dołączanie zmiennych kontrolnych metodologiczną miejską legendą: te same wyniki mogą powstać przez różne mechanizmy, a kontrola zmiennej demograficznej bez teorii niczego nie „oczyszcza”. Zalecają jawne określenie roli każdej zmiennej kontrolnej. W metodzie napisz więc, dlaczego płeć i wiek mogą wiązać się zarówno ze stresem, jak i z wypaleniem. Jeśli nie masz takiego uzasadnienia, lepiej ich nie dołączać. Zapis tabeli współczynników pokazuje hasło tabela regresji liniowej w APA, a diagnostykę modelu – poradnik regresja wieloraka krok po kroku.
Krok 3. Moderacja: czy wsparcie osłabia związek stresu z wypaleniem? (H3)
Moderacja oznacza, że siła lub kierunek związku zależy od trzeciej zmiennej. Testuje się ją, dodając do regresji iloczyn predyktora i moderatora. Aiken i West (1991) w klasycznym podręczniku pokazują, jak skalowanie predyktorów wpływa na współczynniki w modelu z interakcją. Dlatego przed analizą wycentrowaliśmy stres i wsparcie (odjęliśmy średnie): współczynnik stresu oznacza wtedy jego związek z wypaleniem przy przeciętnym wsparciu.
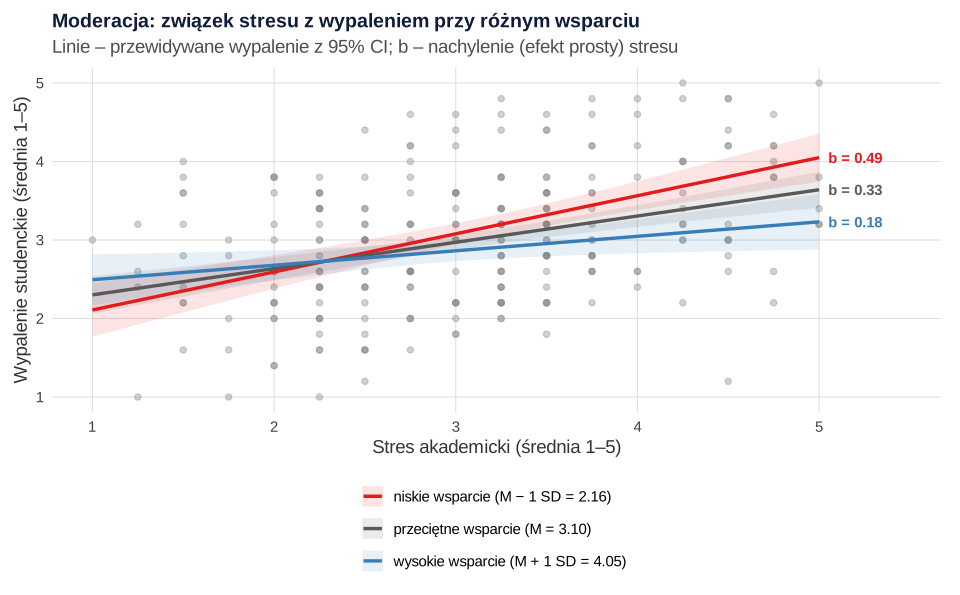
Interakcja stres × wsparcie była istotna: b = −0.16, SE = 0.06, t(256) = −2.77, p = .006, 95% CI [−0.27, −0.05], i wyjaśniała dodatkowe 2.5% wariancji wypalenia (ΔR² = .025). Znak ujemny oznacza, że im wyższe wsparcie, tym słabszy związek stresu z wypaleniem. Efekty proste (nachylenia) stresu wyniosły:
- przy niskim wsparciu (−1 SD): b = 0.49, SE = 0.07, 95% CI [0.34, 0.63], p < .001;
- przy przeciętnym wsparciu: b = 0.33, SE = 0.05, 95% CI [0.23, 0.44], p < .001;
- przy wysokim wsparciu (+1 SD): b = 0.18, SE = 0.08, 95% CI [0.03, 0.34], p = .020.
Przedział Johnsona–Neymana pokazuje, przy jakich wartościach moderatora efekt prosty jest istotny. W przykładzie związek stresu z wypaleniem był istotny dla wsparcia poniżej 4.16 punktu, a nieistotny powyżej – tak wysokie wsparcie zgłosiło 15.4% badanych. Rysunek 1 pokazuje te nachylenia na tle danych.
Istotna interakcja nie zwalnia z pokazania efektów prostych: dopiero one mówią, jak związek wygląda w praktyce. Więcej przykładów, w tym moderację zmienną kategorialną, znajdziesz w poradniku analiza moderacji krok po kroku, a zasady rysowania – w haśle wykres interakcji.
Krok 4. Mediacja: efekt pośredni z bootstrapem (H4)
Mediacja zakłada, że predyktor wiąże się z wynikiem częściowo przez zmienną pośredniczącą. Preacher i Hayes (2008) definiują ją jako pośredni wpływ predyktora na zmienną zależną przez co najmniej jeden mediator i omawiają testowanie efektu pośredniego metodą bootstrap. Podręcznik Hayesa (2022) przedstawia całość – mediację, moderację i ich połączenia – w ramach regresji.
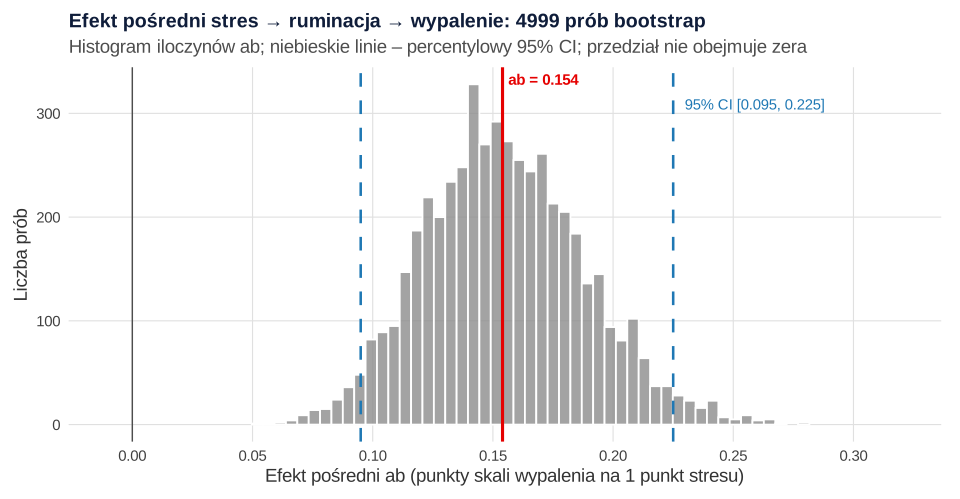
W przykładzie stres wiązał się z ruminacją (ścieżka a = 0.439, 95% CI [0.344, 0.535]), a ruminacja z wypaleniem przy kontroli stresu (ścieżka b = 0.352, 95% CI [0.226, 0.481]). Efekt pośredni ab wyniósł 0.154, a 95% percentylowy przedział bootstrap z 5000 prób (jedna się nie powiodła, wykorzystano 4999) – [0.095, 0.225]. Wartości efektu pośredniego podajemy z trzema miejscami po kropce, bo są małe. Przedział nie obejmuje zera, więc hipoteza 4 została potwierdzona. Efekt bezpośredni pozostał istotny (c′ = 0.204, 95% CI [0.082, 0.328]), a efekt całkowity wyniósł 0.358, 95% CI [0.246, 0.473]. W jednostkach całkowicie standaryzowanych efekt pośredni wyniósł .162.
Dwie rzeczy, które warto umieć wyjaśnić na obronie. Po pierwsze, nie potrzebujesz istotnego efektu całkowitego ani „kroków” Barona i Kenny’ego, żeby testować mediację. Zhao i in. (2010) pokazują słabości tej logiki i proponują testować bezpośrednio efekt pośredni. Po drugie, mediacja w badaniu przekrojowym nie dowodzi procesu w czasie. Maxwell i Cole (2007) wykazali, że przekrojowe analizy mediacji procesów rozwijających się w czasie dają zwykle wyraźnie obciążone oszacowania, nawet w idealnych warunkach. W dyskusji pisz więc o „wzorcu zgodnym z mediacją”, a nie o „mechanizmie”. Krok po kroku, także w PROCESS i lavaan, pokazuje poradnik analiza mediacji krok po kroku.
Jak opisać te wyniki w pracy (APA)
Każdy krok planu analiz to osobny akapit rozdziału wyników, w kolejności hipotez. Poniższe wzory możesz dostosować do własnych danych. Tabelę ścieżek mediacji przygotujesz według hasła tabela mediacji w APA.
Obrona wyników: pytania, które padają najczęściej
Na obronie pracy magisterskiej rzadko pytają o wzory. Pytają o decyzje. Przygotuj krótką odpowiedź na każde z poniższych pytań – w odniesieniu do własnych danych.
| Pytanie komisji | Zarys odpowiedzi |
|---|---|
| Dlaczego CFA, a nie eksploracyjna analiza czynnikowa? | Skale mają ustaloną strukturę z wcześniejszych badań, więc sprawdzałem(-am) ją, a nie odkrywałem(-am). EFA byłaby właściwa przy nowym narzędziu. |
| Czy RMSEA = .027 oznacza, że model jest prawdziwy? | Nie. Oznacza, że model dobrze odtwarza dane; inne modele mogą pasować równie dobrze. Progi dopasowania to wskazówki, a nie test prawdziwości. |
| Po co centrowanie w moderacji? | Żeby współczynniki stresu i wsparcia oznaczały efekty przy przeciętnej wartości drugiej zmiennej. Test interakcji się nie zmienia. |
| Interakcja wyjaśnia tylko 2.5% wariancji. Czy to ma znaczenie? | Efekty interakcji w badaniach korelacyjnych są zwykle małe; ważniejsze jest to, że nachylenie przy niskim wsparciu jest wyraźnie większe niż przy wysokim (0.49 wobec 0.18). |
| Dlaczego bootstrap, a nie test Sobela? | Rozkład iloczynu ab zwykle nie jest normalny, a przedział bootstrap tego nie zakłada; w symulacjach Fritza i MacKinnona (2007) bootstrap wymagał mniejszych prób niż test Sobela. |
| Czy ruminacja powoduje wypalenie? | Badanie przekrojowe tego nie rozstrzyga. Wynik jest zgodny z hipotezą mediacji, ale kierunek mógłby być też odwrotny; potrzebne byłyby pomiary w czasie. |
Więcej pytań z przykładowymi odpowiedziami zebraliśmy w tekście pytania na obronie z metodologii i statystyki, a sposób przełożenia tych wyników na wnioski – w poradniku jak napisać dyskusję wyników.
Kiedy skorzystać z konsultacji statystycznej
Modele z tego poradnika wykraczają poza program wielu kursów statystyki, więc konsultacja jest w magisterce czymś naturalnym – zwłaszcza przy CFA, interakcjach i bootstrapie. Najwięcej daje na dwóch etapach: przy planie analiz (zanim zbierzesz dane) i przy interpretacji wyników (zanim napiszesz dyskusję). W ramach oferty analiz statystycznych dla studentów sprawdzamy plan, wykonujemy analizy z raportem i omawiamy każdą decyzję tak, abyś umiał(a) ją sam(a) uzasadnić przed komisją. Pracę piszesz Ty: musisz rozumieć każdy wynik i ujawnić pomoc zgodnie z zasadami uczelni.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Pobierz plik statystyka-do-pracy-magisterskiej-dane.csv, zapisz go w katalogu roboczym R i uruchom przepisy 2–5. Przepis 1 pokazuje, jak powstały dane. Bootstrap w przepisie 5 (5000 prób) trwa około dwóch–trzech minut; przepis 5 zapisuje też plik kod/p29-bootstrap-ab.rds z próbami do rysunku 2, więc przed uruchomieniem utwórz w katalogu roboczym folder kod.
1. Dane symulowane: 260 studentów, cztery skale
R
# P29 – dane symulowane: badanie kwestionariuszowe 260 studentów do pracy magisterskiej
# Stres akademicki (STR), ruminacja (RUM), wypalenie studenckie (WYP) i wsparcie społeczne (WSP); pozycje 1–5.
# Tworzy plik CSV do pobrania. Uruchom z katalogu strony (strony/P29):  Rscript kod/p29-0-dane.R
set.seed(2910)
N <- 260
plec <- sample(c("K", "M"), N, replace = TRUE, prob = c(.7, .3))
wiek <- sample(21:27, N, replace = TRUE, prob = c(.12, .26, .27, .17, .09, .05, .04))
stres <- rnorm(N)
wsparcie <- -0.20 * stres + rnorm(N, sd = sqrt(1 - 0.04))
ruminacja <- 0.45 * stres + rnorm(N, sd = sqrt(1 - 0.45^2))
wypalenie <- 0.25 * stres + 0.35 * ruminacja - 0.20 * wsparcie - 0.24 * stres * wsparcie + rnorm(N, sd = 0.78)
pozycje <- function(cecha, lad, przedrostek) {
  cecha <- as.numeric(scale(cecha))
  m <- sapply(lad, function(l) {
    x <- l * cecha + rnorm(N, sd = sqrt(1 - l^2))
    as.integer(cut(x, breaks = c(-Inf, -1.35, -0.45, 0.4, 1.25, Inf)))
  })
  colnames(m) <- paste0(przedrostek, seq_along(lad)); m
}
dane <- data.frame(id = 1:N, plec, wiek,
                   pozycje(stres, c(.78, .72, .70, .66), "STR"),
                   pozycje(ruminacja, c(.80, .76, .71, .68), "RUM"),
                   pozycje(wypalenie, c(.79, .75, .73, .70, .62), "WYP"),
                   pozycje(wsparcie, c(.81, .77, .74, .69), "WSP"))
write.csv(dane, "statystyka-do-pracy-magisterskiej-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
dim(read.csv("statystyka-do-pracy-magisterskiej-dane.csv"))
Wynik w R
[1] 260 202. Model pomiarowy: CFA i omega
R
# P29 – krok 1: model pomiarowy (CFA) i rzetelność skal (omega) – dane symulowane
library(lavaan)     # cfa()
library(semTools)   # compRelSEM(): omega dla każdego czynnika

dane <- read.csv("statystyka-do-pracy-magisterskiej-dane.csv")
model_pomiarowy <- '
  stres     =~ STR1 + STR2 + STR3 + STR4
  ruminacja =~ RUM1 + RUM2 + RUM3 + RUM4
  wypalenie =~ WYP1 + WYP2 + WYP3 + WYP4 + WYP5
  wsparcie  =~ WSP1 + WSP2 + WSP3 + WSP4
'
cfa_fit <- cfa(model_pomiarowy, data = dane, estimator = "MLR")
round(fitMeasures(cfa_fit, c("chisq.scaled", "df", "pvalue.scaled", "cfi.robust", "tli.robust",
                             "rmsea.robust", "rmsea.ci.lower.robust", "rmsea.ci.upper.robust", "srmr")), 3)
lad <- standardizedSolution(cfa_fit)
lad <- lad[lad$op == "=~", c("lhs", "rhs", "est.std")]
aggregate(est.std ~ lhs, data = lad, FUN = function(x) round(range(x), 2))
round(unlist(compRelSEM(cfa_fit)), 2)                    # omega (rzetelność złożona) dla każdej skali
# korelacje między czynnikami
round(lavInspect(cfa_fit, "cor.lv"), 2)
Wynik w R
         chisq.scaled                    df         pvalue.scaled
              134.723               113.000                 0.080
           cfi.robust            tli.robust          rmsea.robust
                0.986                 0.983                 0.027
rmsea.ci.lower.robust rmsea.ci.upper.robust                  srmr
                0.000                 0.043                 0.040
        lhs est.std.1 est.std.2
1 ruminacja      0.66      0.78
2     stres      0.66      0.78
3  wsparcie      0.73      0.79
4 wypalenie      0.63      0.73
    stres ruminacja wypalenie  wsparcie
     0.79      0.80      0.81      0.84
          stres rumncj wypaln wsparc
stres      1.00
ruminacja  0.56   1.00
wypalenie  0.47   0.55   1.00
wsparcie  -0.17  -0.13  -0.21   1.00
3. Regresja hierarchiczna
R
# P29 – krok 2: wyniki skal i regresja hierarchiczna (blok 1: płeć i wiek, blok 2: stres, blok 3: ruminacja)
dane <- read.csv("statystyka-do-pracy-magisterskiej-dane.csv")
skala <- function(prefiks) rowMeans(dane[, grep(paste0("^", prefiks), names(dane))])
dane$stres <- skala("STR"); dane$ruminacja <- skala("RUM"); dane$wypalenie <- skala("WYP"); dane$wsparcie <- skala("WSP")
dane$kobieta <- as.integer(dane$plec == "K")
round(sapply(dane[, c("stres", "ruminacja", "wypalenie", "wsparcie")], function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(dane[, c("stres", "ruminacja", "wypalenie", "wsparcie")]), 2)

m1 <- lm(wypalenie ~ kobieta + wiek, data = dane)
m2 <- update(m1, . ~ . + stres)
m3 <- update(m2, . ~ . + ruminacja)
r2 <- sapply(list(m1, m2, m3), function(m) summary(m)$r.squared)
round(c(R2_1 = r2[1], R2_2 = r2[2], R2_3 = r2[3], dR2_2 = r2[2] - r2[1], dR2_3 = r2[3] - r2[2]), 3)
anova(m1, m2, m3)                                  # test F zmiany R² dla kolejnych bloków
# współczynniki modelu końcowego: b, SE, t, p, 95% CI i beta (standaryzowane)
wsp <- cbind(summary(m3)$coefficients, confint(m3))
beta <- coef(lm(scale(wypalenie) ~ scale(kobieta) + scale(wiek) + scale(stres) + scale(ruminacja), data = dane))
round(cbind(wsp, beta = beta), 3)
round(cbind(b = coef(m3), confint(m3), beta = beta), 2)   # to samo z dwoma miejscami po kropce (do tekstu)
car::vif(m3)
Wynik w R
   stres ruminacja wypalenie wsparcie
M   3.06      3.05      3.01     3.10
SD  0.89      0.87      0.84     0.94
          stres ruminacja wypalenie wsparcie
stres      1.00      0.45      0.38    -0.13
ruminacja  0.45      1.00      0.46    -0.11
wypalenie  0.38      0.46      1.00    -0.17
wsparcie  -0.13     -0.11     -0.17     1.00
 R2_1  R2_2  R2_3 dR2_2 dR2_3
0.014 0.155 0.257 0.141 0.102
Analysis of Variance Table

Model 1: wypalenie ~ kobieta + wiek
Model 2: wypalenie ~ kobieta + wiek + stres
Model 3: wypalenie ~ kobieta + wiek + stres + ruminacja
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    257 181.32
2    256 155.38  1    25.942 48.395 2.926e-11 ***
3    255 136.69  1    18.689 34.864 1.123e-08 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %   beta
(Intercept)    1.972      0.747   2.640    0.009  0.501  3.443  0.000
kobieta        0.157      0.102   1.542    0.124 -0.044  0.358  0.083
wiek          -0.033      0.031  -1.077    0.282 -0.094  0.027 -0.058
stres          0.205      0.057   3.563    0.000  0.092  0.318  0.215
ruminacja      0.348      0.059   5.905    0.000  0.232  0.464  0.357
                b 2.5 % 97.5 %  beta
(Intercept)  1.97  0.50   3.44  0.00
kobieta      0.16 -0.04   0.36  0.08
wiek        -0.03 -0.09   0.03 -0.06
stres        0.20  0.09   0.32  0.22
ruminacja    0.35  0.23   0.46  0.36
  kobieta      wiek     stres ruminacja
 1.000782  1.003186  1.252879  1.255893
4. Moderacja: interakcja, efekty proste i przedział Johnsona–Neymana
R
# P29 – krok 3: moderacja – czy wsparcie społeczne osłabia związek stresu z wypaleniem?
library(interactions)   # sim_slopes(): efekty proste i przedział Johnsona–Neymana
dane <- read.csv("statystyka-do-pracy-magisterskiej-dane.csv")
skala <- function(prefiks) rowMeans(dane[, grep(paste0("^", prefiks), names(dane))])
dane$stres <- skala("STR"); dane$wypalenie <- skala("WYP"); dane$wsparcie <- skala("WSP")
dane$stres_c <- dane$stres - mean(dane$stres)            # centrowanie predyktorów
dane$wsparcie_c <- dane$wsparcie - mean(dane$wsparcie)

mod <- lm(wypalenie ~ stres_c * wsparcie_c, data = dane)
round(cbind(summary(mod)$coefficients, confint(mod)), 3)
round(cbind(b = coef(mod), SE = sqrt(diag(vcov(mod))), confint(mod)), 2)
bez_interakcji <- lm(wypalenie ~ stres_c + wsparcie_c, data = dane)
round(c(dR2_interakcja = summary(mod)$r.squared - summary(bez_interakcji)$r.squared), 3)
round(sd(dane$wsparcie_c), 2)
ss <- sim_slopes(mod, pred = stres_c, modx = wsparcie_c, johnson_neyman = TRUE, digits = 3)
ss
round(as.data.frame(ss$slopes), 2)   # efekty proste z 95% CI (dwa miejsca po kropce)
# granica Johnsona–Neymana w jednostkach skali wsparcia (1–5) i odsetek osób powyżej niej
granica <- ss$jn[[1]]$bounds[1]
round(c(granica_skala = unname(granica) + mean(dane$wsparcie), proc_powyzej = 100 * mean(dane$wsparcie_c > granica)), 2)
Wynik w R
                   Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)           2.991      0.048  62.319    0.000  2.896  3.085
stres_c               0.335      0.054   6.157    0.000  0.228  0.442
wsparcie_c           -0.124      0.051  -2.421    0.016 -0.225 -0.023
stres_c:wsparcie_c   -0.159      0.058  -2.768    0.006 -0.273 -0.046
                       b   SE 2.5 % 97.5 %
(Intercept)         2.99 0.05  2.90   3.09
stres_c             0.33 0.05  0.23   0.44
wsparcie_c         -0.12 0.05 -0.22  -0.02
stres_c:wsparcie_c -0.16 0.06 -0.27  -0.05
dR2_interakcja
         0.025
[1] 0.94
JOHNSON-NEYMAN INTERVAL

When wsparcie_c is OUTSIDE the interval [1.062, 7.557], the slope of
stres_c is p < .05.

Note: The range of observed values of wsparcie_c is [-2.102, 1.898]

SIMPLE SLOPES ANALYSIS

Slope of stres_c when wsparcie_c = -9.445005e-01 (- 1 SD):

   Est.    S.E.   t val.       p
------- ------- -------- -------
  0.485   0.075    6.495   0.000

Slope of stres_c when wsparcie_c = -8.198570e-17 (Mean):

   Est.    S.E.   t val.       p
------- ------- -------- -------
  0.335   0.054    6.157   0.000

Slope of stres_c when wsparcie_c =  9.445005e-01 (+ 1 SD):

   Est.    S.E.   t val.       p
------- ------- -------- -------
  0.184   0.079    2.332   0.020

  Value of wsparcie_c Est. S.E. 2.5% 97.5% t val.    p
1               -0.94 0.49 0.07 0.34  0.63   6.49 0.00
2                0.00 0.33 0.05 0.23  0.44   6.16 0.00
3                0.94 0.18 0.08 0.03  0.34   2.33 0.02
granica_skala  proc_powyzej
         4.16         15.38
5. Mediacja: efekt pośredni z bootstrapem
R
# P29 – krok 4: mediacja – stres → ruminacja → wypalenie, efekt pośredni z bootstrapem (5000 prób)
library(lavaan)
dane <- read.csv("statystyka-do-pracy-magisterskiej-dane.csv")
skala <- function(prefiks) rowMeans(dane[, grep(paste0("^", prefiks), names(dane))])
dane$stres <- skala("STR"); dane$ruminacja <- skala("RUM"); dane$wypalenie <- skala("WYP")

model_mediacji <- '
  ruminacja ~ a * stres
  wypalenie ~ b * ruminacja + c_prim * stres
  posredni  := a * b
  calkowity := c_prim + a * b
'
set.seed(2911)
med <- sem(model_mediacji, data = dane, se = "bootstrap", bootstrap = 5000)
pe <- parameterEstimates(med, boot.ci.type = "perc")
pe <- pe[pe$label %in% c("a", "b", "c_prim", "posredni", "calkowity"), c("label", "est", "se", "pvalue", "ci.lower", "ci.upper")]
pe[, -1] <- round(pe[, -1], 3); print(pe, row.names = FALSE)
# efekt pośredni w jednostkach standaryzowanych (całkowicie standaryzowany)
ss <- standardizedSolution(med)
round(ss[ss$label == "posredni", "est.std"], 3)
# zapis prób bootstrapowych efektu pośredniego (do rysunku)
boot_ab <- lavInspect(med, "boot")
ab <- na.omit(boot_ab[, "a"] * boot_ab[, "b"])        # pomijamy ewentualne nieudane próby
saveRDS(ab, "kod/p29-bootstrap-ab.rds")
length(ab)                                         # liczba udanych prób bootstrapowych
Wynik w R
     label   est    se pvalue ci.lower ci.upper
         a 0.439 0.049  0.000    0.344    0.535
         b 0.352 0.065  0.000    0.226    0.481
    c_prim 0.204 0.063  0.001    0.082    0.328
  posredni 0.154 0.033  0.000    0.095    0.225
 calkowity 0.358 0.058  0.000    0.246    0.473
[1] 0.162
[1] 4999
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (Version 0.5-8) [R package]. https://doi.org/10.32614/CRAN.package.semTools
- interactions (wersja 1.2.0): Long, J. A. (2024). interactions: Comprehensive, user-friendly toolkit for probing interactions [R package]. https://doi.org/10.32614/CRAN.package.interactions
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Jakie analizy statystyczne są typowe dla pracy magisterskiej?
Poza statystykami opisowymi i rzetelnością skal najczęściej pojawiają się regresja wieloraka lub hierarchiczna, moderacja (interakcja w regresji), mediacja z bootstrapem efektu pośredniego oraz konfirmacyjna analiza czynnikowa narzędzi. Dobór zależy od hipotez: każda powinna mieć jedną, z góry zaplanowaną analizę.
Czym regresja hierarchiczna różni się od zwykłej regresji wielorakiej?
To ta sama regresja, ale predyktory wprowadzasz blokami w kolejności wynikającej z hipotez, np. najpierw zmienne kontrolne, potem główny predyktor. Dla każdego bloku raportujesz zmianę R² i test F tej zmiany, co pokazuje, ile wariancji wyjaśnia blok ponad poprzednie.
Ile osób potrzeba do analizy mediacji w pracy magisterskiej?
Zależy to od wielkości ścieżek. Według symulacji Fritza i MacKinnona (2007) bootstrap percentylowy potrzebuje do mocy .80 około 78 osób przy średnich ścieżkach a i b, ale około 558 przy małych. To dolne granice, bo błąd pomiaru zwiększa potrzebną liczebność.
Czy w pracy magisterskiej trzeba robić konfirmacyjną analizę czynnikową?
Nie zawsze, ale jest dobrze widziana, gdy używasz kilku skal o ustalonej strukturze albo narzędzia w nowej grupie. Pokazuje, że pozycje układają się w zakładane czynniki, zanim policzysz z nich wyniki. Przy nowym narzędziu właściwsza jest najpierw eksploracyjna analiza czynnikowa.
Jak przygotować się do pytań o statystykę na obronie magisterki?
Dla każdej analizy przygotuj jedno–dwa zdania: dlaczego ją wybrałeś(-aś), co oznacza najważniejszy wynik i czego ten wynik nie dowodzi. Komisja pyta zwykle o decyzje – zmienne kontrolne, sposób testowania efektu pośredniego, przyczynowość w badaniu przekrojowym – a nie o wzory.
Powiązane hasła
Przeczytaj też
Licencjat, magisterka, doktorat
Czego zwykle oczekuje się od części empirycznej na trzech poziomach: tabela, jedno zagadnienie w trzech planach i typowe przestrzelenia.
Czytaj →PoradnikStatystyka do pracy licencjackiej
Typowe plany analiz w licencjacie, co przygotować przed analizą i przykład z danymi CSV: alfa, korelacja, test t Welcha, chi-kwadrat i skrócony rozdział wyników.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikPytania na obronie z metodologii i statystyki
38 pytań komisji o hipotezy, schemat, próbę, narzędzia, analizy i wyniki – z przykładowymi odpowiedziami, ściągą na jedną stronę i planem przygotowania.
Czytaj →PoradnikPytania ze statystyki na obronę magisterską
Pytania promotora i recenzenta ułożone według analizy – od testu t i chi-kwadrat po regresję, ANOVA i alfę Cronbacha – z krótkimi odpowiedziami na liczbach.
Czytaj →Masz w magisterce moderację, mediację albo CFA?
Sprawdzimy plan analiz, wykonamy modele z raportem i omówimy każdą decyzję tak, abyś umiał(a) samodzielnie obronić wyniki przed komisją.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage.
- Fritz, M. S., & MacKinnon, D. P. (2007). Required sample size to detect the mediated effect. Psychological Science, 18(3), 233–239. https://doi.org/10.1111/j.1467-9280.2007.01882.x ● Otwarty dostęp: pełny tekst
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Maxwell, S. E., & Cole, D. A. (2007). Bias in cross-sectional analyses of longitudinal mediation. Psychological Methods, 12(1), 23–44. https://doi.org/10.1037/1082-989x.12.1.23
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Nosek, B. A., Beck, E. D., Campbell, L., Flake, J. K., Hardwicke, T. E., Mellor, D. T., van ’t Veer, A. E., & Vazire, S. (2019). Preregistration is hard, and worthwhile. Trends in Cognitive Sciences, 23(10), 815–818. https://doi.org/10.1016/j.tics.2019.07.009 ● Otwarty dostęp: pełny tekst
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879 ● Otwarty dostęp
- Spector, P. E., & Brannick, M. T. (2011). Methodological urban legends: The misuse of statistical control variables. Organizational Research Methods, 14(2), 287–305. https://doi.org/10.1177/1094428110369842
- Zhao, X., Lynch, J. G., & Chen, Q. (2010). Reconsidering Baron and Kenny: Myths and truths about mediation analysis. Journal of Consumer Research, 37(2), 197–206. https://doi.org/10.1086/651257 ● Otwarty dostęp
Cytowania BibTeX
@book{aiken1991multiple, author={Aiken, Leona S. and West, Stephen G.}, title={{Multiple regression: Testing and interpreting interactions}}, year={1991}, publisher={Sage}}@article{fritz2007required, author={Fritz, Matthew S. and MacKinnon, David P.}, title={{Required sample size to detect the mediated effect}}, journal={Psychological Science}, year={2007}, volume={18}, number={3}, pages={233--239}, doi={10.1111/j.1467-9280.2007.01882.x}}@book{hayes2022introduction, author={Hayes, Andrew F.}, title={{Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{maxwell2007bias, author={Maxwell, Scott E. and Cole, David A.}, title={{Bias in cross-sectional analyses of longitudinal mediation}}, journal={Psychological Methods}, year={2007}, volume={12}, number={1}, pages={23--44}, doi={10.1037/1082-989x.12.1.23}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{nosek2019preregistration, author={Nosek, Brian A. and Beck, Emorie D. and Campbell, Lorne and Flake, Jessica K. and Hardwicke, Tom E. and Mellor, David T. and van ’t Veer, Anna E. and Vazire, Simine}, title={{Preregistration is hard, and worthwhile}}, journal={Trends in Cognitive Sciences}, year={2019}, volume={23}, number={10}, pages={815--818}, doi={10.1016/j.tics.2019.07.009}}@article{preacher2008asymptotic, author={Preacher, Kristopher J. and Hayes, Andrew F.}, title={{Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models}}, journal={Behavior Research Methods}, year={2008}, volume={40}, number={3}, pages={879--891}, doi={10.3758/brm.40.3.879}}@article{spector2011methodological, author={Spector, Paul E. and Brannick, Michael T.}, title={{Methodological urban legends: The misuse of statistical control variables}}, journal={Organizational Research Methods}, year={2011}, volume={14}, number={2}, pages={287--305}, doi={10.1177/1094428110369842}}@article{zhao2010reconsidering, author={Zhao, Xinshu and Lynch, John G. and Chen, Qimei}, title={{Reconsidering Baron and Kenny: Myths and truths about mediation analysis}}, journal={Journal of Consumer Research}, year={2010}, volume={37}, number={2}, pages={197--206}, doi={10.1086/651257}}