Statystyka do pracy licencjackiej: czego naprawdę się oczekuje
Praca licencjacka z częścią empiryczną nie musi zawierać zaawansowanych modeli. Promotor i recenzent sprawdzają przede wszystkim, czy hipotezy da się zweryfikować zebranymi danymi, czy analiza do nich pasuje i czy wynik jest opisany poprawnie i ostrożnie. W praktyce oznacza to zwykle kilka elementów:
- opis próby i statystyki opisowe głównych zmiennych;
- wyniki skal policzone zgodnie z kluczem, z oceną rzetelności;
- 2–4 hipotezy sprawdzone prostymi testami: porównaniem grup, korelacją albo testem chi-kwadrat;
- przy każdym teście – wielkość efektu, a najlepiej także przedział ufności;
- krótki, zrozumiały rozdział wyników z tabelami i jednym–dwoma rysunkami.
To mniej, niż wymaga się w pracy magisterskiej, gdzie częściej pojawiają się regresja hierarchiczna, moderacja, mediacja czy analiza czynnikowa (piszemy o nich w tekście statystyka do pracy magisterskiej). W licencjacie ważniejsza od złożoności jest poprawność: dobrze opisana korelacja z przedziałem ufności jest lepsza niż model, którego autor nie umie wyjaśnić. Jeśli dopiero zaczynasz i potrzebujesz szerszego obrazu, przeczytaj najpierw przewodnik statystyka dla studenta.
Ten poradnik pokazuje cztery typowe plany analiz, listę rzeczy do przygotowania przed analizą i kompletny, mały przykład: od pliku z ankiety do skróconego rozdziału wyników. Wszystkie liczby pochodzą z kodu R na końcu strony, a dane możesz pobrać i przećwiczyć analizę samodzielnie.
Cztery typowe plany analiz w pracy licencjackiej
Większość licencjackich badań empirycznych to jedna z czterech konstrukcji. Rozpoznaj swoją, a dobór analizy stanie się prosty.
| Plan badania | Przykładowa hipoteza | Główna analiza | Gdy założenia zawodzą | Wielkość efektu |
|---|---|---|---|---|
| Związek dwóch zmiennych ilościowych | Im więcej czasu w mediach społecznościowych, tym niższa jakość snu. | korelacja Pearsona | korelacja Spearmana | r z 95% CI |
| Porównanie dwóch grup | Kobiety spędzają w mediach więcej czasu niż mężczyźni. | test t Welcha | test U Manna–Whitneya | d Cohena z 95% CI |
| Porównanie trzech grup lub więcej | Satysfakcja ze studiów różni się między latami studiów. | ANOVA (wersja Welcha) | test Kruskala–Wallisa | η² lub ω² |
| Związek dwóch zmiennych jakościowych | Osoby używające telefonu w łóżku częściej mają problemy z zasypianiem. | test chi-kwadrat | dokładny test Fishera | φ albo V Craméra |
Każdy wiersz ma osobny poradnik krok po kroku z kodem i opisem APA: korelacja Pearsona i Spearmana, test t Studenta, ANOVA, test chi-kwadrat oraz testy nieparametryczne.
Dwie decyzje warto podjąć z góry, zanim zobaczysz dane:
- Do porównania dwóch grup wybierz test Welcha. Delacre i in. (2017) pokazują, że założenie równych wariancji rzadko jest spełnione w psychologii, a dobór testu na podstawie wstępnego testu równości wariancji często zawodzi. Test Welcha lepiej kontroluje błąd I rodzaju i niewiele traci, gdy wariancje są równe. Nie musisz więc najpierw liczyć testu Levene’a.
- Nie zmieniaj testu na nieparametryczny tylko z powodu skali Likerta. Norman (2010) przypomina, że ANOVA, regresja i korelacja są odporne na naruszenia założeń także przy danych ze skal Likerta. Test nieparametryczny wybierz wtedy, gdy rozkład jest wyraźnie skośny, ma wartości odstające albo zmienna ma tylko kilka poziomów. Schober i in. (2018) przypominają, że korelacja Spearmana opisuje związek monotoniczny i jest właściwa dla danych porządkowych, nienormalnych lub z obserwacjami odstającymi.
Plan zapisz, zanim zaczniesz liczyć. Simmons i in. (2011) pokazali, że swoboda w wyborze analiz – próbowanie kilku testów, różnych sposobów liczenia wyniku czy wykluczania osób – radykalnie zwiększa liczbę fałszywie pozytywnych wyników. W pracy licencjackiej nikt nie wymaga formalnej prerejestracji, ale krótka lista „hipoteza – zmienne – test” wysłana promotorowi chroni przed tą pułapką.
Co przygotować przed analizą
Najwięcej czasu w analizie licencjackiej nie zajmują testy, tylko porządkowanie danych. Zanim otworzysz program statystyczny, przygotuj:
- Bazę danych w układzie „osoba = wiersz, zmienna = kolumna”, z krótkimi nazwami kolumn bez polskich znaków i spacji. Jak to zrobić, pokazuje poradnik jak przygotować bazę danych do analizy, a dane z formularzy online – tekst dane z Google Forms i LimeSurvey.
- Książkę kodową: co oznacza każda kolumna, jakie ma wartości (np. 1 = „zdecydowanie się nie zgadzam”) i jak oznaczono braki danych.
- Klucz każdej skali: które pozycje tworzą wynik, czy liczyć sumę, czy średnią, i które pozycje są odwrócone. Klucz bierzesz z podręcznika narzędzia albo artykułu walidacyjnego, a nie „na oko”.
- Listę hipotez z przypisanymi zmiennymi i testami – na jednej stronie.
- Informacje o zbieraniu danych: kiedy, gdzie, ile osób otworzyło ankietę, ile ją ukończyło, ile wykluczono i dlaczego. Ankiety online warto przejrzeć pod kątem nieuważnych odpowiedzi.
- Wymagania promotora: program, format tabel, czy wyniki mają być w tekście, w tabelach, czy w obu miejscach.
Jeśli robisz to po raz pierwszy, zacznij od małej próby testowej: wpisz odpowiedzi trzech znajomych i sprawdź, czy z bazy da się policzyć wszystko, co planujesz. Taki pilotaż bazy oszczędza wiele godzin.
Ile osób zbadać do licencjatu?
Pytanie o liczebność próby pada na każdym seminarium. Uczciwa odpowiedź zależy od tego, jak duży efekt spodziewasz się wykryć. Przy mocy .80 i dwustronnym α = .05 (obliczenia w przepisie 3):
- porównanie dwóch grup przy umiarkowanym efekcie (d = 0.5) wymaga 64 osób w każdej grupie, a przy małym (d = 0.3) – już 176;
- korelacja r = .30 wymaga około 85 osób, a r = .20 – około 194;
- w naszym przykładzie 120 osób dawało moc tylko około .59 dla korelacji r = .20.
W licencjacie rzadko da się zbadać kilkaset osób, i nikt tego nie oczekuje. Lakens (2022) wymienia jednak ograniczenia zasobów jako jeden z sześciu prawomocnych sposobów uzasadnienia liczebności – pod warunkiem, że je nazwiesz i ocenisz, jakie efekty taka próba jest w stanie wykryć. W metodzie napisz więc wprost, ile osób udało się zbadać, a w dyskusji – że małe efekty mogły pozostać niewykryte. Więcej o planowaniu liczebności piszemy w poradniku dobór liczebności próby.
Przykład: od pliku z ankiety do wyników
Przykładowe badanie (dane symulowane) dotyczy związku korzystania z mediów społecznościowych z jakością snu. 120 studentów wypełniło ankietę online z trzema hipotezami:
- H1: Im więcej czasu dziennie osoba spędza w mediach społecznościowych, tym niższa jest jakość jej snu.
- H2: Kobiety spędzają w mediach społecznościowych więcej czasu niż mężczyźni.
- H3: Osoby korzystające z telefonu w łóżku częściej zgłaszają problemy z zasypianiem.
Jakość snu mierzyła krótka skala z pięciu pozycji (1–5), w której pozycja 4 („Często budzę się w nocy”) jest sformułowana odwrotnie. Czas w mediach osoby badane podawały w godzinach dziennie. Plik do pobrania: statystyka-do-pracy-licencjackiej-dane.csv – 120 wierszy, 11 kolumn (płeć, wiek, czas w mediach, pięć pozycji skali snu, dwa pytania tak/nie).
Krok 1. Kontrola danych i wynik skali
Baza nie miała braków, a odpowiedzi na wszystkie pozycje mieściły się w zakresie 1–5. Pozycję odwróconą (nr 4) przekodowano (nowa wartość = 6 − stara), bo przy skali 1–5 odwrócenie to zawsze „6 minus odpowiedź”. Wynik skali policzono jako średnią z pięciu pozycji, dzięki czemu mieści się w tym samym zakresie co odpowiedzi. Alfa Cronbacha wyniosła .83, a najniższa skorygowana korelacja pozycji z resztą skali – .54. Gdyby pozycja 4 nie została odwrócona, korelowałaby z resztą ujemnie i obniżyłaby alfę – to najprostszy sposób, żeby wychwycić pomyłkę w kluczu. Alfa ma znane ograniczenia: McNeish (2018) pokazuje, że jej założenia są zwykle nierealistyczne i prowadzą do zaniżania rzetelności, a jako alternatywę proponuje m.in. omegę. W licencjacie alfa zwykle wystarczy, ale warto wiedzieć, co oznacza – zob. poradnik alfa Cronbacha i rzetelność skali.
Krok 2. Opis próby i statystyki opisowe
W badaniu wzięło udział 79 kobiet (65.8%) i 41 mężczyzn (34.2%) w wieku 19–25 lat (M = 21.28, SD = 1.57). Badani spędzali w mediach społecznościowych średnio 3.32 godziny dziennie (SD = 1.51, zakres 0.5–7.1), a średni wynik skali jakości snu wyniósł 3.14 (SD = 0.92). Skośność obu zmiennych była bliska zera (0.10 i −0.02). Więcej o tym, co i jak opisać na tym etapie, piszemy w tekście jak opisać charakterystykę próby.
Krok 3. H1 – korelacja
Korelacja Pearsona między czasem w mediach a jakością snu wyniosła r(118) = −.34, 95% CI [−.49, −.17], p < .001. Korelacja Spearmana, policzona jako sprawdzenie odporności wyniku, była taka sama (ρ = −.34). Przedział ufności pokazuje, że dane są zgodne zarówno z dość słabym, jak i umiarkowanym związkiem – i to warto napisać. Rysunek 1 pokazuje surowe dane, a nie tylko linię: Weissgerber i in. (2015) zwracają uwagę, że wykresy pokazujące wyłącznie podsumowania mogą wyglądać identycznie przy bardzo różnych rozkładach danych.
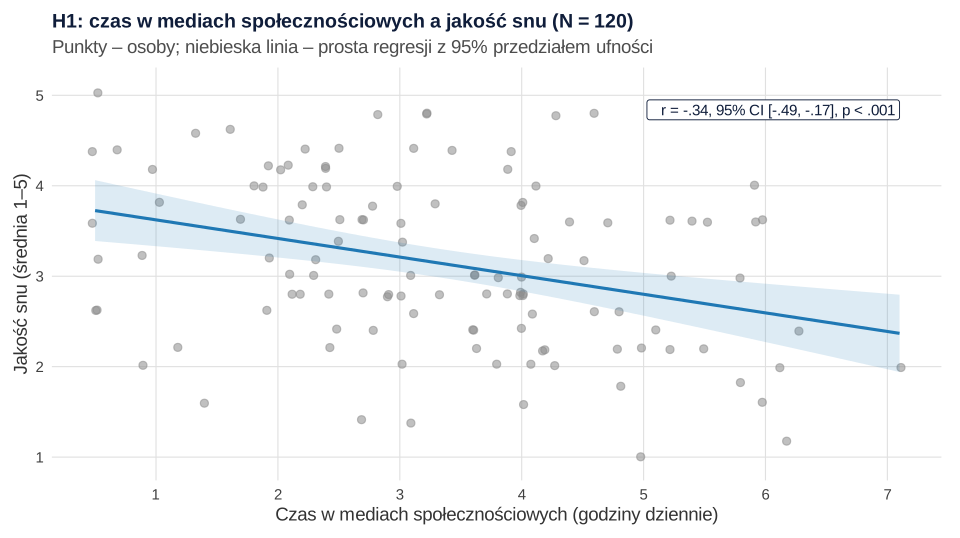
Pamiętaj, że to badanie korelacyjne. Wynik pozwala napisać, że osoby spędzające więcej czasu w mediach oceniały swój sen gorzej, ale nie że media pogarszają sen – równie dobrze osoby, które źle śpią, mogą więcej czasu spędzać z telefonem. Ten tok rozumowania wyjaśnia hasło korelacja a przyczynowość.
Krok 4. H2 – porównanie dwóch grup
Kobiety spędzały w mediach średnio 3.63 godziny dziennie (SD = 1.45), a mężczyźni 2.72 godziny (SD = 1.44). Test t Welcha: t(81.38) = 3.27, p = .002; różnica wyniosła 0.91 godziny, 95% CI [0.36, 1.46], d = 0.63. Niecałkowita liczba stopni swobody to znak rozpoznawczy testu Welcha – podaj ją z dwoma miejscami po kropce. Lakens (2013) wyjaśnia, dlaczego wielkość efektu trzeba raportować razem z testem: tylko ona pozwala porównać wynik z innymi badaniami i wykorzystać go w analizach mocy i metaanalizach.
Krok 5. H3 – tabela krzyżowa i test chi-kwadrat
Problemy z zasypianiem zgłosiło 31 z 53 osób używających telefonu w łóżku (58.5%) i 14 z 67 osób, które tego nie robią (20.9%). Test chi-kwadrat niezależności: χ²(1, N = 120) = 17.85, p < .001, φ = .39. Najmniejsza liczebność oczekiwana wyniosła 19.875, więc warunek liczebności oczekiwanych był spełniony i nie było potrzeby sięgać po test Fishera.
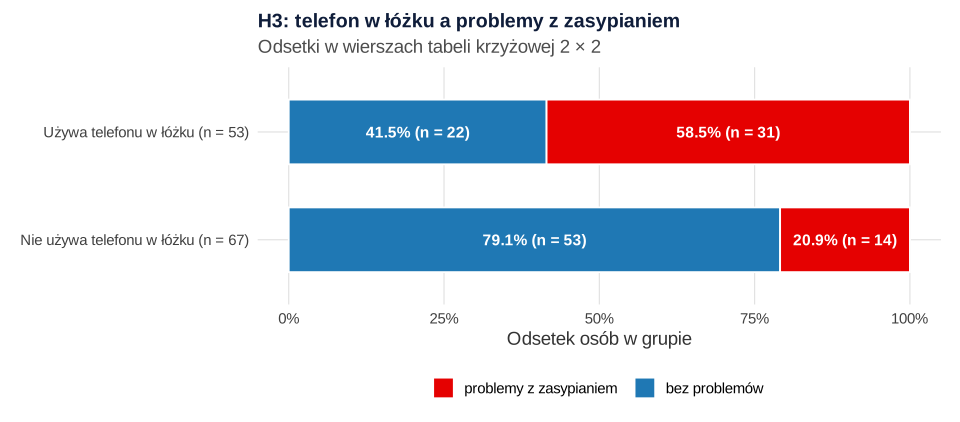
W tabeli krzyżowej i na rysunku pokazuj odsetki w tej grupie, którą porównujesz (tutaj: w wierszach, czyli wśród używających i nieużywających telefonu), i zawsze podawaj liczebności. Sam odsetek „58.5%” bez informacji, że chodzi o 31 osób, nic nie mówi o precyzji wyniku.
Przykładowy rozdział wyników w skrócie
Rozdział wyników w pracy licencjackiej ma zwykle trzy części: opis próby i zmiennych, rzetelność narzędzi, weryfikację hipotez w kolejności ich postawienia. Poniżej skrócona wersja dla naszego przykładu. Pełniejszy rozdział z komentarzem do każdego akapitu znajdziesz w tekście wyniki badań własnych – przykład, a gotowe zdania dla innych testów – w poradniku jak opisać wyniki w stylu APA.
| Zmienna | M | SD | Min–maks | Skośność | α |
|---|---|---|---|---|---|
| Czas w mediach społecznościowych (godz./dzień) | 3.32 | 1.51 | 0.5–7.1 | 0.10 | – |
| Jakość snu (1–5) | 3.14 | 0.92 | 1.0–5.0 | −0.02 | .83 |
Zwróć uwagę na trzy rzeczy w tych opisach. Po pierwsze, każdy zaczyna się od treści (co z czym się wiąże), a liczby są dodatkiem, a nie odwrotnie. Po drugie, żaden nie używa słów „udowodniono” ani „wpływa” – badanie korelacyjne na to nie pozwala. Po trzecie, każdy zawiera wielkość efektu. Wasserstein i Lazar (2016) w oświadczeniu Amerykańskiego Towarzystwa Statystycznego podkreślają, że wartość p nie mierzy wielkości efektu ani prawdopodobieństwa, że hipoteza jest prawdziwa, a wnioski nie powinny zależeć wyłącznie od przekroczenia progu istotności.
Podrozdział „Analiza statystyczna” w części metodologicznej
W rozdziale metodologicznym zapowiadasz, co zrobisz, a w rozdziale wyników – pokazujesz, co wyszło. Opis analiz w metodzie może być krótki, ale musi wymieniać program, testy przypisane do hipotez, poziom istotności i sposób liczenia wyników skal. Standardy raportowania APA (JARS-Quant) kładą nacisk na to, by odróżnić analizy zaplanowane od eksploracyjnych (Appelbaum i in., 2018). Więcej wzorów dla różnych planów badań znajdziesz w poradniku jak opisać metody statystyczne w pracy.
Błędy, które najczęściej wracają z uwagami promotora
Poniższe błędy powtarzają się w pracach licencjackich niezależnie od kierunku. Każdy łatwo poprawić, jeśli wiesz, czego szukać.
| Źle | Dobrze |
|---|---|
| „Test Shapiro–Wilka wykazał brak normalności, dlatego wszystkie analizy wykonano testami nieparametrycznymi.” | Ocena rozkładów na podstawie wykresów i skośności; test dobrany do hipotezy, a przy wyraźnej skośności – analiza nieparametryczna jako uzupełnienie lub zamiennik. |
| „Korelacja okazała się istotna (p = .000), co dowodzi, że media pogarszają sen.” | „Czas w mediach korelował ujemnie z jakością snu, r(118) = −.34, 95% CI [−.49, −.17], p < .001.” Bez słów „dowodzi” i „pogarszają”. |
| Wynik skali policzony bez odwrócenia pozycji sformułowanych negatywnie. | Odwrócenie według klucza (przy skali 1–5: 6 − odpowiedź) i sprawdzenie korelacji pozycji z resztą skali. |
| „58% osób zgłaszało problemy” bez liczebności i bez wskazania, czego dotyczy odsetek. | „31 z 53 osób używających telefonu w łóżku (58.5%)”. |
| Wynik nieistotny opisany jako „brak związku”. | Podanie efektu z przedziałem ufności i ostrożny wniosek: dane nie pozwalają stwierdzić związku, a przedział jest zgodny z efektami od … do …. |
| Hipoteza „istotna w grupie kobiet, nieistotna w grupie mężczyzn” uznana za różnicę między grupami. | Bezpośredni test różnicy, np. interakcji płci z predyktorem w regresji. |
| Ta sama informacja powtórzona w tekście, tabeli i na wykresie. | Tabela dla wielu liczb, tekst dla najważniejszych wniosków, wykres tylko wtedy, gdy coś wyjaśnia. |
Jeśli uwagi promotora już przyszły i nie wiesz, jak je wprowadzić, zajrzyj do poradnika poprawki promotora w rozdziale wyników.
Kiedy warto skonsultować analizę
W pracy licencjackiej większość analiz wykonasz samodzielnie z pomocą promotora i poradników. Konsultacja ze statystykiem przydaje się zwykle w trzech sytuacjach: gdy dane okazały się inne niż w planie (np. bardzo mała grupa porównawcza), gdy promotor oczekuje analizy, której nie było na zajęciach, albo gdy dostajesz uwagi, których nie rozumiesz. W ofercie analiz statystycznych dla studentów przygotowujemy analizę zgodną z planem badania, tabele i opis metod, a potem omawiamy wyniki tak, abyś umiał(a) samodzielnie odpowiedzieć na pytania promotora i komisji. Pamiętaj, że to Ty odpowiadasz za pracę – musisz rozumieć każdy wynik i ujawnić pomoc zgodnie z regulaminem uczelni. Granice takiej pomocy omawiamy w tekście czy można zlecić analizę statystyczną.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunków. Pobierz plik statystyka-do-pracy-licencjackiej-dane.csv, zapisz go w katalogu roboczym R i uruchom przepis 2. Przepis 1 pokazuje, jak plik powstał (nie musisz go uruchamiać), a przepis 3 nie potrzebuje danych.
1. Dane symulowane: ankieta 120 studentów
R
# P28 – dane symulowane do przykładu: ankieta online wśród 120 studentów
# „Czas w mediach społecznościowych a jakość snu”. Tworzy plik CSV do pobrania.
set.seed(2810)
N <- 120
plec <- sample(c("K", "M"), N, replace = TRUE, prob = c(.65, .35))
wiek <- sample(19:25, N, replace = TRUE, prob = c(.14, .22, .24, .18, .11, .07, .04))
media_h <- round(pmin(pmax(rnorm(N, mean = ifelse(plec == "K", 3.6, 3.0), sd = 1.4), 0.5), 9), 1)
# jakość snu (cecha ukryta): im więcej czasu w mediach, tym gorzej
sen_lat <- -0.30 * as.numeric(scale(media_h)) + rnorm(N, sd = sqrt(1 - 0.30^2))
pozycja <- function(lad) {
  x <- lad * sen_lat + rnorm(N, sd = sqrt(1 - lad^2))
  as.integer(cut(x, breaks = c(-Inf, -1.3, -0.45, 0.35, 1.2, Inf)))   # odpowiedzi 1–5
}
sen1 <- pozycja(.75); sen2 <- pozycja(.70); sen3 <- pozycja(.65); sen5 <- pozycja(.72)
sen4_odwr <- 6L - pozycja(.60)                    # pozycja sformułowana odwrotnie („często budzę się w nocy”)
telefon_w_lozku <- ifelse(runif(N) < plogis(-0.4 + 0.45 * as.numeric(scale(media_h))), "tak", "nie")
problemy_zasypianie <- ifelse(runif(N) < plogis(-0.9 + 0.95 * (telefon_w_lozku == "tak")), "tak", "nie")
dane <- data.frame(id = 1:N, plec, wiek, media_h, sen1, sen2, sen3, sen4_odwr, sen5, telefon_w_lozku, problemy_zasypianie)
write.csv(dane, "statystyka-do-pracy-licencjackiej-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
str(read.csv("statystyka-do-pracy-licencjackiej-dane.csv"))
Wynik w R
'data.frame':	120 obs. of  11 variables:
 $ id                 : int  1 2 3 4 5 6 7 8 9 10 ...
 $ plec               : chr  "M" "K" "K" "K" ...
 $ wiek               : int  21 24 21 22 20 20 23 22 24 20 ...
 $ media_h            : num  0.9 4.4 1.8 1.3 2.5 5.5 5.2 2.3 3.8 6 ...
 $ sen1               : int  4 3 4 5 1 3 2 2 2 1 ...
 $ sen2               : int  4 4 4 5 3 3 3 5 3 3 ...
 $ sen3               : int  2 4 4 4 3 5 5 2 3 1 ...
 $ sen4_odwr          : int  4 2 2 1 3 2 4 3 1 4 ...
 $ sen5               : int  4 3 4 4 2 3 3 4 2 1 ...
 $ telefon_w_lozku    : chr  "nie" "tak" "nie" "nie" ...
 $ problemy_zasypianie: chr  "nie" "nie" "tak" "nie" ...
2. Plan analiz: skala, opis próby, H1–H3
R
# P28 – pełny plan analiz typowej pracy licencjackiej na danych z pliku CSV (dane symulowane)
library(psych)   # alpha(): rzetelność skali

dane <- read.csv("statystyka-do-pracy-licencjackiej-dane.csv")

# 1. Kontrola danych: liczebność, braki, zakresy odpowiedzi
c(N = nrow(dane), braki = sum(is.na(dane)))
sapply(dane[, c("sen1", "sen2", "sen3", "sen4_odwr", "sen5")], range)

# 2. Pozycja odwrócona i wynik skali (średnia z 5 pozycji, zakres 1–5)
dane$sen4 <- 6 - dane$sen4_odwr
pozycje <- dane[, c("sen1", "sen2", "sen3", "sen4", "sen5")]
a <- alpha(pozycje)
round(c(alfa = a$total$raw_alpha, min_r_pozycja_reszta = min(a$item.stats$r.drop)), 2)
dane$jakosc_snu <- rowMeans(pozycje)

# 3. Charakterystyka próby i statystyki opisowe
table(dane$plec); round(100 * prop.table(table(dane$plec)), 1)
round(c(M_wiek = mean(dane$wiek), SD_wiek = sd(dane$wiek), min = min(dane$wiek), max = max(dane$wiek)), 2)
opis <- function(x) round(c(M = mean(x), SD = sd(x), Mdn = median(x), min = min(x), max = max(x),
                            skosnosc = psych::skew(x)), 2)
rbind(media_h = opis(dane$media_h), jakosc_snu = opis(dane$jakosc_snu))

# 4. H1: czas w mediach a jakość snu – korelacja Pearsona (i Spearmana jako sprawdzenie)
r1 <- cor.test(dane$media_h, dane$jakosc_snu)
round(c(r = unname(r1$estimate), df = unname(r1$parameter), p = r1$p.value, CI_dolna = r1$conf.int[1], CI_gorna = r1$conf.int[2]), 3)
rs <- cor.test(dane$media_h, dane$jakosc_snu, method = "spearman", exact = FALSE)
round(c(rho = unname(rs$estimate), p = rs$p.value), 3)

# 5. H2: kobiety a mężczyźni – czas w mediach, test t Welcha i d Cohena
aggregate(media_h ~ plec, data = dane, FUN = function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
t2 <- t.test(media_h ~ plec, data = dane)       # Welch: bez założenia równych wariancji
K <- dane$media_h[dane$plec == "K"]; M <- dane$media_h[dane$plec == "M"]
sp <- sqrt(((length(K) - 1) * var(K) + (length(M) - 1) * var(M)) / (length(K) + length(M) - 2))
round(c(t = unname(t2$statistic), df = unname(t2$parameter), p = t2$p.value,
        roznica = mean(K) - mean(M), CI_dolna = t2$conf.int[1], CI_gorna = t2$conf.int[2], d = (mean(K) - mean(M)) / sp), 3)

# 6. H3: telefon w łóżku a problemy z zasypianiem – test chi-kwadrat i phi
tab <- table(telefon = dane$telefon_w_lozku, problemy = dane$problemy_zasypianie)
tab
round(100 * prop.table(tab, 1), 1)                 # odsetki w wierszach
ch <- chisq.test(tab, correct = FALSE)
ch$expected
round(c(chi2 = unname(ch$statistic), df = unname(ch$parameter), p = ch$p.value,
        phi = sqrt(unname(ch$statistic) / sum(tab))), 3)
Wynik w R
    N braki
  120     0
     sen1 sen2 sen3 sen4_odwr sen5
[1,]    1    1    1         1    1
[2,]    5    5    5         5    5
                alfa min_r_pozycja_reszta
                0.83                 0.54

 K  M
79 41

   K    M
65.8 34.2
 M_wiek SD_wiek     min     max
  21.28    1.57   19.00   25.00
              M   SD Mdn min max skosnosc
media_h    3.32 1.51 3.2 0.5 7.1     0.10
jakosc_snu 3.14 0.92 3.0 1.0 5.0    -0.02
       r       df        p CI_dolna CI_gorna
  -0.336  118.000    0.000   -0.486   -0.166
   rho      p
-0.336  0.000
  plec media_h.n media_h.M media_h.SD
1    K     79.00      3.63       1.45
2    M     41.00      2.72       1.44
       t       df        p  roznica CI_dolna CI_gorna        d
   3.268   81.381    0.002    0.910    0.356    1.464    0.628
       problemy
telefon nie tak
    nie  53  14
    tak  22  31
       problemy
telefon  nie  tak
    nie 79.1 20.9
    tak 41.5 58.5
       problemy
telefon    nie    tak
    nie 41.875 25.125
    tak 33.125 19.875
  chi2     df      p    phi
17.845  1.000  0.000  0.386
3. Ile osób zbadać: liczebność dla mocy .80
R
# P28 – ile osób zbadać? Liczebność potrzebna do mocy .80 przy alfa = .05 (test dwustronny)
# Porównanie dwóch grup (test t): d = 0.5 i d = 0.3 – liczba osób w KAŻDEJ grupie
ceiling(sapply(c(d_05 = 0.5, d_03 = 0.3), function(d) power.t.test(delta = d, sd = 1, power = .80)$n))
# Korelacja: przybliżenie przez transformację z Fishera, n = ((z_alfa/2 + z_beta) / atanh(r))^2 + 3
n_r <- function(r) ceiling(((qnorm(.975) + qnorm(.80)) / atanh(r))^2 + 3)
sapply(c(r_30 = .30, r_20 = .20), n_r)
# Moc przy 120 osobach dla korelacji r = .20 (przybliżenie Fishera)
round(pnorm(atanh(.20) * sqrt(120 - 3) - qnorm(.975)), 2)
Wynik w R
d_05 d_03
  64  176
r_30 r_20
  85  194
[1] 0.59
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Ile hipotez powinna mieć praca licencjacka?
Zwykle od dwóch do czterech, każda sprawdzana jedną, z góry wybraną analizą. Więcej hipotez nie podnosi wartości pracy, za to wydłuża rozdział wyników i zwiększa ryzyko przypadkowych wyników istotnych. Ostateczną liczbę ustal z promotorem na etapie planu badania.
Czy w pracy licencjackiej trzeba podawać wielkość efektu?
Tak, warto przy każdym teście: r przy korelacji, d Cohena przy porównaniu dwóch grup, η² przy ANOVA, φ albo V Craméra przy teście chi-kwadrat. Wartość p mówi tylko, czy wynik jest zgodny z hipotezą zerową, a wielkość efektu – jak duża jest różnica lub związek.
Jaki program wybrać do analizy danych w licencjacie?
Taki, który zna promotor albo który jest dostępny na uczelni: SPSS, JASP, jamovi, R, a do prostych zestawień nawet Excel. Wyniki testów są w nich takie same. Ważne, żeby w podrozdziale „Analiza statystyczna” podać nazwę i wersję programu.
Co zrobić, gdy w ankiecie są pozycje odwrócone?
Przed policzeniem wyniku skali przekoduj je według klucza z podręcznika narzędzia: przy skali 1–5 nowa wartość to 6 minus odpowiedź, przy skali 1–7 – 8 minus odpowiedź. Potem sprawdź korelacje pozycji z resztą skali; ujemna korelacja zwykle oznacza, że któraś pozycja nie została odwrócona.
Jak długi powinien być rozdział wyników w pracy licencjackiej?
Nie ma jednej normy, ale zwykle wystarcza kilka do kilkunastu stron: opis próby i zmiennych, rzetelność skal oraz weryfikacja każdej hipotezy z tabelą lub rysunkiem. Liczby, które są w tabeli, nie powtarzaj w całości w tekście – w tekście opisz najważniejsze wnioski.
Powiązane hasła
Przeczytaj też
Zebrano mniej osób, niż planowano
Dobierać dalej czy analizować? Drzewo decyzji, symulacja dobierania w R, analiza wrażliwości i gotowe zdania do Metody i Ograniczeń.
Czytaj →PoradnikLicencjat, magisterka, doktorat
Czego zwykle oczekuje się od części empirycznej na trzech poziomach: tabela, jedno zagadnienie w trzech planach i typowe przestrzelenia.
Czytaj →PoradnikStatystyka dla studenta
Po co statystyka na studiach, jak się jej uczyć w siedmiu etapach, które analizy są w pracach dyplomowych i gdzie szukać pomocy – z symulacją w R.
Czytaj →PoradnikWyniki badań własnych – przykładowy rozdział
Cały rozdział wyników jednego badania – od przygotowania danych po tabelę hipotez – z komentarzem, tabelami APA, rysunkami i wzorem w Wordzie.
Czytaj →PoradnikStatystyka do pracy magisterskiej
Plan analiz, CFA i omega, regresja hierarchiczna, moderacja i mediacja z bootstrapem, wzory opisu APA i pytania na obronie – z danymi i kodem R.
Czytaj →Piszesz licencjat i nie wiesz, od czego zacząć analizę?
Dobierzemy analizy do Twoich hipotez, przygotujemy wyniki z tabelami i wyjaśnimy je tak, abyś pewnie przedstawił(a) je promotorowi.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Norman, G. (2010). Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
- Schober, P., Boer, C., & Schwarte, L. A. (2018). Correlation coefficients: Appropriate use and interpretation. Anesthesia & Analgesia, 126(5), 1763–1768. https://doi.org/10.1213/ANE.0000000000002864 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{norman2010likert, author={Norman, Geoff}, title={{Likert scales, levels of measurement and the “laws” of statistics}}, journal={Advances in Health Sciences Education}, year={2010}, volume={15}, number={5}, pages={625--632}, doi={10.1007/s10459-010-9222-y}}@article{schober2018correlation, author={Schober, Patrick and Boer, Christa and Schwarte, Lothar A.}, title={{Correlation coefficients: Appropriate use and interpretation}}, journal={Anesthesia \& Analgesia}, year={2018}, volume={126}, number={5}, pages={1763--1768}, doi={10.1213/ane.0000000000002864}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}