Statystyka dla studenta: do czego naprawdę się przydaje
Dla wielu osób statystyka jest przedmiotem „do zaliczenia”: wzory, tablice, kolokwium i ulga, że już po wszystkim. Potem przychodzi seminarium dyplomowe i okazuje się, że bez statystyki nie da się ani zaplanować badania, ani opisać jego wyników, ani odpowiedzieć na pytanie recenzenta. Jeśli czujesz przy tym napięcie, nie jesteś wyjątkiem. Onwuegbuzie i Wilson (2003) w przeglądzie badań opisują lęk przed statystyką jako zjawisko częste wśród studentów, wielowymiarowe i obniżające wyniki w nauce. Zwracają też uwagę, że istnieją sposoby, które ten lęk skutecznie zmniejszają.
Statystyka przydaje się studentowi w trzech sytuacjach, i tylko jedna z nich to praca dyplomowa:
- Czytanie badań. Artykuł podaje „istotny efekt” albo „brak różnic”. Bez podstaw statystyki nie ocenisz, czy wniosek wynika z danych, czy z życzeń autorów. To umiejętność potrzebna każdemu, kto pisze przegląd literatury, a później pracuje w zawodzie opartym na badaniach.
- Własne badanie. W pracy dyplomowej sam(a) decydujesz, ile osób zbadać, jak zmierzyć zmienne, którą analizę wybrać i jak opisać wynik. Każda z tych decyzji jest statystyczna, nawet jeśli w planie studiów nazywa się „metodologią”.
- Decyzje w niepewności. Wynik jednego badania, jednej ankiety czy jednego sondażu zawsze zawiera przypadek. Statystyka uczy, jak duży może być ten przypadek i kiedy wniosek jest na tyle pewny, by na nim polegać.
Ten przewodnik pokazuje, czego i w jakiej kolejności się uczyć, które analizy pojawiają się w pracach dyplomowych najczęściej, jakie przekonania o statystyce warto porzucić i gdzie szukać pomocy. Zaczniemy od eksperymentu myślowego, który policzyliśmy w R. Wyjaśnia on lepiej niż definicje, po co w ogóle jest statystyka.
Dlaczego jedno badanie to za mało: 20 replikacji tego samego eksperymentu
Wyobraź sobie, że testujesz krótki trening uważności. 30 osób trenuje, 30 jest w grupie kontrolnej, a po dwóch tygodniach mierzysz stres na skali 0–40. Załóżmy, że wiemy, jak jest naprawdę: w populacji trening obniża stres średnio o 3 punkty przy odchyleniu standardowym 6 punktów. To umiarkowany efekt, d = 0.5. W R możemy „przeprowadzić” to samo badanie wiele razy i zobaczyć, co dostałby każdy z badaczy (dane symulowane, kod w sekcji Przykład w R).
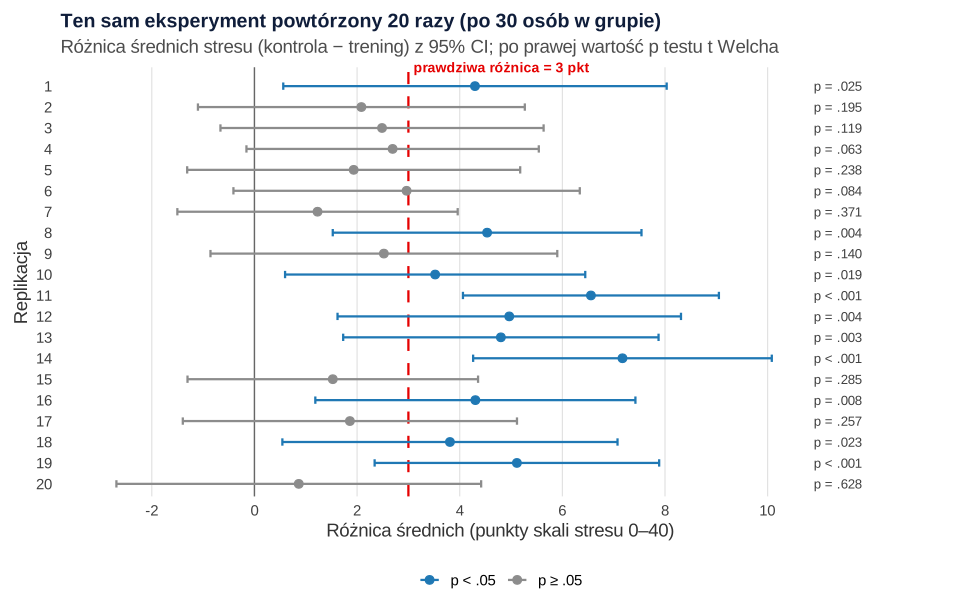
Co widać na rysunku?
- Połowa badaczy „znalazła efekt”, połowa nie. Wynik istotny statystycznie (p < .05) uzyskało 10 z 20 replikacji, choć efekt istniał w każdej z nich. Wartości p wahały się od p < .001 do p = .628.
- Oszacowania bardzo się różnią. Zaobserwowana różnica średnich wynosiła od 0.86 do 7.17 punktu, czyli od „prawie nic” do ponad dwukrotności prawdziwego efektu.
- Przedziały ufności zwykle trafiają. 18 z 20 przedziałów obejmuje prawdziwą wartość 3 punktów. Przy 10 000 replikacji odsetek ten wyniósł 94.7%, czyli tyle, ile obiecuje 95% przedział ufności.
Ta sama symulacja powtórzona 10 000 razy daje jeszcze dwie lekcje. Po pierwsze, przy 30 osobach w grupie istotny wynik pojawił się tylko w 47.3% badań. Tyle wynosi moc testu w tym planie, a wzór analityczny daje prawie to samo: .478. Aby moc wyniosła .80, potrzeba 64 osób w każdej grupie. Po drugie, w badaniach istotnych średnia wielkość efektu wyniosła d = 0.73, choć prawdziwa to 0.50, a średnia ze wszystkich badań – 0.50. Jeśli więc czytasz tylko badania „udane”, przeceniasz efekt. Button i in. (2013) pokazują ten sam mechanizm w neuronaukach: niska moc nie tylko zmniejsza szansę wykrycia prawdziwego efektu, ale też prowadzi do zawyżonych oszacowań i słabej replikowalności.
To jest właśnie odpowiedź na pytanie „po co statystyka”: pojedynczy wynik to jedno losowanie z wielu możliwych, a statystyka mówi, jak bardzo to losowanie może się mylić. Dlatego w pracy podajesz nie tylko p, ale też wielkość efektu z przedziałem ufności, a liczebność próby planujesz przed badaniem – tak jak opisujemy w poradniku dobór liczebności próby. Lakens (2022) wymienia sześć sposobów uzasadnienia liczebności: od zbadania niemal całej populacji, przez ograniczenia zasobów i analizę mocy, po planowanie dokładności oszacowania. W pracy licencjackiej najczęściej uczciwym uzasadnieniem są właśnie ograniczenia zasobów, ale trzeba je nazwać i wyciągnąć z nich wnioski.
Ścieżka nauki: siedem etapów w sensownej kolejności
Statystyki najłatwiej uczyć się warstwami. Każdy etap korzysta z poprzedniego, więc przeskakiwanie od razu do regresji czy modeli równań strukturalnych zwykle kończy się klikaniem w program bez zrozumienia wyniku. Poniższa ścieżka odpowiada temu, czego potrzebujesz do typowej pracy empirycznej w naukach społecznych i o zdrowiu.
| Etap | Co musisz umieć | Sprawdzian zrozumienia | Gdzie poczytać |
|---|---|---|---|
| 1. Dane i pomiar | rozróżnić skalę nominalną, porządkową i ilościową; zapisać dane w tabeli „osoba = wiersz” | Czy umiesz powiedzieć, jaką średnią policzysz dla płci, a jaką dla wieku? | jak przygotować bazę danych |
| 2. Opis danych | średnia, mediana, odchylenie standardowe, odsetki, histogram i wykres pudełkowy | Czy wiesz, kiedy mediana lepiej opisuje dane niż średnia? | statystyki opisowe w pracy |
| 3. Próba a populacja | rozkład z próby, błąd standardowy, przedział ufności | Czy rozumiesz, dlaczego w większej próbie przedział ufności jest węższy? | centralne twierdzenie graniczne |
| 4. Testowanie hipotez | hipoteza zerowa i alternatywna, wartość p, błąd I i II rodzaju, moc, wielkość efektu | Czy umiesz powiedzieć, czego p nie mówi? | p value krok po kroku, wielkość efektu |
| 5. Podstawowe testy | test t, ANOVA, korelacja, chi-kwadrat, testy nieparametryczne | Czy dobierzesz test do hipotezy bez tabelki „jaki test wybrać”? | jak dobrać test do hipotezy |
| 6. Modele | regresja wieloraka, interakcja, efekt pośredni | Czy wiesz, co znaczy współczynnik „przy kontroli pozostałych zmiennych”? | regresja wieloraka krok po kroku |
| 7. Raport | zapis wyników w stylu APA, tabele i rysunki | Czy Twój opis pozwala odtworzyć analizę? | jak opisać wyniki w stylu APA |
Kilka rad, które przyspieszają naukę na każdym etapie:
- Ucz się na danych, które coś dla Ciebie znaczą. Zbiór z własnej ankiety, nawet pilotażowej, uczy więcej niż przykład z podręcznika, bo wiesz, co oznacza każda liczba.
- Najpierw wykres, potem test. Zanim policzysz korelację, obejrzyj wykres rozrzutu. Zanim porównasz grupy, zobacz rozkłady. Połowa błędów w pracach studenckich wynika z tego, że nikt nie spojrzał na dane.
- Opowiedz wynik zwykłym językiem. Jeśli nie umiesz wytłumaczyć koleżance, co znaczy r = −.34, to znak, że trzeba wrócić do etapu 4, a nie szukać lepszego programu.
- Odtwórz cudzy wynik. Weź artykuł, w którym autorzy podają średnie i odchylenia standardowe, i policz z nich wielkość efektu. To najlepszy trening czytania badań.
- Zapisuj kroki. Skrypt w R albo składnia w SPSS to notatki z analizy. Za pół roku, gdy promotor poprosi o poprawkę, nie będziesz zgadywać, co zrobiłeś(-aś).
Najważniejsze analizy w pracach dyplomowych i gdzie je znaleźć
Większość prac licencjackich i magisterskich z psychologii, pedagogiki, nauk o zdrowiu czy zarządzania korzysta z kilku tych samych analiz. Zamiast uczyć się ich jako listy testów, zacznij od pytania badawczego: czego dotyczy, jakie są zmienne i ile masz grup lub pomiarów.
| Pytanie badawcze | Przykład | Typowa analiza | Poradnik |
|---|---|---|---|
| Jaka jest badana grupa? | wiek, płeć, staż, średnie wyniki skal | statystyki opisowe, odsetki | poradnik z etapu 2 ścieżki nauki |
| Czy dwie grupy się różnią? | stres u studentów studiów stacjonarnych i niestacjonarnych | test t Welcha, test U Manna–Whitneya | test t Studenta krok po kroku |
| Czy różni się więcej grup? | satysfakcja z pracy na trzech oddziałach | jednoczynnikowa ANOVA (Welcha), test Kruskala–Wallisa | ANOVA krok po kroku |
| Czy dwie zmienne ilościowe są powiązane? | czas w mediach społecznościowych a jakość snu | korelacja Pearsona lub Spearmana | korelacja Pearsona i Spearmana |
| Czy dwie zmienne jakościowe są powiązane? | płeć a wybór formy terapii | test chi-kwadrat, dokładny test Fishera | test chi-kwadrat krok po kroku |
| Co jeśli dane są porządkowe lub bardzo skośne? | ocena bólu, liczba dni absencji | testy nieparametryczne albo metody odporne | testy nieparametryczne |
| Co przewiduje wynik przy kilku zmiennych naraz? | wypalenie a stres, wsparcie i staż | regresja wieloraka (także hierarchiczna) | poradnik z etapu 6 ścieżki nauki |
W pracy licencjackiej zwykle wystarczą pierwsze cztery–pięć wierszy tej tabeli. Jak zaplanować taki zestaw i opisać go w rozdziale wyników, pokazujemy w poradniku statystyka do pracy licencjackiej. W pracy magisterskiej częściej pojawiają się modele: regresja hierarchiczna, moderacja, mediacja i konfirmacyjna analiza czynnikowa – o nich piszemy w tekście statystyka do pracy magisterskiej. Jeśli piszesz pracę z psychologii, zajrzyj też do przewodnika statystyka dla psychologa, który omawia skale, normy i rzetelność kwestionariuszy.
Zwróć uwagę, że w tabeli przy porównaniu dwóch grup stoi test t Welcha, a nie klasyczny test Studenta. To nie przypadek: wersja Welcha nie zakłada równych wariancji w grupach, a przy równych traci niewiele, dlatego Delacre i in. (2017) zalecają ją jako wybór domyślny zamiast wstępnego testowania równości wariancji. Podobnie wiele decyzji, które w starszych podręcznikach były „sztywnymi regułami”, dziś ma bardziej elastyczne uzasadnienie. Ucz się więc logiki wyboru, a nie samych schematów.
Jaki program wybrać do nauki
Program ma mniejsze znaczenie, niż się wydaje. Test t w każdym pakiecie daje ten sam wynik, a różnią się sposób pracy, cena i to, co zobaczysz domyślnie. Kilka praktycznych wskazówek:
- IBM SPSS Statistics – nadal popularny na uczelniach; jeśli Twoja uczelnia ma licencję, a promotor pracuje w SPSS, to rozsądny wybór.
- JASP i jamovi – bezpłatne, z interfejsem przypominającym SPSS. Dobrze nadają się do nauki, bo od razu pokazują wielkości efektu i wykresy.
- R – wymaga nauki kodu, ale daje pełną kontrolę i powtarzalność. Każda liczba na tej stronie pochodzi z kodu R, który możesz uruchomić sam(a).
- Excel – wystarczy do statystyk opisowych i prostych wykresów, ale przy testach łatwo o błąd. Jego możliwości i granice opisujemy w poradniku analiza statystyczna w Excelu.
Porównanie bezpłatnych programów znajdziesz w zestawieniu bezpłatne programy do analizy statystycznej. Wybierz jeden i trzymaj się go w czasie pisania pracy – zmiana programu w połowie analiz to przepis na niespójne wyniki.
Pięć przekonań o statystyce, które warto porzucić
Część trudności ze statystyką nie wynika z braku wiedzy, tylko z błędnych skrótów myślowych, które łatwo przyswoić na wykładzie i trudno potem oduczyć. Greenland i in. (2016) zebrali listę 25 typowych błędnych interpretacji wartości p, przedziałów ufności i mocy. Oto pięć, które najczęściej trafiają do prac dyplomowych.
„p to prawdopodobieństwo, że hipoteza zerowa jest prawdziwa”
Nie. Wartość p mówi, jak nietypowe byłyby takie (lub bardziej skrajne) dane, gdyby hipoteza zerowa i wszystkie założenia modelu były prawdziwe. Nie mówi, jak prawdopodobna jest sama hipoteza. Rysunek 1 pokazuje to wprost: we wszystkich 20 replikacjach hipoteza zerowa była fałszywa, a mimo to wartości p sięgały .628. Szerzej piszemy o tym w tekście wartość p – jak ją interpretować.
„95% przedział ufności zawiera prawdziwą wartość z prawdopodobieństwem 95%”
Poziom 95% dotyczy procedury: w długiej serii badań 95% tak liczonych przedziałów obejmie prawdziwą wartość (w naszej symulacji – 94.7%). O jednym konkretnym przedziale tak powiedzieć nie można. Nie martw się, jeśli to zaskakuje: Hoekstra i in. (2014) pokazali, że zarówno studenci psychologii, jak i badacze akceptowali średnio ponad trzy z sześciu fałszywych stwierdzeń o przedziale ufności, a badacze wypadali niemal tak samo jak studenci.
„Wynik nieistotny oznacza, że efektu nie ma”
Brak istotności to często brak dowodu, a nie dowód braku. W symulacji połowa badań nie dała istotnego wyniku, choć efekt był prawdziwy. Gdy Twoja hipoteza się nie potwierdzi, opisz przedział ufności i moc, zamiast pisać „nie ma związku” – podpowiadamy, jak to zrobić, w poradniku hipoteza się nie potwierdziła – co dalej.
„Danych ze skali Likerta nie wolno analizować testami parametrycznymi”
To uproszczenie krąży po seminariach od lat. Norman (2010) przypomina, że liczne badania od lat 30. XX wieku pokazują odporność ANOVA, regresji i korelacji na naruszenia założeń, także przy danych ze skal Likerta i małych próbach. Średnia z kilku pozycji skali zachowuje się zwykle jak zmienna ilościowa. Decyzję o teście uzasadnij rozkładem wyników, a nie samą nazwą skali.
„Efekt istotny w jednej grupie i nieistotny w drugiej to różnica między grupami”
Gelman i Stern (2006) pokazują, że nawet duża różnica wartości p może odpowiadać małej, nieistotnej różnicy samych efektów. Jeśli chcesz stwierdzić, że związek jest silniejszy u kobiet niż u mężczyzn, musisz to przetestować bezpośrednio – najczęściej jako interakcję w modelu regresji.
Wspólny mianownik tych przekonań to myślenie zero-jedynkowe: „istotne – jest, nieistotne – nie ma”. Cumming (2014) proponuje zamiast niego estymację: wielkości efektów, przedziały ufności i łączenie wyników wielu badań. To podejście dobrze sprawdza się także w pracy dyplomowej, bo zmusza do pytania „jak duży jest efekt i jak dokładnie go znam?”.
Gdzie statystyka pojawia się w pracy dyplomowej
Statystyka nie zaczyna się w rozdziale wyników. W typowej pracy empirycznej pojawia się w czterech miejscach:
- Problem i hipotezy. Hipoteza musi dać się sprawdzić konkretną analizą. „Stres wpływa na zdrowie” – nie; „poziom stresu koreluje dodatnio z liczbą dni zwolnienia lekarskiego” – tak.
- Metoda. Opisujesz dobór i liczebność próby, narzędzia z ich rzetelnością oraz plan analiz. Jak napisać ten rozdział, pokazuje poradnik rozdział metodologiczny.
- Wyniki. Statystyki opisowe, sprawdzenie założeń, testy hipotez z wielkościami efektu, tabele i rysunki zgodne ze stylem APA. Standardy raportowania APA (JARS-Quant) dzielą hipotezy i analizy na pierwszorzędowe, drugorzędowe i eksploracyjne (Appelbaum i in., 2018) – to dobry sposób na uporządkowanie rozdziału.
- Dyskusja i obrona. Interpretujesz wynik ostrożnie (korelacja to nie przyczynowość), omawiasz ograniczenia i odpowiadasz na pytania komisji. Przykładowe pytania z odpowiedziami zebraliśmy w tekście pytania na obronie z metodologii i statystyki.
Zanim zaczniesz analizę, przejdź przez krótką listę kontrolną:
- Każda hipoteza ma przypisaną jedną główną analizę, zapisaną przed obejrzeniem wyników.
- Wiesz, jak policzyć wynik każdej skali (suma czy średnia, które pozycje odwrócić) i skąd to wiesz – z podręcznika narzędzia albo artykułu walidacyjnego.
- Masz uzasadnienie liczebności próby, nawet jeśli brzmi ono „tyle osób udało się zbadać w dostępnym czasie”.
- Wiesz, co zrobisz z brakami danych i osobami, które wypełniły ankietę niestarannie.
- Znasz wymagania promotora co do programu, formatu tabel i poziomu szczegółowości.
Te decyzje warto omówić z promotorem na etapie planu, a nie po zebraniu danych. Krótka, konkretna wiadomość oszczędza tygodnie poprawek:
Gdzie szukać pomocy ze statystyką
Pomoc ze statystyką to nic wstydliwego – także doświadczeni badacze konsultują swoje analizy. Ważne, żeby była to pomoc w zrozumieniu, a nie zastąpienie Twojej pracy. Kolejność, która zwykle działa najlepiej:
- Promotor i prowadzący zajęcia. Przyjdź na konsultacje z konkretnym pytaniem, wydrukiem i wykresem, a nie z ogólnym „nie wiem, jaki test”.
- Podręcznik i dokumentacja programu. Klasyczny podręcznik do SPSS (Field, 2018) czy pomoc w JASP i jamovi odpowiadają na większość pytań technicznych.
- Poradniki krok po kroku. Na naszym blogu każdy z najczęstszych testów ma poradnik z przykładem, kodem i gotowym opisem APA – zacznij od tabeli w sekcji Najważniejsze analizy.
- Konsultacja statystyczna. Gdy analiza wykracza poza zajęcia (np. model z interakcją, efekt pośredni, analiza czynnikowa) albo promotor zgłasza uwagi, których nie rozumiesz, rozważ konsultację ze statystykiem. W ofercie analiz statystycznych dla studentów wykonujemy analizy, sprawdzamy plan i wyjaśniamy wyniki tak, abyś umiał(a) je samodzielnie przedstawić i obronić.
Przy każdej formie pomocy obowiązuje ta sama zasada: to Ty jesteś autorem lub autorką pracy, więc musisz rozumieć każdą liczbę w rozdziale wyników i ujawnić pomoc zgodnie z regulaminem uczelni. Europejski kodeks rzetelności naukowej zaleca uznawanie wkładu osób, które nie są autorami, a niewłaściwe użycie statystyki, np. po to, by sugerować istotność, zalicza do niedopuszczalnych praktyk (ALLEA, 2023). Gdzie przebiega granica między konsultacją a nieuczciwą usługą, wyjaśniamy w tekście czy można zlecić analizę statystyczną.
Przykład w R
Kod odtwarza wszystkie liczby z sekcji o replikacjach i z rysunku 1. Nie potrzebuje żadnych plików ani dodatkowych pakietów – działa w czystej instalacji R. Symulacja 10 000 badań trwa kilka sekund.
Ten sam eksperyment powtórzony 20 i 10 000 razy
R
# Ten sam eksperyment powtórzony wiele razy (dane symulowane).
# Scenariusz: trening uważności a grupa kontrolna, wynik – stres (0–40), po 30 osób w grupie.
# W populacji różnica wynosi 3 punkty przy SD = 6, czyli d = 0.5.
set.seed(2031)
n <- 30; roznica_pop <- 3; sd_pop <- 6

jedno_badanie <- function(n) {
  kontrola <- rnorm(n, mean = 20, sd = sd_pop)
  trening  <- rnorm(n, mean = 20 - roznica_pop, sd = sd_pop)
  tt <- t.test(kontrola, trening)                      # test t Welcha (domyślny w R)
  sp <- sqrt((var(kontrola) + var(trening)) / 2)
  c(roznica = mean(kontrola) - mean(trening), dolna = tt$conf.int[1], gorna = tt$conf.int[2],
    p = tt$p.value, d = (mean(kontrola) - mean(trening)) / sp)
}

# 1) Dwadzieścia replikacji – te same, które pokazuje rysunek
dwadziescia <- as.data.frame(t(replicate(20, jedno_badanie(n))))
dwadziescia$nr <- 1:20
print(round(dwadziescia[, c("nr", "roznica", "dolna", "gorna", "p", "d")], 3), row.names = FALSE)
round(c(istotnych = sum(dwadziescia$p < .05), min_p = min(dwadziescia$p), max_p = max(dwadziescia$p),
        min_roznica = min(dwadziescia$roznica), max_roznica = max(dwadziescia$roznica),
        CI_obejmuje_3 = sum(dwadziescia$dolna <= 3 & dwadziescia$gorna >= 3)), 3)

# 2) 10 000 replikacji: jak często badanie „wychodzi” i jak duże są efekty w badaniach istotnych
duzo <- as.data.frame(t(replicate(10000, jedno_badanie(n))))
round(c(odsetek_istotnych = mean(duzo$p < .05),
        sredni_d_wszystkie = mean(duzo$d),
        sredni_d_istotne = mean(duzo$d[duzo$p < .05]),
        odsetek_CI_z_prawdziwa = mean(duzo$dolna <= 3 & duzo$gorna >= 3)), 3)

# 3) Moc analityczna i liczebność potrzebna do mocy .80 (d = 0.5, alfa = .05, test dwustronny)
round(power.t.test(n = 30, delta = 0.5, sd = 1)$power, 3)
ceiling(power.t.test(delta = 0.5, sd = 1, power = .80)$n)
Wynik w R
 nr roznica  dolna  gorna     p     d
  1   4.297  0.562  8.033 0.025 0.596
  2   2.084 -1.101  5.269 0.195 0.338
  3   2.486 -0.662  5.635 0.119 0.409
  4   2.693 -0.156  5.541 0.063 0.489
  5   1.934 -1.311  5.178 0.238 0.308
  6   2.965 -0.409  6.340 0.084 0.454
  7   1.229 -1.502  3.960 0.371 0.233
  8   4.534  1.526  7.542 0.004 0.780
  9   2.522 -0.857  5.901 0.140 0.386
 10   3.522  0.597  6.446 0.019 0.623
 11   6.557  4.063  9.050 0.000 1.359
 12   4.965  1.619  8.312 0.004 0.767
 13   4.802  1.729  7.874 0.003 0.808
 14   7.171  4.261 10.081 0.000 1.274
 15   1.527 -1.304  4.357 0.285 0.279
 16   4.305  1.186  7.424 0.008 0.713
 17   1.860 -1.396  5.116 0.257 0.296
 18   3.810  0.544  7.075 0.023 0.603
 19   5.114  2.342  7.886 0.000 0.954
 20   0.864 -2.690  4.418 0.628 0.126
    istotnych         min_p         max_p   min_roznica   max_roznica
       10.000         0.000         0.628         0.864         7.171
CI_obejmuje_3
       18.000
     odsetek_istotnych     sredni_d_wszystkie       sredni_d_istotne
                 0.473                  0.504                  0.729
odsetek_CI_z_prawdziwa
                 0.947
[1] 0.478
[1] 64
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test() i power.t.test() z pakietu stats); rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Od czego zacząć naukę statystyki na studiach?
Zacznij od rodzajów zmiennych i statystyk opisowych: średniej, mediany, odchylenia standardowego, odsetków i wykresów. Potem poznaj rozkład z próby, błąd standardowy i przedział ufności, a dopiero na tej podstawie testowanie hipotez, wartość p i wielkość efektu. Testy i modele są łatwiejsze, gdy rozumiesz te podstawy.
Dlaczego badanie z prawdziwym efektem może dać wynik nieistotny?
Bo każda próba zawiera przypadek, a test ma ograniczoną moc. Przy 30 osobach w grupie i umiarkowanym efekcie (d = 0.5) wynik istotny pojawia się tylko w około 48% badań, więc mniej więcej co drugi badacz „nie znajdzie” istniejącego efektu. Dlatego liczebność próby planuje się przed badaniem, a wynik nieistotny opisuje z przedziałem ufności.
Jakie analizy statystyczne są najczęściej w pracach licencjackich?
Najczęściej są to statystyki opisowe i charakterystyka próby, porównanie dwóch grup (test t Welcha albo test U Manna–Whitneya), korelacja Pearsona lub Spearmana, test chi-kwadrat dla zmiennych jakościowych oraz rzetelność skal (alfa Cronbacha). W pracach magisterskich dochodzą częściej regresja wieloraka, moderacja, mediacja i analiza czynnikowa.
Czy student musi znać R, żeby napisać pracę dyplomową?
Nie. Te same analizy wykonasz w SPSS, JASP czy jamovi, a wyniki będą identyczne. R daje jednak pełną kontrolę i powtarzalność, bo cały przebieg analizy zapisujesz w skrypcie. Wybierz program, który zna Twój promotor albo który jest dostępny na uczelni, i nie zmieniaj go w trakcie analiz.
Jak poradzić sobie z lękiem przed statystyką?
Lęk przed statystyką jest wśród studentów częsty i da się go zmniejszyć. Pomaga nauka na własnych, zrozumiałych danych, zaczynanie od wykresów zamiast wzorów, wyjaśnianie wyników zwykłym językiem i regularna praca małymi krokami. Gdy utkniesz, przyjdź na konsultacje z konkretnym pytaniem i wydrukiem.
Powiązane hasła
Przeczytaj też
Statystyka do pracy licencjackiej
Typowe plany analiz w licencjacie, co przygotować przed analizą i przykład z danymi CSV: alfa, korelacja, test t Welcha, chi-kwadrat i skrócony rozdział wyników.
Czytaj →PoradnikStatystyka do pracy magisterskiej
Plan analiz, CFA i omega, regresja hierarchiczna, moderacja i mediacja z bootstrapem, wzory opisu APA i pytania na obronie – z danymi i kodem R.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →Utknąłeś(-aś) przy analizie do pracy?
Sprawdzimy plan analiz, policzymy wyniki i wyjaśnimy je tak, abyś rozumiał(a) każdą liczbę i umiał(a) ją obronić przed promotorem i komisją.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- ALLEA. (2023). The European Code of Conduct for Research Integrity (Revised edition 2023). ALLEA – All European Academies. https://allea.org/wp-content/uploads/2023/06/European-Code-of-Conduct-Revised-Edition-2023.pdf ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475 ● Otwarty dostęp
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE.
- Gelman, A., & Stern, H. (2006). The difference between “significant” and “not significant” is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006x152649
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Hoekstra, R., Morey, R. D., Rouder, J. N., & Wagenmakers, E.-J. (2014). Robust misinterpretation of confidence intervals. Psychonomic Bulletin & Review, 21(5), 1157–1164. https://doi.org/10.3758/s13423-013-0572-3 ● Otwarty dostęp: pełny tekst
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Norman, G. (2010). Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
- Onwuegbuzie, A. J., & Wilson, V. A. (2003). Statistics anxiety: Nature, etiology, antecedents, effects, and treatments – a comprehensive review of the literature. Teaching in Higher Education, 8(2), 195–209. https://doi.org/10.1080/1356251032000052447
Cytowania BibTeX
@techreport{allea2023european, author={{ALLEA}}, title={{The European Code of Conduct for Research Integrity (Revised edition 2023)}}, year={2023}, institution={ALLEA – All European Academies}, url={https://allea.org/wp-content/uploads/2023/06/European-Code-of-Conduct-Revised-Edition-2023.pdf}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{button2013power, author={Button, Katherine S. and Ioannidis, John P. A. and Mokrysz, Claire and Nosek, Brian A. and Flint, Jonathan and Robinson, Emma S. J. and Munafò, Marcus R.}, title={{Power failure: Why small sample size undermines the reliability of neuroscience}}, journal={Nature Reviews Neuroscience}, year={2013}, volume={14}, number={5}, pages={365--376}, doi={10.1038/nrn3475}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@book{field2018discovering, author={Field, Andy}, title={{Discovering statistics using IBM SPSS Statistics}}, year={2018}, edition={5th}, publisher={SAGE}}@article{gelman2006difference, author={Gelman, Andrew and Stern, Hal}, title={{The difference between “significant” and “not significant” is not itself statistically significant}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={328--331}, doi={10.1198/000313006x152649}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{hoekstra2014robust, author={Hoekstra, Rink and Morey, Richard D. and Rouder, Jeffrey N. and Wagenmakers, Eric-Jan}, title={{Robust misinterpretation of confidence intervals}}, journal={Psychonomic Bulletin \& Review}, year={2014}, volume={21}, number={5}, pages={1157--1164}, doi={10.3758/s13423-013-0572-3}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{norman2010likert, author={Norman, Geoff}, title={{Likert scales, levels of measurement and the “laws” of statistics}}, journal={Advances in Health Sciences Education}, year={2010}, volume={15}, number={5}, pages={625--632}, doi={10.1007/s10459-010-9222-y}}@article{onwuegbuzie2003statistics, author={Onwuegbuzie, Anthony J. and Wilson, Vicki A.}, title={{Statistics anxiety: Nature, etiology, antecedents, effects, and treatments – a comprehensive review of the literature}}, journal={Teaching in Higher Education}, year={2003}, volume={8}, number={2}, pages={195--209}, doi={10.1080/1356251032000052447}}