Centralne twierdzenie graniczne – co dokładnie mówi?
Centralne twierdzenie graniczne (CTG, ang. central limit theorem) mówi, że średnia z dużej liczby niezależnych obserwacji pochodzących z tego samego rozkładu ma w przybliżeniu rozkład normalny – niezależnie od tego, jaki kształt ma rozkład pojedynczych obserwacji. Warunek jest jeden, ale ważny: rozkład w populacji musi mieć skończoną wariancję. Kwak i Kim (2017) nazywają to twierdzenie fundamentem współczesnej statystyki, bo na nim opiera się wiele testów parametrycznych, w tym test t Studenta.
W zapisie, którego używa większość podręczników: jeśli populacja ma średnią μ i odchylenie standardowe σ, a z populacji losujesz niezależnie n osób, to średnia z próby M ma rozkład coraz bliższy normalnemu:
W tym zdaniu są trzy osobne informacje i warto je rozdzielić, bo tylko jedna z nich jest „graniczna”:
- Środek: średnie z prób skupiają się wokół μ. To prawda dla każdego n, także dla n = 2.
- Rozrzut: odchylenie standardowe rozkładu średnich wynosi σ / √n. To błąd standardowy średniej – i ten wzór też obowiązuje przy każdym n, o ile obserwacje są niezależne.
- Kształt: rozkład średnich staje się normalny dopiero „w granicy”, czyli wraz ze wzrostem n. To jest właściwa treść CTG – i właśnie tu pojawia się pytanie, jak duże n wystarczy.
Najważniejsze dla praktyki: CTG mówi o rozkładzie średniej, a nie o rozkładzie danych. Jeśli czasy reakcji w Twojej próbie są prawostronnie skośne, to przy 300 osobach nadal będą skośne – CTG nie sprawi, że „dane staną się normalne”. Sprawi natomiast, że średnia z takich danych będzie zachowywała się przewidywalnie.
Ten wpis pokazuje samo twierdzenie: symulacje dla czterech różnych rozkładów i kilku liczebności, tempo, w jakim rozkład średnich zbliża się do normalnego, sytuacje, w których CTG nie pomaga, oraz to, co z tego wynika dla testu t, ANOVA i regresji. Jeśli interesuje Cię, jak z rozkładu średnich powstaje wartość p, przeczytaj wpis P value krok po kroku – tam CTG jest jednym z kroków rachunku.
Dlaczego średnie układają się w dzwon
Intuicja jest prosta. Średnia to suma podzielona przez n, a w sumie wiele niezależnych składników wzajemnie się „równoważy”: pojedynczy bardzo wysoki wynik zostaje rozcieńczony przez pozostałe, a kombinacji, które dają wynik bliski środka, jest znacznie więcej niż kombinacji dających wynik skrajny. Przy rzucie jedną kostką każda liczba oczek od 1 do 6 jest równie prawdopodobna. Przy średniej z dwóch kostek wynik 3.5 można uzyskać na sześć sposobów, a wynik 6 – tylko na jeden. Przy dziesięciu kostkach skrajne średnie stają się już bardzo rzadkie.
Ten sam mechanizm działa przy dowolnej zmiennej z próby losowej: wyniku kwestionariusza, czasie reakcji czy liczbie objawów. Nie działa natomiast dowolnie szybko. Im bardziej skośny rozkład i im cięższe ma ogony, tym więcej obserwacji potrzeba, żeby skrajne wartości przestały „przeważać” średnią. Pokazuje to symulacja.
Symulacja: cztery populacje, różne liczebności prób
W symulacji przyjęliśmy cztery populacje, które przypominają dane z badań psychologicznych (dane symulowane, obliczenia w R):
- Pozycja skali Likerta 1–5 – większość osób zaznacza 4 lub 5; rozkład jest lewostronnie skośny, skośność −0.88, μ = 3.89, σ = 1.09.
- Czas reakcji w ms – typowo prawostronnie skośny, z długim ogonem wolnych odpowiedzi; skośność 2.26, μ = 542.95, σ = 192.84.
- Liczba napadów paniki w miesiącu – większość osób ma zero, nieliczne kilka lub kilkanaście; skośność 2.87, μ = 1.20, σ = 2.02.
- Czas korzystania z aplikacji w minutach dziennie – bardzo silna skośność (15.60) i ciężki prawy ogon: kilka osób spędza w aplikacji wielokrotność średniego czasu; μ = 46.76, σ = 98.30.
Z każdej populacji wylosowaliśmy po 20 000 prób o liczebności 5, 10, 30, 100 i 300 osób i w każdej policzyliśmy średnią. Rysunek 1 pokazuje rozkład tych średnich dla trzech liczebności.
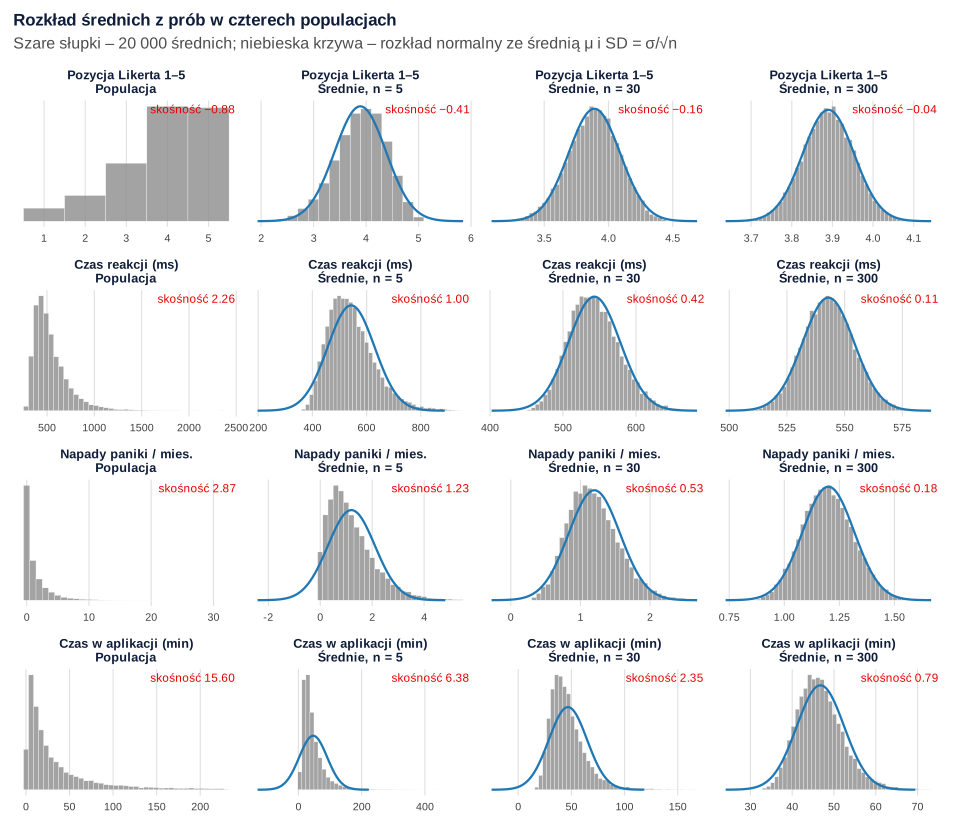
Średnia ze wszystkich średnich była w każdej komórce praktycznie równa μ (np. 542.73–543.84 ms dla czasu reakcji), a odchylenie standardowe średnich zgadzało się ze wzorem σ / √n: dla czasu reakcji i n = 30 wyniosło 35.11 ms wobec teoretycznych 35.21 ms. Te dwie części twierdzenia działają więc od razu. Różnice widać dopiero w kształcie:
| Populacja | Skośność danych | n = 5 | n = 10 | n = 30 | n = 100 | n = 300 |
|---|---|---|---|---|---|---|
| Pozycja Likerta 1–5 | −0.88 | −0.41 | −0.31 | −0.16 | −0.09 | −0.04 |
| Czas reakcji (ms) | 2.26 | 1.00 | 0.68 | 0.42 | 0.20 | 0.11 |
| Napady paniki w miesiącu | 2.87 | 1.23 | 0.92 | 0.53 | 0.32 | 0.18 |
| Czas w aplikacji (min) | 15.60 | 6.38 | 3.78 | 2.35 | 1.60 | 0.79 |
Przy pozycji Likerta już średnie z 5 osób mają rozkład zbliżony do normalnego. Przy czasie reakcji i liczbie napadów paniki rozkład średnich z 30 osób jest wciąż lekko skośny, ale przy 100 osobach różnica jest już niewielka. Przy czasie w aplikacji nawet średnie z 300 osób mają skośność 0.79 – wyraźnie więcej niż średnie z 5 odpowiedzi na skali Likerta.
Jak szybko działa CTG? Mit „n ≥ 30”
Dla średniej z niezależnych obserwacji istnieje prosta zależność: skośność rozkładu średnich jest równa skośności populacji podzielonej przez √n, a nadwyżka kurtozy maleje jeszcze szybciej – proporcjonalnie do 1/n.
Dla trzech pierwszych populacji wartości z symulacji niemal pokrywają się z tym wzorem, np. dla czasu reakcji i n = 30: 0.42 w symulacji wobec 0.41 ze wzoru. Przy czasie w aplikacji zgodność jest słabsza (2.35 wobec 2.85), bo o skośności decydują tam bardzo rzadkie, skrajne wartości, które nawet w 20 000 prób pojawiają się nieregularnie. Wynika z niego, ile osób potrzeba, żeby skośność rozkładu średnich spadła poniżej 0.5:
- pozycja Likerta: 4 osoby;
- czas reakcji: 21 osób;
- napady paniki: 33 osoby;
- czas w aplikacji: 974 osoby.
Popularna reguła „od 30 osób rozkład średniej jest normalny” jest więc prawdziwa dla jednych danych i fałszywa dla innych. Nie ma jednej liczebności, od której CTG „zaczyna działać” – potrzebne n zależy od skośności i ciężkości ogonów rozkładu. Pozycja skali Likerta, która ma tylko pięć wartości, jest pod tym względem łagodniejsza niż czas korzystania z aplikacji, w którym kilka osób może mieć wynik dziesięciokrotnie większy od średniej.
Czy dane z psychologii są zwykle „łagodne”? Raczej nie. Micceri (1989) przeanalizował 440 dużych rozkładów wyników testów osiągnięć i miar psychometrycznych i wszystkie istotnie odbiegały od normalności – m.in. ciężkością ogonów i asymetrią. Blanca i in. (2013) sprawdzili 693 rozkłady z małych prób (n = 10–30): skośność wynosiła od −2.49 do 2.33, kurtoza od −1.92 do 7.41, a tylko 5.5% rozkładów było bliskich normalnemu. Cain i in. (2017) stwierdzili odejście od normalności w 74% rozkładów jednowymiarowych z artykułów w Psychological Science i American Educational Research Journal.
Co to oznacza dla przedziału ufności i testu t
Przedział ufności dla średniej i test t dla jednej próby korzystają z tego, że średnia (a dokładniej statystyka t) ma znany rozkład. Jeśli rozkład średnich jest skośny, 95% przedział ufności obejmuje prawdziwą średnią rzadziej niż w 95% prób. Sprawdziliśmy to w symulacji: dla każdej populacji i liczebności policzyliśmy 20 000 przedziałów t i odsetek tych, które zawierały μ (rysunek 2).
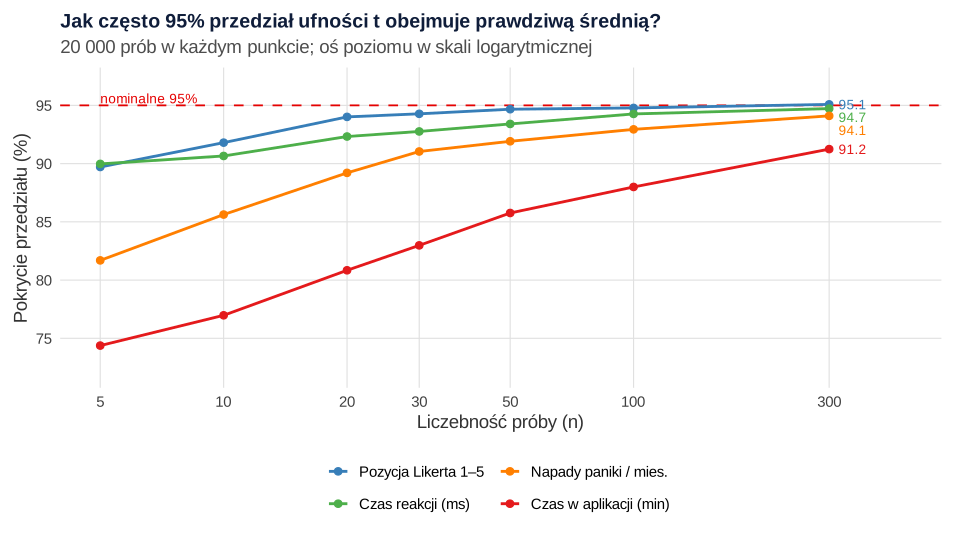
Przy pozycji Likerta pokrycie od n = 20 wynosiło 94.0% lub więcej. Przy liczbie napadów paniki i 30 osobach – 91.0%, a przy czasie w aplikacji i 30 osobach – tylko 83.0%; nawet 300 osób dało 91.2%. Ciekawsze jest jednak to, w którą stronę przedział chybia. Przy prawostronnie skośnych danych prawie wszystkie chybienia to przedziały leżące w całości poniżej μ: dla czasu w aplikacji i n = 30 aż 16.9% przedziałów było za nisko i tylko 0.1% za wysoko. Przyczyna: w małej próbie z długim prawym ogonem zwykle brakuje rzadkich, bardzo wysokich wartości, więc średnia z próby jest częściej za niska, a odchylenie standardowe – niedoszacowane.
Ma to praktyczną konsekwencję dla testów jednostronnych. W teście dwustronnym błędy w obu ogonach częściowo się kompensują, w jednostronnym – nie. Jeśli hipoteza dotyczy jednego kierunku, a dane są wyraźnie skośne, CTG chroni Cię słabiej, niż sugeruje sama liczebność.
Dwie grupy: kiedy skośność się znosi, a kiedy nie
W teście t dla prób niezależnych sytuacja jest korzystniejsza. Statystyka opiera się na różnicy dwóch średnich, a jeśli obie grupy mają rozkład o tym samym kształcie i są równoliczne, ich skośności się odejmują. W symulacji obie grupy pochodziły z tej samej, silnie skośnej populacji napadów paniki, więc hipoteza zerowa była prawdziwa. Odsetek wyników p < .05 – czyli rzeczywisty błąd I rodzaju – wyniósł:
| Liczebności grup | Test dwustronny | Jednostronny: A < B | Jednostronny: A > B |
|---|---|---|---|
| 15 i 15 | 4.30% | 5.04% | 4.88% |
| 10 i 40 | 4.21% | 2.34% | 6.27% |
| 100 i 100 | 5.04% | 5.08% | 5.15% |
Przy równych grupach test działa poprawnie już przy 15 osobach w każdej, mimo skośności danych 2.87. Przy grupach 10 i 40 osób test dwustronny nadal trzyma poziom, ale testy jednostronne rozjeżdżają się: 2.34% w jedną stronę i 6.27% w drugą. To zgodne z ogólniejszym obrazem z literatury: Blanca i in. (2017) w symulacji z trzema grupami i rozkładami typowymi dla nauk o zdrowiu i nauk społecznych stwierdzili, że test F w ANOVA utrzymał poprawny poziom błędu I rodzaju we wszystkich badanych warunkach.
CTG nie naprawia natomiast nierównych wariancji. W drugiej symulacji dane były idealnie normalne, ale mniejsza grupa miała dwa razy większe odchylenie standardowe niż większa. Klasyczny test t Studenta (z założeniem równych wariancji) dał wynik istotny w 17.95% prób przy grupach 20 i 80 osób – i dokładnie tyle samo przy grupach 200 i 800 osób. Większa próba w ogóle nie pomogła, bo problem nie dotyczy kształtu rozkładu średnich, tylko źle oszacowanego błędu standardowego różnicy. Test Welcha dał w tych samych danych 5.20% i 4.92%. Dlatego Delacre i in. (2017) zalecają, by test Welcha był domyślnym wyborem w psychologii, zamiast wstępnego testowania równości wariancji.
Kiedy CTG nie działa albo działa za wolno
1. Rozkład bez skończonej wariancji
Klasyczne CTG wymaga, by wariancja populacji była skończona. Podręcznikowy kontrprzykład to rozkład Cauchy’ego: jego ogony są tak ciężkie, że wariancja – a nawet średnia – nie istnieje. Średnia z n obserwacji ma wtedy dokładnie ten sam rozkład Cauchy’ego co jedna obserwacja. W symulacji rozstęp ćwiartkowy średnich z prób z rozkładu normalnego malał z 0.422 przy n = 10 do 0.042 przy n = 1000, a dla rozkładu Cauchy’ego wynosił 2.045, 2.054 i 2.115 – średnia z tysiąca obserwacji nie była ani trochę dokładniejsza niż z dziesięciu. Rysunek 3 pokazuje, co to oznacza dla jednego badacza zbierającego dane.
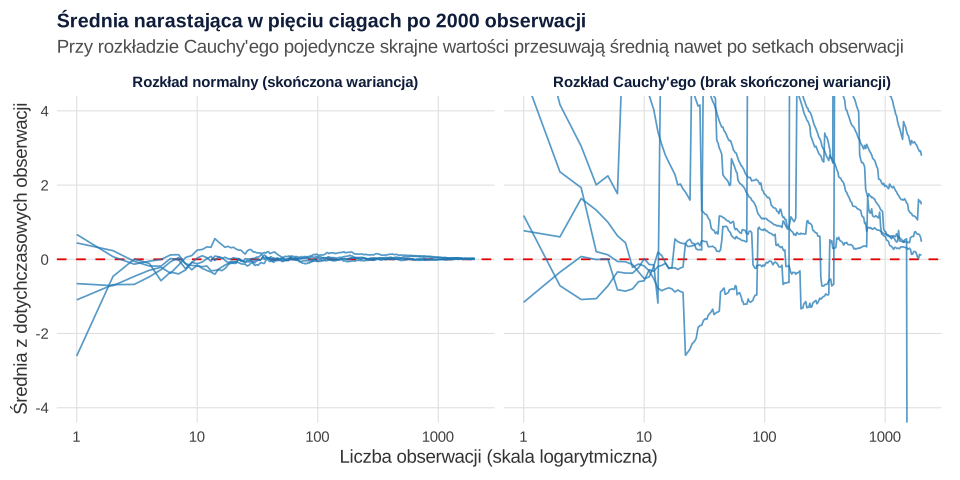
W danych psychologicznych rozkład Cauchy’ego w czystej postaci zdarza się rzadko, ale podobnie mogą zachowywać się ilorazy dwóch zmiennych (np. wskaźnik „wynik po / wynik przed”, gdy mianownik bywa bliski zeru) albo zmienne, w których pojedyncza osoba może mieć wynik o kilka rzędów wielkości większy niż inni.
2. Ciężkie ogony przy skończonej wariancji
Częstszy problem to rozkłady, w których wariancja jest skończona, ale zawyżona przez nieliczne skrajne wartości. CTG wtedy formalnie działa, ale wolno (jak przy czasie w aplikacji), a dodatkowo średnia staje się mało precyzyjna. Wilcox i Keselman (2003) pokazują, że metody oparte na odpornych miarach położenia, np. średniej ucinanej, mogą wtedy wyraźnie zwiększyć moc. W symulacji porównaliśmy dwie grupy po 30 osób z przesunięciem o 0.5 jednostki. Przy rozkładzie normalnym moc testu Welcha wyniosła 47.6%, a testu Yuena dla 20% średnich ucinanych 42.1%. Gdy jednak 10% obserwacji pochodziło z rozkładu o czterokrotnie większym odchyleniu standardowym, moc testu Welcha spadła do 25.5%, a testu Yuena – tylko do 36.1%. Błąd I rodzaju był w porządku; problemem jest to, że nieliczne obserwacje odstające zawyżają odchylenie standardowe (tutaj z 1 do 1.58) i „zagłuszają” efekt.
3. Obserwacje zależne
CTG w podstawowej wersji zakłada, że obserwacje są niezależne. W badaniu szkolnym uczniowie z jednej klasy są do siebie bardziej podobni niż uczniowie z różnych klas. W symulacji 300 uczniów z 20 klas (ICC = .20) potraktowano jak próbę 300 niezależnych osób. Naiwny 95% przedział ufności dla średniej objął prawdziwą wartość tylko w 68.8% prób. Efekt schematu wyniósł 3.8, czyli te 300 osób niesie tyle informacji co około 79 niezależnych. Tego CTG nie naprawi – potrzebny jest model wielopoziomowy albo inna analiza uwzględniająca grupowanie (zob. model wielopoziomowy krok po kroku w R).
4. Statystyka, która nie jest średnią
CTG dotyczy średnich i sum oraz statystyk, które da się do nich sprowadzić (np. różnica średnich, współczynniki regresji). Nie gwarantuje szybkiej normalności dla wariancji, odchylenia standardowego, wartości maksymalnej czy korelacji w małej próbie. Dlatego testy porównujące wariancje są znacznie bardziej wrażliwe na kształt rozkładu niż testy porównujące średnie, a przedział ufności dla korelacji przy nienormalnych danych wymaga osobnej uwagi.
5. Mała próba i silna skośność jednocześnie
Najczęstsza sytuacja w pracach dyplomowych: 20–30 osób w grupie i zmienna typu „liczba zdarzeń” albo „czas”. Tabela i rysunek 2 pokazują, że wtedy pokrycie przedziału może wynosić 85–92% zamiast 95%. To nie katastrofa, ale wystarczający powód, by pokazać rozkład danych, rozważyć transformację lub metodę odporną i nie powoływać się na CTG jak na zaklęcie.
Znaczenie CTG dla testów: t, ANOVA, regresja
Skąd w ogóle „założenie normalności”? W teście t, ANOVA i regresji liniowej wartości p i przedziały ufności liczy się z rozkładu statystyki testowej. Ten rozkład jest dokładny, gdy reszty mają rozkład normalny, a w przybliżeniu poprawny – dzięki CTG – gdy próba jest wystarczająco duża. Lumley i in. (2002) pokazali w symulacjach, że w dużych próbach test t i regresja liniowa dają trafne wnioski nawet przy skrajnie nienormalnych danych. Zwracają też uwagę, że ważniejsze bywa inne pytanie: czy różnica średnich w ogóle odpowiada na pytanie badawcze.
W praktyce wynika z tego kilka zasad:
| Sytuacja | Czy CTG pomaga? | Co zrobić |
|---|---|---|
| Umiarkowana skośność, dwie podobne grupy, kilkadziesiąt osób w każdej | tak | test t Welcha lub ANOVA; pokaż rozkład w histogramie lub na wykresie Q-Q |
| Silna skośność, mała próba (< 30 osób w grupie) | częściowo | transformacja (np. logarytmiczna dla czasów), metoda odporna, bootstrap; sprawdź zgodność wyników |
| Grupy o bardzo różnej liczebności i wariancji | nie | test Welcha zamiast testu Studenta, także w dużej próbie |
| Ciężkie ogony, pojedyncze skrajne wyniki | formalnie tak, ale moc spada | średnia ucinana i test Yuena, analiza wrażliwości z obserwacjami odstającymi i bez nich |
| Dane pogrupowane (klasy, pary, pomiary powtarzane) | nie w wersji podstawowej | model wielopoziomowy albo test dla prób zależnych |
| Hipoteza dotyczy mediany albo „typowej osoby”, a nie średniej | nie dotyczy | analiza median lub testy nieparametryczne – ale świadomie, z inną hipotezą |
Kilka uwag do tej tabeli:
- Nie testuj normalności, żeby wybrać test. Rochon i in. (2012) pokazali, że procedura „najpierw test Shapiro–Wilka, potem test t albo test U Manna–Whitneya” zniekształca warunkowe poziomy błędu I rodzaju obu testów. W dużej próbie test Shapiro–Wilka wykryje nieistotne odchylenia, w małej – przeoczy ważne. Jak oceniać rozkład na wykresach, opisujemy we wpisie jak sprawdzić normalność rozkładu.
- W regresji liczy się rozkład reszt, nie predyktorów ani zmiennej zależnej, a CTG dotyczy rozkładu współczynników, które są ważonymi średnimi. Szczegóły diagnostyki znajdziesz we wpisie regresja wieloraka krok po kroku.
- Metody odporne nie są „karą” za brak normalności. Field i Wilcox (2017) przypominają, że dane psychologiczne częściej naruszają założenia modelu liniowego, niż je spełniają, i pokazują, jak liczyć odporne odpowiedniki testu t, ANOVA i regresji w R.
- Bootstrap nie jest automatycznym lekarstwem. Hesterberg (2015) zwraca uwagę, że popularny percentylowy przedział bootstrapowy przy małych próbach bywa mniej dokładny niż przedział t, a przewagę zyskuje dopiero przy większych próbach.
Jeśli wybierasz test do swojej hipotezy, przydadzą Ci się też wpisy test t Studenta krok po kroku i testy nieparametryczne krok po kroku. To, ile osób zbadać, żeby mieć wystarczającą moc i precyzję, omawiamy osobno w poradniku dobór liczebności próby.
Jak opisać to w pracy
Promotor lub recenzent nie oczekuje wykładu o CTG. Oczekuje jednego–dwóch zdań, które pokazują, że sprawdzono rozkład danych i świadomie dobrano analizę. Poniższe wzory dotyczą typowych sytuacji; liczby zastąp własnymi.
Zwróć uwagę, czego w tych zdaniach nie ma: nie ma „dane miały rozkład normalny na mocy centralnego twierdzenia granicznego” (CTG nie dotyczy danych) ani „próba była większa niż 30, więc spełniono założenie normalności” (próg zależy od rozkładu). Jeśli potrzebujesz pomocy w doborze analizy do swoich danych i chcesz zrozumieć, dlaczego wybrano taki test, zajrzyj do oferty analiz statystycznych dla studentów – wyjaśniamy decyzje tak, abyś mógł (mogła) obronić je samodzielnie.
Symulacje w R
Kod odtwarza wszystkie liczby z tekstu i tabel. Uruchom przepisy po kolei w jednej sesji R – przepis 2 korzysta z listy populacje utworzonej w przepisie 1. Używamy wyłącznie funkcji podstawowej instalacji R. Przepis 2 trwa najdłużej (około pół minuty), bo wykonuje 120 000 testów t w pętli.
1. Rozkład średnich z czterech populacji
R
# Centralne twierdzenie graniczne w symulacji: jak wygląda rozkład średnich z prób
# z czterech różnych populacji i jak szybko zbliża się do rozkładu normalnego (dane symulowane).
options(width = 110)
set.seed(1515)
R <- 20000                                   # liczba prób w każdej komórce symulacji
n_lista <- c(5, 10, 30, 100, 300)

# Cztery populacje – generatory i parametry teoretyczne (średnia, SD, skośność)
p_lik <- c(.04, .08, .18, .35, .35)          # pozycja skali Likerta 1–5 (lewostronnie skośna)
mu_lik <- sum(1:5 * p_lik); sd_lik <- sqrt(sum((1:5 - mu_lik)^2 * p_lik))
sk_lik <- sum((1:5 - mu_lik)^3 * p_lik) / sd_lik^3
lognorm_sk <- function(s) (exp(s^2) + 2) * sqrt(exp(s^2) - 1)
populacje <- list(
  likert = list(los = function(k) sample(1:5, k, TRUE, p_lik), M = mu_lik, SD = sd_lik, sk = sk_lik),
  czas_reakcji = list(los = function(k) 250 + rlnorm(k, 5.5, 0.6),            # ms
                      M = 250 + exp(5.5 + 0.6^2 / 2), SD = sqrt((exp(0.6^2) - 1) * exp(2 * 5.5 + 0.6^2)), sk = lognorm_sk(0.6)),
  napady_paniki = list(los = function(k) rnbinom(k, size = 0.5, mu = 1.2),    # liczba w miesiącu
                       M = 1.2, SD = sqrt(1.2 + 1.2^2 / 0.5),
                       sk = { p <- 0.5 / (0.5 + 1.2); (2 - p) / sqrt(0.5 * (1 - p)) }),
  czas_w_aplikacji = list(los = function(k) rlnorm(k, 3, 1.3),                # minuty dziennie
                          M = exp(3 + 1.3^2 / 2), SD = sqrt((exp(1.3^2) - 1) * exp(2 * 3 + 1.3^2)), sk = lognorm_sk(1.3)))

parametry <- t(sapply(populacje, function(p) round(c(M = p$M, SD = p$SD, skosnosc = p$sk), 2)))
parametry

skosnosc <- function(x) mean((x - mean(x))^3) / mean((x - mean(x))^2)^1.5
wyniki <- list(); srednie_rys <- list()   # srednie_rys: średnie dla n = 5, 30 i 300 (do rysunku 1)
for (nazwa in names(populacje)) {
  p <- populacje[[nazwa]]
  for (n in n_lista) {
    m <- colMeans(matrix(p$los(n * R), nrow = n))       # R średnich z prób o liczebności n
    wyniki[[length(wyniki) + 1]] <- data.frame(populacja = nazwa, n = n,
      M_srednich = mean(m), SD_srednich = sd(m), SE_teoria = p$SD / sqrt(n),
      skosnosc_srednich = skosnosc(m), skosnosc_teoria = p$sk / sqrt(n))
    if (n %in% c(5, 30, 300)) srednie_rys[[length(srednie_rys) + 1]] <- data.frame(populacja = nazwa, n = n, m = m)
  }
}
wyniki <- do.call(rbind, wyniki)
print(transform(wyniki, M_srednich = round(M_srednich, 2), SD_srednich = round(SD_srednich, 3),
                SE_teoria = round(SE_teoria, 3), skosnosc_srednich = round(skosnosc_srednich, 2),
                skosnosc_teoria = round(skosnosc_teoria, 2)), row.names = FALSE)

# Przy jakim n skośność rozkładu średnich spada poniżej 0.5 (wzór: skośność populacji / √n)?
sapply(populacje, function(p) ceiling((p$sk / 0.5)^2))
Wynik w R
                      M     SD skosnosc
likert             3.89   1.09    -0.88
czas_reakcji     542.95 192.84     2.26
napady_paniki      1.20   2.02     2.87
czas_w_aplikacji  46.76  98.30    15.60
        populacja   n M_srednich SD_srednich SE_teoria skosnosc_srednich skosnosc_teoria
           likert   5       3.90       0.489     0.489             -0.41           -0.39
           likert  10       3.89       0.347     0.346             -0.31           -0.28
           likert  30       3.89       0.201     0.200             -0.16           -0.16
           likert 100       3.89       0.109     0.109             -0.09           -0.09
           likert 300       3.89       0.063     0.063             -0.04           -0.05
     czas_reakcji   5     543.84      87.338    86.242              1.00            1.01
     czas_reakcji  10     542.94      60.558    60.982              0.68            0.71
     czas_reakcji  30     542.96      35.111    35.208              0.42            0.41
     czas_reakcji 100     542.73      19.132    19.284              0.20            0.23
     czas_reakcji 300     543.04      11.105    11.134              0.11            0.13
    napady_paniki   5       1.20       0.896     0.903              1.23            1.28
    napady_paniki  10       1.20       0.640     0.639              0.92            0.91
    napady_paniki  30       1.20       0.368     0.369              0.53            0.52
    napady_paniki 100       1.20       0.204     0.202              0.32            0.29
    napady_paniki 300       1.20       0.116     0.117              0.18            0.17
 czas_w_aplikacji   5      46.75      44.367    43.961              6.38            6.98
 czas_w_aplikacji  10      46.63      30.648    31.085              3.78            4.93
 czas_w_aplikacji  30      46.59      17.606    17.947              2.35            2.85
 czas_w_aplikacji 100      46.75       9.898     9.830              1.60            1.56
 czas_w_aplikacji 300      46.70       5.611     5.675              0.79            0.90
          likert     czas_reakcji    napady_paniki czas_w_aplikacji
               4               21               33              974
2. Pokrycie przedziału t, błąd I rodzaju i test Welcha
R
# Czy przedział ufności t i test t „działają” przy danych nienormalnych? (dane symulowane)
# Uruchom po przepisie 1 (korzysta z listy populacje).
options(width = 110)
set.seed(2715)
R <- 20000
n_lista <- c(5, 10, 20, 30, 50, 100, 300)

# 1. Jedna próba: pokrycie 95% przedziału t i to, po której stronie przedział „chybia”
pokrycie <- list()
for (nazwa in names(populacje)) {
  p <- populacje[[nazwa]]
  for (n in n_lista) {
    x <- matrix(p$los(n * R), nrow = n)
    m <- colMeans(x); s <- sqrt((colSums(x^2) - n * m^2) / (n - 1))
    kr <- qt(.975, n - 1) * s / sqrt(n)
    pokrycie[[length(pokrycie) + 1]] <- data.frame(populacja = nazwa, n = n,
      pokrycie = 100 * mean(m - kr <= p$M & p$M <= m + kr),
      chybia_nizej = 100 * mean(m + kr < p$M),     # cały przedział poniżej prawdziwej średniej
      chybia_wyzej = 100 * mean(m - kr > p$M))
  }
}
pokrycie <- do.call(rbind, pokrycie)
print(transform(pokrycie, pokrycie = round(pokrycie, 1), chybia_nizej = round(chybia_nizej, 1),
                chybia_wyzej = round(chybia_wyzej, 1)), row.names = FALSE)

# 2. Dwie grupy z tej samej skośnej populacji (napady paniki), H0 prawdziwa: odsetek wyników p < .05
blad_I <- function(n1, n2, los, R = 20000) {
  p_dw <- p_lewy <- p_prawy <- numeric(R)
  for (i in seq_len(R)) {
    a <- los(n1); b <- los(n2)
    t <- t.test(a, b, var.equal = TRUE)
    p_dw[i] <- t$p.value
    p_lewy[i] <- pt(t$statistic, t$parameter)                 # H1: średnia A < średnia B
    p_prawy[i] <- pt(t$statistic, t$parameter, lower.tail = FALSE)
  }
  round(100 * c(dwustronny = mean(p_dw < .05), jednostronny_lewy = mean(p_lewy < .05),
                jednostronny_prawy = mean(p_prawy < .05)), 2)
}
los_np <- populacje$napady_paniki$los
rbind(`n = 15 i 15` = blad_I(15, 15, los_np), `n = 10 i 40` = blad_I(10, 40, los_np),
      `n = 100 i 100` = blad_I(100, 100, los_np))

# 3. CTG nie naprawia nierównych wariancji: rozkład normalny, SD = 2 w mniejszej grupie i 1 w większej
nierowne <- function(n1, n2, R = 20000) {
  st <- we <- numeric(R)
  for (i in seq_len(R)) {
    a <- rnorm(n1, 0, 2); b <- rnorm(n2, 0, 1)
    st[i] <- t.test(a, b, var.equal = TRUE)$p.value
    we[i] <- t.test(a, b)$p.value
  }
  round(100 * c(Student = mean(st < .05), Welch = mean(we < .05)), 2)
}
rbind(`n = 20 i 80` = nierowne(20, 80), `n = 200 i 800` = nierowne(200, 800))
Wynik w R
        populacja   n pokrycie chybia_nizej chybia_wyzej
           likert   5     89.7          1.2          9.0
           likert  10     91.8          1.0          7.2
           likert  20     94.0          1.4          4.6
           likert  30     94.3          1.6          4.2
           likert  50     94.7          1.5          3.9
           likert 100     94.8          1.8          3.5
           likert 300     95.1          2.0          2.9
     czas_reakcji   5     90.0          9.6          0.5
     czas_reakcji  10     90.7          8.9          0.5
     czas_reakcji  20     92.3          7.1          0.6
     czas_reakcji  30     92.8          6.4          0.8
     czas_reakcji  50     93.4          5.7          0.9
     czas_reakcji 100     94.3          4.6          1.2
     czas_reakcji 300     94.7          3.6          1.7
    napady_paniki   5     81.7         18.2          0.1
    napady_paniki  10     85.6         14.2          0.1
    napady_paniki  20     89.2         10.5          0.3
    napady_paniki  30     91.0          8.6          0.4
    napady_paniki  50     91.9          7.4          0.7
    napady_paniki 100     92.9          6.2          0.9
    napady_paniki 300     94.1          4.4          1.5
 czas_w_aplikacji   5     74.4         25.6          0.1
 czas_w_aplikacji  10     77.0         23.0          0.0
 czas_w_aplikacji  20     80.8         19.1          0.0
 czas_w_aplikacji  30     83.0         16.9          0.1
 czas_w_aplikacji  50     85.8         14.2          0.1
 czas_w_aplikacji 100     88.0         11.8          0.2
 czas_w_aplikacji 300     91.2          8.3          0.5
              dwustronny jednostronny_lewy jednostronny_prawy
n = 15 i 15         4.30              5.04               4.88
n = 10 i 40         4.21              2.34               6.27
n = 100 i 100       5.04              5.08               5.15
              Student Welch
n = 20 i 80     17.95  5.20
n = 200 i 800   17.95  4.92
3. Kiedy CTG zawodzi: Cauchy, ciężkie ogony, dane zależne
R
# Kiedy CTG nie pomaga: brak skończonej wariancji, ciężkie ogony i obserwacje zależne (dane symulowane).
options(width = 110)
set.seed(3115)
R <- 20000

# 1. Rozkład Cauchy'ego (brak skończonej wariancji): rozrzut średnich nie maleje wraz z n
iqr_srednich <- sapply(c(10, 100, 1000), function(n) {
  c(normalny = IQR(colMeans(matrix(rnorm(n * 5000), nrow = n))),
    Cauchy = IQR(colMeans(matrix(rcauchy(n * 5000), nrow = n))))
})
colnames(iqr_srednich) <- paste("n =", c(10, 100, 1000))
round(iqr_srednich, 3)

# 2. Ciężkie ogony przy skończonej wariancji: 10% osób z rozkładu o 4 razy większym SD
#    (rozkład „zanieczyszczony”); dwie grupy po 30 osób, przesunięcie o 0.5
los_zanieczyszczony <- function(k) ifelse(runif(k) < .10, rnorm(k, 0, 4), rnorm(k, 0, 1))
test_yuena <- function(a, b, g = 0.2) {               # test Yuena dla średnich ucinanych 20%
  sk <- function(x) { n <- length(x); k <- floor(g * n); xs <- sort(x)
    w <- c(rep(xs[k + 1], k), xs[(k + 1):(n - k)], rep(xs[n - k], k))   # winsoryzacja
    h <- n - 2 * k; c(m = mean(xs[(k + 1):(n - k)]), d = (n - 1) * var(w) / (h * (h - 1)), h = h) }
  A <- sk(a); B <- sk(b)
  t <- (A[["m"]] - B[["m"]]) / sqrt(A[["d"]] + B[["d"]])
  df <- (A[["d"]] + B[["d"]])^2 / (A[["d"]]^2 / (A[["h"]] - 1) + B[["d"]]^2 / (B[["h"]] - 1))
  2 * pt(abs(t), df, lower.tail = FALSE)
}
moc <- function(los, n = 30, przesuniecie = 0.5, R = 10000) {
  p_t <- p_y <- numeric(R)
  for (i in seq_len(R)) {
    a <- los(n) + przesuniecie; b <- los(n)
    p_t[i] <- t.test(a, b)$p.value; p_y[i] <- test_yuena(a, b)
  }
  round(100 * c(test_t_Welcha = mean(p_t < .05), test_Yuena = mean(p_y < .05)), 1)
}
rbind(normalny = moc(rnorm), zanieczyszczony = moc(los_zanieczyszczony))
round(c(SD_zanieczyszczonego = sqrt(.9 * 1 + .1 * 16)), 2)

# 3. Obserwacje zależne: 20 klas po 15 uczniów, ICC = .20; naiwny 95% CI dla średniej traktuje 300 osób jak niezależne
pokrycie_naiwne <- replicate(R, {
  klasa <- rep(rnorm(20, 0, sqrt(.20)), each = 15)
  y <- 50 + 10 * (klasa + rnorm(300, 0, sqrt(.80)))
  kr <- qt(.975, 299) * sd(y) / sqrt(300)
  abs(mean(y) - 50) <= kr
})
round(c(pokrycie_naiwne = 100 * mean(pokrycie_naiwne), efekt_schematu = 1 + (15 - 1) * .20,
        efektywne_n = 300 / (1 + (15 - 1) * .20)), 1)
Wynik w R
         n = 10 n = 100 n = 1000
normalny  0.422   0.135    0.042
Cauchy    2.045   2.054    2.115
                test_t_Welcha test_Yuena
normalny                 47.6       42.1
zanieczyszczony          25.5       36.1
SD_zanieczyszczonego
                1.58
pokrycie_naiwne  efekt_schematu     efektywne_n
           68.8             3.8            78.9
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów stats i base); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org
Najczęstsze błędy i mity o CTG
- „Przy dużej próbie dane mają rozkład normalny”. Nie – rozkład danych się nie zmienia. CTG dotyczy rozkładu średniej (i statystyk opartych na średnich).
- „Od 30 osób zawsze można stosować test t”. Potrzebna liczebność zależy od skośności i ogonów: w symulacji wystarczyły 4 osoby dla pozycji Likerta, ale dla czasu w aplikacji skośność średniej spadła poniżej 0.5 dopiero przy 974 osobach.
- „CTG rozwiązuje wszystkie problemy z założeniami”. Nie naprawia nierównych wariancji przy nierównych grupach (17.95% błędów I rodzaju niezależnie od liczebności), zależności obserwacji (pokrycie 68.8% zamiast 95%) ani spadku mocy przy ciężkich ogonach.
- Wybór testu na podstawie testu normalności. Wynik testu Shapiro–Wilka zależy głównie od liczebności; oceń rozkład na wykresie i dobierz analizę do pytania badawczego.
- Raportowanie średniej tam, gdzie pytanie dotyczy typowej osoby. CTG sprawia, że średnia czasu w aplikacji ma przewidywalny rozkład, ale nie sprawia, że opisuje „przeciętnego użytkownika”. Przy silnie skośnej zmiennej podaj też medianę.
- Utożsamianie CTG z prawem wielkich liczb. Prawo wielkich liczb mówi, że średnia z próby zbliża się do μ; CTG mówi coś więcej – jaki kształt ma rozkład odchyleń średniej od μ.
- Zapominanie o warunku niezależności. Kilkaset odpowiedzi z kilku klas, zespołów czy rodzin to nie kilkaset niezależnych obserwacji.
Jak te zagadnienia łączą się z resztą statystyki na studiach, pokazujemy we wpisie statystyka dla studenta.
Najczęstsze pytania
Co mówi centralne twierdzenie graniczne w prostych słowach?
Że średnie liczone z wielu niezależnych prób układają się w rozkład zbliżony do normalnego, nawet jeśli pojedyncze wyniki mają rozkład skośny. Środek tego rozkładu to średnia populacji, a jego odchylenie standardowe (błąd standardowy) wynosi σ/√n. Dzięki temu można liczyć przedziały ufności i testy dla średnich bez znajomości dokładnego rozkładu danych.
Od jakiej liczebności próby działa centralne twierdzenie graniczne?
Nie ma jednej granicy. Skośność rozkładu średniej maleje jak skośność danych podzielona przez √n, więc dla odpowiedzi na skali Likerta wystarczy kilka osób, dla typowych czasów reakcji – około 20–30, a dla zmiennych z bardzo długim ogonem (czas, dochód, liczba zdarzeń) nawet setki. Reguła „n ≥ 30” jest tylko przybliżeniem dla umiarkowanie skośnych danych.
Czy przy dużej próbie można pominąć założenie normalności w teście t?
Najczęściej tak – przy kilkudziesięciu lub więcej osobach w grupie test t i ANOVA są odporne na umiarkowane odchylenia od normalności, bo dzięki CTG rozkład różnicy średnich jest bliski normalnemu. Duża próba nie chroni jednak przed skutkami nierównych wariancji przy nierównych grupach (użyj testu Welcha), zależności obserwacji ani utratą mocy przy skrajnych wartościach.
Czym różni się centralne twierdzenie graniczne od prawa wielkich liczb?
Prawo wielkich liczb mówi, że średnia z próby zbliża się do średniej populacji, gdy liczebność rośnie. Centralne twierdzenie graniczne idzie dalej: opisuje kształt rozkładu odchyleń średniej z próby od średniej populacji – przybliżeniem jest rozkład normalny z odchyleniem σ/√n. To drugie twierdzenie pozwala liczyć przedziały ufności i wartości p.
Kiedy centralne twierdzenie graniczne nie działa?
Gdy rozkład nie ma skończonej wariancji (np. rozkład Cauchy’ego – średnia z tysiąca obserwacji jest wtedy tak samo niepewna jak jedna obserwacja), gdy obserwacje są zależne (np. uczniowie z tych samych klas) albo gdy statystyka nie jest średnią (np. wariancja, maksimum). Przy bardzo skośnych danych i małej próbie twierdzenie działa, ale zbyt wolno, by na nim polegać.
Powiązane hasła
Przeczytaj też
P value krok po kroku
Jak powstaje wartość p: rozkład z prób, centralne twierdzenie graniczne, błąd standardowy, statystyka Z i pole pod krzywą – z przykładem i tablicą Z.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikTest t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →Nie wiesz, czy Twoje dane „wytrzymają” test t?
Sprawdzimy rozkłady w Twojej bazie, dobierzemy test do pytania badawczego i wyjaśnimy każdą decyzję tak, abyś umiał(a) ją uzasadnić przed promotorem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Blanca, M. J., Alarcón, R., Arnau, J., Bono, R., & Bendayan, R. (2017). Non-normal data: Is ANOVA still a valid option? Psicothema, 29(4), 552–557. https://doi.org/10.7334/psicothema2016.383 ● Otwarty dostęp
- Blanca, M. J., Arnau, J., López-Montiel, D., Bono, R., & Bendayan, R. (2013). Skewness and kurtosis in real data samples. Methodology, 9(2), 78–84. https://doi.org/10.1027/1614-2241/a000057
- Cain, M. K., Zhang, Z., & Yuan, K.-H. (2017). Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation. Behavior Research Methods, 49(5), 1716–1735. https://doi.org/10.3758/s13428-016-0814-1 ● Otwarty dostęp
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Field, A. P., & Wilcox, R. R. (2017). Robust statistical methods: A primer for clinical psychology and experimental psychopathology researchers. Behaviour Research and Therapy, 98, 19–38. https://doi.org/10.1016/j.brat.2017.05.013 ● Otwarty dostęp: pełny tekst
- Hesterberg, T. C. (2015). What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum. The American Statistician, 69(4), 371–386. https://doi.org/10.1080/00031305.2015.1089789 ● Otwarty dostęp
- Kwak, S. G., & Kim, J. H. (2017). Central limit theorem: The cornerstone of modern statistics. Korean Journal of Anesthesiology, 70(2), 144–156. https://doi.org/10.4097/kjae.2017.70.2.144 ● Otwarty dostęp
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Rochon, J., Gondan, M., & Kieser, M. (2012). To test or not to test: Preliminary assessment of normality when comparing two independent samples. BMC Medical Research Methodology, 12(1), Article 81. https://doi.org/10.1186/1471-2288-12-81 ● Otwarty dostęp
- Wilcox, R. R., & Keselman, H. J. (2003). Modern robust data analysis methods: Measures of central tendency. Psychological Methods, 8(3), 254–274. https://doi.org/10.1037/1082-989X.8.3.254
Cytowania BibTeX
@article{blanca2017nonnormal, author={Blanca, María J. and Alarcón, Rafael and Arnau, Jaume and Bono, Roser and Bendayan, Rebecca}, title={{Non-normal data: Is ANOVA still a valid option?}}, journal={Psicothema}, year={2017}, volume={29}, number={4}, pages={552--557}, doi={10.7334/psicothema2016.383}}@article{blanca2013skewness, author={Blanca, María J. and Arnau, Jaume and López-Montiel, Dolores and Bono, Roser and Bendayan, Rebecca}, title={{Skewness and kurtosis in real data samples}}, journal={Methodology}, year={2013}, volume={9}, number={2}, pages={78--84}, doi={10.1027/1614-2241/a000057}}@article{cain2017univariate, author={Cain, Meghan K. and Zhang, Zhiyong and Yuan, Ke-Hai}, title={{Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={5}, pages={1716--1735}, doi={10.3758/s13428-016-0814-1}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{field2017robust, author={Field, Andy P. and Wilcox, Rand R.}, title={{Robust statistical methods: A primer for clinical psychology and experimental psychopathology researchers}}, journal={Behaviour Research and Therapy}, year={2017}, volume={98}, pages={19--38}, doi={10.1016/j.brat.2017.05.013}}@article{hesterberg2015what, author={Hesterberg, Tim C.}, title={{What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum}}, journal={The American Statistician}, year={2015}, volume={69}, number={4}, pages={371--386}, doi={10.1080/00031305.2015.1089789}}@article{kwak2017central, author={Kwak, Sang Gyu and Kim, Jong Hae}, title={{Central limit theorem: The cornerstone of modern statistics}}, journal={Korean Journal of Anesthesiology}, year={2017}, volume={70}, number={2}, pages={144--156}, doi={10.4097/kjae.2017.70.2.144}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@article{micceri1989unicorn, author={Micceri, Theodore}, title={{The unicorn, the normal curve, and other improbable creatures}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={156--166}, doi={10.1037/0033-2909.105.1.156}}@article{rochon2012test, author={Rochon, Justine and Gondan, Matthias and Kieser, Meinhard}, title={{To test or not to test: Preliminary assessment of normality when comparing two independent samples}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={81}, doi={10.1186/1471-2288-12-81}}@article{wilcox2003modern, author={Wilcox, Rand R. and Keselman, H. J.}, title={{Modern robust data analysis methods: Measures of central tendency}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={254--274}, doi={10.1037/1082-989x.8.3.254}}