Dobór liczebności próby: najpierw pytanie, ile chcesz wiedzieć
„Ile osób muszę zbadać?” to pytanie, które recenzent, komisja etyczna i grantodawca zadają w innej formie: dlaczego tyle i co z tej liczebności wynika dla wniosków? Odpowiedź „bo tyle udało się zebrać” bywa uczciwa, ale sama w sobie nic nie mówi o tym, czy badanie mogło odpowiedzieć na pytanie badawcze. Lakens (2022) wyróżnia sześć sposobów uzasadnienia liczebności próby i każdy z nich jest legalny, jeśli zostanie jasno opisany:
| Uzasadnienie | Kiedy ma sens | Co trzeba podać |
|---|---|---|
| Badanie (prawie) całej populacji | mała, zamknięta populacja, np. wszyscy pracownicy jednej organizacji | wielkość populacji i odsetek zbadanych |
| Ograniczenia zasobów | stały budżet, czas, dostęp do rzadkiej grupy klinicznej | skąd ograniczenie i jaki efekt badanie mogło wykryć (analiza wrażliwości) |
| Analiza mocy a priori | badanie testuje hipotezę o efekcie określonej wielkości | test, α, moc, wielkość efektu i jej źródło |
| Planowanie precyzji | celem jest oszacowanie (np. korelacji, różnicy) z określoną dokładnością | zakładana szerokość przedziału ufności i założenia o rozproszeniu |
| Heurystyka | „zwyczaj w dziedzinie”, reguły typu „30 na grupę” | uczciwe przyznanie, że to reguła, a nie obliczenie |
| Brak uzasadnienia | badanie eksploracyjne bez planu | jawne stwierdzenie tego faktu |
W tym poradniku przechodzimy przez cztery środkowe podejścia na jednym scenariuszu: planujesz eksperyment, w którym krótka interwencja ma obniżyć lęk przed egzaminem w porównaniu z grupą kontrolną (wynik na skali o SD około 10 punktów). Wszystkie liczby pochodzą z kodu R w sekcji Obliczenia w R; tam, gdzie potrzebna jest symulacja, dane są symulowane. Jeśli liczysz próbę do pracy dyplomowej z ankietą, zacznij od hasła liczebność próby w ankiecie – tu skupiamy się na badaniach testujących hipotezy i szacujących efekty.
Pięć decyzji, które musisz podjąć przed obliczeniem
- Analiza, którą naprawdę wykonasz. Liczebność liczy się dla konkretnego testu: inaczej dla testu t dla prób niezależnych, inaczej dla tego samego efektu w planie wewnątrzobiektowym, a jeszcze inaczej dla interakcji.
- Poziom istotności α – zwykle .05 dla testu dwustronnego, ale przy kilku hipotezach głównych z korektą trzeba policzyć próbę dla skorygowanego α.
- Pożądana moc, czyli prawdopodobieństwo wykrycia efektu, jeśli istnieje. Konwencją jest .80, ale przy badaniu, którego nie da się łatwo powtórzyć, lepiej .90 – błąd II rodzaju na poziomie 20% to dużo.
- Wielkość efektu – najtrudniejsza decyzja, której poświęcamy osobny akapit niżej.
- Odpływ i wykluczenia – liczba osób do rekrutacji jest większa niż liczba osób do analizy.
Skąd wziąć wielkość efektu?
Są dwa różne pytania i warto ich nie mylić. Pierwsze: jaki efekt spodziewam się zobaczyć? Drugie: jaki najmniejszy efekt miałby dla mnie znaczenie? To drugie to najmniejszy interesujący efekt (SESOI) i to on jest lepszą podstawą planowania, bo nie zależy od optymizmu badacza. SESOI można wyznaczyć teoretycznie, praktycznie (np. koszt interwencji a korzyść) albo empirycznie. Anvari i Lakens (2021) pokazali metodę zakotwiczoną: pytając uczestników o globalną ocenę zmiany samopoczucia, wyznaczyli najmniejszą różnicę wyniku skali afektu, którą ludzie odczuwają jako zmianę. W badaniach klinicznych odpowiednikiem jest MCID.
Jeśli opierasz się na oczekiwanym efekcie, sprawdź, skąd pochodzi:
- Metaanaliza – najlepsze źródło, ale efekty z literatury bywają zawyżone przez efekt szuflady. Weź raczej dolną granicę przedziału ufności niż oszacowanie punktowe; jak czytać metaanalizę, opisujemy w poradniku metaanaliza krok po kroku.
- Pojedyncze wcześniejsze badanie – przy małej próbie i publikacji wyników istotnych efekt jest zwykle zawyżony. Button i in. (2013) pokazują, że niska moc zmniejsza nie tylko szansę wykrycia efektu, ale też prawdopodobieństwo, że wynik istotny odzwierciedla prawdziwy efekt, i prowadzi do zawyżonych oszacowań.
- Własny pilotaż – najbardziej kuszący i najbardziej zawodny (o tym w sekcji o pilotażu).
- Konwencje Cohena – d = 0.2, 0.5 i 0.8 jako efekt mały, średni i duży (Cohen, 1992). To ostatnia deska ratunku, a nie uzasadnienie; więcej o kontekstowej interpretacji efektów piszemy we wpisie wielkość efektu – interpretacja.
Brysbaert (2019) proponuje, by przy braku lepszych danych traktować d = 0.4 jako rozsądne pierwsze oszacowanie najmniejszego interesującego efektu w psychologii. Tego założenia używamy w przykładach.
Analiza mocy a priori: typowe plany badań
Analiza mocy a priori odpowiada na pytanie: ile osób potrzebuję, by przy danym α wykryć zakładany efekt z zakładaną mocą? W R wystarczy funkcja power.t.test() z pakietu stats; te same obliczenia wykonasz w programie G*Power (Faul i in., 2007), co opisujemy w haśle analiza mocy a priori w G*Power. Rysunek 1 pokazuje, jak moc testu t dla dwóch grup rośnie z liczebnością przy różnych wielkościach efektu.
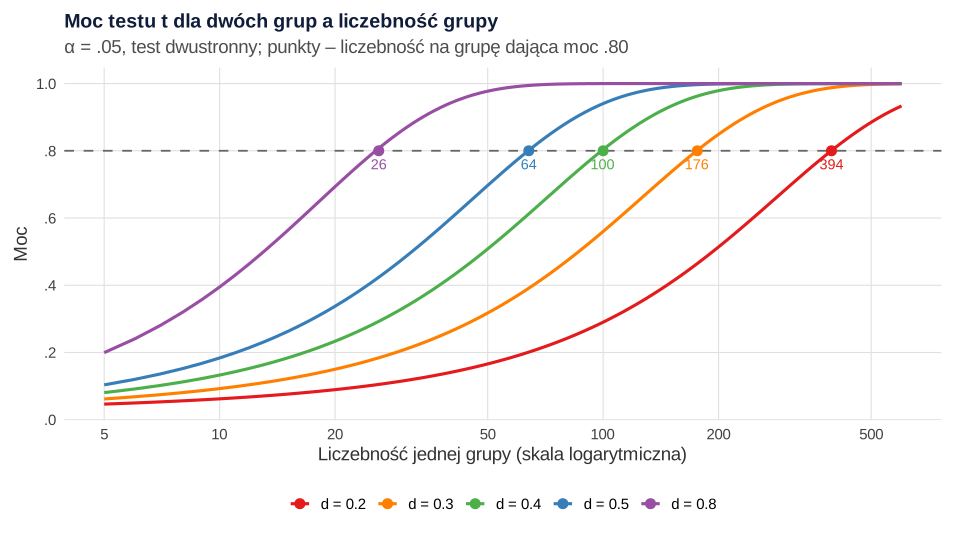
power.t.test).Kluczowa obserwacja: liczebność rośnie z kwadratem odwrotności efektu. Zmniejszenie zakładanego efektu o połowę – z d = 0.4 do 0.2 – oznacza prawie czterokrotnie większą próbę: 394 zamiast 100 osób na grupę. Dlatego wybór wielkości efektu ma większe znaczenie niż wybór między mocą .80 a .90.
| Plan i założenia | Moc .80 | Moc .90 |
|---|---|---|
| Dwie grupy, d = 0.4 (na grupę) | 100 | 133 |
| Dwie grupy, d = 0.3 (na grupę) | 176 | 235 |
| Dwie grupy, d = 0.5 (na grupę) | 64 | 86 |
| Ten sam efekt d = 0.4 mierzony dwa razy u tych samych osób, korelacja pomiarów .50 (dz = 0.40) | 52 osoby | – |
| Jak wyżej, korelacja pomiarów .70 (dz = 0.52) | 32 osoby | – |
| Korelacja r = .20 / .30 | 194 / 85 osób | – |
| Trzy grupy o średnich 0, 0.3 i 0.6 SD (f = 0.245), test F | 55 na grupę | – |
Kilka wniosków z tej tabeli:
- Plan wewnątrzobiektowy jest znacznie „tańszy”, bo efekt standaryzowany na różnicach, dz = d / √(2(1 − r)), rośnie z korelacją pomiarów. Przy korelacji .30 trzeba jednak 71 osób, a przy .70 – 32. Załóż realistyczną korelację, najlepiej z wcześniejszych danych z tym samym narzędziem.
- Korelacje wymagają dużych prób. Do wykrycia r = .10 z mocą .80 potrzeba 783 osób – to częsta skala efektów w badaniach kwestionariuszowych.
- ANOVA dla trzech grup wykrywa „jakąkolwiek różnicę”. Jeśli hipoteza dotyczy konkretnych porównań, licz moc dla tych porównań, a nie dla testu omnibusowego.
- Interakcje są osobną kategorią. Sommet i in. (2023) przeanalizowali 159 badań i stwierdzili, że mediana mocy wykrycia interakcji typowej wielkości wynosiła tylko .18. Liczebność dla interakcji zależy od jej kształtu i bywa wielokrotnie większa niż dla efektu głównego; Perugini i in. (2018) pokazują, jak liczyć moc dla prostych planów eksperymentalnych, także z moderacją i mediacją. Jeśli testujesz moderację, zajrzyj też do poradnika analiza moderacji krok po kroku.
Korekty i odpływ
Jeśli planujesz trzy porównania parami z korektą Bonferroniego (α = .05/3), liczebność dla d = 0.4 rośnie ze 100 do 133 osób na grupę. Przy przewidywanym odpływie 15% osób do rekrutacji potrzebujesz 157 osób na grupę (133 / 0.85, w górę). Odpływ szacuj z podobnych badań; w badaniach podłużnych bywa znacznie większy niż 15%.
SESOI i test równoważności: gdy chcesz pokazać, że efektu brak
Klasyczna analiza mocy zakłada, że chcesz wykryć efekt. Czasem cel jest odwrotny: pokazać, że nowa, tańsza forma interwencji nie jest gorsza albo że dwie wersje kwestionariusza dają praktycznie takie same wyniki. Nieistotny wynik testu t tego nie dowodzi. Lakens (2017) pokazuje, że do tego służy test równoważności (TOST), w którym granice równoważności wyznacza się z SESOI – i to przed zebraniem danych.
Taki test też trzeba zaplanować. Przy granicach ±0.3 SD, prawdziwej różnicy równej zero, α = .05 i mocy .80 przybliżenie daje 191 osób na grupę. Symulacja 5000 badań z testem t potwierdziła moc .798. Wykazanie braku efektu wymaga więc większej próby niż wykrycie efektu tej samej wielkości (176 osób na grupę dla d = 0.3 przy mocy .80). Jak interpretować wyniki nieistotne i kiedy sięgać po TOST, omawiamy we wpisie hipoteza się nie potwierdziła.
Planowanie precyzji: jak szeroki będzie przedział ufności
Nie każde badanie testuje hipotezę zerową. Jeśli chcesz oszacować korelację między dwiema cechami albo wielkość efektu interwencji, pytanie brzmi: jak dokładne będzie to oszacowanie? Lakens (2022) nazywa to planowaniem dokładności (ang. accuracy in parameter estimation, AIPE). Zamiast mocy wybierasz pożądaną szerokość przedziału ufności.
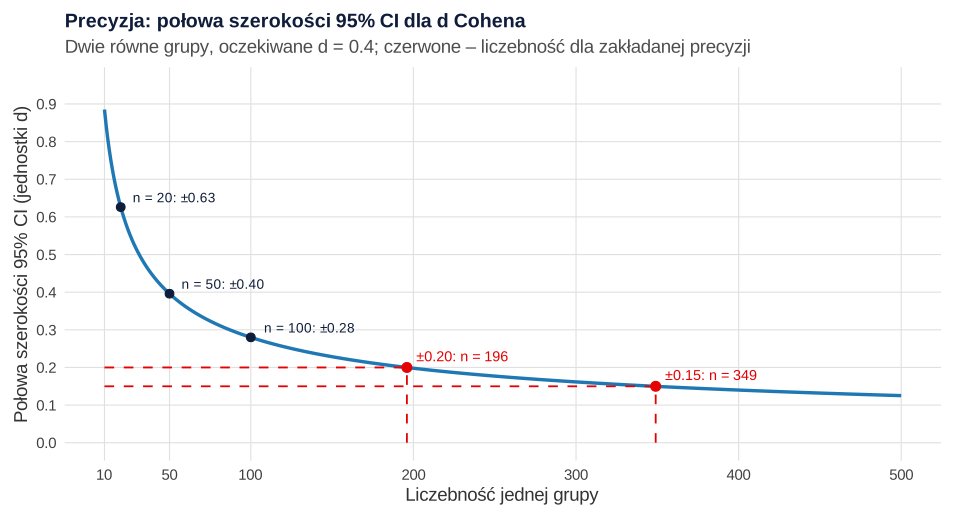
Wynik bywa otrzeźwiający. Przy 20 osobach na grupę 95% CI dla d ma połowę szerokości ±0.63 – obejmuje więc zarówno efekty bliskie zeru, jak i bardzo duże. Przy 100 osobach na grupę, czyli liczebności „wystarczającej” do mocy .80 dla d = 0.4, połowa szerokości wynosi ±0.28. Oszacowanie efektu z dokładnością ±0.20 wymaga 196 osób na grupę, a z dokładnością ±0.15 – 349 osób. Badanie wystarczające do wykrycia efektu zwykle nie wystarcza do jego precyzyjnego oszacowania.
Podobnie z korelacją. Przy oczekiwanym r = .30 i 50 osobach 95% CI wynosi od .02 do .53 – od efektu praktycznie zerowego do dużego. Przy 100 osobach od .11 do .47, przy 200 od .17 do .42, a przy 400 od .21 do .39. Szerokość przedziału maleje z pierwiastkiem z n, więc dwukrotne zawężenie wymaga mniej więcej czterokrotnie większej próby.
Pewność, a nie tylko oczekiwana szerokość
Wzór na „oczekiwaną” szerokość przedziału ma pułapkę: szerokość zależy od odchylenia standardowego w próbie, a to jest losowe. Załóżmy, że chcesz oszacować różnicę średnich na skali lęku (SD = 10) z połową szerokości 95% CI najwyżej 3 punkty. Wzór daje 87 osób na grupę, ale symulacja pokazuje, że przy tej liczebności cel osiągasz tylko w 52.9% badań. Żeby osiągnąć go z prawdopodobieństwem .90 (tzw. assurance), potrzeba 98 osób na grupę.
Analiza wrażliwości: gdy liczebność jest z góry ustalona
Często liczebność wynika z ograniczeń: masz dostęp do 120 studentów z dwóch roczników albo do wszystkich pacjentów oddziału w ciągu roku. Wtedy obliczanie „potrzebnego n” jest fikcją. Uczciwa alternatywa to analiza wrażliwości: jaki efekt badanie o tej liczebności wykryje z akceptowalną mocą?
Przy 60 osobach na grupę test t (α = .05, dwustronny) wykrywa z mocą .80 efekt d = 0.52, z mocą .90 – d = 0.60, a z mocą .95 – d = 0.66. Odwrotnie: dla efektu d = 0.3 moc wynosi tylko .37, a dla d = 0.4 – .58. Jeśli wcześniejsze badania sugerują efekty rzędu 0.3–0.4, to badanie 2 × 60 osób z dużym prawdopodobieństwem da wynik nieistotny, nawet gdy efekt istnieje. Taką informację lepiej mieć przed rozpoczęciem badania niż w odpowiedzi recenzenta – i lepiej ją opisać, niż przemilczeć. Takie zarzuty i odpowiedzi na nie omawiamy we wpisie zarzuty recenzentów do statystyki.
Dlaczego nie planować próby na podstawie pilotażu
Badanie pilotażowe jest bardzo przydatne – do sprawdzenia procedury, czasu trwania, zrozumiałości instrukcji i rekrutacji. Leon i in. (2011) podkreślają, że jego rolą jest ocena wykonalności, a nie testowanie hipotez, i że z powodu małej próby nie daje ono sensownego oszacowania wielkości efektu do planowania kolejnego badania. Albers i Lakens (2018) opisują dodatkowe zjawisko – follow-up bias: badacz kontynuuje projekt tylko po „obiecującym” pilotażu, więc liczebność badania głównego jest systematycznie zbyt mała.
Symulacja pokazuje skalę problemu. Prawdziwy efekt wynosi d = 0.4, a pilotaż obejmuje 15 osób w każdej grupie. W 10 000 symulowanych pilotaży połowa oszacowań d mieściła się między 0.15 a 0.67, a co dziesiąty pilotaż dał d poniżej −0.07 – czyli efekt w przeciwnym kierunku. 29.0% pilotaży dało d < 0.2, co w praktyce często kończy projekt, a 30.7% – d > 0.6, co prowadzi do zbyt małej próby. Jeśli badacz kontynuował tylko po pilotażu z d ≥ 0.2 (71.0% przypadków) i planował próbę z mocą .80 dla efektu z pilotażu, mediana liczebności wyniosła 54 osoby na grupę, a mediana rzeczywistej mocy – zaledwie .54. W 46.0% kontynuowanych projektów rzeczywista moc była niższa niż .50 (rysunek 3).
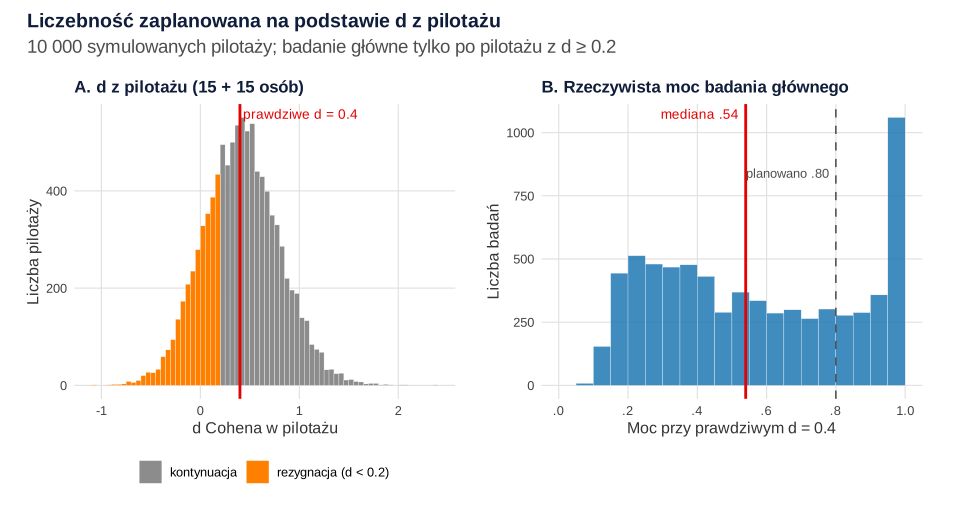
Wniosek praktyczny: z pilotażu bierz informacje o procedurze, odpływie i ewentualnie o rozproszeniu wyników, a wielkość efektu ustal na podstawie SESOI albo literatury. Więcej o celach pilotażu piszemy w poradniku badanie pilotażowe – po co, ile osób, co sprawdzić.
Moc post hoc to nie uzasadnienie liczebności
Po badaniu z wynikiem nieistotnym kusi, by policzyć moc z zaobserwowanego efektu i napisać „moc wyniosła .25, więc próba była za mała”. Hoenig i Heisey (2001) pokazali, że to podejście jest z gruntu wadliwe: moc obliczona z obserwowanego efektu jest prostą funkcją wartości p i nie dodaje żadnej nowej informacji. W teście dwustronnym wynik z p = .05 zawsze daje „moc obserwowaną” około .50, wynik z p = .20 – .25, a z p = .50 – .10. Zamiast tego podaj przedział ufności dla efektu i analizę wrażliwości: jaki efekt badanie mogło wykryć przy swojej liczebności.
Reguły kciuka i ich ograniczenia
Reguły typu „30 osób na grupę”, „10 osób na każdą zmienną w regresji” czy „co najmniej 100 osób do analizy czynnikowej” krążą w podręcznikach i na seminariach. Lakens (2022) traktuje heurystyki jako najsłabszą formę uzasadnienia – mogą być punktem wyjścia, ale nie mówią nic o tym, jaki efekt badanie wykryje. Konkretnie:
- „30 na grupę” daje moc .80 tylko dla efektów rzędu d = 0.74. Dla d = 0.4 potrzeba ponad trzy razy więcej osób. Ta liczba nie wynika z rachunku mocy – częściej przywołuje się ją przy rozkładzie średniej, a i tam jest tylko przybliżeniem (zob. centralne twierdzenie graniczne).
- Tabele Cohena (Cohen, 1992) są poprawne, ale dla efektów „konwencjonalnych”. Brysbaert (2019) zwraca uwagę, że przy realistycznych efektach w psychologii porównanie warunków wewnątrzobiektowych wymaga ponad 50 osób, a porównanie grup lub interakcja – 100, 200 i więcej.
- Reguły „osób na zmienną” w regresji ignorują wielkość efektu, korelacje predyktorów i cel analizy (test pojedynczego współczynnika czy predykcja).
- Dane pogrupowane (klasy, zespoły, gabinety) wymagają przemnożenia liczebności przez efekt schematu – 300 osób z 20 klas może nieść tyle informacji co kilkadziesiąt niezależnych.
- Badania sondażowe często planuje się przez margines błędu dla odsetka, co jest wariantem planowania precyzji, ale ma sens tylko przy losowym doborze próby.
Jak opisać uzasadnienie liczebności w artykule lub wniosku grantowym
Dobry opis pozwala czytelnikowi odtworzyć obliczenie. Podaj: test, α (i korektę), moc, wielkość efektu i jej źródło, wynikową liczebność, uwzględniony odpływ i program lub funkcję. Jeśli liczebność była ograniczona, podaj analizę wrażliwości. Taki opis powinien znaleźć się także w prerejestracji – zob. plan analizy statystycznej i prerejestracja.
Jeśli przygotowujesz wniosek grantowy lub protokół i chcesz, żeby ktoś sprawdził założenia analizy mocy albo przeprowadził symulację dla bardziej złożonego planu (interakcja, model wielopoziomowy, wiele wyników), zajrzyj do oferty analiz statystycznych dla badaczy.
Obliczenia w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Potrzebna jest wyłącznie podstawowa instalacja R (funkcje power.t.test, power.anova.test, uniroot). Przepisy są niezależne; symulacje mają ustalone ziarno losowania.
1. Analiza mocy a priori dla typowych planów
R
# Analiza mocy a priori dla typowych planów badań w psychologii (α = .05, test dwustronny, moc .80 i .90)
options(width = 110)

# 1. Dwie niezależne grupy (test t): liczebność na grupę dla różnych d
d <- c(0.2, 0.3, 0.4, 0.5, 0.8)
n_grupa <- sapply(d, function(x) c(moc_80 = ceiling(power.t.test(delta = x, power = .80)$n),
                                   moc_90 = ceiling(power.t.test(delta = x, power = .90)$n)))
colnames(n_grupa) <- paste("d =", d)
n_grupa

# 2. Ten sam efekt w planie wewnątrzosobowym (dwa pomiary tych samych osób):
#    d_z = d / √(2(1 − r)), gdzie r – korelacja między pomiarami
d_z <- function(d, r) d / sqrt(2 * (1 - r))
wewn <- sapply(c(0.3, 0.5, 0.7), function(r) c(d_z = round(d_z(0.4, r), 3),
       n_osob = ceiling(power.t.test(delta = d_z(0.4, r), power = .80, type = "paired")$n)))
colnames(wewn) <- paste0("r_", c(.3, .5, .7)); wewn

# 3. Korelacja: przybliżenie przez transformację z Fishera
n_korelacja <- function(r, moc = .80, alfa = .05)
  ceiling(((qnorm(1 - alfa / 2) + qnorm(moc)) / atanh(r))^2 + 3)
setNames(sapply(c(.10, .20, .30, .50), n_korelacja), paste0("r_", c(.10, .20, .30, .50)))

# 4. Jednoczynnikowa ANOVA, trzy grupy o średnich 0, 0.3 i 0.6 SD (f Cohena = 0.245)
srednie <- c(0, 0.3, 0.6)
f <- sqrt(mean((srednie - mean(srednie))^2)); round(f, 3)
ceiling(power.anova.test(groups = 3, between.var = var(srednie), within.var = 1, power = .80)$n)

# 5. Korekta Bonferroniego dla trzech porównań parami (α = .05/3) i przewidywany odpływ 15% osób
n_bonf <- ceiling(power.t.test(delta = 0.4, sig.level = .05 / 3, power = .80)$n)
c(n_bez_korekty = ceiling(power.t.test(delta = 0.4, power = .80)$n), n_bonferroni = n_bonf,
  do_rekrutacji_15proc_odplywu = ceiling(n_bonf / 0.85))

# 6. Test równoważności (TOST) dla dwóch grup: granice ±0.3 SD, prawdziwa różnica 0, moc .80
#    przybliżenie normalne i sprawdzenie symulacją z testem t
n_tost <- ceiling(2 * (qnorm(.95) + qnorm(1 - .20 / 2))^2 / 0.3^2); n_tost
set.seed(1616)
moc_tost <- mean(replicate(5000, {
  a <- rnorm(n_tost); b <- rnorm(n_tost); r <- mean(a) - mean(b)
  se <- sqrt(var(a) / n_tost + var(b) / n_tost); df <- 2 * n_tost - 2
  pt((r + 0.3) / se, df, lower.tail = FALSE) < .05 & pt((r - 0.3) / se, df) < .05
}))
round(moc_tost, 3)
Wynik w R
       d = 0.2 d = 0.3 d = 0.4 d = 0.5 d = 0.8
moc_80     394     176     100      64      26
moc_90     527     235     133      86      34
        r_0.3 r_0.5  r_0.7
d_z     0.338   0.4  0.516
n_osob 71.000  52.0 32.000
r_0.1 r_0.2 r_0.3 r_0.5
  783   194    85    30
[1] 0.245
[1] 55
               n_bez_korekty                 n_bonferroni do_rekrutacji_15proc_odplywu
                         100                          133                          157
[1] 191
[1] 0.798
2. Planowanie precyzji i pewność osiągnięcia celu
R
# Planowanie precyzji (AIPE): jak szeroki będzie 95% przedział ufności przy danej liczebności?
options(width = 110)

# 1. Połowa szerokości 95% CI dla d Cohena (dwie równe grupy), przybliżenie SE(d) = √(2/n + d²/(4n))
pol_szer_d <- function(n, d = 0.4) qnorm(.975) * sqrt(2 / n + d^2 / (4 * n))
n_lista <- c(20, 50, 100, 200, 400)
round(setNames(sapply(n_lista, pol_szer_d), paste("n =", n_lista)), 3)
# ile osób na grupę, żeby połowa szerokości CI dla d wynosiła najwyżej 0.20 lub 0.15?
sapply(c(0.20, 0.15), function(cel) uniroot(function(n) pol_szer_d(n) - cel, c(5, 5000))$root) |> ceiling()

# 2. Ta sama logika dla korelacji r = .30 (przedział z transformacji Fishera)
ci_r <- function(r, n) tanh(atanh(r) + c(-1, 1) * qnorm(.975) / sqrt(n - 3))
t(sapply(c(50, 100, 200, 400), function(n) round(c(n = n, dolna = ci_r(.30, n)[1], gorna = ci_r(.30, n)[2],
                                                    szerokosc = diff(ci_r(.30, n))), 3)))

# 3. Pewność (assurance): różnica średnich w punktach skali lęku (SD = 10), cel: połowa szerokości CI ≤ 3 pkt.
#    Wzór na „oczekiwaną” szerokość daje n, przy którym cel osiągniesz tylko w około połowie badań.
set.seed(1617)
pewnosc <- function(n, cel = 3, sd = 10, R = 10000) {
  s_p <- sqrt((rchisq(R, n - 1) * sd^2 / (n - 1) + rchisq(R, n - 1) * sd^2 / (n - 1)) / 2)  # wylosowane SD łączne
  mean(qt(.975, 2 * n - 2) * s_p * sqrt(2 / n) <= cel)
}
n_oczek <- ceiling(uniroot(function(n) qt(.975, 2 * n - 2) * 10 * sqrt(2 / n) - 3, c(5, 5000))$root)
n_90 <- n_oczek; while (pewnosc(n_90) < .90) n_90 <- n_90 + 1
c(n_na_grupe_oczekiwana_szerokosc = n_oczek, pewnosc_przy_tym_n = round(pewnosc(n_oczek), 3),
  n_na_grupe_pewnosc_90 = n_90)
Wynik w R
 n = 20  n = 50 n = 100 n = 200 n = 400
  0.626   0.396   0.280   0.198   0.140
[1] 196 349
       n dolna gorna szerokosc
[1,]  50 0.024 0.534     0.510
[2,] 100 0.110 0.469     0.359
[3,] 200 0.168 0.421     0.253
[4,] 400 0.208 0.387     0.179
n_na_grupe_oczekiwana_szerokosc              pewnosc_przy_tym_n           n_na_grupe_pewnosc_90
                         87.000                           0.529                          98.000
3. Analiza wrażliwości, pilotaż i „moc post hoc”
R
# Analiza wrażliwości (jaki efekt wykryje badanie o danej liczebności), pułapka badania pilotażowego
# i dlaczego „moc post hoc” nic nie dodaje do wartości p
options(width = 110)

# 1. Analiza wrażliwości: dostępnych jest 120 osób (60 na grupę)
sapply(c(.80, .90, .95), function(m) round(power.t.test(n = 60, power = m)$delta, 3)) |>
  setNames(c("moc_80", "moc_90", "moc_95"))
round(sapply(c(0.2, 0.3, 0.4, 0.5), function(x) power.t.test(n = 60, delta = x)$power), 3) |>
  setNames(paste("d =", c(0.2, 0.3, 0.4, 0.5)))
# reguła „30 osób na grupę”: jaki efekt wykrywa z mocą .80?
round(power.t.test(n = 30, power = .80)$delta, 3)

# 2. Pilotaż jako źródło wielkości efektu: prawdziwe d = 0.4, pilotaż po 15 osób w grupie
set.seed(1618)
d_pilot <- replicate(10000, { a <- rnorm(15, 0.4); b <- rnorm(15)
  (mean(a) - mean(b)) / sqrt((var(a) + var(b)) / 2) })
round(quantile(d_pilot, c(.10, .25, .50, .75, .90)), 2)
round(c(proc_d_ponizej_0.2 = 100 * mean(d_pilot < 0.2), proc_d_ponad_0.6 = 100 * mean(d_pilot > 0.6)), 1)

# Badacz kontynuuje tylko wtedy, gdy pilotaż dał d ≥ 0.2, i planuje n z mocą .80 dla d z pilotażu
kontynuacja <- d_pilot[d_pilot >= 0.2]
n_plan <- sapply(kontynuacja, function(x) ceiling(power.t.test(delta = x, power = .80)$n))
moc_rzeczywista <- sapply(n_plan, function(n) power.t.test(n = n, delta = 0.4)$power)
round(c(proc_kontynuacji = 100 * length(kontynuacja) / length(d_pilot), mediana_n = median(n_plan),
        mediana_mocy = median(moc_rzeczywista), proc_moc_ponizej_50 = 100 * mean(moc_rzeczywista < .50)), 2)

# 3. „Moc post hoc” (obliczona z obserwowanego efektu) jest prostą funkcją wartości p (test z, dwustronny)
moc_obserwowana <- function(p) { z <- qnorm(1 - p / 2)
  pnorm(z - qnorm(.975)) + pnorm(-z - qnorm(.975)) }
round(sapply(c(.01, .05, .20, .50), moc_obserwowana), 3) |> setNames(paste("p", sub("^0", "", c(.01, .05, .20, .50))))
Wynik w R
moc_80 moc_90 moc_95
 0.516  0.597  0.664
d = 0.2 d = 0.3 d = 0.4 d = 0.5
  0.191   0.371   0.584   0.775
[1] 0.736
  10%   25%   50%   75%   90%
-0.07  0.15  0.41  0.67  0.91
proc_d_ponizej_0.2   proc_d_ponad_0.6
              29.0               30.7
   proc_kontynuacji           mediana_n        mediana_mocy proc_moc_ponizej_50
              71.02               54.00                0.54               45.96
p .01 p .05  p .2  p .5
0.731 0.500 0.249 0.104
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy przy doborze liczebności
- Wielkość efektu „z sufitu” albo dobrana tak, by wyszło wykonalne n. Recenzent zapyta o źródło; podaj SESOI lub metaanalizę, a gdy liczebność jest ograniczona – analizę wrażliwości zamiast udawanej analizy a priori.
- Analiza mocy dla innego testu niż planowany. Moc ANOVA omnibusowej nie jest mocą porównań parami, a moc efektu głównego – mocą interakcji.
- Efekt z pilotażu lub z jednego małego badania. Takie oszacowania są niestabilne i – po selekcji „obiecujących” wyników – zawyżone.
- Pominięcie korekt, odpływu i wykluczeń. Liczebność do analizy to nie liczebność do rekrutacji.
- Moc post hoc w dyskusji. Nie dodaje informacji ponad wartość p; zastąp ją przedziałem ufności i analizą wrażliwości.
- Mylenie mocy z precyzją. Próba wystarczająca do wykrycia efektu daje zwykle szeroki przedział ufności dla jego wielkości.
- Traktowanie dużej próby z naboru internetowego jak dużej próby losowej. Liczebność nie naprawia błędu doboru; więcej o tym w haśle reprezentatywność próby.
Najczęstsze pytania
Jak uzasadnić liczebność próby w artykule naukowym?
Podaj, jakie podejście zastosowano (analiza mocy a priori, planowana precyzja, ograniczenie zasobów), a przy analizie mocy – test, poziom α z ewentualną korektą, moc, wielkość efektu z jej źródłem, wynikową liczebność, uwzględniony odpływ i program lub funkcję. Jeśli liczebność była z góry ograniczona, napisz to wprost i dodaj analizę wrażliwości: jaki efekt badanie mogło wykryć z mocą .80 lub .90.
Co zrobić, gdy nie mogę zebrać próby wynikającej z analizy mocy?
Opisz ograniczenie i wykonaj analizę wrażliwości – policz, jaki najmniejszy efekt wykryje badanie o dostępnej liczebności. Rozważ zwiększenie mocy bez zwiększania próby: plan wewnątrzobiektowy, rzetelniejszy pomiar, kowariant mierzony przed interwencją albo jedną hipotezę główną zamiast wielu. W raporcie interpretuj wyniki przez przedziały ufności, a nie samą istotność.
Czy można oprzeć analizę mocy na wyniku badania pilotażowego?
Raczej nie. Przy kilkunastu osobach w grupie oszacowanie wielkości efektu jest bardzo nieprecyzyjne, a kontynuowanie projektu tylko po „obiecującym” pilotażu sprawia, że badanie główne ma zwykle za małą moc – w symulacji przy prawdziwym d = 0.4 mediana rzeczywistej mocy wyniosła .54 zamiast planowanych .80. Pilotaż służy do sprawdzenia procedury i wykonalności.
Czym różni się planowanie mocy od planowania precyzji?
Analiza mocy odpowiada na pytanie, ile osób trzeba, by z określonym prawdopodobieństwem uzyskać wynik istotny, jeśli efekt ma założoną wielkość. Planowanie precyzji odpowiada na pytanie, ile osób trzeba, by przedział ufności dla efektu był wystarczająco wąski. Precyzja zwykle wymaga większej próby: przy d = 0.4 moc .80 daje 100 osób na grupę, a 95% CI o połowie szerokości ±0.20 – 196 osób.
Ile osób potrzeba do testu równoważności TOST?
Więcej niż do wykrycia efektu tej samej wielkości. Przy granicach równoważności ±0.3 SD, prawdziwej różnicy równej zero, α = .05 i mocy .80 potrzeba 191 osób na grupę (symulacja potwierdziła moc .798). Granice ustal przed badaniem na podstawie najmniejszego interesującego efektu.
Powiązane hasła
Przeczytaj też
Analiza mocy w jamovi (jpower)
Moduł jpower: N, moc albo najmniejszy efekt dla testu t, tabele i wykresy mocy, δ w próbach zależnych i czego moduł nie liczy – z kontrolą w R.
Czytaj →PoradnikLiczebność próby w eksperymencie ankietowym
Ile osób na warunek przy małych efektach, ile daje kowariata przed bodźcem i plan wewnątrzosobowy, ile kosztują dodatkowe warunki i ubytek.
Czytaj →PoradnikMoc testu i liczebność próby – zadania
Dziesięć zadań: liczebność dla testu t, proporcji i korelacji, moc przy danym n, minimalny efekt, ubytek, efekt schematu, α i moc po fakcie.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikBadanie pilotażowe: po co, ile osób, co sprawdzić
Pilotaż a pretest, ile osób zbadać, co sprawdzić w danych i dlaczego nie liczyć mocy z efektu z pilotażu. Z symulacją, kodem R i wzorem opisu.
Czytaj →Planujesz badanie i musisz uzasadnić liczebność próby?
Policzymy moc lub precyzję dla Twojego planu – także symulacyjnie dla interakcji i modeli wielopoziomowych – i przygotujemy opis, który da się obronić przed recenzentem i panelem grantowym.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Albers, C., & Lakens, D. (2018). When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias. Journal of Experimental Social Psychology, 74, 187–195. https://doi.org/10.1016/j.jesp.2017.09.004 ● Otwarty dostęp
- Anvari, F., & Lakens, D. (2021). Using anchor-based methods to determine the smallest effect size of interest. Journal of Experimental Social Psychology, 96, Article 104159. https://doi.org/10.1016/j.jesp.2021.104159 ● Otwarty dostęp
- Brysbaert, M. (2019). How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables. Journal of Cognition, 2(1), Article 16. https://doi.org/10.5334/joc.72 ● Otwarty dostęp
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475 ● Otwarty dostęp
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146 ● Otwarty dostęp
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Lakens, D. (2017). Equivalence tests: A practical primer for t tests, correlations, and meta-analyses. Social Psychological and Personality Science, 8(4), 355–362. https://doi.org/10.1177/1948550617697177 ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Leon, A. C., Davis, L. L., & Kraemer, H. C. (2011). The role and interpretation of pilot studies in clinical research. Journal of Psychiatric Research, 45(5), 626–629. https://doi.org/10.1016/j.jpsychires.2010.10.008 ● Otwarty dostęp
- Perugini, M., Gallucci, M., & Costantini, G. (2018). A practical primer to power analysis for simple experimental designs. International Review of Social Psychology, 31(1), Article 20. https://doi.org/10.5334/irsp.181 ● Otwarty dostęp
- Sommet, N., Weissman, D. L., Cheutin, N., & Elliot, A. J. (2023). How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction. Advances in Methods and Practices in Psychological Science, 6(3), Article 25152459231178728. https://doi.org/10.1177/25152459231178728 ● Otwarty dostęp
Cytowania BibTeX
@article{albers2018power, author={Albers, Casper and Lakens, Daniël}, title={{When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={74}, pages={187--195}, doi={10.1016/j.jesp.2017.09.004}}@article{anvari2021using, author={Anvari, Farid and Lakens, Daniël}, title={{Using anchor-based methods to determine the smallest effect size of interest}}, journal={Journal of Experimental Social Psychology}, year={2021}, volume={96}, eid={104159}, doi={10.1016/j.jesp.2021.104159}}@article{brysbaert2019how, author={Brysbaert, Marc}, title={{How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables}}, journal={Journal of Cognition}, year={2019}, volume={2}, number={1}, eid={16}, doi={10.5334/joc.72}}@article{button2013power, author={Button, Katherine S. and Ioannidis, John P. A. and Mokrysz, Claire and Nosek, Brian A. and Flint, Jonathan and Robinson, Emma S. J. and Munafò, Marcus R.}, title={{Power failure: Why small sample size undermines the reliability of neuroscience}}, journal={Nature Reviews Neuroscience}, year={2013}, volume={14}, number={5}, pages={365--376}, doi={10.1038/nrn3475}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{faul2007gpower, author={Faul, Franz and Erdfelder, Edgar and Lang, Albert-Georg and Buchner, Axel}, title={{G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences}}, journal={Behavior Research Methods}, year={2007}, volume={39}, number={2}, pages={175--191}, doi={10.3758/bf03193146}}@article{hoenig2001abuse, author={Hoenig, John M. and Heisey, Dennis M.}, title={{The abuse of power: The pervasive fallacy of power calculations for data analysis}}, journal={The American Statistician}, year={2001}, volume={55}, number={1}, pages={19--24}, doi={10.1198/000313001300339897}}@article{lakens2017equivalence, author={Lakens, Daniël}, title={{Equivalence tests: A practical primer for t tests, correlations, and meta-analyses}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={355--362}, doi={10.1177/1948550617697177}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{leon2011role, author={Leon, Andrew C. and Davis, Lori L. and Kraemer, Helena C.}, title={{The role and interpretation of pilot studies in clinical research}}, journal={Journal of Psychiatric Research}, year={2011}, volume={45}, number={5}, pages={626--629}, doi={10.1016/j.jpsychires.2010.10.008}}@article{perugini2018practical, author={Perugini, Marco and Gallucci, Marcello and Costantini, Giulio}, title={{A practical primer to power analysis for simple experimental designs}}, journal={International Review of Social Psychology}, year={2018}, volume={31}, number={1}, eid={20}, doi={10.5334/irsp.181}}@article{sommet2023how, author={Sommet, Nicolas and Weissman, David L. and Cheutin, Nicolas and Elliot, Andrew J.}, title={{How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction}}, journal={Advances in Methods and Practices in Psychological Science}, year={2023}, volume={6}, number={3}, eid={25152459231178728}, doi={10.1177/25152459231178728}}