Wzór przedstawienia charakterystyki próby: jak korzystać z tej strony
Ta strona zawiera gotowe wzory: tabele w stylu APA 7 i akapity do podrozdziału „Uczestnicy” dla czterech typowych badań. Wybierz wzór najbliższy Twojemu schematowi, skopiuj tabelę przyciskiem „Kopiuj tabelę do Worda” albo pobierz wszystkie cztery tabele w pliku wzor-przedstawienia-charakterystyki-proby-tabele.docx, a potem zastąp liczby własnymi wynikami.
Liczby we wzorach pochodzą z danych symulowanych i kodu w sekcji Przykład w R. Uzasadnienie decyzji – które cechy opisać, kiedy średnia, a kiedy mediana, jak tworzyć przedziały wieku i jak porównać próbę z populacją – znajdziesz we wpisie jak opisać charakterystykę próby badawczej. Tutaj skupiamy się na formie.
| Twoje badanie | Wzór | Kolumny tabeli | Porównanie grup |
|---|---|---|---|
| Ankieta w jednej grupie (badanie korelacyjne) | Wzór 1 | jedna kolumna z wartościami | nie dotyczy |
| Dwie grupy dobrane osobno (np. kliniczna i kontrolna) | Wzór 2 | kolumna dla każdej grupy i SMD | standaryzowane różnice |
| Eksperyment z losowym przydziałem | Wzór 3 | kolumna dla każdego warunku i ogółem | bez testów istotności |
| Badanie z dwoma pomiarami | Wzór 4 | osoby z obu pomiarów i osoby, które odpadły | SMD i testy dla odpadania |
Trzy zasady formy obowiązują we wszystkich wzorach. Pierwsza: tabela ma numer i tytuł kursywą nad tabelą, tylko poziome linie i notę „Uwaga.” pod spodem – tak wygląda tabela w stylu APA 7 (zob. styl APA i wpis o tabelach APA w pracy z psychologii). Druga: w jednej kolumnie łącz wartości w formacie „n (%)” dla zmiennych kategorialnych i „M (SD)” dla ilościowych, a format zaznacz w nazwie wiersza. Trzecia: liczby zapisuj z kropką dziesiętną i jednym miejscem po przecinku dla procentów oraz dwoma dla średnich i odchyleń. Hayes-Larson i in. (2019) proponują podstawową strukturę takiej tabeli i jej modyfikacje dla bardziej złożonych schematów. Wzory poniżej podążają za tą logiką w uproszczonej formie, odpowiedniej dla pracy dyplomowej.
Wzór 1. Ankieta w jednej grupie
Najczęstszy przypadek: badanie korelacyjne online, jedna próba, kilka cech socjodemograficznych. Wiek w przykładzie jest prawostronnie skośny, dlatego tabela podaje zarówno średnią z odchyleniem standardowym, jak i medianę z kwartylami. Przy rozkładzie symetrycznym wiersz z medianą możesz usunąć.
Tabela 1
Charakterystyka socjodemograficzna uczestników badania (N = 402)
| Cecha | n (%) lub M (SD) |
|---|---|
| Wiek w latach, M (SD) | 35.88 (11.20) |
| Wiek w latach, Mdn [Q1, Q3] | 34 [27, 42] |
| Wiek w latach, zakres | 20–67 |
| Płeć | |
| kobieta | 221 (55.0) |
| mężczyzna | 167 (41.5) |
| inna | 8 (2.0) |
| wolę nie odpowiadać | 6 (1.5) |
| Wykształcenie | |
| podstawowe lub zasadnicze zawodowe | 48 (11.9) |
| średnie | 154 (38.3) |
| wyższe | 200 (49.8) |
| Miejsce zamieszkania | |
| wieś | 124 (30.8) |
| miasto do 100 tys. | 137 (34.1) |
| miasto powyżej 100 tys. | 141 (35.1) |
| Sytuacja zawodowa | |
| pracuje | 235 (58.5) |
| uczy się lub studiuje | 87 (21.6) |
| nie pracuje | 45 (11.2) |
| emerytura lub renta | 35 (8.7) |
Uwaga. Procenty obliczono od liczebności całej próby. Q1 i Q3 – pierwszy i trzeci kwartyl. Dane symulowane.
Akapit do podrozdziału „Uczestnicy” nie powtarza całej tabeli. Podaje liczebność, wiek i płeć oraz odsyła do tabeli po resztę:
Jeżeli piszesz artykuł po angielsku, ten sam akapit w podrozdziale Participants może brzmieć tak:
Kategorie metryczki wpisuj w tej samej kolejności co w ankiecie albo w kolejności naturalnej (od najniższego wykształcenia, od najmniejszej miejscowości). Nie sortuj ich według liczebności. Sposób formułowania pytań o płeć i wiek opisuje hasło pytania o płeć i wiek w ankiecie. Hughes i in. (2022) proponują także inkluzywne kategorie dla wykształcenia, zatrudnienia i dochodu.
Wzór 2. Dwie grupy dobrane osobno
Gdy porównujesz grupy, których nie przydzielono losowo – np. osoby z rozpoznaniem zaburzeń lękowych i osoby bez rozpoznania – tabela ma pokazać, na ile grupy są porównywalne pod względem cech innych niż badana. Zamiast kolumny z wartościami p podaj standaryzowaną różnicę (SMD). Austin (2009) opisuje standaryzowane różnice jako miarę porównywania rozkładów cech między grupami, którą stosuje się zarówno do średnich, jak i do odsetków. W odróżnieniu od p nie zależy ona od liczebności grup. Wiersze dotyczące tylko jednej grupy (czas od diagnozy, leczenie) oznacz kreską w drugiej kolumnie.
Tabela 2
Charakterystyka grupy klinicznej i kontrolnej
| Cecha | Grupa kliniczna (n = 46) | Grupa kontrolna (n = 50) | SMD |
|---|---|---|---|
| Wiek w latach, M (SD) | 33.72 (8.32) | 32.94 (8.93) | 0.09 |
| Kobiety, n (%) | 32 (69.6) | 27 (54.0) | 0.32 |
| Lata nauki, M (SD) | 14.17 (2.51) | 15.36 (2.00) | −0.52 |
| Czas od diagnozy w latach, Mdn [Q1, Q3] | 4 [2, 7] | – | – |
| Przyjmowanie leków, n (%) | 27 (58.7) | – | – |
Uwaga. SMD – standaryzowana różnica (grupa kliniczna minus kontrolna); dla odsetka kobiet obliczona z proporcji. Kreska – nie dotyczy. Dane symulowane.
Odmiany wzoru 2. Jeśli grupę kontrolną dobierano parami do osób z grupy klinicznej (np. według płci i wieku z dokładnością do dwóch lat), napisz to wprost i podaj, według jakich cech dobierano pary. W takim schemacie podobieństwo grup w tych cechach wynika z doboru, a nie jest wynikiem badania. Gdy grup jest więcej niż dwie, dodaj kolejne kolumny, a SMD podaj dla każdej pary grup albo dla każdej grupy względem grupy odniesienia. W pracach z udziałem pacjentów dopisz wiersze o cechach klinicznych istotnych dla pytania: rozpoznanie według klasyfikacji, czas trwania, leczenie, choroby współistniejące. Każdy taki wiersz dotyczy tylko grupy klinicznej.
Ostatnie zdanie wzoru stosuj tylko wtedy, gdy decyzję o zmiennej kontrolnej podjęto z powodów merytorycznych i przed analizą, a nie dlatego, że różnica „wyszła”. Wartość d czy SMD wyjaśnia hasło standaryzowana różnica średnich, a analizę z kowariantem – hasło ANCOVA.
Wzór 3. Eksperyment z losowym przydziałem
W eksperymencie z losowym przydziałem tabela pokazuje warunki w osobnych kolumnach i kolumnę „Ogółem”. Nie dodawaj testów istotności różnic między warunkami. De Boer i in. (2015) wyjaśniają, że zgodnie z wytycznymi CONSORT testy różnic wyjściowych w badaniach z randomizacją są zbędne. Nie pokazują, czy losowanie się udało, a wybór zmiennych kontrolnych na ich podstawie może pominąć ważne zmienne. Wytyczne CONSORT 2010 (Schulz i in., 2010) zawierają też schemat przepływu uczestników, który przydaje się we wzorze 4.
Tabela 3
Charakterystyka uczestników w trzech warunkach eksperymentu
| Cecha | Kontrolny (n = 41) | Uważność (n = 40) | Relaksacja (n = 42) | Ogółem (N = 123) |
|---|---|---|---|---|
| Wiek w latach, M (SD) | 21.32 (1.71) | 21.30 (1.56) | 21.62 (1.59) | 21.41 (1.61) |
| Kobiety, n (%) | 28 (68.3) | 29 (72.5) | 29 (69.0) | 86 (69.9) |
| Nastrój przed manipulacją, M (SD) | 4.69 (1.07) | 4.36 (1.04) | 4.61 (1.11) | 4.56 (1.07) |
Uwaga. Uczestników przydzielono do warunków losowo, dlatego nie podano testów istotności różnic między warunkami. Dane symulowane.
Jeśli losowanie było blokowe lub warstwowe, dopisz to w zdaniu o przydziale. Nazwij też precyzyjnie, co robiła grupa kontrolna (np. „słuchała nagrania o neutralnej treści”), bo samo „grupa kontrolna” nie mówi czytelnikowi, z czym porównujesz warunki eksperymentalne. Więcej o schematach eksperymentalnych mówią hasła schemat eksperymentalny i randomizacja.
Wzór 4. Badanie z dwoma pomiarami i odpadaniem uczestników
W badaniu z kilkoma pomiarami opis próby składa się z trzech elementów: schematu przepływu uczestników, charakterystyki próby z pierwszego pomiaru i porównania osób, które zostały w badaniu, z tymi, które odpadły. Odpadanie rzadko jest losowe. Zhou i Fishbach (2016) pokazali, że w eksperymentach internetowych odsetek osób przerywających udział sięgał 30–50%, różnił się między warunkami i mógł prowadzić do fałszywych wniosków. Dlatego takie porównanie należy do standardu raportowania.
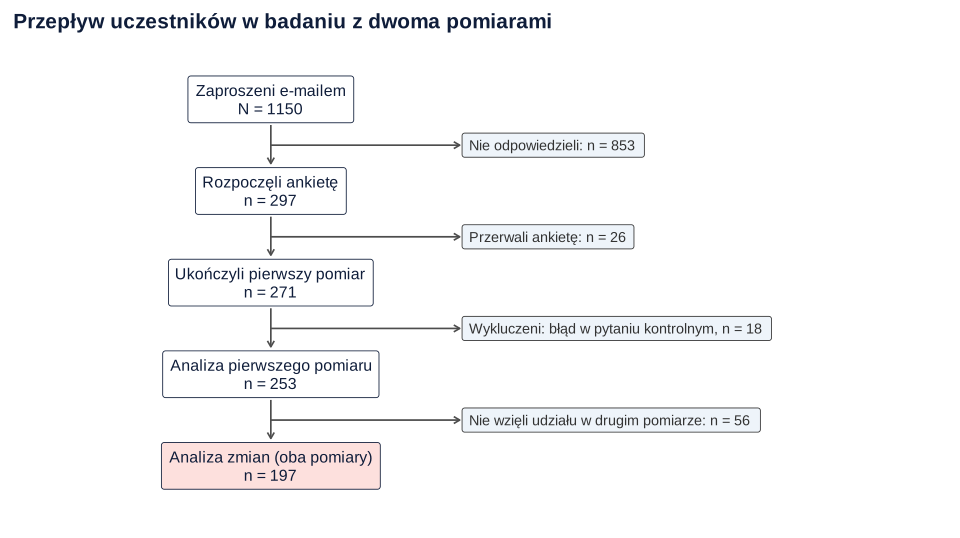
Tabela 4
Porównanie osób, które wzięły udział w obu pomiarach, z osobami, które zrezygnowały po pierwszym
| Cecha | Oba pomiary (n = 197) | Tylko pierwszy pomiar (n = 56) | SMD |
|---|---|---|---|
| Wiek w latach, M (SD) | 22.13 (1.73) | 22.25 (1.80) | −0.07 |
| Kobiety, n (%) | 140 (71.1) | 31 (55.4) | 0.33 |
| Stres w pierwszym pomiarze, M (SD) | 3.06 (0.75) | 3.13 (0.87) | −0.08 |
Uwaga. SMD – standaryzowana różnica (osoby z obu pomiarów minus osoby z jednym pomiarem). Stres: średnia skali 1–5. Dane symulowane.
Więcej niż dwa pomiary. W schemacie podłużnym z trzema pomiarami lub więcej schemat przepływu ma kolejne pola dla każdego pomiaru. Tabelę porównującą osoby, które zostały i odpadły, możesz wtedy zastąpić tabelą z liczbą osób i średnimi wynikami w każdym pomiarze, a w tekście podać odsetek osób z kompletem danych. Jeśli w analizie stosujesz model mieszany, który korzysta ze wszystkich dostępnych pomiarów, napisz, ilu osób dotyczy analiza, bo nie zawsze jest to liczba osób z kompletem danych.
Testy w tym wzorze są uzasadnione, bo nie porównują grup utworzonych losowo, tylko sprawdzają, czy odpadanie wiązało się z cechami uczestników. Jeśli wiązało się z wynikiem z pierwszego pomiaru, opisz to w ograniczeniach i rozważ metody uwzględniające wszystkie dostępne obserwacje (zob. braki danych i analiza ITT). Przy pomiarach powtarzanych przyda się też wpis ANOVA z powtarzanymi pomiarami czy model mieszany.
Wzór 5. Rekrutacja, kryteria i opis w streszczeniu
Charakterystyka próby w podrozdziale „Uczestnicy” zwykle zaczyna się od opisu rekrutacji i kryteriów. Poniższy wzór ma pola w nawiasach kwadratowych do uzupełnienia. Dobór opisz nazwą, której używa literatura, np. dobór celowy lub próba wygodna (zob. dobór celowy, wygodny i kula śnieżna).
Informacje o zgodzie i ochronie danych muszą odpowiadać temu, co naprawdę przekazano uczestnikom. Zakres takiej informacji omawia hasło świadoma zgoda i RODO w badaniach. Pytania z metryczki, na których opierasz opis próby, warto zacytować dosłownie w aneksie.
W streszczeniu pracy lub artykułu wystarcza jedno zdanie o próbie. Podaj w nim liczebność, populację, wiek i sposób doboru:
Jeżeli opis próby przygotowujesz do rozdziału metodologicznego pracy magisterskiej, jego miejsce wśród pozostałych podrozdziałów pokazuje wpis rozdział metodologiczny – jak go napisać. Zasady tabel ze statystykami opisowymi zmiennych badanych (a nie cech próby) omawia hasło tabela statystyk opisowych w APA.
Źle i dobrze: najczęstsze poprawki w tabeli charakterystyki próby
| Źle | Dobrze | Dlaczego |
|---|---|---|
| „Wiek: 35.88 ± 11.20” | „Wiek w latach, M (SD): 35.88 (11.20)” | znak ± bez opisu nie mówi, czy chodzi o SD, błąd standardowy, czy przedział ufności |
| „Kobiety: 55%” | „Kobiety, n (%): 221 (55.0)” | sam procent nie pozwala odtworzyć liczebności |
| Kolumna „p” w tabeli eksperymentu | Kolumny warunków i „Ogółem”, bez testów | różnice po losowaniu są z definicji przypadkowe |
| „Płeć: K 221, M 167” (bez osób z pozostałych kategorii) | Wszystkie kategorie, także „inna” i „wolę nie odpowiadać” | suma liczebności ma się zgadzać z N |
| Kategorie posortowane według liczebności | Kolejność naturalna lub jak w ankiecie | czytelnik szybciej porównuje tabele z różnych badań |
| „Próba była reprezentatywna” | „Próba miała charakter wygodny; jej strukturę porównano z…” | reprezentatywność wymaga uzasadnienia, a nie deklaracji |
Z zapisem „±” wiąże się częsty błąd: w opisie zmienności próby podaje się błąd standardowy zamiast odchylenia standardowego. Nagele (2003) stwierdził, że w czterech czołowych czasopismach anestezjologicznych zrobiono tak w 23% artykułów. Altman i Bland (2005) wyjaśniają, że do opisu obserwacji służy SD, a SE – do opisu niepewności oszacowania. W tabeli charakterystyki próby podawaj więc zawsze SD.
Lista kontrolna przed oddaniem rozdziału
- Liczebność w opisie próby zgadza się z liczebnością w analizach (albo wyjaśniasz różnicę: braki w pojedynczych zmiennych, wykluczenia).
- Każda tabela ma numer, tytuł kursywą i notę wyjaśniającą skróty oraz mianownik procentów.
- Przy zmiennych ilościowych podano M (SD), a przy skośnych także Mdn i kwartyle lub zakres.
- Przy zmiennych kategorialnych podano n i % dla wszystkich kategorii, a liczebności sumują się do N.
- W badaniu z grupami są osobne kolumny dla grup; w eksperymencie nie ma testów różnic wyjściowych.
- W badaniu z kilkoma pomiarami jest schemat przepływu uczestników i porównanie osób, które zostały i odpadły.
- Tekst podaje najważniejsze liczby i odsyła do tabeli zamiast powtarzać ją w całości.
- Małe kategorie są połączone tak, by nie dało się rozpoznać pojedynczych osób.
Jeżeli opis próby jest częścią większego rozdziału z wynikami, zobacz, jak łączy się z kolejnymi podrozdziałami we wpisie wyniki badań własnych – przykładowy rozdział. Dla ankiet internetowych przydatna jest lista CHERRIES. Eysenbach (2004) opracował ją po to, by czytelnik mógł ocenić sposób (samo)selekcji próby w e-ankiecie. Jak dojść do próby analitycznej od surowego eksportu, pokazuje wpis o analizie ankiety do pracy dyplomowej. Jeżeli Twoje badanie ma nietypowy schemat i nie wiesz, jak przedstawić próbę, możesz skonsultować tabelę i opis w ramach analiz statystycznych dla studentów.
Przykład w R
Kod odtwarza wszystkie liczby z tabel, akapitów i schematu przepływu oraz tworzy plik .docx z czterema tabelami. Zapisz przepis 1 jako kod/p22-1-tabele.R w katalogu roboczym – przepis 2 wczytuje go przez source() i korzysta z jego danych i funkcji. Wszystkie dane są symulowane (set.seed(2222)).
1. Dane czterech badań i liczby do tabel
R
# P22 – dane symulowane dla czterech typów badań i liczby do tabel charakterystyki próby
set.seed(2222)
f_msd  <- function(x) sprintf("%.2f (%.2f)", mean(x, na.rm = TRUE), sd(x, na.rm = TRUE))
f_mdn  <- function(x) { q <- quantile(x, c(.5, .25, .75), na.rm = TRUE); sprintf("%.0f [%.0f, %.0f]", q[1], q[2], q[3]) }
f_np   <- function(x, k) sprintf("%d (%.1f)", sum(x == k, na.rm = TRUE), 100 * mean(x == k, na.rm = TRUE))
smd_c  <- function(x, g) { a <- x[g == levels(g)[1]]; b <- x[g == levels(g)[2]]
  (mean(a, na.rm = TRUE) - mean(b, na.rm = TRUE)) / sqrt((var(a, na.rm = TRUE) + var(b, na.rm = TRUE)) / 2) }
smd_p  <- function(x, g) { p1 <- mean(x[g == levels(g)[1]]); p2 <- mean(x[g == levels(g)[2]])
  (p1 - p2) / sqrt((p1 * (1 - p1) + p2 * (1 - p2)) / 2) }

## A. Badanie ankietowe jednej grupy (dorośli, ankieta online)
nA <- 402
A <- data.frame(wiek = pmin(18 + round(rgamma(nA, 2.3, 0.13)), 67),
  plec = sample(c("kobieta", "mężczyzna", "inna", "wolę nie odpowiadać"), nA, TRUE, c(.61, .36, .015, .015)),
  wykszt = sample(c("podstawowe lub zasadnicze zawodowe", "średnie", "wyższe"), nA, TRUE, c(.12, .41, .47)),
  miejsce = sample(c("wieś", "miasto do 100 tys.", "miasto powyżej 100 tys."), nA, TRUE, c(.29, .31, .40)),
  praca = sample(c("pracuje", "uczy się lub studiuje", "nie pracuje", "emerytura lub renta"), nA, TRUE, c(.58, .22, .12, .08)))
cat("A: N =", nA, "\n")
c(wiek_M_SD = f_msd(A$wiek), wiek_Mdn_IQR = f_mdn(A$wiek), zakres = paste(range(A$wiek), collapse = "–"))
for (v in c("plec", "wykszt", "miejsce", "praca")) print(sapply(sort(unique(A[[v]])), function(k) f_np(A[[v]], k)))

## B. Dwie grupy porównawcze (grupa kliniczna i kontrolna, dobór nielosowy)
B <- data.frame(grupa = factor(rep(c("kliniczna", "kontrolna"), c(46, 50)), levels = c("kliniczna", "kontrolna")))
B$wiek  <- round(ifelse(B$grupa == "kliniczna", rnorm(96, 34.5, 9.5), rnorm(96, 31.0, 8.5)))
B$kob   <- rbinom(96, 1, ifelse(B$grupa == "kliniczna", .70, .62))
B$nauka <- round(ifelse(B$grupa == "kliniczna", rnorm(96, 14.1, 2.4), rnorm(96, 15.3, 2.2)))
B$od_diagnozy <- ifelse(B$grupa == "kliniczna", round(rgamma(96, 1.4, 0.3)), NA)
B$leki  <- ifelse(B$grupa == "kliniczna", rbinom(96, 1, .54), NA)
cat("B: n =", table(B$grupa), "\n")
rbind(wiek = c(tapply(B$wiek, B$grupa, f_msd), ogolem = f_msd(B$wiek)),
      kobiety = c(tapply(B$kob, B$grupa, f_np, k = 1), ogolem = f_np(B$kob, 1)),
      lata_nauki = c(tapply(B$nauka, B$grupa, f_msd), ogolem = f_msd(B$nauka)))
c(od_diagnozy_Mdn_IQR = f_mdn(B$od_diagnozy[B$grupa == "kliniczna"]), leki = f_np(B$leki[B$grupa == "kliniczna"], 1))
round(c(SMD_wiek = smd_c(B$wiek, B$grupa), SMD_kobiety = smd_p(B$kob, B$grupa), SMD_nauka = smd_c(B$nauka, B$grupa)), 2)

## C. Eksperyment z losowym przydziałem do trzech warunków
C <- data.frame(warunek = factor(sample(rep(c("kontrolny", "uważność", "relaksacja"), c(41, 40, 42))),
                                 levels = c("kontrolny", "uważność", "relaksacja")))
C$wiek <- 19 + rpois(123, 2.4); C$kob <- rbinom(123, 1, .68); C$nastroj <- round(rnorm(123, 4.6, 1.1), 1)
cat("C: n =", table(C$warunek), "\n")
range(C$wiek)
rbind(wiek = c(tapply(C$wiek, C$warunek, f_msd), ogolem = f_msd(C$wiek)),
      kobiety = c(tapply(C$kob, C$warunek, f_np, k = 1), ogolem = f_np(C$kob, 1)),
      nastroj_przed = c(tapply(C$nastroj, C$warunek, f_msd), ogolem = f_msd(C$nastroj)))

## D. Badanie podłużne: kto został do drugiego pomiaru
zaproszeni <- 1150
rozpoczeli <- rbinom(1, zaproszeni, .27)
ukonczyli_T1 <- rbinom(1, rozpoczeli, .90)
D <- data.frame(wiek = 19 + rpois(ukonczyli_T1, 3), kob = rbinom(ukonczyli_T1, 1, .66),
                stres_T1 = round(pmin(pmax(rnorm(ukonczyli_T1, 3.1, .75), 1), 5), 2),
                kontrola_ok = rbinom(ukonczyli_T1, 1, .93))
D <- D[D$kontrola_ok == 1, ]
D$T2 <- factor(ifelse(rbinom(nrow(D), 1, plogis(1.1 - 0.45 * scale(D$stres_T1)[, 1] + 0.3 * D$kob)) == 1,
                      "zostali", "odpadli"), levels = c("zostali", "odpadli"))
c(zaproszeni = zaproszeni, nie_odpowiedzieli = zaproszeni - rozpoczeli, rozpoczeli = rozpoczeli,
  przerwali = rozpoczeli - ukonczyli_T1, ukonczyli_T1 = ukonczyli_T1,
  wykluczeni_kontrola = ukonczyli_T1 - nrow(D), analiza_T1 = nrow(D), T2 = sum(D$T2 == "zostali"),
  odpadli = sum(D$T2 == "odpadli"))
round(c(proc_rozpoczelo = 100 * rozpoczeli / zaproszeni, proc_T2 = 100 * mean(D$T2 == "zostali")), 1)
rbind(wiek = c(tapply(D$wiek, D$T2, f_msd), ogolem = f_msd(D$wiek)),
      kobiety = c(tapply(D$kob, D$T2, f_np, k = 1), ogolem = f_np(D$kob, 1)),
      stres_T1 = c(tapply(D$stres_T1, D$T2, f_msd), ogolem = f_msd(D$stres_T1)))
round(c(SMD_wiek = smd_c(D$wiek, D$T2), SMD_kobiety = smd_p(D$kob, D$T2), SMD_stres = smd_c(D$stres_T1, D$T2)), 2)
tt <- t.test(stres_T1 ~ T2, data = D)
round(c(t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value), 3)
ch <- chisq.test(table(D$T2, D$kob), correct = FALSE)
round(c(chi2 = unname(ch$statistic), p = ch$p.value), 3)
Wynik w R
A: N = 402
      wiek_M_SD    wiek_Mdn_IQR          zakres
"35.88 (11.20)"   "34 [27, 42]"         "20–67"
               inna             kobieta           mężczyzna wolę nie odpowiadać
          "8 (2.0)"        "221 (55.0)"        "167 (41.5)"           "6 (1.5)"
podstawowe lub zasadnicze zawodowe                            średnie
                       "48 (11.9)"                       "154 (38.3)"
                            wyższe
                      "200 (49.8)"
     miasto do 100 tys. miasto powyżej 100 tys.                    wieś
           "137 (34.1)"            "141 (35.1)"            "124 (30.8)"
  emerytura lub renta           nie pracuje               pracuje
           "35 (8.7)"           "45 (11.2)"          "235 (58.5)"
uczy się lub studiuje
          "87 (21.6)"
B: n = 46 50
           kliniczna      kontrolna      ogolem
wiek       "33.72 (8.32)" "32.94 (8.93)" "33.31 (8.60)"
kobiety    "32 (69.6)"    "27 (54.0)"    "59 (61.5)"
lata_nauki "14.17 (2.51)" "15.36 (2.00)" "14.79 (2.33)"
od_diagnozy_Mdn_IQR                leki
         "4 [2, 7]"         "27 (58.7)"
   SMD_wiek SMD_kobiety   SMD_nauka
       0.09        0.32       -0.52
C: n = 41 40 42
[1] 19 27
              kontrolny      uważność       relaksacja     ogolem
wiek          "21.32 (1.71)" "21.30 (1.56)" "21.62 (1.59)" "21.41 (1.61)"
kobiety       "28 (68.3)"    "29 (72.5)"    "29 (69.0)"    "86 (69.9)"
nastroj_przed "4.69 (1.07)"  "4.36 (1.04)"  "4.61 (1.11)"  "4.56 (1.07)"
         zaproszeni   nie_odpowiedzieli          rozpoczeli           przerwali
               1150                 853                 297                  26
       ukonczyli_T1 wykluczeni_kontrola          analiza_T1                  T2
                271                  18                 253                 197
            odpadli
                 56
proc_rozpoczelo         proc_T2
           25.8            77.9
         zostali        odpadli        ogolem
wiek     "22.13 (1.73)" "22.25 (1.80)" "22.15 (1.74)"
kobiety  "140 (71.1)"   "31 (55.4)"    "171 (67.6)"
stres_T1 "3.06 (0.75)"  "3.13 (0.87)"  "3.08 (0.77)"
   SMD_wiek SMD_kobiety   SMD_stres
      -0.07        0.33       -0.08
     t     df      p
-0.537 79.095  0.593
 chi2     p
4.912 0.027
2. Plik .docx z tabelami w stylu APA
R
# Plik .docx z czterema wzorami tabel charakterystyki próby – uruchom z katalogu strony
suppressPackageStartupMessages({ library(officer); library(flextable) })
invisible(capture.output(source("kod/p22-1-tabele.R")))

apa_ft <- function(df, szer) {
  ft <- flextable(df)
  ft <- font(ft, fontname = "Times New Roman", part = "all"); ft <- fontsize(ft, size = 11, part = "all")
  ft <- border_remove(ft)
  ft <- hline_top(ft, border = fp_border(width = 1.5), part = "header")
  ft <- hline_bottom(ft, border = fp_border(width = 1), part = "header")
  ft <- hline_bottom(ft, border = fp_border(width = 1.5), part = "body")
  ft <- align(ft, j = 1, align = "left", part = "all"); ft <- align(ft, j = -1, align = "center", part = "all")
  ft <- width(ft, width = szer); ft <- padding(ft, padding.top = 2, padding.bottom = 2, part = "all")
  ft
}
naglowek <- function(doc, nr, tytul) {
  doc <- body_add_fpar(doc, fpar(ftext(paste("Tabela", nr), fp_text(bold = TRUE, font.family = "Times New Roman", font.size = 12))))
  body_add_fpar(doc, fpar(ftext(tytul, fp_text(italic = TRUE, font.family = "Times New Roman", font.size = 12))))
}
uwaga <- function(doc, tekst) {
  doc <- body_add_fpar(doc, fpar(ftext("Uwaga. ", fp_text(italic = TRUE, font.family = "Times New Roman", font.size = 10)),
                                 ftext(tekst, fp_text(font.family = "Times New Roman", font.size = 10))))
  body_add_par(doc, "")
}
ord <- function(x, poziomy) sapply(poziomy, function(k) f_np(x, k))

# Tabela 1 – jedna grupa
t1 <- data.frame(Cecha = c("Wiek w latach, M (SD)", "Wiek w latach, Mdn [Q1, Q3]", "Wiek w latach, zakres", "Płeć",
                           "  kobieta", "  mężczyzna", "  inna", "  wolę nie odpowiadać", "Wykształcenie",
                           "  podstawowe lub zasadnicze zawodowe", "  średnie", "  wyższe", "Miejsce zamieszkania",
                           "  wieś", "  miasto do 100 tys.", "  miasto powyżej 100 tys.", "Sytuacja zawodowa",
                           "  pracuje", "  uczy się lub studiuje", "  nie pracuje", "  emerytura lub renta"),
                 Wartosc = c(f_msd(A$wiek), f_mdn(A$wiek), paste(range(A$wiek), collapse = "–"), "",
                             ord(A$plec, c("kobieta", "mężczyzna", "inna", "wolę nie odpowiadać")), "",
                             ord(A$wykszt, c("podstawowe lub zasadnicze zawodowe", "średnie", "wyższe")), "",
                             ord(A$miejsce, c("wieś", "miasto do 100 tys.", "miasto powyżej 100 tys.")), "",
                             ord(A$praca, c("pracuje", "uczy się lub studiuje", "nie pracuje", "emerytura lub renta"))))
names(t1) <- c("Cecha", "n (%) lub M (SD)")
# Tabela 2 – dwie grupy
t2 <- data.frame(Cecha = c("Wiek w latach, M (SD)", "Kobiety, n (%)", "Lata nauki, M (SD)",
                           "Czas od diagnozy w latach, Mdn [Q1, Q3]", "Przyjmowanie leków, n (%)"),
                 K = c(f_msd(B$wiek[B$grupa == "kliniczna"]), f_np(B$kob[B$grupa == "kliniczna"], 1),
                       f_msd(B$nauka[B$grupa == "kliniczna"]), f_mdn(B$od_diagnozy[B$grupa == "kliniczna"]),
                       f_np(B$leki[B$grupa == "kliniczna"], 1)),
                 Kt = c(f_msd(B$wiek[B$grupa == "kontrolna"]), f_np(B$kob[B$grupa == "kontrolna"], 1),
                        f_msd(B$nauka[B$grupa == "kontrolna"]), "–", "–"),
                 SMD = c(sprintf("%.2f", smd_c(B$wiek, B$grupa)), sprintf("%.2f", smd_p(B$kob, B$grupa)),
                         sub("-", "−", sprintf("%.2f", smd_c(B$nauka, B$grupa))), "–", "–"))
names(t2) <- c("Cecha", "Grupa kliniczna (n = 46)", "Grupa kontrolna (n = 50)", "SMD")
# Tabela 3 – eksperyment
t3 <- data.frame(Cecha = c("Wiek w latach, M (SD)", "Kobiety, n (%)", "Nastrój przed manipulacją, M (SD)"),
                 a = c(f_msd(C$wiek[C$warunek == "kontrolny"]), f_np(C$kob[C$warunek == "kontrolny"], 1), f_msd(C$nastroj[C$warunek == "kontrolny"])),
                 b = c(f_msd(C$wiek[C$warunek == "uważność"]), f_np(C$kob[C$warunek == "uważność"], 1), f_msd(C$nastroj[C$warunek == "uważność"])),
                 c = c(f_msd(C$wiek[C$warunek == "relaksacja"]), f_np(C$kob[C$warunek == "relaksacja"], 1), f_msd(C$nastroj[C$warunek == "relaksacja"])),
                 d = c(f_msd(C$wiek), f_np(C$kob, 1), f_msd(C$nastroj)))
names(t3) <- c("Cecha", "Kontrolny (n = 41)", "Uważność (n = 40)", "Relaksacja (n = 42)", "Ogółem (N = 123)")
# Tabela 4 – podłużne
t4 <- data.frame(Cecha = c("Wiek w latach, M (SD)", "Kobiety, n (%)", "Stres w pierwszym pomiarze, M (SD)"),
                 a = c(f_msd(D$wiek[D$T2 == "zostali"]), f_np(D$kob[D$T2 == "zostali"], 1), f_msd(D$stres_T1[D$T2 == "zostali"])),
                 b = c(f_msd(D$wiek[D$T2 == "odpadli"]), f_np(D$kob[D$T2 == "odpadli"], 1), f_msd(D$stres_T1[D$T2 == "odpadli"])),
                 SMD = sub("-", "−", sprintf("%.2f", c(smd_c(D$wiek, D$T2), smd_p(D$kob, D$T2), smd_c(D$stres_T1, D$T2)))))
names(t4) <- c("Cecha", "Oba pomiary (n = 197)", "Tylko pierwszy pomiar (n = 56)", "SMD")

doc <- read_docx()
doc <- body_add_fpar(doc, fpar(ftext("Wzory tabel charakterystyki próby (APA 7) – dane symulowane, metodolog.pl",
                                      fp_text(bold = TRUE, font.family = "Times New Roman", font.size = 13))))
doc <- body_add_par(doc, "Zastąp liczby własnymi wynikami. Wiersze z wcięciem to kategorie zmiennej podanej wyżej.")
doc <- naglowek(doc, 1, "Charakterystyka socjodemograficzna uczestników badania (N = 402)")
doc <- body_add_flextable(doc, apa_ft(t1, c(3.6, 2.0)), align = "left")
doc <- uwaga(doc, "Procenty obliczono od liczebności całej próby. Q1 i Q3 – pierwszy i trzeci kwartyl.")
doc <- naglowek(doc, 2, "Charakterystyka grupy klinicznej i kontrolnej")
doc <- body_add_flextable(doc, apa_ft(t2, c(2.4, 1.45, 1.45, 0.7)), align = "left")
doc <- uwaga(doc, "SMD – standaryzowana różnica (grupa kliniczna minus kontrolna); dla odsetka kobiet obliczona z proporcji. Kreska – nie dotyczy.")
doc <- naglowek(doc, 3, "Charakterystyka uczestników w trzech warunkach eksperymentu")
doc <- body_add_flextable(doc, apa_ft(t3, c(2.1, 1.1, 1.1, 1.1, 1.1)), align = "left")
doc <- uwaga(doc, "Uczestników przydzielono do warunków losowo, dlatego nie podano testów istotności różnic między warunkami.")
doc <- naglowek(doc, 4, "Porównanie osób, które wzięły udział w obu pomiarach, z osobami, które zrezygnowały po pierwszym")
doc <- body_add_flextable(doc, apa_ft(t4, c(2.4, 1.45, 1.45, 0.7)), align = "left")
doc <- uwaga(doc, "SMD – standaryzowana różnica (osoby z obu pomiarów minus osoby z jednym pomiarem).")
doc <- set_doc_properties(doc, title = "Wzory tabel charakterystyki próby", creator = "Metodolog.pl",
                          description = "Wzory tabel APA 7; dane symulowane", created = as.POSIXct("2026-10-21 12:00:00", tz = "UTC"))
print(doc, target = "wzor-przedstawienia-charakterystyki-proby-tabele.docx")

# Metadane: autor i ostatnia modyfikacja = Metodolog.pl (officer wpisuje nazwę użytkownika systemu)
plik <- normalizePath("wzor-przedstawienia-charakterystyki-proby-tabele.docx")
tmp <- tempfile("docx_"); dir.create(tmp); utils::unzip(plik, exdir = tmp)
core_f <- file.path(tmp, "docProps", "core.xml")
core <- paste(readLines(core_f, warn = FALSE, encoding = "UTF-8"), collapse = "")
core <- sub("<cp:lastModifiedBy>.*?</cp:lastModifiedBy>", "<cp:lastModifiedBy>Metodolog.pl</cp:lastModifiedBy>", core)
writeLines(core, core_f, useBytes = TRUE)
pliki <- list.files(tmp, recursive = TRUE, all.files = TRUE)
unlink(plik); zip::zip(plik, files = pliki, root = tmp)

# Kontrola: ponowne wczytanie pliku
spr <- officer::docx_summary(officer::read_docx(plik))
print(head(unique(spr$text[spr$content_type == "paragraph" & grepl("^Tabela|^Uwaga", spr$text)]), 8))
tmp2 <- tempfile("docx_"); dir.create(tmp2); utils::unzip(plik, exdir = tmp2)
core2 <- paste(readLines(file.path(tmp2, "docProps", "core.xml"), warn = FALSE, encoding = "UTF-8"), collapse = "")
cat("creator:", sub(".*<dc:creator>(.*?)</dc:creator>.*", "\\1", core2), "| lastModifiedBy:",
    sub(".*<cp:lastModifiedBy>(.*?)</cp:lastModifiedBy>.*", "\\1", core2), "\n")
wszystko <- paste(unlist(lapply(list.files(tmp2, recursive = TRUE, full.names = TRUE), function(f)
  paste(readLines(f, warn = FALSE, encoding = "UTF-8"), collapse = ""))), collapse = "")
cat("Tabele w pliku:", lengths(regmatches(wszystko, gregexpr("<w:tbl[ >]", wszystko))), "\n")
cat("Nazwa użytkownika systemu w pliku:", grepl(Sys.getenv("USER"), wszystko, fixed = TRUE), "\n")
Wynik w R
[1] "Tabela 1"
[2] "Uwaga. Procenty obliczono od liczebności całej próby. Q1 i Q3 – pierwszy i trzeci kwartyl."
[3] "Tabela 2"
[4] "Uwaga. SMD – standaryzowana różnica (grupa kliniczna minus kontrolna); dla odsetka kobiet obliczona z proporcji. Kreska – nie dotyczy."
[5] "Tabela 3"
[6] "Uwaga. Uczestników przydzielono do warunków losowo, dlatego nie podano testów istotności różnic między warunkami."
[7] "Tabela 4"
[8] "Uwaga. SMD – standaryzowana różnica (osoby z obu pomiarów minus osoby z jednym pomiarem)."
creator: Metodolog.pl | lastModifiedBy: Metodolog.pl
Tabele w pliku: 4
Nazwa użytkownika systemu w pliku: FALSE
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; plik .docx utworzono w pakietach officer i flextable, a schemat przepływu – w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- officer (wersja 0.7.4): Gohel, D., Moog, S., & Heckmann, M. (2026). officer: Manipulation of Microsoft Word and PowerPoint documents [R package]. https://doi.org/10.32614/CRAN.package.officer
- flextable (wersja 0.9.11): Gohel, D., & Skintzos, P. (2026). flextable: Functions for tabular reporting [R package]. https://doi.org/10.32614/CRAN.package.flextable
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Jak powinna wyglądać tabela charakterystyki próby w APA 7?
Nad tabelą pogrubiony numer („Tabela 1”) i tytuł kursywą, w tabeli tylko linie poziome (nad i pod nagłówkiem oraz na końcu), w wierszach cechy, a w kolumnach wartości dla całej próby albo dla grup. Pod tabelą nota zaczynająca się od „Uwaga.” wyjaśnia skróty i mianownik procentów.
Czy w tabeli charakterystyki grup podawać wartości p?
W eksperymencie z losowym przydziałem nie – różnice po losowaniu są przypadkowe, a testy niczego nie sprawdzają. Przy grupach dobranych osobno (np. kliniczna i kontrolna) lepiej podać standaryzowane różnice (SMD), które nie zależą od liczebności. Testy są uzasadnione przy porównaniu osób, które zostały w badaniu, z tymi, które odpadły.
Jak opisać w pracy osoby, które zrezygnowały z drugiego pomiaru?
Podaj liczbę i odsetek osób w każdym pomiarze, najlepiej na schemacie przepływu uczestników, i porównaj osoby z obu pomiarów z osobami, które odpadły, pod względem cech z pierwszego pomiaru. Jeśli odpadanie wiązało się z wynikiem, opisz to w ograniczeniach.
Ile cech socjodemograficznych umieścić w tabeli opisu próby?
Tyle, ile potrzeba, by czytelnik wiedział, kogo zbadano: zwykle wiek, płeć oraz 2–4 cechy określające populację lub związane z pytaniem badawczym. Gdy cech jest najwyżej trzy, wystarczy akapit bez tabeli.
Czy charakterystykę próby umieścić w metodzie czy w wynikach?
W układzie APA opis uczestników należy do metody (podrozdział „Uczestnicy”), razem z rekrutacją, kryteriami i przepływem uczestników. W wynikach umieszcza się statystyki opisowe zmiennych badanych, a nie cech próby.
Powiązane hasła
Przeczytaj też
Numeracja i podpisy tabel w Wordzie
Podpisy, numer z rozdziałem, odsyłacze, spis tabel, tabela APA, wyniki ze SPSS i naprawa „Błąd! Nie można odnaleźć źródła odwołania”.
Czytaj →PoradnikJak opisać eksperyment ankietowy
Co napisać w metodzie i wynikach eksperymentu online: bodziec, losowanie, sprawdzenie manipulacji, schemat przepływu, efekt z CI i gotowe zdania APA.
Czytaj →PoradnikJak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Chcesz, żeby ktoś sprawdził opis Twojej próby?
Przygotujemy tabele i opis uczestników do Twojego schematu badania i wyjaśnimy każdą liczbę, tak abyś mógł(mogła) je samodzielnie omówić w pracy i na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903 ● Otwarty dostęp
- Austin, P. C. (2009). Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples. Statistics in Medicine, 28(25), 3083–3107. https://doi.org/10.1002/sim.3697 ● Otwarty dostęp
- de Boer, M. R., Waterlander, W. E., Kuijper, L. D. J., Steenhuis, I. H. M., & Twisk, J. W. R. (2015). Testing for baseline differences in randomized controlled trials: An unhealthy research behavior that is hard to eradicate. International Journal of Behavioral Nutrition and Physical Activity, 12(1), Article 4. https://doi.org/10.1186/s12966-015-0162-z ● Otwarty dostęp
- Eysenbach, G. (2004). Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES). Journal of Medical Internet Research, 6(3), Article e34. https://doi.org/10.2196/jmir.6.3.e34 ● Otwarty dostęp
- Hayes-Larson, E., Kezios, K. L., Mooney, S. J., & Lovasi, G. (2019). Who is in this study, anyway? Guidelines for a useful Table 1. Journal of Clinical Epidemiology, 114, 125–132. https://doi.org/10.1016/j.jclinepi.2019.06.011 ● Otwarty dostęp: pełny tekst
- Hughes, J. L., Camden, A. A., Yangchen, T., Smith, G. P. A., Domenech Rodríguez, M. M., Rouse, S. V., McDonald, C. P., & Lopez, S. (2022). Guidance for researchers when using inclusive demographic questions for surveys: Improved and updated questions. Psi Chi Journal of Psychological Research, 27(4), 232–255. https://doi.org/10.24839/2325-7342.JN27.4.232 ● Otwarty dostęp
- Nagele, P. (2003). Misuse of standard error of the mean (SEM) when reporting variability of a sample. A critical evaluation of four anaesthesia journals. British Journal of Anaesthesia, 90(4), 514–516. https://doi.org/10.1093/bja/aeg087 ● Otwarty dostęp
- Schulz, K. F., Altman, D. G., Moher, D., & CONSORT Group. (2010). CONSORT 2010 statement: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, Article c332. https://doi.org/10.1136/bmj.c332 ● Otwarty dostęp
- Zhou, H., & Fishbach, A. (2016). The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions. Journal of Personality and Social Psychology, 111(4), 493–504. https://doi.org/10.1037/pspa0000056
Cytowania BibTeX
@article{altman2005standard, author={Altman, Douglas G. and Bland, J. Martin}, title={{Standard deviations and standard errors}}, journal={BMJ}, year={2005}, volume={331}, number={7521}, pages={903}, doi={10.1136/bmj.331.7521.903}}@article{austin2009balance, author={Austin, Peter C.}, title={{Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={25}, pages={3083--3107}, doi={10.1002/sim.3697}}@article{deboer2015testing, author={de Boer, Michiel R. and Waterlander, Wilma E. and Kuijper, Lothar D. J. and Steenhuis, Ingrid H. M. and Twisk, Jos W. R.}, title={{Testing for baseline differences in randomized controlled trials: An unhealthy research behavior that is hard to eradicate}}, journal={International Journal of Behavioral Nutrition and Physical Activity}, year={2015}, volume={12}, number={1}, eid={4}, doi={10.1186/s12966-015-0162-z}}@article{eysenbach2004improving, author={Eysenbach, Gunther}, title={{Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES)}}, journal={Journal of Medical Internet Research}, year={2004}, volume={6}, number={3}, eid={e34}, doi={10.2196/jmir.6.3.e34}}@article{hayeslarson2019who, author={Hayes-Larson, Eleanor and Kezios, Katrina L. and Mooney, Stephen J. and Lovasi, Gina}, title={{Who is in this study, anyway? Guidelines for a useful Table 1}}, journal={Journal of Clinical Epidemiology}, year={2019}, volume={114}, pages={125--132}, doi={10.1016/j.jclinepi.2019.06.011}}@article{hughes2022guidance, author={Hughes, Jennifer L. and Camden, Abigail A. and Yangchen, Tenzin and Smith, Gabrielle P. A. and Domenech Rodríguez, Melanie M. and Rouse, Steven V. and McDonald, C. Peeper and Lopez, Stella}, title={{Guidance for researchers when using inclusive demographic questions for surveys: Improved and updated questions}}, journal={Psi Chi Journal of Psychological Research}, year={2022}, volume={27}, number={4}, pages={232--255}, doi={10.24839/2325-7342.jn27.4.232}}@article{nagele2003misuse, author={Nagele, Peter}, title={{Misuse of standard error of the mean (SEM) when reporting variability of a sample. A critical evaluation of four anaesthesia journals}}, journal={British Journal of Anaesthesia}, year={2003}, volume={90}, number={4}, pages={514--516}, doi={10.1093/bja/aeg087}}@article{schulz2010consort, author={Schulz, Kenneth F. and Altman, Douglas G. and Moher, David and {CONSORT Group}}, title={{CONSORT 2010 statement: Updated guidelines for reporting parallel group randomised trials}}, journal={BMJ}, year={2010}, volume={340}, eid={c332}, doi={10.1136/bmj.c332}}@article{zhou2016pitfall, author={Zhou, Haotian and Fishbach, Ayelet}, title={{The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions}}, journal={Journal of Personality and Social Psychology}, year={2016}, volume={111}, number={4}, pages={493--504}, doi={10.1037/pspa0000056}}