Charakterystyka próby badawczej: po co ją opisujesz
Opis próby bywa traktowany jak formalność: kilka zdań o wieku i płci przepisanych z metryczki. Tymczasem to jedyne miejsce, w którym czytelnik dowiaduje się, kogo naprawdę zbadano. Od tego zależy, na kogo można przenieść wyniki, czy są porównywalne z innymi badaniami i czy przy interpretacji nie trzeba czegoś zastrzec. Hayes-Larson i in. (2019) piszą, że dobrze przygotowana tabela charakterystyki próby pozwala ocenić zagrożenia zarówno trafności wewnętrznej, jak i zewnętrznej.
Opis próby pełni trzy funkcje:
- Granice uogólnienia. Wynik uzyskany na 318 studentach jednej uczelni, w większości studiujących stacjonarnie, nie mówi wprost nic o pracujących trzydziestolatkach. Andrade (2021) podkreśla, że wyniki z prób wygodnych i celowych można uogólniać tylko na (sub)populację, z której pochodzą.
- Kontekst interpretacji. Średni poziom stresu ma inne znaczenie w próbie studentów pierwszego roku niż w próbie osób kończących studia i jednocześnie pracujących.
- Porównywalność i kumulacja wiedzy. Autorzy przeglądów i metaanaliz korzystają z opisu próby, by zdecydować, czy badania da się zestawić. Rad i in. (2018) pokazali, że w artykułach z czołowego czasopisma psychologicznego próby niemal zawsze pochodziły z krajów zachodnich, a wnioski formułowano tak, jakby dotyczyły ludzi w ogóle. Wcześniej Henrich i in. (2010) zwrócili uwagę, że populacje WEIRD (zachodnie, wykształcone, uprzemysłowione, bogate i demokratyczne) są w wielu zjawiskach psychologicznych nietypowe.
Ten wpis wyjaśnia, co opisać i jakie decyzje podjąć po drodze: miary dla wieku, przedziały wiekowe, kategorie i braki, porównanie z populacją. Gotowe tabele i zdania dla różnych typów badań, do skopiowania, zebraliśmy osobno we wzorze przedstawienia charakterystyki próby. Przykład dotyczy ankiety online wypełnionej przez 318 studentów jednej uczelni (dane symulowane). Wszystkie liczby pochodzą z kodu w sekcji Przykład w R.
Które cechy opisać, a których nie
Nie opisuj wszystkiego, co jest w metryczce, tylko dlatego, że to zebrałeś(-aś). Wybierz cechy według trzech kryteriów:
- Minimum dla każdej pracy: liczebność analizowanej próby, wiek oraz płeć lub tożsamość płciowa. Uzupełnij je o cechy określające populację, np. kierunek, rok i tryb studiów albo staż pracy.
- Cechy związane z pytaniem badawczym: zmienne, które mogą wiązać się z wynikiem. W badaniu stresu będą to np. praca zarobkowa czy rok studiów, a w badaniu klinicznym – czas trwania zaburzenia i leczenie.
- Cechy potrzebne do oceny doboru: te, dla których istnieją dane o populacji i które pozwalają porównać z nią próbę (zob. porównanie z populacją).
Cech, których nie wykorzystujesz w analizie ani w interpretacji, nie zbieraj wcale. To zasada minimalizacji danych, którą omawia hasło metryczka. Każde dodatkowe pytanie demograficzne wydłuża ankietę i zwiększa ryzyko identyfikacji osób w małych grupach. Wytyczne APA JARS obejmują osobny moduł JARS–REC, poświęcony raportowaniu rasy, etniczności i kultury (American Psychological Association, b.d.). W polskich pracach dyplomowych pytania o pochodzenie etniczne zadaje się rzadko, ale warto wiedzieć, że uwzględnienie kontekstu kulturowego próby należy do standardu raportowania.
| Cecha | Po co ją opisać | Jak opisać |
|---|---|---|
| Wiek | zasięg uogólnienia, porównywalność | M i SD albo Mdn i IQR oraz zakres; przedziały tylko z uzasadnieniem |
| Płeć / tożsamość płciowa | porównywalność, ewentualne analizy w grupach | n (%) dla każdej kategorii, łącznie z „inna” i „wolę nie odpowiadać” |
| Rok i tryb studiów | określenie populacji, porównanie ze strukturą uczelni | n (%) |
| Praca zarobkowa, sytuacja rodzinna | tylko gdy wiąże się z pytaniem badawczym | n (%) |
| Cechy kliniczne | w badaniach z grupą kliniczną | czas trwania (Mdn, IQR), leczenie (n, %) |
Wiek i inne zmienne ilościowe: średnia czy mediana?
Najczęstszy zapis to „M = 22.73, SD = 4.07”. Jest poprawny, jeśli rozkład jest w miarę symetryczny. W próbach studenckich zwykle nie jest: większość osób ma 20–24 lata, a kilkanaście osób studiujących zaocznie ma 30, 40 czy 50 lat. Tak jest i w przykładzie (rysunek 1). Wiek wahał się od 19 do 54 lat, a skośność wyniosła 3.49.
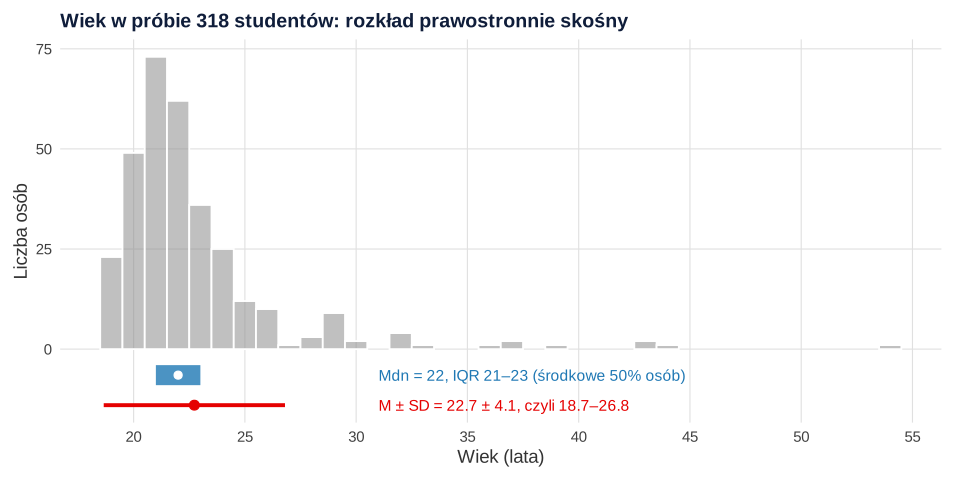
Kształt rozkładu najszybciej ocenisz na histogramie. Przy takiej skośności średnia (22.73) jest przesunięta w stronę starszych osób, a odchylenie standardowe (4.07) zawyża rozproszenie w środku rozkładu. Przedział „średnia ± SD” zaczyna się od 18.7 roku, czyli poniżej wieku najmłodszej osoby w próbie. Mediana wynosi 22 lata, a rozstęp ćwiartkowy 21–23 lata. Środkowa połowa próby mieści się więc w trzech latach życia, a osób w wieku co najmniej 30 lat było 4.7%.
Praktyczna reguła: przy wyraźnej skośności podaj medianę z IQR, a obok zakres. Średnią i SD możesz dołączyć, bo wiele czasopism i metaanaliz z nich korzysta. W tekście może to brzmieć tak: „Wiek uczestników wynosił od 19 do 54 lat (Mdn = 22, IQR: 21–23; M = 22.73, SD = 4.07)”. Więcej o doborze miar przy różnych rozkładach znajdziesz we wpisie o statystykach opisowych w pracy.
Skośność często wynika z mieszania dwóch grup. W przykładzie studenci stacjonarni (n = 263) mieli średnio 21.5 roku (SD = 1.6), a niestacjonarni (n = 55) – 28.6 roku (SD = 6.5). Gdy próba składa się z wyraźnie różnych podgrup, opis wieku w każdej z nich mówi więcej niż jedna liczba dla całości.
Do opisu zmienności próby używaj odchylenia standardowego, a nie błędu standardowego. Altman i Bland (2005) przypominają, że SD opisuje rozproszenie obserwacji, a błąd standardowy – niepewność oszacowania średniej. Ten drugi jest zawsze mniejszy, więc podany w opisie próby sugeruje, że uczestnicy są bardziej podobni do siebie, niż są w rzeczywistości.
Przedziały wieku: kiedy i jakie
Zbieraj wiek w latach, a nie w przedziałach. Przedziały zawsze da się utworzyć później, a liczby lat z przedziału już nie odtworzysz. Jeśli jednak chcesz pokazać wiek w kategoriach, granice przedziałów są decyzją, którą trzeba uzasadnić. W przykładzie te same 318 osób podzielono na trzy sposoby:
| Sposób grupowania | Przedziały i liczebności | Ocena |
|---|---|---|
| Przedziały merytoryczne | 18–21: 145; 22–24: 123; 25–29: 35; 30+: 15 | czytelne i porównywalne z innymi badaniami; granice wynikają z etapu studiów |
| Tercyle próby | 19–21: 145; 22–23: 98; 24–54: 75 | granice zależą od próby, ostatnia grupa łączy 24-latków z 54-latkami |
| Równe przedziały 10-letnie | 15–24: 268; 25–34: 42; 35–44: 7; 45–54: 1 | prawie cała próba w jednej kategorii, a ostatnia ma 1 osobę |
Wybierz przedziały merytoryczne, ustalone przed analizą: etapy studiów, grupy wiekowe z dokumentu, z którym się porównujesz, albo z literatury. Unikaj podziału według kwantyli Twojej próby, bo granice zmieniają się z badania na badanie. Podział według mediany w analizie statystycznej ma dodatkowe wady, które opisuje hasło dzielenie medianą. Kategoria z jedną osobą nic nie mówi i zwiększa ryzyko jej rozpoznania. Takie kategorie łącz z sąsiednimi, np. „35 lat i więcej”.
Przedziały w opisie próby nie zastępują wieku w analizach. Jeżeli wiek jest zmienną kontrolną w regresji, wprowadź go jako liczbę lat, a nie jako kategorie.
Płeć, kategorie odpowiedzi i braki danych
Dla każdej zmiennej kategorialnej podaj liczebność i procent każdej kategorii. Hughes i in. (2022) proponują inkluzywne sformułowania pytań demograficznych i kategorii odpowiedzi, m.in. dla tożsamości płciowej i płci przypisanej przy urodzeniu. Praktyczne rozwiązania dla ankiety opisuje hasło pytania o płeć i wiek w ankiecie. W przykładzie kobiety stanowiły 72.6% próby (n = 231), mężczyźni 23.9% (n = 76), 8 osób (2.5%) wybrało odpowiedź „inna”, a 3 (0.9%) – „wolę nie odpowiadać”.
Nie pomijaj małych kategorii w opisie i nie usuwaj tych osób z próby tylko dlatego, że jest ich niewiele. Jeśli analizy porównują kobiety i mężczyzn, napisz wprost, że osoby z pozostałych kategorii (8 i 3 osoby) nie weszły do tego porównania, ale uwzględniono je w pozostałych analizach. Call i in. (2023) zwracają uwagę, że decyzje o zbieraniu, łączeniu i raportowaniu danych demograficznych mają konsekwencje etyczne: mogą utrwalać stereotypy albo pomijać grupy mniejszościowe. Dlatego każdą decyzję o łączeniu kategorii warto uzasadnić.
Procent od czego? To pytanie pojawia się przy każdej zmiennej z brakami. W przykładzie 6 osób (1.9%) nie odpowiedziało na pytanie o miejsce zamieszkania. Wieś wskazało 86 osób, czyli 27.0% całej próby albo 27.6% osób, które odpowiedziały. Oba zapisy są poprawne, jeśli jasno określisz mianownik. Najprościej podać liczbę braków jako osobny wiersz i procenty od całej próby albo dopisać w uwadze pod tabelą, od czego liczono procenty.
Łączenie kategorii. Pięć kategorii miejsca zamieszkania (od wsi po miasto powyżej 500 tys.) dało grupy liczące od 26 do 101 osób. Jeśli miejsce zamieszkania nie jest kluczowe dla pytania, możesz połączyć je w trzy kategorie: wieś (86 osób, 27.6%), miasto do 100 tys. (77 osób, 24.7%) i miasto powyżej 100 tys. (149 osób, 47.8%). Łącz według treści (wielkość miejscowości), a nie według tego, co daje równe grupy, i zrób to przed testowaniem hipotez.
Jeżeli udział respondentów w badaniu zakończył się na różnych etapach (przerwane ankiety, wykluczenia), opis próby dotyczy próby analizowanej. Liczbę osób na każdym etapie podaj w procedurze albo na schemacie przepływu. Jak dojść do próby analitycznej od surowego eksportu, pokazuje wpis o analizie ankiety do pracy dyplomowej, a sposób postępowania z brakami – hasło braki danych.
Porównanie próby z populacją
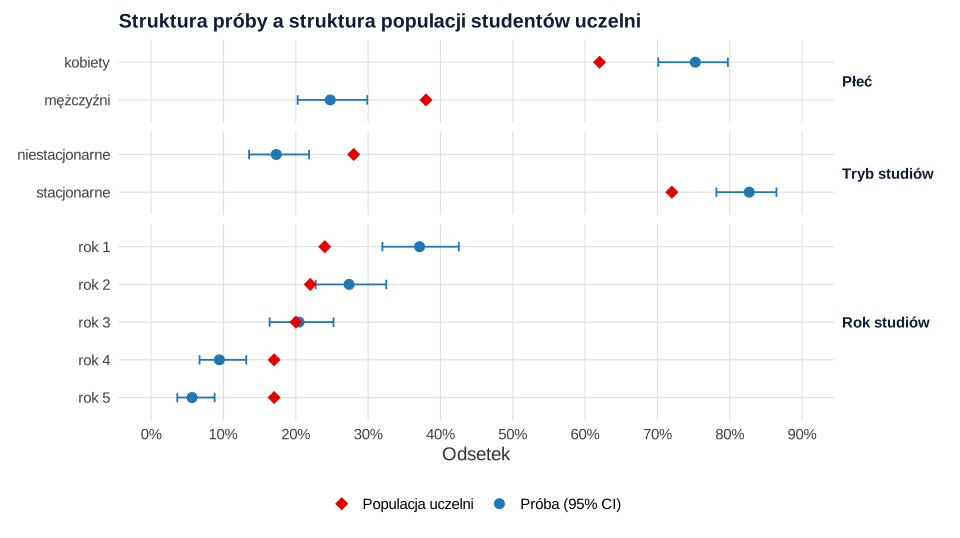
Najmocniejszy argument w dyskusji o zasięgu wniosków to porównanie struktury próby z danymi o populacji. W pracy o studentach jednej uczelni źródłem mogą być oficjalne dane uczelni o liczbie studentów według płci, trybu i roku. W badaniach dorosłych sięga się po statystykę publiczną. Podaj źródło i rok tych danych. W przykładzie przyjęto następującą strukturę populacji fikcyjnej uczelni: 62% kobiet, 28% osób studiujących niestacjonarnie, a na kolejnych latach studiów odpowiednio 24%, 22%, 20%, 17% i 17% studentów.
Do porównania wystarczą trzy elementy:
- Odsetek w próbie z przedziałem ufności i odsetek w populacji. Kobiety stanowiły 75.24% osób, które wybrały kategorię „kobieta” lub „mężczyzna”, 95% CI [70.12, 79.74], wobec 62% w populacji. Studentów niestacjonarnych było 17.30%, 95% CI [13.54, 21.84], wobec 28%. Przedział ufności dla proporcji omawia hasło przedział ufności dla proporcji.
- Różnica w punktach procentowych i jej standaryzowana wielkość. Nadreprezentacja kobiet wyniosła 13.24 punktu procentowego, a niedoreprezentacja studentów niestacjonarnych 10.70 punktu. Dla proporcji standaryzowaną różnicę można wyrazić współczynnikiem h Cohena: h = 0.29 dla kobiet i h = −0.26 dla studentów niestacjonarnych. Najsilniej niedoreprezentowany był piąty rok studiów: 5.66% w próbie wobec 17% w populacji, h = −0.37. Austin (2009) opisuje standaryzowane różnice jako podstawowe narzędzie porównywania rozkładów cech między grupami, zarówno dla średnich, jak i dla odsetków (zob. standaryzowana różnica średnich).
- Test zgodności, jeśli chcesz. Test chi-kwadrat zgodności potwierdził różnice we wszystkich trzech cechach: dla płci χ²(1, N = 307) = 22.86, dla trybu χ²(1, N = 318) = 18.07, dla roku studiów χ²(4, N = 318) = 61.71, wszędzie p < .001. Przy dużych próbach test wykrywa nawet nieistotne praktycznie różnice, a przy małych przeoczy duże. Dlatego wnioski opieraj na wielkości różnic, a nie na samym p.
Co z tego wynika? Próba jest przesunięta w stronę kobiet, studentów stacjonarnych i pierwszych lat studiów, czyli osób najłatwiej osiągalnych przez kanały rekrutacji. To typowy obraz próby wygodnej. Pamiętaj jednak, że zgodność z populacją w zakresie płci i trybu nie dowodzi reprezentatywności w zakresie badanej cechy. Osoby, które zgłosiły się same, mogą różnić się od pozostałych właśnie poziomem stresu. Mechanizm ten pokazuje symulacja we wpisie o rodzajach badań ankietowych.
Czy ważyć dane? Wagi poststratyfikacyjne przywracają w próbie strukturę populacji. W przykładzie odpowiedź każdej osoby studiującej niestacjonarnie liczyłaby się 1.62 raza, a stacjonarnie – 0.87 raza. Ponieważ studenci niestacjonarni mieli niższy średni stres (M = 2.96, SD = 0.65) niż stacjonarni (M = 3.23, SD = 0.77), ważona średnia stresu w całej próbie spadła z 3.18 do 3.16. Zmiana jest niewielka, bo różnica stresu między trybami jest umiarkowana, a wagi korygują wyłącznie strukturę trybu studiów. Elliott i Valliant (2017) wyjaśniają, że do prób nieprobabilistycznych nie stosuje się wnioskowania opartego na schemacie losowania, więc potrzebny jest model, np. oszacowanie pseudo-prawdopodobieństw udziału. Ważenie koryguje przy tym tylko te cechy, które do modelu wprowadzono. W pracy dyplomowej zwykle wystarczy porównanie z populacją i ostrożny opis ograniczeń. Ważenie stosuj wtedy, gdy celem jest oszacowanie populacyjne.
Cechy próby a interpretacja wyników
Opis próby nie kończy się na tabeli. Zanim przejdziesz do hipotez, sprawdź, czy cechy próby mogą wpływać na wyniki główne. W przykładzie studenci niestacjonarni byli starsi i mieli niższy średni stres niż stacjonarni. Jeśli w badaniu porównujesz grupy, które różnią się trybem studiów, różnica w stresie może częściowo wynikać właśnie z trybu, a nie z cechy, którą badasz. Taka zmienna działa jak zmienna zakłócająca. Możesz ją uwzględnić w analizie jako zmienną kontrolną, o ile planujesz to przed analizą i uzasadniasz teoretycznie.
Z drugiej strony, nie dodawaj do modelu każdej cechy z metryczki „na wszelki wypadek”. Zmienne kontrolne wybieraj na podstawie wiedzy o tym, co może wiązać się zarówno z predyktorem, jak i z wynikiem, a nie na podstawie tego, która z nich „wyszła” istotna w porównaniu grup. Wynik i decyzję opisz w metodzie, a ograniczenia związane ze składem próby – w dyskusji.
Zwróć też uwagę na prywatność. W małych próbach i w nielicznych podgrupach rzadkie połączenia cech (wiek, kierunek, rok, miejsce zamieszkania) mogą wskazać konkretną osobę. Dotyczy to zwłaszcza badań w jednej organizacji lub na jednym roku studiów. Łącz kategorie tak, by żadna nie liczyła jednej czy dwóch osób, i nie publikuj surowych danych demograficznych bez anonimizacji.
Gdzie umieścić opis próby w pracy
W układzie APA charakterystyka próby trafia do podrozdziału „Uczestnicy” w metodzie, a nie do wyników. Typowa kolejność wygląda tak:
- populacja i kryteria włączenia oraz wyłączenia;
- sposób doboru i rekrutacji (gdzie, kiedy, jakimi kanałami; zob. dobór celowy, wygodny i kula śnieżna);
- przepływ uczestników: ilu zaproszono lub ilu rozpoczęło, ilu wykluczono i dlaczego, ilu analizowano;
- charakterystyka próby analizowanej: zdanie lub dwa w tekście i tabela, jeśli cech jest więcej niż trzy–cztery;
- porównanie z populacją lub między grupami, jeśli je wykonano.
Nie powtarzaj w tekście wszystkich liczb z tabeli. W tekście podaj najważniejsze: liczebność, wiek, płeć i cechy kluczowe dla pytania. Resztę zostaw w tabeli. Układ całego rozdziału metodologicznego omawia wpis rozdział metodologiczny – jak go napisać.
W badaniach z kilkoma grupami (np. grupa kliniczna i kontrolna) opisz każdą grupę w osobnej kolumnie i pokaż standaryzowane różnice, zamiast testować każdą cechę. W badaniach z losowym przydziałem testy różnic wyjściowych są zbędne. Wzory takich tabel, w tym tabelę dla badania z dwoma pomiarami, znajdziesz we wpisie z gotowymi tabelami, do którego odsyłamy na początku. Jeśli nie masz pewności, jak opisać nietypową próbę albo jak porównać ją z populacją, możesz skorzystać z konsultacji statystycznej dla studentów – z wyjaśnieniem każdej decyzji, którą potem obronisz samodzielnie.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Pobierz plik jak-opisac-charakterystyke-proby-dane.csv (318 osób, dane symulowane), zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – przepisy 2 i 3 korzystają z ramki proba wczytanej w przepisie 1. Struktura populacji w przepisie 3 to wartości przyjęte w przykładzie; zastąp je danymi o swojej populacji.
1. Wiek: miary opisowe i przedziały
R
proba <- read.csv("jak-opisac-charakterystyke-proby-dane.csv", encoding = "UTF-8", na.strings = "")
nrow(proba)
w <- proba$wiek
round(c(M = mean(w), SD = sd(w), Mdn = median(w), Q1 = unname(quantile(w, .25)), Q3 = unname(quantile(w, .75)),
        min = min(w), max = max(w), skosnosc = psych::skew(w)), 2)
round(c(M_minus_SD = mean(w) - sd(w), M_plus_SD = mean(w) + sd(w)), 1)
round(100 * mean(w >= 30), 1)                                # odsetek osób w wieku 30+
# Wiek w podgrupach trybu studiów
aggregate(wiek ~ tryb, proba, function(x) round(c(n = length(x), M = mean(x), SD = sd(x), Mdn = median(x)), 1))

# Trzy sposoby pogrupowania wieku
table(cut(w, c(17, 21, 24, 29, Inf), labels = c("18–21", "22–24", "25–29", "30+")))
table(cut(w, quantile(w, 0:3 / 3), include.lowest = TRUE))   # tercyle – granice zależą od próby
table(cut(w, seq(15, 55, 10), right = FALSE))                # równe przedziały 10-letnie
Wynik w R
[1] 318
       M       SD      Mdn       Q1       Q3      min      max skosnosc
   22.73     4.07    22.00    21.00    23.00    19.00    54.00     3.49
M_minus_SD  M_plus_SD
      18.7       26.8
[1] 4.7
            tryb wiek.n wiek.M wiek.SD wiek.Mdn
1 niestacjonarne   55.0   28.6     6.5     27.0
2    stacjonarne  263.0   21.5     1.6     21.0

18–21 22–24 25–29   30+
  145   123    35    15

[19,21] (21,23] (23,54]
    145      98      75

[15,25) [25,35) [35,45) [45,55)
    268      42       7       1
2. Zmienne kategorialne, braki i łączenie kategorii
R
proc <- function(x, mianownik_z_brakami = FALSE) {
  t <- table(x, useNA = if (mianownik_z_brakami) "ifany" else "no")
  cbind(n = t, proc = round(100 * prop.table(t), 1))
}
proba$miejsce <- factor(proba$miejsce, levels = c("wieś", "miasto do 20 tys.", "miasto 20–100 tys.",
                                                  "miasto 100–500 tys.", "miasto powyżej 500 tys."))
proc(proba$plec)
proc(proba$rok)
proc(proba$miejsce, mianownik_z_brakami = TRUE)              # procent od całej próby (z brakami)
proc(proba$miejsce)                                          # procent od osób, które odpowiedziały
# Scalenie małych i bliskich kategorii miejsca zamieszkania
m3 <- ifelse(proba$miejsce == "wieś", "wieś",
             ifelse(proba$miejsce %in% c("miasto do 20 tys.", "miasto 20–100 tys."), "miasto do 100 tys.", "miasto powyżej 100 tys."))
proc(factor(m3, levels = c("wieś", "miasto do 100 tys.", "miasto powyżej 100 tys.")))
Wynik w R
                      n proc
Inna                  8  2.5
Kobieta             231 72.6
Mężczyzna            76 23.9
Wolę nie odpowiadać   3  0.9
    n proc
1 118 37.1
2  87 27.4
3  65 20.4
4  30  9.4
5  18  5.7
                          n proc
wieś                     86 27.0
miasto do 20 tys.        26  8.2
miasto 20–100 tys.       51 16.0
miasto 100–500 tys.     101 31.8
miasto powyżej 500 tys.  48 15.1
<NA>                      6  1.9
                          n proc
wieś                     86 27.6
miasto do 20 tys.        26  8.3
miasto 20–100 tys.       51 16.3
miasto 100–500 tys.     101 32.4
miasto powyżej 500 tys.  48 15.4
                          n proc
wieś                     86 27.6
miasto do 100 tys.       77 24.7
miasto powyżej 100 tys. 149 47.8
3. Porównanie z populacją i wagi poststratyfikacyjne
R
# Porównanie z populacją: struktura studentów uczelni (wartości przyjęte w przykładzie)
pop <- list(plec = c(Kobieta = .62, "Mężczyzna" = .38),
            tryb = c(niestacjonarne = .28, stacjonarne = .72),
            rok  = c("1" = .24, "2" = .22, "3" = .20, "4" = .17, "5" = .17))
porownaj <- function(x, p0) {
  x <- x[x %in% names(p0)]; t <- table(factor(x, levels = names(p0))); n <- sum(t)
  ci <- t(sapply(t, function(k) prop.test(k, n, correct = FALSE)$conf.int))
  gof <- chisq.test(t, p = p0)
  list(tabela = round(cbind(n = t, proba = 100 * t / n, CI_dolna = 100 * ci[, 1], CI_gorna = 100 * ci[, 2],
                            populacja = 100 * p0, roznica_pp = 100 * (t / n - p0),
                            h_Cohena = 2 * asin(sqrt(t / n)) - 2 * asin(sqrt(p0))), 2),
       test = round(c(N = n, chi2 = unname(gof$statistic), df = unname(gof$parameter), p = gof$p.value), 3))
}
porownaj(proba$plec, pop$plec)
porownaj(proba$tryb, pop$tryb)
porownaj(as.character(proba$rok), pop$rok)

# Czy nadreprezentacja studentów stacjonarnych zmienia wynik? Średni stres bez wag i z wagami trybu
tp <- prop.table(table(proba$tryb))
proba$waga <- pop$tryb[proba$tryb] / tp[proba$tryb]
round(c(waga_niestacjonarne = unname(pop$tryb["niestacjonarne"] / tp["niestacjonarne"]),
        waga_stacjonarne = unname(pop$tryb["stacjonarne"] / tp["stacjonarne"])), 2)
aggregate(stres ~ tryb, proba, function(x) round(c(M = mean(x), SD = sd(x)), 2))
round(c(M_bez_wag = mean(proba$stres), M_z_wagami = weighted.mean(proba$stres, proba$waga)), 2)
Wynik w R
$tabela
            n proba CI_dolna CI_gorna populacja roznica_pp h_Cohena
Kobieta   231 75.24    70.12    79.74        62      13.24     0.29
Mężczyzna  76 24.76    20.26    29.88        38     -13.24    -0.29

$test
      N    chi2      df       p
307.000  22.857   1.000   0.000

$tabela
                 n proba CI_dolna CI_gorna populacja roznica_pp h_Cohena
niestacjonarne  55  17.3    13.54    21.84        28      -10.7    -0.26
stacjonarne    263  82.7    78.16    86.46        72       10.7     0.26

$test
      N    chi2      df       p
318.000  18.074   1.000   0.000

$tabela
    n proba CI_dolna CI_gorna populacja roznica_pp h_Cohena
1 118 37.11    31.98    42.54        24      13.11     0.29
2  87 27.36    22.75    32.51        22       5.36     0.12
3  65 20.44    16.37    25.21        20       0.44     0.01
4  30  9.43     6.69    13.15        17      -7.57    -0.23
5  18  5.66     3.61     8.77        17     -11.34    -0.37

$test
      N    chi2      df       p
318.000  61.705   4.000   0.000

waga_niestacjonarne    waga_stacjonarne
               1.62                0.87
            tryb stres.M stres.SD
1 niestacjonarne    2.96     0.65
2    stacjonarne    3.23     0.77
 M_bez_wag M_z_wagami
      3.18       3.16
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; skośność obliczono w pakiecie psych, a rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w opisie charakterystyki próby
- Opis próby przed wykluczeniami. Charakterystyka ma dotyczyć osób, których dane analizowano. Jeśli opisujesz wszystkich, którzy otworzyli ankietę, liczby w opisie nie zgadzają się z liczebnościami w wynikach.
- Średnia i SD przy silnie skośnym wieku. Gdy przedział „średnia ± SD” wychodzi poza zakres danych, dodaj medianę z IQR i zakres.
- Błąd standardowy zamiast odchylenia standardowego. SE opisuje precyzję oszacowania średniej, a nie zróżnicowanie uczestników.
- Procenty bez mianownika. Przy brakach danych napisz, czy procenty liczono od całej próby, czy od osób, które odpowiedziały. Procenty w kategorii muszą sumować się do 100 (z dokładnością do zaokrągleń).
- Przedziały wieku dopasowane do danych. Tercyle czy „równe grupy” zmieniają się z badania na badanie. Ustal granice merytorycznie i przed analizą.
- Pomijanie osób z małych kategorii. Osoby, które wybrały „inna” lub „wolę nie odpowiadać”, opisz zawsze, nawet jeśli nie wchodzą do porównań grup.
- „Próba była reprezentatywna, bo odsetek kobiet był podobny jak w populacji”. Zgodność kilku cech demograficznych nie gwarantuje zgodności w badanej cesze. Napisz, w jakich cechach próbę porównano i z jakim wynikiem.
- Testy istotności dla każdej cechy w tabeli porównującej grupy z losowym przydziałem. Przy losowaniu różnice wyjściowe są z definicji przypadkowe. Pokaż wielkość różnic i ewentualnie uwzględnij ważne zmienne w analizie głównej.
- Zbyt szczegółowe dane w małych próbach. Połączenie rzadkich cech (np. wiek 54 lata, studia niestacjonarne, piąty rok, mała miejscowość) może wskazać konkretną osobę. Łącz kategorie i nie podawaj wartości skrajnych, jeśli nie są potrzebne.
Najczęstsze pytania
Jakie dane demograficzne podać w opisie próby badawczej?
Zawsze liczebność analizowanej próby, wiek oraz płeć lub tożsamość płciową, a do tego cechy określające populację (np. kierunek, rok i tryb studiów) i cechy, które mogą wiązać się z wynikiem. Cech, których nie wykorzystujesz w analizie ani interpretacji, lepiej w ogóle nie zbierać.
Czy wiek uczestników opisać średnią czy medianą?
Gdy rozkład wieku jest zbliżony do symetrycznego, wystarczą średnia i odchylenie standardowe z zakresem. Gdy jest wyraźnie skośny – typowe w próbach studenckich z osobami studiującymi zaocznie – podaj medianę z rozstępem ćwiartkowym i zakres, a średnią z SD możesz dodać obok.
Jak porównać strukturę próby ze strukturą populacji?
Zestaw odsetki w próbie (z 95% przedziałami ufności) z odsetkami z oficjalnych danych o populacji, podaj różnice w punktach procentowych i ich standaryzowaną wielkość, np. h Cohena. Test chi-kwadrat zgodności możesz dodać, ale wnioski opieraj na wielkości różnic, bo przy dużej próbie istotne wychodzą nawet drobne rozbieżności.
Od czego liczyć procenty w opisie próby, gdy są braki danych?
Możesz liczyć od całej próby (wtedy braki to osobny wiersz) albo od osób, które odpowiedziały na pytanie – ważne, by jasno napisać, który mianownik zastosowano, np. w uwadze pod tabelą. Nie mieszaj obu sposobów w jednej tabeli bez wyjaśnienia.
Co zrobić z osobami, które w pytaniu o płeć wybrały „wolę nie odpowiadać”?
Opisz je w charakterystyce próby z liczebnością i procentem i zostaw w analizach, które nie wymagają tej zmiennej. Jeżeli porównujesz kobiety i mężczyzn, napisz wprost, ile osób z pozostałych kategorii nie weszło do tego porównania.
Powiązane hasła
Przeczytaj też
Badanie na studentach i ankieta na zajęciach
Co wolno wnioskować z próby studenckiej, wąski zakres zmiennych, grupy ćwiczeniowe jako skupienia, symulacje w R i zdania do Metody.
Czytaj →PoradnikMetryczka: jak zakodować wiek, staż i wykształcenie
Liczba czy przedział, czyszczenie wpisów „50 lat” i „1988”, spójność wieku i stażu, kwartyle a progi, wykształcenie w analizie i Tabela 1.
Czytaj →PoradnikŁączenie kategorii odpowiedzi – kiedy i jak
Likert 5 na 3, „nie wiem”, małe kategorie metryczki, łączenie pod wynik w symulacji i alternatywy: test Fishera, trend, regresja porządkowa – z kodem R.
Czytaj →PoradnikWzór charakterystyki próby
Gotowe tabele APA i akapity do podrozdziału „Uczestnicy” dla ankiety, dwóch grup, eksperymentu i badania z dwoma pomiarami – z plikiem .docx.
Czytaj →PoradnikRodzaje badań ankietowych
Czas, dobór, kanał i cel badania ankietowego oraz ich konsekwencje dla wniosków – z symulacją autoselekcji w R i wzorem opisu schematu.
Czytaj →PoradnikStatystyki opisowe w pracy
Co policzyć dla jakiej zmiennej, jak zbudować tabelę APA, ile miejsc po przecinku podać, jak pokazać braki danych i które wykresy wybrać – na jednym przykładzie z R.
Czytaj →Nie wiesz, jak opisać swoją próbę?
Pomożemy dobrać miary i kategorie, porównać próbę z populacją i wyjaśnić, jakie wnioski z tego wynikają, tak abyś umiał(a) uzasadnić każdą decyzję.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903 ● Otwarty dostęp
- American Psychological Association. (b.d.). APA Style Journal Article Reporting Standards (APA Style JARS). APA Style. Pobrano 15 października 2026 z https://apastyle.apa.org/jars ● Otwarty dostęp
- Andrade, C. (2021). The inconvenient truth about convenience and purposive samples. Indian Journal of Psychological Medicine, 43(1), 86–88. https://doi.org/10.1177/0253717620977000 ● Otwarty dostęp
- Austin, P. C. (2009). Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples. Statistics in Medicine, 28(25), 3083–3107. https://doi.org/10.1002/sim.3697 ● Otwarty dostęp
- Call, C. C., Eckstrand, K. L., Kasparek, S. W., Boness, C. L., Blatt, L., Jamal-Orozco, N., Novacek, D. M., Foti, D., & Scholars for Elevating Equity and Diversity (SEED). (2023). An ethics and social-justice approach to collecting and using demographic data for psychological researchers. Perspectives on Psychological Science, 18(5), 979–995. https://doi.org/10.1177/17456916221137350 ● Otwarty dostęp: pełny tekst
- Elliott, M. R., & Valliant, R. (2017). Inference for nonprobability samples. Statistical Science, 32(2), 249–264. https://doi.org/10.1214/16-sts598 ● Otwarty dostęp
- Hayes-Larson, E., Kezios, K. L., Mooney, S. J., & Lovasi, G. (2019). Who is in this study, anyway? Guidelines for a useful Table 1. Journal of Clinical Epidemiology, 114, 125–132. https://doi.org/10.1016/j.jclinepi.2019.06.011 ● Otwarty dostęp: pełny tekst
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/s0140525x0999152x
- Hughes, J. L., Camden, A. A., Yangchen, T., Smith, G. P. A., Domenech Rodríguez, M. M., Rouse, S. V., McDonald, C. P., & Lopez, S. (2022). Guidance for researchers when using inclusive demographic questions for surveys: Improved and updated questions. Psi Chi Journal of Psychological Research, 27(4), 232–255. https://doi.org/10.24839/2325-7342.JN27.4.232 ● Otwarty dostęp
- Rad, M. S., Martingano, A. J., & Ginges, J. (2018). Toward a psychology of Homo sapiens: Making psychological science more representative of the human population. Proceedings of the National Academy of Sciences, 115(45), 11401–11405. https://doi.org/10.1073/pnas.1721165115 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{altman2005standard, author={Altman, Douglas G. and Bland, J. Martin}, title={{Standard deviations and standard errors}}, journal={BMJ}, year={2005}, volume={331}, number={7521}, pages={903}, doi={10.1136/bmj.331.7521.903}}@misc{apandjars, author={{American Psychological Association}}, title={{APA Style Journal Article Reporting Standards (APA Style JARS)}}, howpublished={APA Style}, publisher={American Psychological Association}, url={https://apastyle.apa.org/jars}}@article{andrade2021inconvenient, author={Andrade, Chittaranjan}, title={{The inconvenient truth about convenience and purposive samples}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={1}, pages={86--88}, doi={10.1177/0253717620977000}}@article{austin2009balance, author={Austin, Peter C.}, title={{Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={25}, pages={3083--3107}, doi={10.1002/sim.3697}}@article{call2023ethics, author={Call, Christine C. and Eckstrand, Kristen L. and Kasparek, Steven W. and Boness, Cassandra L. and Blatt, Lorraine and Jamal-Orozco, Nabila and Novacek, Derek M. and Foti, Dan and {Scholars for Elevating Equity and Diversity (SEED)}}, title={{An ethics and social-justice approach to collecting and using demographic data for psychological researchers}}, journal={Perspectives on Psychological Science}, year={2023}, volume={18}, number={5}, pages={979--995}, doi={10.1177/17456916221137350}}@article{elliott2017inference, author={Elliott, Michael R. and Valliant, Richard}, title={{Inference for nonprobability samples}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={249--264}, doi={10.1214/16-sts598}}@article{hayeslarson2019who, author={Hayes-Larson, Eleanor and Kezios, Katrina L. and Mooney, Stephen J. and Lovasi, Gina}, title={{Who is in this study, anyway? Guidelines for a useful Table 1}}, journal={Journal of Clinical Epidemiology}, year={2019}, volume={114}, pages={125--132}, doi={10.1016/j.jclinepi.2019.06.011}}@article{henrich2010weirdest, author={Henrich, Joseph and Heine, Steven J. and Norenzayan, Ara}, title={{The weirdest people in the world?}}, journal={Behavioral and Brain Sciences}, year={2010}, volume={33}, number={2–3}, pages={61--83}, doi={10.1017/s0140525x0999152x}}@article{hughes2022guidance, author={Hughes, Jennifer L. and Camden, Abigail A. and Yangchen, Tenzin and Smith, Gabrielle P. A. and Domenech Rodríguez, Melanie M. and Rouse, Steven V. and McDonald, C. Peeper and Lopez, Stella}, title={{Guidance for researchers when using inclusive demographic questions for surveys: Improved and updated questions}}, journal={Psi Chi Journal of Psychological Research}, year={2022}, volume={27}, number={4}, pages={232--255}, doi={10.24839/2325-7342.jn27.4.232}}@article{rad2018toward, author={Rad, Mostafa Salari and Martingano, Alison Jane and Ginges, Jeremy}, title={{Toward a psychology of Homo sapiens: Making psychological science more representative of the human population}}, journal={Proceedings of the National Academy of Sciences}, year={2018}, volume={115}, number={45}, pages={11401--11405}, doi={10.1073/pnas.1721165115}}