Co to jest schemat przekrojowy?
Schemat przekrojowy (badanie przekrojowe, ang. cross-sectional design) to plan badania, w którym wszystkie zmienne mierzy się u każdej osoby jeden raz, w tym samym okresie. Badacz robi „zdjęcie” populacji w danym momencie: zbiera ankietę, test lub wywiad i na tym kończy kontakt z uczestnikiem. Setia (2016) podkreśla, że w takim badaniu ekspozycję i wynik ocenia się jednocześnie, a uczestników dobiera się tylko według kryteriów włączenia i wyłączenia, a nie według tego, czy doświadczyli danego czynnika.
W psychologii to najczęstszy schemat prac licencjackich i magisterskich. Typowe przykłady to ankieta o stresie i wsparciu społecznym wśród studentów albo pomiar objawów depresji i czasu spędzanego w mediach społecznościowych. Do tej grupy należy też porównanie poziomu lęku u osób w różnym wieku zbadanych w jednym miesiącu.
Warto rozdzielić dwie osie opisu planu badania. Oś czasu mówi, ile razy mierzymy te same osoby: raz w schemacie przekrojowym, wielokrotnie w schemacie podłużnym. Oś kontroli mówi, czy badacz manipuluje zmienną niezależną, jak w schemacie eksperymentalnym, czy tylko ją mierzy, jak w schemacie korelacyjnym i obserwacyjnym. Większość badań przekrojowych w psychologii jest jednocześnie korelacyjna, ale te pojęcia nie są synonimami. Eksperyment z jednym pomiarem po manipulacji też ma przekrojową strukturę czasu.
Do czego badanie przekrojowe nadaje się dobrze
Wang i Cheng (2020) wymieniają trzy główne zastosowania badań przekrojowych: szacowanie rozpowszechnienia, opis cech populacji i badanie uwarunkowań, czyli zmiennych współwystępujących z wynikiem. Dochodzą do tego niski koszt, szybka realizacja i przydatność jako wstęp do droższego badania podłużnego. W praktyce schemat przekrojowy dobrze odpowiada na pytania typu:
| Pytanie badawcze | Czy wystarczy jeden pomiar? | Dlaczego |
|---|---|---|
| Jaki odsetek studentów ma wysoki poziom lęku? | Tak | Rozpowszechnienie w danym momencie |
| Czy kobiety i mężczyźni różnią się poziomem wypalenia? | Tak, jako opis różnicy | Porównanie grup wyróżnionych w jednym pomiarze |
| Czy wsparcie społeczne współwystępuje z mniejszym stresem? | Tak, jako opis związku | Korelacja lub regresja w jednym momencie |
| Czy stres prowadzi do bezsenności, czy odwrotnie? | Nie | Brak kolejności w czasie |
| Jak zmienia się pamięć z wiekiem u tej samej osoby? | Nie | Różnice między osobami to nie zmiana w osobie |
| Czy samoocena pośredniczy między krytyką a depresją? | Zwykle nie | Mediacja to proces rozciągnięty w czasie |
Trzy pułapki jednego pomiaru
Brak kolejności w czasie. Gdy dwie zmienne zmierzono w tym samym kwestionariuszu, dane nie mówią, która była pierwsza. Związek wsparcia społecznego z depresją może wynikać z tego, że wsparcie chroni przed objawami. Może też być tak, że osoby z depresją wycofują się z kontaktów i gorzej oceniają pomoc innych. Statystycznie oba scenariusze dają tę samą korelację.
Różnice między osobami to nie zmiana w osobie. Porównanie 25-latków z 65-latkami mówi, czym różnią się te grupy dziś. Nie mówi, jak zmieni się 25-latek za 40 lat, bo grupy wieku są jednocześnie różnymi kohortami: dorastały w innych szkołach i w innym świecie technologii. Wiek i rok urodzenia są w badaniu przekrojowym nierozdzielne – to klasyczna zmienna zakłócająca wbudowana w sam schemat.
Obciążona mediacja. Maxwell i Cole (2007) pokazali, że przekrojowe analizy mediacji procesów rozwijających się w czasie dają zwykle wyraźnie obciążone oszacowania. Dzieje się tak nawet w idealnych warunkach pełnej mediacji. Przekrojowe oszacowania efektu bezpośredniego, pośredniego i odsetka mediacji często poważnie wprowadzają w błąd. Jeśli pytanie dotyczy mechanizmu, czyli mediacji, schemat przekrojowy jest najsłabszym możliwym wyborem.
Rohrer (2018) zwraca uwagę, że wnioski przyczynowe z danych obserwacyjnych zawsze zależą od założeń o strukturze przyczynowej. Dlatego w badaniu przekrojowym te założenia trzeba wypowiedzieć wprost, a nie ukrywać za słowem „związek”. Dodanie zmiennych kontrolnych tego problemu nie usuwa: kontrolowanie zmiennych z tego samego pomiaru nie odtworzy kolejności zdarzeń.
Przykład: wiek a pamięć robocza w jednym pomiarze
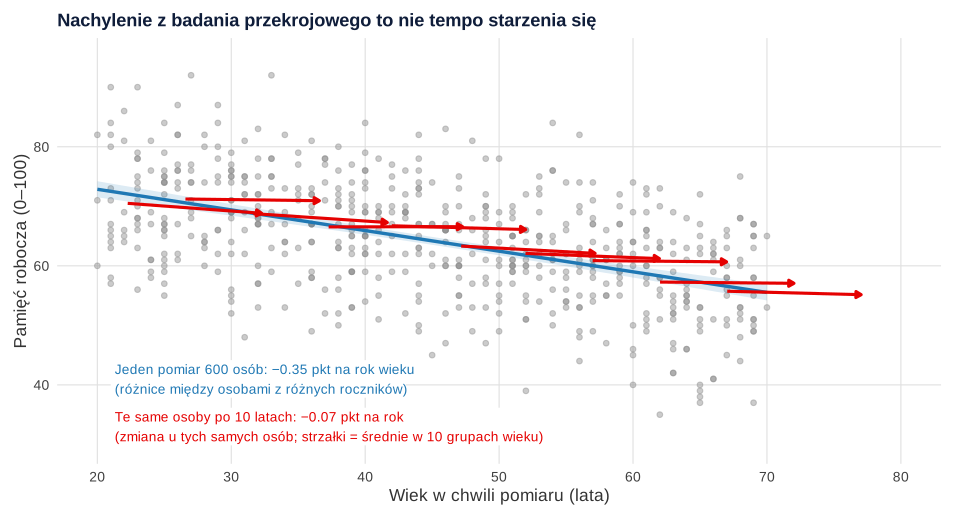
W symulowanym badaniu przekrojowym 600 dorosłych w wieku 20–69 lat wykonało test pamięci roboczej (0–100). W populacji, z której pochodzą dane, działały dwa procesy: rzeczywiste starzenie się (−0.10 pkt na każdy rok życia u tej samej osoby) i efekt kohorty (+0.25 pkt na każdy rok późniejszego urodzenia, np. dzięki dłuższej edukacji). Badacz widzi tylko jeden pomiar.
- Rozpowszechnienie: wynik poniżej 50 pkt miało 38 osób, czyli 6.3%, 95% CI [4.6, 8.7]. Na to pytanie schemat przekrojowy odpowiada w pełni.
- Różnice między grupami wieku: średnie wynosiły 70.10 (20–34 lata), 65.66 (35–49) i 59.04 (50–69).
- Nachylenie regresji: b = −0.35 pkt na rok wieku, 95% CI [−0.39, −0.30], t(598) = −14.48, p < .001, R² = .26.
Kuszący wniosek brzmi: „z każdym rokiem pamięć słabnie o 0.35 pkt”. Jest błędny. Gdyby te same osoby zbadać ponownie po 10 latach, średnia zmiana wyniosłaby −0.07 pkt na rok, 95% CI [−0.10, −0.03]. To pięć razy mniej niż nachylenie z jednego pomiaru. Różnica wynika z tego, że nachylenie przekrojowe łączy starzenie się z różnicami między pokoleniami (rysunek 1). Jeśli pytanie dotyczy zmiany, potrzebny jest schemat podłużny. Czytelnie wyjaśnia to wpis o modelach cross-lagged, w którym różnice między osobami oddziela się od zmian w osobie.
Jak opisać schemat przekrojowy w pracy
Badania przekrojowe są jednym z trzech schematów objętych listą STROBE. Z jej 22 punktów 18 jest wspólnych dla badań kohortowych, kliniczno-kontrolnych i przekrojowych (von Elm i in., 2007). Z listy warto wziąć zwłaszcza: nazwę schematu w tytule lub metodzie, okres i miejsce zbierania danych, sposób rekrutacji i odsetek odpowiedzi oraz uzasadnienie liczebności. W rozdziale metodologicznym napisz też wprost, czego schemat nie pozwala ustalić. Pomoże w tym poradnik rozdział metodologiczny krok po kroku, a o samym opisie uczestników przeczytasz w tekście jak opisać charakterystykę próby.
W dyskusji używaj języka związku („wyższy poziom X współwystępował z…”), a nie wpływu („X obniża…”). Jeśli formułujesz hipotezę przyczynową, nazwij ją i wskaż, jakie badanie mogłoby ją sprawdzić. Wzory takich zdań znajdziesz we wpisie jak napisać dyskusję wyników.
Przykład w R
Kod tworzy dane z przykładu, szacuje odsetek niskich wyników z 95% CI, liczy średnie w grupach wieku i regresję wyniku na wiek, a na końcu dokłada hipotetyczny pomiar po 10 latach, by porównać nachylenie przekrojowe ze zmianą w osobie. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Rozpowszechnienie, różnice wieku i hipotetyczny drugi pomiar
R
# Dane symulowane: badanie przekrojowe – jeden pomiar 600 dorosłych w wieku 20–69 lat
# Wynik testu pamięci roboczej (skala 0–100). W populacji działają dwa procesy:
#   starzenie się: −0.10 pkt na rok życia (zmiana u tej samej osoby),
#   efekt kohorty: +0.25 pkt na każdy rok późniejszego urodzenia (lepsza edukacja, trening poznawczy).
set.seed(190)
n <- 600
wiek <- round(runif(n, 20, 69.99))
rok_urodzenia <- 2026 - wiek
pamiec <- 60 - 0.10 * (wiek - 20) + 0.25 * (rok_urodzenia - 1957) + rnorm(n, 0, 8)
pamiec <- pmin(pmax(round(pamiec), 0), 100)
dane <- data.frame(wiek, pamiec)

# 1. Do czego badanie przekrojowe nadaje się dobrze: rozpowszechnienie (odsetek z wynikiem < 50)
niski <- sum(dane$pamiec < 50)
c(n_niski = niski, procent = round(100 * niski / n, 1))
round(100 * as.numeric(prop.test(niski, n)$conf.int), 1)

# 2. Różnice między grupami wieku w jednym momencie
dane$grupa_wieku <- cut(dane$wiek, c(19, 34, 49, 69), labels = c("20–34", "35–49", "50–69"))
round(tapply(dane$pamiec, dane$grupa_wieku, mean), 2)
model_przekr <- lm(pamiec ~ wiek, data = dane)
round(summary(model_przekr)$coefficients, 3)
round(confint(model_przekr)["wiek", ], 3)
round(summary(model_przekr)$r.squared, 3)

# 3. Czego badanie przekrojowe nie pokaże: zmiana u tych samych osób.
# Te same osoby zbadane ponownie po 10 latach (hipotetyczne przedłużenie badania):
# u każdej osoby działa tylko starzenie się (−0.10 pkt na rok) plus losowe wahania wyniku
pamiec_po10 <- pmin(pmax(round(dane$pamiec - 0.10 * 10 + rnorm(n, 0, 4)), 0), 100)
zmiana_na_rok <- (pamiec_po10 - dane$pamiec) / 10
round(c(srednia_zmiana_na_rok = mean(zmiana_na_rok), se = sd(zmiana_na_rok) / sqrt(n)), 3)
round(as.numeric(t.test(zmiana_na_rok)$conf.int), 3)
Wynik w R
n_niski procent
   38.0     6.3
[1] 4.6 8.7
20–34 35–49 50–69
70.10 65.66 59.04
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   79.785      1.133  70.448        0
wiek          -0.347      0.024 -14.484        0
 2.5 % 97.5 %
-0.394 -0.300
[1] 0.26
srednia_zmiana_na_rok                    se
               -0.068                 0.017
[1] -0.102 -0.034
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Język przyczynowy w tytule i wnioskach („wpływ wsparcia na depresję”) przy jednym pomiarze. Opisuj związek albo wprost nazwij założenia, przy których wniosek przyczynowy byłby uprawniony.
- Interpretowanie różnic między grupami wieku jako rozwoju lub starzenia się. Przekrój miesza wiek z kohortą, a przykład pokazuje, jak bardzo może to zawyżyć tempo zmian.
- Mediacja „udowodniona” na danych z jednego kwestionariusza. Istotny efekt pośredni w danych przekrojowych nie pokazuje, że proces przebiega w założonej kolejności (Maxwell i Cole, 2007).
- Utożsamianie „przekrojowy” z „reprezentatywny”. Schemat określa liczbę pomiarów, a nie sposób doboru osób. Badanie przekrojowe na próbie wygodnej opisuje tylko tę próbę, a uogólnienie wymaga próby losowej albo mocnych założeń.
- Pominięcie wspólnej metody pomiaru. Gdy wszystkie zmienne pochodzą z samoopisu w jednej ankiecie, część korelacji może wynikać z wspólnej wariancji metody, a nie z relacji między konstruktami.
- Brak daty i kontekstu zbierania danych. Wynik przekrojowy dotyczy konkretnego momentu, np. sesji egzaminacyjnej albo okresu pandemii. Bez tej informacji czytelnik nie oceni, czy da się go przenieść na inny czas.
Najczęstsze pytania
Czym różni się badanie przekrojowe od podłużnego?
W badaniu przekrojowym każdą osobę mierzy się raz, a w podłużnym te same osoby bada się wielokrotnie. Przekrój opisuje różnice między osobami w jednym momencie, a badanie podłużne pozwala śledzić zmiany w osobie i kolejność zdarzeń. Zobacz schemat podłużny.
Czy badanie ankietowe jednorazowe to schemat przekrojowy?
Tak, jeśli wszystkie zmienne zebrano w jednym pomiarze. Ankieta wypełniona raz przez studentów o stresie, wsparciu i objawach depresji to typowe badanie przekrojowe, niezależnie od tego, czy analizujesz korelacje, regresję, czy porównania grup.
Co to jest efekt kohorty w badaniu przekrojowym?
To różnica między grupami wieku wynikająca z tego, że dorastały w innych warunkach (edukacja, technologia, kultura), a nie z samego starzenia się. W jednym pomiarze wieku i rocznika nie da się rozdzielić, więc różnice wiekowe mogą przeceniać lub zaniżać rzeczywiste zmiany rozwojowe.
Jakie są zalety badania przekrojowego?
Jest tanie i szybkie, nie wymaga utrzymania kontaktu z uczestnikami i nie traci osób w kolejnych pomiarach. Dobrze szacuje rozpowszechnienie, opisuje populację i pozwala wstępnie sprawdzić związki przed zaplanowaniem droższego badania podłużnego lub eksperymentu.
Jak nazwać ograniczenia schematu przekrojowego w pracy?
Napisz, że jednorazowy pomiar nie pozwala ustalić kierunku związków ani odróżnić zmian w osobie od różnic między osobami, a wyniki dotyczą konkretnego okresu badania. Jeśli zmienne pochodzą z samoopisu w jednej ankiecie, dodaj ryzyko wspólnej wariancji metody.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Sondaż przekrojowy – jak opisać metodę
Gotowy podrozdział „Metoda” dla ankiety w zdrowiu: STROBE, rekrutacja, odsetek odpowiedzi, braki danych, PR a OR i to, co wolno napisać we wnioskach – z przykładem w R.
Czytaj →PoradnikMediacja w danych podłużnych
Symulacja sześciu sposobów liczenia efektu pośredniego, schemat półpodłużny, CLPM i RI-CLPM w lavaan oraz wpływ odstępu między falami.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikModele cross-lagged: logika, założenia i interpretacja CLPM oraz RI-CLPM
Jak odróżnić stabilne różnice między osobami od zmiany wewnątrzosobowej, dobrać model panelowy i nie pomylić predykcji czasowej z przyczynowością.
Czytaj →PoradnikJak napisać dyskusję wyników – wzory zdań
Osiem elementów dyskusji z gotowymi zdaniami: interpretacja, wyniki nieistotne, konkretne ograniczenia, granice uogólniania, implikacje i wnioski.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Maxwell, S. E., & Cole, D. A. (2007). Bias in cross-sectional analyses of longitudinal mediation. Psychological Methods, 12(1), 23–44. https://doi.org/10.1037/1082-989x.12.1.23
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Setia, M. S. (2016). Methodology series module 3: Cross-sectional studies. Indian Journal of Dermatology, 61(3), 261–264. https://doi.org/10.4103/0019-5154.182410 ● Otwarty dostęp
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
- Wang, X., & Cheng, Z. (2020). Cross-sectional studies: Strengths, weaknesses, and recommendations. Chest, 158(1), S65–S71. https://doi.org/10.1016/j.chest.2020.03.012 ● Otwarty dostęp
Cytowania BibTeX
@article{maxwell2007bias, author={Maxwell, Scott E. and Cole, David A.}, title={{Bias in cross-sectional analyses of longitudinal mediation}}, journal={Psychological Methods}, year={2007}, volume={12}, number={1}, pages={23--44}, doi={10.1037/1082-989x.12.1.23}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{setia2016methodology, author={Setia, Maninder Singh}, title={{Methodology series module 3: Cross-sectional studies}}, journal={Indian Journal of Dermatology}, year={2016}, volume={61}, number={3}, pages={261--264}, doi={10.4103/0019-5154.182410}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}@article{wang2020cross, author={Wang, Xiaofeng and Cheng, Zhenshun}, title={{Cross-sectional studies: Strengths, weaknesses, and recommendations}}, journal={Chest}, year={2020}, volume={158}, number={1}, pages={S65--S71}, doi={10.1016/j.chest.2020.03.012}}