Co to jest schemat quasi-eksperymentalny?
Schemat quasi-eksperymentalny (quasi-eksperyment, ang. quasi-experimental design) to plan, w którym badacz wprowadza lub wykorzystuje interwencję i porównuje jej skutki z warunkiem kontrolnym, ale nie przydziela uczestników do grup losowo. Od eksperymentu różni go brak randomizacji. Od badania korelacyjnego odróżnia go to, że istnieje konkretna interwencja z jasnym początkiem, której skutki chcemy ocenić. Klasycznym podręcznikiem tej rodziny planów jest książka Shadisha, Cooka i Campbella (2002).
Quasi-eksperymenty pojawiają się tam, gdzie losowanie jest niemożliwe, nieetyczne albo zbyt kosztowne. Program profilaktyczny trafia do całej szkoły, nowa procedura obejmuje cały oddział szpitala, a kurs przygotowawczy wybierają sami studenci. Harris i in. (2006) opisują quasi-eksperymenty jako najczęściej nierandomizowane badania „przed i po” interwencji. Proponują też hierarchię takich planów: im wyżej w niej plan, tym mocniejsze dowody na związek przyczynowy.
Rodzaje planów quasi-eksperymentalnych
| Plan | Struktura | Główne zagrożenie |
|---|---|---|
| Jedna grupa: pretest – interwencja – posttest | O X O | Wszystko, co zmienia się w czasie: regresja do średniej, dojrzewanie, wydarzenia zewnętrzne |
| Grupy nierównoważne z pretestem i posttestem | O X O O O | Selekcja: grupy różnią się na starcie i mogą zmieniać się w innym tempie |
| Przerwane szeregi czasowe | O O O O X O O O O | Zdarzenie zbiegające się w czasie z interwencją |
| Szeregi czasowe z grupą porównawczą | jak wyżej + grupa bez interwencji | Różne trendy w obu grupach |
| Nieciągłość regresji (regression discontinuity) | przydział według progu w zmiennej wyjściowej | Błędna postać zależności w pobliżu progu |
Najsłabszy jest plan z jedną grupą. Po zakwalifikowaniu do programu osób z najwyższym stresem ich wyniki obniżą się częściowo same. Barnett i in. (2005) wyjaśniają, że po nietypowo wysokich pomiarach następują zwykle wartości bliższe średniej, a efekt ten jest tym silniejszy, im większy błąd pomiaru. Dlatego grupa porównawcza, nawet nielosowa, i kilka pomiarów przed interwencją znacząco wzmacniają wnioskowanie.
Przykład: program antystresowy w jednym liceum
Liceum A wprowadziło 8-tygodniowy program radzenia sobie ze stresem przed maturą (n = 58). Liceum B służyło za porównanie (n = 61). Szkołę A wybrano, bo jej uczniowie byli wyraźnie bardziej zestresowani. Stres mierzono skalą PSS-10 (0–40) przed programem i po nim. W symulacji znamy prawdę: program obniża stres o 2 punkty, a pomiar ma rzetelność około .75.
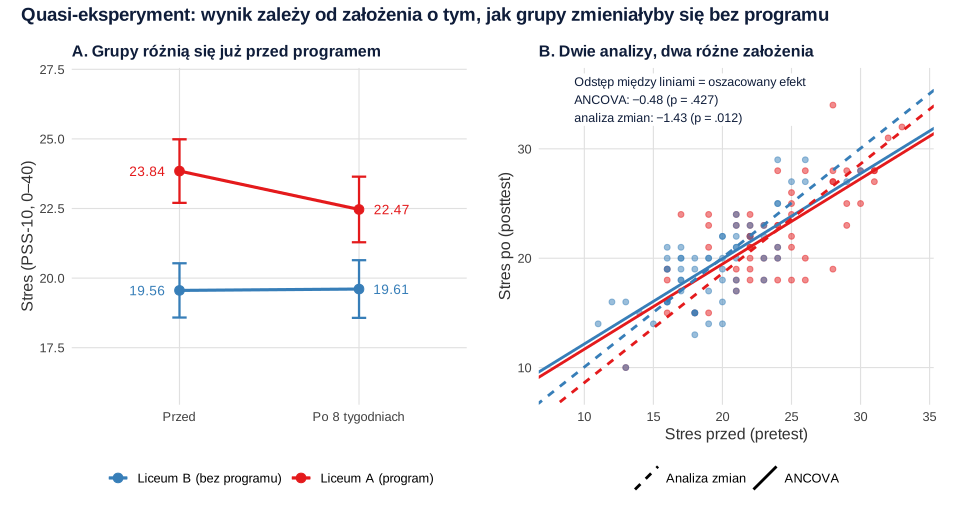
- Grupy nie są równoważne: w preteście średnie wynosiły 23.84 w szkole A i 19.56 w szkole B, p < .001.
- Porównanie samych posttestów (22.47 vs 19.61) daje absurdalny wniosek, że po programie stres był o 2.86 pkt wyższy, p < .001. Różnica wyjściowa przenosi się na wynik końcowy.
- Analiza zmian (post − pre) daje efekt −1.43 pkt, 95% CI [−2.54, −0.32], t(117) = −2.56, p = .012.
- ANCOVA z pretestem jako kowariantem daje efekt −0.48 pkt, 95% CI [−1.67, 0.71], t(116) = −0.80, p = .427.
Dwie rozsądne analizy prowadzą do różnych wniosków. To sytuacja opisana przez Lorda (1967): ANCOVA stosowana do porównań naturalnych grup, które nie są wyrównane pod względem zmiennej kontrolnej, prowadzi do paradoksu interpretacyjnego. Analiza zmian zakłada, że bez programu obie szkoły zmieniałyby się równolegle. ANCOVA zakłada, że osoby o tym samym wyniku w preteście miałyby ten sam wynik końcowy niezależnie od szkoły. Przy błędzie pomiaru i trwałej różnicy między szkołami to drugie założenie jest fałszywe. Szkoła A ma wyższy „prawdziwy” stres, więc jej uczniowie po korekcie na zawodny pretest nadal wypadają gorzej i efekt programu się rozmywa (rysunek 1). Van Breukelen (2006) podsumowuje: w badaniach randomizowanych obie metody są nieobciążone, ale przy grupach różniących się na starcie mogą dawać sprzeczne wyniki.
Żadna analiza statystyczna nie rozstrzygnie tego za badacza. Wybór zależy od tego, które założenie o przebiegu zmian bez interwencji jest wiarygodniejsze. Najlepiej oprzeć je na danych, na przykład na kilku pomiarach sprzed programu, które pokazują wcześniejsze trendy w obu szkołach.
Jak wzmocnić plan bez losowania
Siła quasi-eksperymentu zależy bardziej od planu niż od wyrafinowania analizy. Każdy element poniżej wyklucza jedno z alternatywnych wyjaśnień wyniku:
- Kilka pomiarów przed interwencją – pokazują, czy grupy miały równoległe trendy, i odróżniają efekt od regresji do średniej.
- Grupa porównawcza dobrana pod kątem podobieństwa – ta sama miejscowość, typ szkoły, podobne wyniki wyjściowe; opisz kryteria doboru.
- Pomiar zmiennych, które mogą tłumaczyć różnice – np. wykształcenie rodziców czy wcześniejsze oceny; nie rozwiążą problemu w pełni, ale pozwolą ocenić jego skalę (zob. zmienna zakłócająca).
- Wynik, na który interwencja nie powinna działać – jeśli program antystresowy „poprawia” także wyniki z matematyki, efekt prawdopodobnie wynika z różnic między szkołami.
- Analizy wrażliwości – kilka rozsądnych modeli zamiast jednego (zob. analiza wrażliwości).
Jak opisać quasi-eksperyment w pracy
Nazwij plan precyzyjnie, np. „quasi-eksperyment z grupą nierównoważną, pretestem i posttestem”, i wyjaśnij, dlaczego nie było losowania. Podaj, jak dobrano grupę porównawczą, i pokaż różnice wyjściowe w tabeli. Opisz analizę razem z jej założeniem, a gdy dwie analizy dają różne wyniki – raportuj obie. O tym, jak wpisać to w strukturę pracy, piszemy w poradniku rozdział metodologiczny, a plan analizy warto ustalić przed zebraniem danych (plan analizy i prerejestracja).
Przykład w R
Kod tworzy dane dwóch szkół, porównuje grupy na starcie i szacuje efekt programu trzema sposobami: samym posttestem, analizą zmian i ANCOVA. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Grupy nierównoważne: porównanie posttestów, analiza zmian i ANCOVA
R
# Dane symulowane: quasi-eksperyment w dwóch liceach (grupy nierównoważne, bez losowego przydziału).
# Liceum A dostało program radzenia sobie ze stresem przed maturą, liceum B – nie.
# Stres mierzono skalą PSS-10 (0–40) przed programem (pretest) i po 8 tygodniach (posttest).
# Liceum A wybrano, bo uczniowie byli bardziej zestresowani: średni „prawdziwy” stres 24 vs 20.
# Prawdziwy efekt programu: −2 punkty. Pomiar ma błąd (rzetelność ok. .75).
set.seed(191)
nA <- 58; nB <- 61
szkola <- factor(rep(c("program", "bez_programu"), c(nA, nB)), levels = c("bez_programu", "program"))
stres_staly <- c(rnorm(nA, 24, 4), rnorm(nB, 20, 4))           # stały poziom stresu ucznia
pre  <- round(stres_staly + rnorm(nA + nB, 0, 2.3))
post <- round(stres_staly - 2 * (szkola == "program") + rnorm(nA + nB, 0, 2.3))
dane <- data.frame(szkola, pre, post)

# 1. Średnie przed i po w każdej szkole
aggregate(cbind(pre, post) ~ szkola, data = dane, FUN = function(x) round(mean(x), 2))
t.test(pre ~ szkola, data = dane, var.equal = TRUE)$p.value   # grupy różnią się już na starcie

# 2. Porównanie samych posttestów (błąd: ignoruje różnicę wyjściową)
round(coef(summary(lm(post ~ szkola, data = dane)))[2, ], 3)

# 3. Analiza zmian (różnica post − pre): zakłada, że bez programu obie szkoły zmieniałyby się tak samo
dane$zmiana <- dane$post - dane$pre
m_zmiana <- lm(zmiana ~ szkola, data = dane)
round(coef(summary(m_zmiana))[2, ], 3)
round(confint(m_zmiana)[2, ], 2)

# 4. ANCOVA (posttest z pretestem jako kowariantem): zakłada, że przy równym preteście szkoły by się nie różniły
m_ancova <- lm(post ~ pre + szkola, data = dane)
round(coef(summary(m_ancova)), 3)
round(confint(m_ancova)[3, ], 2)

# Kategoria odniesienia to szkoła bez programu, więc współczynnik „szkolaprogram” = efekt programu (A − B).
Wynik w R
        szkola   pre  post
1 bez_programu 19.56 19.61
2      program 23.84 22.47
[1] 1.333036e-07
  Estimate Std. Error    t value   Pr(>|t|)
     2.859      0.798      3.581      0.000
  Estimate Std. Error    t value   Pr(>|t|)
    -1.428      0.559     -2.556      0.012
 2.5 % 97.5 %
 -2.54  -0.32
              Estimate Std. Error t value Pr(>|t|)
(Intercept)      4.373      1.321   3.310    0.001
pre              0.779      0.065  12.018    0.000
szkolaprogram   -0.481      0.603  -0.797    0.427
 2.5 % 97.5 %
 -1.67   0.71
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakiecie ggplot2 (z patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Nazywanie badania eksperymentem, gdy grupy utworzono z istniejących klas, oddziałów lub z ochotników. Bez losowego przydziału to quasi-eksperyment, a wnioski przyczynowe wymagają dodatkowych argumentów (zob. trafność wewnętrzna).
- Test t dla posttestów bez uwzględnienia różnic wyjściowych – jak w przykładzie, może odwrócić kierunek efektu.
- Mechaniczne użycie ANCOVA jako „wyrównania grup”. W grupach nierandomizowanych ANCOVA nie usuwa różnic, które nie zostały w pełni zmierzone. Przy zawodnym preteście zwykle zaniża lub zawyża efekt.
- Kwalifikowanie do programu na podstawie skrajnych wyników i ocena poprawy tylko w tej grupie. Regresja do średniej imituje wtedy skuteczność.
- Brak sprawdzenia trendów przed interwencją. Jeden pomiar wyjściowy nie pokazuje, czy grupy zmieniały się równolegle; dwa lub trzy pomiary znacznie wzmacniają plan.
- Pominięcie zdarzeń zewnętrznych. Jeśli w szkole A w tym samym czasie zmienił się harmonogram egzaminów, efekt programu i efekt tej zmiany są nierozdzielne – opisz to jako ograniczenie albo dodaj szkołę porównawczą o podobnym kalendarzu.
Najczęstsze pytania
Czym różni się quasi-eksperyment od eksperymentu?
W eksperymencie uczestników przydziela się do warunków losowo, więc grupy są porównywalne pod względem wszystkich cech, także niezmierzonych. W quasi-eksperymencie grupy powstają w inny sposób (klasy, oddziały, wybór uczestników), dlatego różnice w wynikach mogą wynikać z różnic wyjściowych, a nie z interwencji.
Czy badanie przed i po w jednej grupie to quasi-eksperyment?
Tak, to najprostszy i najsłabszy plan quasi-eksperymentalny. Zmiana między pomiarami może wynikać z interwencji, ale też z regresji do średniej, dojrzewania, wydarzeń zewnętrznych czy oswojenia z testem. Grupa porównawcza i kilka pomiarów wyjściowych znacznie wzmacniają taki plan.
ANCOVA czy analiza zmian w quasi-eksperymencie?
Obie są dopuszczalne, ale zakładają co innego. Analiza zmian zakłada równoległe zmiany grup bez interwencji, a ANCOVA – że osoby z tym samym pretestem miałyby ten sam posttest. Przy grupach różniących się na starcie mogą dać sprzeczne wyniki (paradoks Lorda), więc uzasadnij wybór i rozważ podanie obu.
Co to jest paradoks Lorda?
To sytuacja, w której dla tych samych danych z dwóch nierównoważnych grup analiza zmian i ANCOVA dają różne wnioski o efekcie, np. jedna wskazuje istotną poprawę, a druga brak efektu. Paradoks pokazuje, że wynik zależy od założeń o przebiegu zmian, a nie tylko od danych.
Jak wzmocnić wnioski z quasi-eksperymentu?
Dobierz grupę porównawczą jak najbardziej podobną, zmierz obie grupy kilka razy przed interwencją, zapisz zdarzenia zewnętrzne w czasie badania, mierz zmienne mogące tłumaczyć różnice i sprawdź, czy wynik jest odporny na różne analizy. Plan analizy zapisz przed zebraniem danych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Badanie przed i po – opis metody i wnioski
Gotowy podrozdział „Metoda” dla jednej grupy i grupy nierandomizowanej, symulacja regresji do średniej i zdania, które wolno napisać we wnioskach.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikQuasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikStatystyka w pracy z pedagogiki
Ankiety wśród nauczycieli i rodziców: skala Likerta, chi-kwadrat i test Fishera, testy rangowe z korektą Holma, procenty w tabelach i uczniowie w klasach.
Czytaj →PoradnikPytania z metodologii na obronę
Pytania promotora, recenzenta i komisji ułożone według typu badania – od eksperymentu i sondażu po przegląd systematyczny – oraz pojęcia, o które pytają „z definicji”.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Harris, A. D., McGregor, J. C., Perencevich, E. N., Furuno, J. P., Zhu, J., Peterson, D. E., & Finkelstein, J. (2006). The use and interpretation of quasi-experimental studies in medical informatics. Journal of the American Medical Informatics Association, 13(1), 16–23. https://doi.org/10.1197/jamia.m1749 ● Otwarty dostęp
- Lord, F. M. (1967). A paradox in the interpretation of group comparisons. Psychological Bulletin, 68(5), 304–305. https://doi.org/10.1037/h0025105
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{harris2006use, author={Harris, Anthony D. and McGregor, Jessina C. and Perencevich, Eli N. and Furuno, Jon P. and Zhu, Jingkun and Peterson, Dan E. and Finkelstein, Joseph}, title={{The use and interpretation of quasi-experimental studies in medical informatics}}, journal={Journal of the American Medical Informatics Association}, year={2006}, volume={13}, number={1}, pages={16--23}, doi={10.1197/jamia.m1749}}@article{lord1967paradox, author={Lord, Frederic M.}, title={{A paradox in the interpretation of group comparisons}}, journal={Psychological Bulletin}, year={1967}, volume={68}, number={5}, pages={304--305}, doi={10.1037/h0025105}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}