Co to jest schemat korelacyjny?
Schemat korelacyjny (ang. correlational design) to plan badania, w którym mierzysz zmienne tak, jak występują u badanych osób, i analizujesz związki między nimi – bez manipulowania czymkolwiek i bez losowego przydziału. Typowa praca dyplomowa z kwestionariuszami („czy wsparcie społeczne wiąże się z wypaleniem?”) to badanie korelacyjne.
Nazwa dotyczy planu badania, a nie statystyki. Badanie jest korelacyjne także wtedy, gdy porównujesz testem t istniejące grupy (palący i niepalący), bo przynależności do grupy nikt nie przydzielał. I odwrotnie: regresja policzona na danych z eksperymentu nie czyni eksperymentu korelacyjnym. O schemacie decyduje to, skąd bierze się zmienność predyktora: z decyzji badacza czy z „natury”. Andrade (2021) przypomina przy tym, że istotny związek dwóch zmiennych nie dowodzi przyczynowości, bo oba mogą zależeć od zmiennych zakłócających.
Kiedy wybrać schemat korelacyjny?
- Manipulacja jest niemożliwa lub nieetyczna. Nie przydzielisz losowo osobowości, traumy, rozwodu rodziców ani wieku.
- Interesuje Cię przewidywanie, a nie przyczyna. Do przewidywania rezygnacji ze studiów na podstawie wyników z pierwszego semestru nie potrzeba wiedzy o mechanizmie.
- Badasz strukturę zjawiska. Analiza czynnikowa, rzetelność i trafność skal opierają się na korelacjach.
- Chcesz zbadać zjawisko w naturalnych warunkach, na dużej i zróżnicowanej próbie – kosztem trafności wewnętrznej zyskujesz zewnętrzną.
- Szukasz kandydatów do eksperymentu. Silne i stabilne związki wskazują, co warto potem sprawdzić eksperymentalnie.
Schemat korelacyjny może być przekrojowy (jeden pomiar) albo podłużny (kilka pomiarów tych samych osób). Ten drugi ustala kolejność zdarzeń w czasie, choć sam w sobie nie rozstrzyga o przyczynie.
Jeden związek, kilka wyjaśnień
Gdy czas spędzany w mediach społecznościowych koreluje z objawami depresyjnymi, możliwe są co najmniej trzy mechanizmy: (A) media nasilają objawy, (B) osoby z objawami częściej uciekają w media, (C) trzecia zmienna, np. samotność, sprzyja jednemu i drugiemu. Ten trzeci przypadek to korelacja pozorna, a samotność pełni w nim rolę zmiennej zakłócającej. Dane z jednego pomiaru nie odróżnią tych wyjaśnień – pokazuje to symulacja w następnej sekcji.
Antonakis i in. (2010) zbierają źródła takich problemów pod hasłem endogeniczności. Należą do nich pominięte zmienne, selekcja próby, wzajemne oddziaływanie, wspólna metoda pomiaru i błąd pomiaru. W przeglądzie 110 artykułów o przywództwie z czołowych czasopism stwierdzili, że autorzy nie uwzględniali od 66% do 90% warunków, od których zależy trafność wniosków przyczynowych.
Przykład: trzy światy, ta sama korelacja
W symulacji wygenerowano trzy „światy” po 300 osób, każdy według innego mechanizmu: A – media wpływają na objawy, B – objawy wpływają na korzystanie z mediów, C – samotność wpływa na oba, a między mediami a objawami nie ma bezpośredniego związku. W każdym świecie przeprowadzono to samo badanie korelacyjne: jednorazowy pomiar obu zmiennych.
| Świat (mechanizm) | r [95% CI] | b: objawy na media | b: media na objawy |
|---|---|---|---|
| A: media → objawy | .37 [.27, .46] | 0.38 | 0.36 |
| B: objawy → media | .38 [.28, .48] | 0.39 | 0.37 |
| C: samotność → oba | .31 [.21, .41] | 0.28 | 0.35 |
We wszystkich trzech światach korelacja jest umiarkowana i istotna (p < .001). Regresja „w jedną” i „w drugą stronę” daje podobne współczynniki. Wybór, która zmienna jest predyktorem, a która wynikiem, to decyzja badacza – dane jej nie potwierdzają. Rysunek 1 pokazuje, że trzech mechanizmów nie da się odróżnić nawet „na oko”.
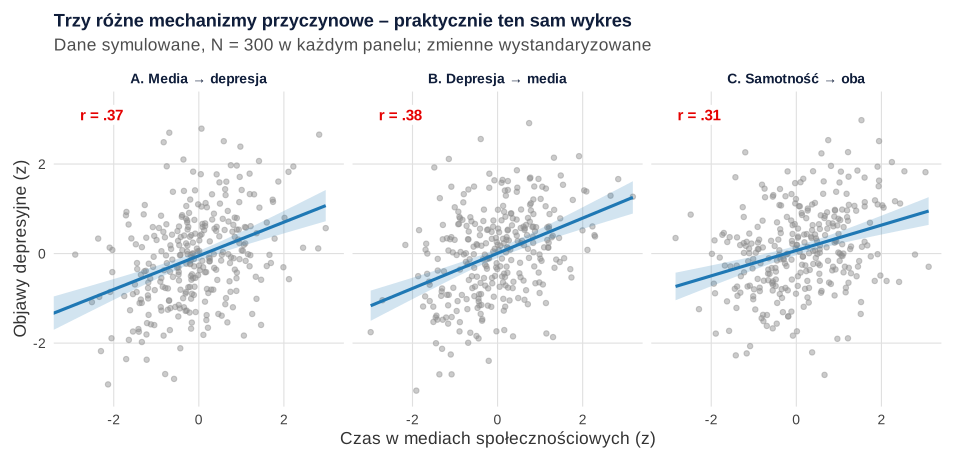
W świecie C pomaga zmierzenie samotności. Korelacja cząstkowa mediów i objawów po kontroli samotności spada z .31 do −.07, a w regresji z obiema zmiennymi współczynnik mediów jest nieistotny (b = −0.06, p = .227). Pomoc jest jednak warunkowa. W świecie C samotność jest wspólną przyczyną, więc jej kontrola usuwa pozorny związek. Gdyby jednak samotność była mediatorem (media → samotność → objawy), ta sama kontrola usunęłaby część prawdziwego efektu.
Kontrola statystyczna wymaga modelu przyczynowego
„Kontrolowanie” zmiennych w regresji to najczęstsza odpowiedź na zarzut korelacyjności. Wysocki i in. (2022) pokazują, że zmniejsza ona obciążenie tylko przy właściwym doborze zmiennych kontrolnych. Źle dobrane mogą dać oszacowanie bardziej obciążone niż brak kontroli. Rohrer (2018) wyjaśnia za pomocą grafów przyczynowych, czego nie kontrolować. Należą do tego wspólne skutki obu zmiennych (tzw. zderzacze, ang. colliders) i mediatory; podobny skutek może mieć dobór niereprezentatywnej próby. Wniosek praktyczny: zanim dodasz zmienne kontrolne, narysuj założony układ przyczynowy i uzasadnij każdą z nich.
Grosz i in. (2020) opisują „tabu” wnioskowania przyczynowego w psychologii nieeksperymentalnej. Badacze unikają słowa „przyczyna”, a mimo to interpretują wyniki przyczynowo – tylko niejawnie i bez wypowiedzenia założeń. Zalecają postawę odwrotną: otwarcie nazwać pytanie przyczynowe i jawnie podać założenia, przy których odpowiedź byłaby trafna.
Jak wzmocnić badanie korelacyjne?
- Zmierz prawdopodobne wspólne przyczyny, zanim zbierzesz dane – nie da się kontrolować zmiennej, której nie ma w bazie.
- Dodaj wymiar czasu. Kilka pomiarów tych samych osób pokazuje, co poprzedza co, i pozwala oddzielić stałe różnice między osobami od zmian w czasie.
- Zróżnicuj źródła danych. Ocena nauczyciela, dane z dzienniczka czy wskaźnik behawioralny obok samoopisu zmniejszają ryzyko, że związek wynika z metody pomiaru.
- Zapisz model i plan analizy z góry. Lista zmiennych kontrolnych ustalona po obejrzeniu wyników to zaproszenie do dopasowywania analizy do oczekiwań.
Jak opisać wyniki badania korelacyjnego (APA)
Używaj języka związku („wiązał się”, „współwystępował”, „przewidywał”). Jeśli formułujesz interpretację przyczynową, oznacz ją jako hipotezę zależną od założeń. Podaj współczynnik z przedziałem ufności i zmienne kontrolne z uzasadnieniem.
Więcej o wyborze i interpretacji współczynników znajdziesz w haśle korelacja. Model z wieloma predyktorami i zmiennymi kontrolnymi krok po kroku omawia poradnik regresja wieloraka krok po kroku. Jak dane podłużne pomagają ustalić kierunek, wyjaśnia wpis o modelach cross-lagged.
Przykład w R
Kod generuje trzy światy o różnych mechanizmach przyczynowych, liczy w każdym korelację i regresje w obu kierunkach, a w świecie ze wspólną przyczyną – korelację cząstkową i regresję z kontrolą zmiennej zakłócającej.
Ta sama korelacja przy różnych mechanizmach
R
# Dane symulowane: trzy różne mechanizmy przyczynowe, jeden schemat korelacyjny.
# X = czas w mediach społecznościowych, Y = objawy depresyjne, Z = samotność (wszystkie wystandaryzowane).
# W każdym „świecie” badamy 300 osób jednokrotnie, niczym nie manipulując.
set.seed(1871)
n <- 300
swiat_A <- within(data.frame(X = rnorm(n)), Y <- 0.35 * X + rnorm(n, sd = sqrt(1 - 0.35^2)))   # X → Y
swiat_B <- within(data.frame(Y = rnorm(n)), X <- 0.35 * Y + rnorm(n, sd = sqrt(1 - 0.35^2)))   # Y → X
swiat_C <- within(data.frame(Z = rnorm(n)), {                                                  # Z → X i Z → Y
  X <- 0.6 * Z + rnorm(n, sd = 0.8)
  Y <- 0.6 * Z + rnorm(n, sd = 0.8)
})

# 1. W każdym świecie korelacja X i Y wygląda podobnie
sapply(list(A = swiat_A, B = swiat_B, C = swiat_C), function(d) {
  k <- cor.test(d$X, d$Y)
  round(c(r = unname(k$estimate), dolna_CI = k$conf.int[1], gorna_CI = k$conf.int[2], p = k$p.value), 3)
})

# 2. Regresja „Y na X” i „X na Y” – obie istotne w każdym świecie, dane nie wskazują kierunku
round(sapply(list(A = swiat_A, B = swiat_B, C = swiat_C), function(d)
  c(b_Y_na_X = unname(coef(lm(Y ~ X, d))[2]), b_X_na_Y = unname(coef(lm(X ~ Y, d))[2]))), 3)

# 3. Świat C: korelacja cząstkowa X i Y po kontroli zmiennej zakłócającej Z
r_czastkowa <- with(swiat_C, cor(resid(lm(X ~ Z)), resid(lm(Y ~ Z))))
round(c(r_XY = cor(swiat_C$X, swiat_C$Y), r_XY_Z = r_czastkowa), 3)
summary(lm(Y ~ X + Z, data = swiat_C))$coefficients
Wynik w R
             A     B     C
r        0.370 0.383 0.314
dolna_CI 0.268 0.282 0.208
gorna_CI 0.464 0.475 0.412
p        0.000 0.000 0.000
             A     B     C
b_Y_na_X 0.376 0.393 0.283
b_X_na_Y 0.364 0.373 0.347
  r_XY r_XY_Z
 0.314 -0.070
                Estimate Std. Error    t value     Pr(>|t|)
(Intercept)  0.006119711 0.04478930  0.1366333 8.914132e-01
X           -0.061726046 0.05099932 -1.2103308 2.271143e-01
Z            0.655264650 0.05672985 11.5506141 9.731090e-26
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Język wpływu bez planu przyczynowego. „Wsparcie obniża stres” w badaniu ankietowym to nadinterpretacja; napisz „wiązało się z niższym stresem”.
- Uznanie, że nazwa „predyktor” rozstrzyga o kierunku. W regresji możesz zamienić role zmiennych; to Ty, a nie dane, decydujesz, co jest predyktorem.
- Kontrolowanie wszystkiego, co zmierzono. Kontrola mediatora lub wspólnego skutku zniekształca wynik; każda zmienna kontrolna wymaga uzasadnienia.
- Mediacja przekrojowa interpretowana jako mechanizm. Analiza mediacji na jednym pomiarze nie ustala kolejności zdarzeń.
- Wszystkie zmienne z jednego kwestionariusza samoopisowego. Część związku może wynikać z wspólnej wariancji metody, a nie z relacji konstruktów.
- Brak wykresu rozrzutu. Współczynnik bez wykresu może ukryć związek nieliniowy albo obserwację odstającą.
Najczęstsze pytania
Co to jest schemat korelacyjny?
To plan badania, w którym mierzysz zmienne bez manipulowania nimi i bez losowego przydziału, a następnie sprawdzasz, jak się ze sobą wiążą – np. czy osoby z większym wsparciem społecznym zgłaszają mniejszy stres. Typowa praca dyplomowa oparta na kwestionariuszach ma schemat korelacyjny.
Czym różni się badanie korelacyjne od eksperymentu?
W eksperymencie badacz wytwarza warunki i losowo przydziela do nich osoby, więc może wnioskować o wpływie. W badaniu korelacyjnym zmienne tylko się mierzy, a związek może wynikać z wpływu X na Y, Y na X albo ze wspólnej przyczyny – dlatego opisuje się związki, a nie efekty.
Czy porównanie grup testem t to badanie korelacyjne?
Tak, jeśli grupy istniały wcześniej (np. palący i niepalący, studenci różnych kierunków). O schemacie decyduje sposób powstania zmienności predyktora, a nie wybrana statystyka: bez manipulacji i losowego przydziału badanie pozostaje nieeksperymentalne.
Czy kontrola zmiennych w regresji pozwala wnioskować przyczynowo?
Tylko przy mocnych założeniach: że uwzględniono wszystkie ważne wspólne przyczyny i nie kontroluje się mediatorów ani wspólnych skutków. Źle dobrane zmienne kontrolne mogą zwiększyć obciążenie, dlatego każdą uzasadnij założonym modelem przyczynowym.
Jak pisać o wynikach badania korelacyjnego?
Używaj sformułowań „wiązał się”, „współwystępował”, „przewidywał”, a nie „wpływał” czy „powodował”. Podaj współczynnik z przedziałem ufności i wskaż w dyskusji alternatywne wyjaśnienia związku, w tym możliwe zmienne zakłócające i odwrotny kierunek.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Badanie korelacyjne w pracy
Jak nazwać schemat i zmienne, ile osób potrzeba dla r, jak ułożyć kwestionariusze, co kontrolować i co wolno napisać we wnioskach – z gotowym podrozdziałem „Metoda” i przykładem w R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikModele cross-lagged: logika, założenia i interpretacja CLPM oraz RI-CLPM
Jak odróżnić stabilne różnice między osobami od zmiany wewnątrzosobowej, dobrać model panelowy i nie pomylić predykcji czasowej z przyczynowością.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →PoradnikPytania z metodologii na obronę
Pytania promotora, recenzenta i komisji ułożone według typu badania – od eksperymentu i sondażu po przegląd systematyczny – oraz pojęcia, o które pytają „z definicji”.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Andrade, C. (2021). A student’s guide to the classification and operationalization of variables in the conceptualization and design of a clinical study: Part 1. Indian Journal of Psychological Medicine, 43(2), 177–179. https://doi.org/10.1177/0253717621994334 ● Otwarty dostęp
- Antonakis, J., Bendahan, S., Jacquart, P., & Lalive, R. (2010). On making causal claims: A review and recommendations. The Leadership Quarterly, 21(6), 1086–1120. https://doi.org/10.1016/j.leaqua.2010.10.010 ● Otwarty dostęp: pełny tekst
- Grosz, M. P., Rohrer, J. M., & Thoemmes, F. (2020). The taboo against explicit causal inference in nonexperimental psychology. Perspectives on Psychological Science, 15(5), 1243–1255. https://doi.org/10.1177/1745691620921521 ● Otwarty dostęp
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Wysocki, A. C., Lawson, K. M., & Rhemtulla, M. (2022). Statistical control requires causal justification. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095823. https://doi.org/10.1177/25152459221095823 ● Otwarty dostęp
Cytowania BibTeX
@article{andrade2021student, author={Andrade, Chittaranjan}, title={{A student’s guide to the classification and operationalization of variables in the conceptualization and design of a clinical study: Part 1}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={2}, pages={177--179}, doi={10.1177/0253717621994334}}@article{antonakis2010making, author={Antonakis, John and Bendahan, Samuel and Jacquart, Philippe and Lalive, Rafael}, title={{On making causal claims: A review and recommendations}}, journal={The Leadership Quarterly}, year={2010}, volume={21}, number={6}, pages={1086--1120}, doi={10.1016/j.leaqua.2010.10.010}}@article{grosz2020taboo, author={Grosz, Michael P. and Rohrer, Julia M. and Thoemmes, Felix}, title={{The taboo against explicit causal inference in nonexperimental psychology}}, journal={Perspectives on Psychological Science}, year={2020}, volume={15}, number={5}, pages={1243--1255}, doi={10.1177/1745691620921521}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{wysocki2022statistical, author={Wysocki, Anna C. and Lawson, Katherine M. and Rhemtulla, Mijke}, title={{Statistical control requires causal justification}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095823}, doi={10.1177/25152459221095823}}