Co to jest schemat eksperymentalny?
Schemat eksperymentalny (ang. experimental design; eksperyment, plan eksperymentalny) to plan badania, w którym badacz sam wytwarza różne poziomy zmiennej niezależnej i losowo przydziela do nich osoby. Potem porównuje wyniki w zmiennej zależnej. Losowy przydział sprawia, że grupy na starcie różnią się tylko przypadkowo. Systematyczna różnica po manipulacji może więc zostać przypisana manipulacji. Dlatego eksperyment jest punktem odniesienia dla wnioskowania przyczynowego w psychologii. Klasyczne omówienie tej logiki i jej granic dają Shadish i in. (2002).
Od schematu eksperymentalnego odróżnij dwa inne. Schemat quasi-eksperymentalny też porównuje warunki, ale bez losowego przydziału (np. dwie klasy szkolne). Schemat korelacyjny niczym nie manipuluje, tylko mierzy zmienne.
Trzy filary eksperymentu
- Manipulacja. Badacz decyduje, kto doświadczy którego warunku, i wytwarza te warunki w kontrolowany sposób.
- Randomizacja. O przydziale decyduje losowanie, a nie badacz, osoba badana czy kolejność zgłoszeń. Dzięki temu znane i nieznane zmienne zakłócające rozkładają się między grupami tylko przypadkowo.
- Kontrola. Warunki różnią się tylko manipulowanym czynnikiem: ta sama procedura, czas, osoba prowadząca, a najlepiej zaślepienie. Punktem odniesienia jest grupa kontrolna. Mohr i in. (2009) pokazują, że w badaniach interwencji psychologicznych wynik może zależeć od wyboru warunku kontrolnego tak samo jak od samej interwencji. Lista oczekujących, placebo i aktywna kontrola odpowiadają na różne pytania.
Logika ta ma długą historię. Odpowiada kanonowi jednej różnicy: jeśli dwie sytuacje różnią się tylko jedną okolicznością, a różnią się też skutkiem, to ta okoliczność jest przyczyną skutku lub jej częścią. Eksperyment jest praktycznym sposobem, by sytuacje różniły się „tylko jedną okolicznością”. Okoliczności, które wytwarza badacz, kontroluje procedura, a pozostałe – losowanie.
Spełnienie tych warunków daje wysoką trafność wewnętrzną. Nie gwarantuje natomiast trafności zewnętrznej: efekt uzyskany na studentach w laboratorium nie musi wystąpić w innej grupie i w innych warunkach.
Odmiany schematu eksperymentalnego
W tabeli używamy zapisu Campbella: R – losowy przydział, X – manipulacja, O – pomiar; elementy w jednym wierszu dotyczą jednej grupy, w kolejności czasowej.
| Schemat | Zapis | Kiedy stosować |
|---|---|---|
| Tylko posttest z grupą kontrolną | R X O R O | Gdy pretest mógłby uwrażliwić osoby albo jest niemożliwy (np. jednorazowe zadanie) |
| Pretest–posttest z grupą kontrolną | R O X O R O O | Interwencje; pretest zwiększa precyzję i pozwala ocenić ubytek |
| Plan Salomona | cztery grupy: z pretestem i bez, z manipulacją i bez | Gdy trzeba sprawdzić, czy sam pretest zmienia efekt |
| Czynnikowy (np. 2 × 2) | R XA1B1 O … R XA2B2 O | Dwa czynniki naraz i ich interakcja |
| Wewnątrzobiektowy | R: X1 O X2 O / X2 O X1 O | Gdy każdą osobę można zbadać we wszystkich warunkach (losowana kolejność) |
Manipulowany czynnik może być międzyobiektowy, gdy każda osoba jest w jednym warunku, albo wewnątrzobiektowy, gdy przechodzi wszystkie warunki w losowej lub kontrbalansowanej kolejności.
Przykład: trening a lęk egzaminacyjny
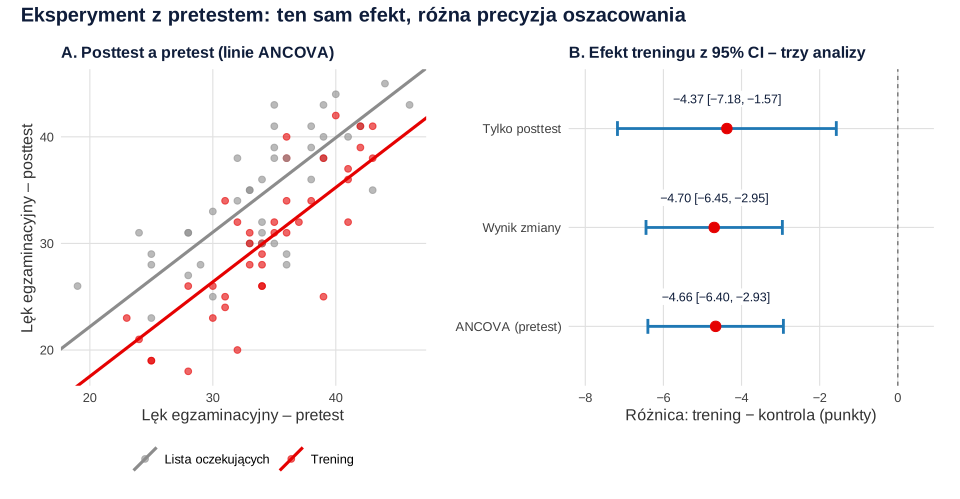
W eksperymencie (dane symulowane) 80 osób z wysokim lękiem egzaminacyjnym losowo przydzielono do 4-tygodniowego treningu albo na listę oczekujących (po 40 osób). Lęk mierzono skalą 10–50 przed i po. Na starcie grupy były podobne: średnia w preteście 34.33 (SD = 5.28) w grupie treningowej i 34.00 (SD = 5.90) w kontrolnej. Po czterech tygodniach średnie wyniosły 30.23 (SD = 6.67) i 34.60 (SD = 5.90). Pretest silnie korelował z posttestem (r = .73).
Ten sam eksperyment można przeanalizować na trzy sposoby; wszystkie dają nieobciążone oszacowanie efektu, ale z różną precyzją:
| Analiza | Efekt (trening − kontrola) | SE | 95% CI | p |
|---|---|---|---|---|
| Tylko posttest | −4.38 | 1.41 | [−7.18, −1.57] | .003 |
| Wynik zmiany (post − pre) | −4.70 | 0.88 | [−6.45, −2.95] | < .001 |
| ANCOVA z pretestem | −4.66 | 0.87 | [−6.40, −2.93] | < .001 |
Uwzględnienie pretestu zmniejszyło błąd standardowy o mniej więcej 40%, bo usunęło z błędu stałe różnice między osobami. Van Breukelen (2006) pokazuje, że w badaniach randomizowanych zarówno ANCOVA, jak i analiza wyników zmiany są nieobciążone, ale ANCOVA ma większą moc. Inaczej jest w badaniach bez losowania: tam obie metody mogą dawać sprzeczne wyniki. W przykładzie przewaga ANCOVA jest niewielka, bo nachylenie posttestu względem pretestu (0.89) jest bliskie 1; przy słabszej korelacji pretestu z posttestem różnica byłaby większa.
Co może zepsuć eksperyment?
- Ubytek osób różny w warunkach. Zhou i Fishbach (2016) opisali eksperymenty internetowe, w których 30–50% osób przerywało udział, i to w różnym stopniu w różnych warunkach. Łamało to losowy przydział i prowadziło do absurdalnych wniosków. Raportuj liczbę osób, które zaczęły i ukończyły badanie w każdej grupie.
- Usuwanie osób po przydziale (np. „nie zaliczyły” kontroli manipulacji) – grupy przestają być porównywalne. Podstawowa analiza obejmuje wszystkich zgodnie z przydziałem.
- Testowanie różnic wyjściowych. Wytyczne CONSORT 2025 odradzają testy istotności dla zmiennych mierzonych przed przydziałem, bo przy prawidłowej randomizacji każda różnica jest dziełem przypadku (Hopewell i in., 2025). Pokaż statystyki opisowe w tabeli, a ważne predyktory wyniku, np. pretest, uwzględnij w modelu z góry.
- Efekt oczekiwań. Osoby, które wiedzą, w jakim są warunku, i badacze, którzy to wiedzą, mogą wpływać na wynik.
Jak opisać eksperyment w pracy (APA)
Opisz schemat (warunki, przydział, liczebności), przebieg (ile osób zaczęło i ukończyło badanie w każdej grupie) i analizę główną określoną przed badaniem.
Gdzie w pracy opisać schemat, przydział i przebieg badania, pokazuje poradnik rozdział metodologiczny – jak go napisać. Analizę eksperymentu z kilkoma grupami omawia wpis ANOVA krok po kroku.
Przykład w R
Kod tworzy dane eksperymentu z pretestem i posttestem i porównuje trzy analizy: tylko posttest, wynik zmiany i ANCOVA.
Eksperyment z pretestem: posttest, zmiana i ANCOVA
R
# Dane symulowane: schemat eksperymentalny z pretestem i posttestem oraz grupą kontrolną.
# 80 osób z wysokim lękiem egzaminacyjnym losowo przydzielono (40/40) do 4-tygodniowego treningu
# albo na listę oczekujących. Lęk egzaminacyjny (skala 10–50) mierzono przed i po.
set.seed(1861)
n <- 80
grupa <- factor(sample(rep(c("kontrola", "trening"), n / 2)), levels = c("kontrola", "trening"))
pre <- round(pmin(pmax(rnorm(n, 34, 6), 10), 50))
post <- round(pmin(pmax(8 + 0.75 * pre - 4 * (grupa == "trening") + rnorm(n, sd = 4.8), 10), 50))
dane <- data.frame(grupa, pre, post, zmiana = post - pre)
aggregate(cbind(pre, post) ~ grupa, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
round(cor(dane$pre, dane$post), 2)

# Trzy analizy tego samego eksperymentu (efekt = trening − kontrola)
m_post   <- lm(post ~ grupa, data = dane)          # tylko posttest
m_zmiana <- lm(zmiana ~ grupa, data = dane)        # różnica post − pre
m_ancova <- lm(post ~ pre + grupa, data = dane)    # ANCOVA: posttest skorygowany o pretest
wynik <- t(sapply(list(posttest = m_post, zmiana = m_zmiana, ANCOVA = m_ancova), function(m)
  c(b = unname(coef(m)["grupatrening"]), SE = summary(m)$coefficients["grupatrening", "Std. Error"],
    confint(m)["grupatrening", ], p = summary(m)$coefficients["grupatrening", "Pr(>|t|)"])))
round(wynik, 3)

# Pełny wynik ANCOVA
summary(m_ancova)
Wynik w R
     grupa pre.M pre.SD post.M post.SD
1 kontrola 34.00   5.90  34.60    5.90
2  trening 34.33   5.28  30.23    6.67
[1] 0.73
              b    SE  2.5 % 97.5 %     p
posttest -4.375 1.407 -7.176 -1.574 0.003
zmiana   -4.700 0.877 -6.446 -2.954 0.000
ANCOVA   -4.663 0.871 -6.398 -2.928 0.000

Call:
lm(formula = post ~ pre + grupa, data = dane)

Residuals:
    Min      1Q  Median      3Q     Max
-9.3690 -2.3612  0.3471  2.3121  8.2903

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept)   4.46203    2.74764   1.624    0.108
pre           0.88641    0.07876  11.255  < 2e-16 ***
grupatrening -4.66308    0.87113  -5.353 8.66e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 3.894 on 77 degrees of freedom
Multiple R-squared:  0.6636,	Adjusted R-squared:  0.6549
F-statistic: 75.96 on 2 and 77 DF,  p-value: < 2.2e-16
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Nazywanie eksperymentem badania bez losowego przydziału. Porównanie dwóch istniejących klas czy oddziałów to quasi-eksperyment.
- Porównywanie zmian „wewnątrz” każdej grupy osobno (test t przed–po w grupie eksperymentalnej istotny, w kontrolnej nie). Efekt to różnica między grupami, a nie różnica między dwiema wartościami p.
- Brak grupy kontrolnej. Sama poprawa po interwencji może wynikać z upływu czasu, praktyki albo regresji do średniej.
- Pretest pominięty w analizie, choć był mierzony – tracisz precyzję, którą dawał.
- Brak informacji o przebiegu: ile osób przydzielono, ile ukończyło, dlaczego odpadły.
- Uogólnianie poza warunki badania. Efekt uzyskany u ochotników w laboratorium wymaga ostrożności przy przenoszeniu na inne grupy.
Najczęstsze pytania
Co to jest schemat eksperymentalny?
To plan badania, w którym badacz sam wytwarza warunki (manipuluje zmienną niezależną), losowo przydziela do nich osoby i porównuje ich wyniki. Dzięki losowemu przydziałowi grupy różnią się na starcie tylko przypadkowo, więc różnicę po manipulacji można przypisać manipulacji.
Czym różni się eksperyment od quasi-eksperymentu?
W eksperymencie o przydziale do warunków decyduje losowanie, a w quasi-eksperymencie – nie (np. porównuje się istniejące klasy albo oddziały). Bez losowania grupy mogą różnić się wieloma cechami naraz, więc wnioski przyczynowe wymagają dodatkowych założeń i kontroli.
Czy w eksperymencie trzeba robić pretest?
Nie zawsze. Schemat z samym posttestem i grupą kontrolną jest pełnoprawnym eksperymentem. Pretest zwiększa jednak precyzję (jako kowariant w ANCOVA), pozwala ocenić ubytek osób, ale może uwrażliwić badanych – sprawdza to plan Salomona.
Jak analizować eksperyment z pretestem i posttestem?
W badaniu randomizowanym najlepiej ANCOVA: posttest jako zmienna zależna, grupa jako czynnik, pretest jako kowariant. Analiza wyników zmiany też jest nieobciążona, ale zwykle ma mniejszą moc; porównywanie zmian osobno w każdej grupie jest błędem.
Czy trzeba testować, czy grupy w eksperymencie różniły się na starcie?
Nie. Przy prawidłowej randomizacji każda różnica wyjściowa jest przypadkowa, a test istotności niczego tu nie rozstrzyga. Pokaż statystyki opisowe obu grup, a zmienne silnie związane z wynikiem, np. pretest, uwzględnij w zaplanowanym modelu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Eksperyment z losowym przydziałem – jak opisać metodę
Warunki, jednostka randomizacji, lista blokowa, ukrycie przydziału, zaślepienie i gotowy podrozdział Metoda z kodem R.
Czytaj →PoradnikEksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikPytania z metodologii na obronę
Pytania promotora, recenzenta i komisji ułożone według typu badania – od eksperymentu i sondażu po przegląd systematyczny – oraz pojęcia, o które pytają „z definicji”.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials. BMJ, 389, Article e081124. https://doi.org/10.1136/bmj-2024-081124 ● Otwarty dostęp
- Mohr, D. C., Spring, B., Freedland, K. E., Beckner, V., Arean, P., Hollon, S. D., Ockene, J., & Kaplan, R. (2009). The selection and design of control conditions for randomized controlled trials of psychological interventions. Psychotherapy and Psychosomatics, 78(5), 275–284. https://doi.org/10.1159/000228248
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
- Zhou, H., & Fishbach, A. (2016). The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions. Journal of Personality and Social Psychology, 111(4), 493–504. https://doi.org/10.1037/pspa0000056
Cytowania BibTeX
@article{hopewell2025consort, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081124}, doi={10.1136/bmj-2024-081124}}@article{mohr2009selection, author={Mohr, David C. and Spring, Bonnie and Freedland, Kenneth E. and Beckner, Victoria and Arean, Patricia and Hollon, Steven D. and Ockene, Judith and Kaplan, Robert}, title={{The selection and design of control conditions for randomized controlled trials of psychological interventions}}, journal={Psychotherapy and Psychosomatics}, year={2009}, volume={78}, number={5}, pages={275--284}, doi={10.1159/000228248}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}@article{zhou2016pitfall, author={Zhou, Haotian and Fishbach, Ayelet}, title={{The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions}}, journal={Journal of Personality and Social Psychology}, year={2016}, volume={111}, number={4}, pages={493--504}, doi={10.1037/pspa0000056}}