Co to jest schemat obserwacyjny?
Schemat obserwacyjny (ang. observational design, observational study) to plan badania, w którym badacz nie przydziela osób do warunków. Rejestruje, kto był na coś narażony albo coś wybrał (tzw. ekspozycja), i porównuje dalsze losy lub wyniki tych osób. Ekspozycją może być palenie, praca zmianowa, korzystanie z terapii czy chodzenie na korepetycje. Kluczowe jest to, że o ekspozycji zdecydowało życie albo sami uczestnicy, a nie losowanie.
W psychologii termin ma dwa znaczenia i warto je rozróżniać:
- Badanie obserwacyjne jako plan – każde badanie bez przydziału ekspozycji przez badacza. To znaczenie dominuje w epidemiologii i naukach o zdrowiu; bliskim odpowiednikiem w psychologii jest schemat korelacyjny.
- Obserwacja jako metoda zbierania danych – systematyczne rejestrowanie zachowania (np. interakcji dziecka z rodzicem) przez wyszkolonych obserwatorów według ustalonego klucza kategorii, zamiast pytania ludzi o nie w kwestionariuszu.
Oba znaczenia łączy brak ingerencji badacza w badane zjawisko. Hasło omawia najpierw plan, a potem metodę.
Rodzaje badań obserwacyjnych
Lista STROBE, standard raportowania badań obserwacyjnych, wyróżnia trzy podstawowe plany i ma 22 punkty, z których 18 jest wspólnych dla wszystkich trzech (von Elm i in., 2007).
| Plan | Logika | Przykład w psychologii | Typowa miara |
|---|---|---|---|
| Kohortowy | Od ekspozycji do wyniku: osoby z ekspozycją i bez obserwuje się w czasie | Studenci chodzący i niechodzący na korepetycje – wynik egzaminu na koniec semestru | Różnica średnich, ryzyko względne |
| Kliniczno-kontrolny | Od wyniku wstecz do ekspozycji: porównuje się osoby z wynikiem i bez niego | Osoby z zaburzeniem lękowym i bez – czy częściej doświadczyły przemocy rówieśniczej? | Iloraz szans |
| Przekrojowy | Ekspozycja i wynik mierzone jednocześnie | Praca zmianowa a objawy bezsenności w jednym badaniu ankietowym | Częstość, korelacja, iloraz szans |
Plan kohortowy może być prospektywny, gdy śledzisz osoby od teraz, albo retrospektywny, gdy korzystasz z istniejących danych. Badanie przekrojowe omawiamy szerzej w haśle schemat przekrojowy, a wielokrotny pomiar tych samych osób – w haśle schemat podłużny.
Główny problem: grupy dobierają się same
W eksperymencie losowanie sprawia, że grupy na starcie różnią się tylko przypadkowo. W badaniu obserwacyjnym osoby same trafiają do grupy z ekspozycją albo bez niej – i zwykle różnią się wieloma cechami naraz. Grimes i Schulz (2002) podkreślają, że w badaniach obserwacyjnych zawsze w jakimś stopniu występują trzy rodzaje błędów: selekcji (kto trafia do badania i do grup), informacji (jak mierzymy ekspozycję i wynik) i zakłócania (wspólne przyczyny ekspozycji i wyniku, zob. zmienna zakłócająca). Mogą one dawać wysoce istotne, ale pozorne wyniki, dlatego przypadek – czyli wartość p – rozważa się na końcu, a nie na początku.
Przykład: korepetycje rówieśnicze a wynik egzaminu
W badaniu kohortowym (dane symulowane) obserwowano 400 osób na drugim roku psychologii. Na początku semestru 121 z nich zdecydowało się chodzić na korepetycje rówieśnicze ze statystyki, a 279 nie. Wtedy też zmierzono średnią ocen z pierwszego roku, motywację (1–7) i lęk przed statystyką (1–5). Na koniec semestru odnotowano wynik egzaminu (0–100 punktów).
Krok 1: czy grupy były porównywalne na starcie? Do porównania używa się standaryzowanej różnicy średnich (SMD), a nie testów istotności, bo SMD nie zależy od liczebności. Austin (2009) przypomina, że SMD = 0.1 odpowiada znikomej korelacji z przynależnością do grupy (φ = .05) – stąd popularny próg 0.1 dla „zaniedbywalnej” różnicy. W przykładzie osoby, które wybrały korepetycje, miały wyraźnie wyższą średnią ocen (SMD = 0.96), wyższą motywację (SMD = 0.44) i nieco wyższy lęk (SMD = 0.21).
Krok 2: porównanie surowe i skorygowane. Uczestnicy korepetycji uzyskali średnio 70.68 punktu (SD = 12.83), pozostali 60.39 (SD = 11.61). Surowa różnica wynosi 10.28 punktu, 95% CI [7.72, 12.85]. Po uwzględnieniu w regresji wielorakiej średniej ocen, motywacji i lęku różnica maleje do 3.57 punktu, 95% CI [1.22, 5.92], p = .003. Większość surowej różnicy wynikała więc z tego, kto wybierał korepetycje, a nie z samych korepetycji.
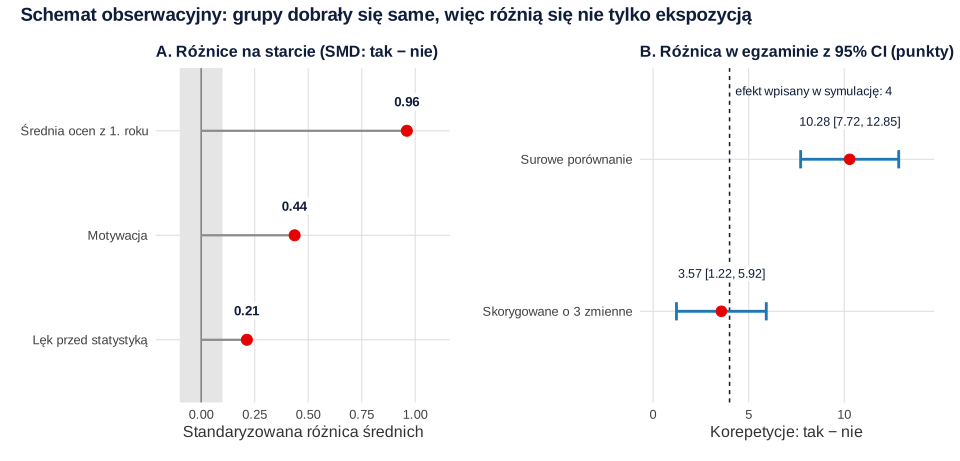
W symulacji znamy prawdę (efekt korepetycji = 4 punkty) i wiemy, że zmierzyliśmy wszystkie zmienne zakłócające. W prawdziwym badaniu żadnej z tych rzeczy nie wiesz. Wynik skorygowany jest wiarygodny tylko wtedy, gdy nie ma ważnych niezmierzonych różnic, np. w zdolnościach matematycznych czy czasie na naukę. Dlatego wnioski z badania obserwacyjnego formułuje się ostrożnie, a o związku przyczynowym przemawia dopiero zbieżność wielu przesłanek. Grimes i Schulz (2002) wymieniają wśród nich kolejność w czasie, siłę i spójność związku oraz zależność „dawka–odpowiedź”.
Obserwacja zachowania jako metoda
W drugim znaczeniu schemat obserwacyjny to sposób pomiaru: zamiast pytać, obserwujesz. Dobrze zaplanowana obserwacja systematyczna wymaga kilku decyzji:
- Klucz kategorii – jasno zdefiniowane, rozłączne zachowania (np. „dziecko inicjuje kontakt”, „rodzic chwali”) z przykładami granicznymi, spisane w książce kodowej.
- Sposób próbkowania – rejestrowanie każdego zdarzenia, rejestrowanie w krótkich przedziałach czasu (np. co 10 sekund) albo próbki czasowe.
- Warunki – obserwacja naturalna (szkoła, dom) albo w sytuacji ustrukturyzowanej (laboratorium, zadanie wspólne).
- Zgodność obserwatorów – co najmniej część materiału koduje niezależnie dwóch obserwatorów. Hallgren (2012) omawia, jak zaplanować taki pomiar oraz jak policzyć i zaraportować kappę Cohena dla kategorii i ICC dla ocen ilościowych.
Obserwacja zmniejsza problemy samoopisu, np. aprobatę społeczną, ale wprowadza własne: reaktywność (ludzie zachowują się inaczej, gdy wiedzą, że są obserwowani) i oczekiwania obserwatora. Pomaga kodowanie nagrań przez osoby, które nie znają hipotez.
Jak opisać badanie obserwacyjne (APA)
Nazwij plan (kohortowy, kliniczno-kontrolny, przekrojowy), opisz, jak osoby trafiały do grup, pokaż porównanie grup na starcie i uzasadnij wybór zmiennych kontrolnych. Lista STROBE (von Elm i in., 2007) dobrze sprawdza się jako lista kontrolna także w pracy dyplomowej.
Wzór tabeli charakterystyki grup na starcie znajdziesz we wpisie jak opisać charakterystykę próby badawczej. Wymagania czasopism medycznych wobec badań obserwacyjnych omawia wpis statystyka w publikacji medycznej.
Przykład w R
Kod tworzy dane badania kohortowego z samodzielnym wyborem ekspozycji, liczy standaryzowane różnice średnich na starcie oraz surową i skorygowaną różnicę w wyniku egzaminu.
Porównanie grup na starcie i korekta o zmienne zakłócające
R
# Dane symulowane: badanie obserwacyjne (kohortowe) – nikt nie przydziela „ekspozycji”.
# 400 osób na 2. roku psychologii; część SAMA zdecydowała się chodzić na korepetycje rówieśnicze
# ze statystyki. Na początku semestru zmierzono: średnią ocen z 1. roku, motywację (1–7)
# i lęk przed statystyką (1–5). Wynik: egzamin ze statystyki (0–100 pkt).
set.seed(1881)
n <- 400
srednia_ocen <- round(pmin(pmax(rnorm(n, 3.9, 0.45), 3), 5), 2)
motywacja <- round(pmin(pmax(rnorm(n, 4.5, 1.1), 1), 7), 1)
lek <- round(pmin(pmax(rnorm(n, 3, 0.8), 1), 5), 1)
szansa <- plogis(-1.2 + 1.3 * (srednia_ocen - 3.9) / 0.45 + 0.8 * (motywacja - 4.5) / 1.1 + 0.3 * (lek - 3) / 0.8)
korepetycje <- factor(ifelse(runif(n) < szansa, "tak", "nie"), levels = c("nie", "tak"))
egzamin <- round(pmin(pmax(62 + 4 * (korepetycje == "tak") + 7 * (srednia_ocen - 3.9) / 0.45 +
                             4 * (motywacja - 4.5) / 1.1 - 3 * (lek - 3) / 0.8 + rnorm(n, sd = 10), 0), 100))
dane <- data.frame(korepetycje, srednia_ocen, motywacja, lek, egzamin)
table(dane$korepetycje)

# 1. Czy grupy były porównywalne na starcie? Standaryzowana różnica średnich (SMD)
smd <- function(x, g) (mean(x[g == "tak"]) - mean(x[g == "nie"])) / sqrt((var(x[g == "tak"]) + var(x[g == "nie"])) / 2)
round(sapply(dane[, c("srednia_ocen", "motywacja", "lek")], smd, g = dane$korepetycje), 2)

# 2. Surowe porównanie wyników egzaminu
aggregate(egzamin ~ korepetycje, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
m_surowy <- lm(egzamin ~ korepetycje, data = dane)
# 3. Model skorygowany o zmierzone zmienne zakłócające
m_skoryg <- lm(egzamin ~ korepetycje + srednia_ocen + motywacja + lek, data = dane)
round(rbind(surowy = c(b = coef(m_surowy)[["korepetycjetak"]], confint(m_surowy)["korepetycjetak", ]),
            skorygowany = c(b = coef(m_skoryg)[["korepetycjetak"]], confint(m_skoryg)["korepetycjetak", ])), 2)
summary(m_skoryg)$coefficients
Wynik w R
nie tak
279 121
srednia_ocen    motywacja          lek
        0.96         0.44         0.21
  korepetycje egzamin.M egzamin.SD
1         nie     60.39      11.61
2         tak     70.68      12.83
                b 2.5 % 97.5 %
surowy      10.28  7.72  12.85
skorygowany  3.57  1.22   5.92
                Estimate Std. Error   t value     Pr(>|t|)
(Intercept)    -3.340913  5.7808166 -0.577931 5.636400e-01
korepetycjetak  3.571105  1.1950151  2.988335 2.980212e-03
srednia_ocen   15.582804  1.2675506 12.293635 1.232928e-29
motywacja       3.466028  0.4858838  7.133450 4.707214e-12
lek            -3.539675  0.6136511 -5.768222 1.619045e-08
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Porównanie surowe przedstawione jako efekt. Różnica 10 punktów w przykładzie to głównie efekt tego, kto wybiera korepetycje.
- Testy istotności zamiast SMD przy porównaniu grup na starcie – przy dużej próbie wszystko jest „istotne”, przy małej nic.
- Kontrolowanie zmiennych mierzonych po ekspozycji, np. liczby godzin nauki w trakcie semestru, która może być skutkiem korepetycji.
- Brak opisu, jak osoby trafiały do grup i ile odpadło w trakcie obserwacji.
- Obserwacja zachowania bez sprawdzenia zgodności obserwatorów – bez kappy lub ICC nie wiadomo, czy kategorie są rzetelne.
- Mylenie badania obserwacyjnego z eksperymentem naturalnym. To drugie wymaga, by ekspozycja była „prawie losowa” (np. wynikała z daty urodzenia), czego w zwykłym badaniu obserwacyjnym brak.
Najczęstsze pytania
Co to jest badanie obserwacyjne?
To badanie, w którym badacz nie decyduje, kto doświadczy ekspozycji (np. terapii, pracy zmianowej, korepetycji), tylko rejestruje ją i porównuje dalsze wyniki. Ponieważ grupy dobierają się same, mogą różnić się wieloma cechami, co utrudnia wnioskowanie o przyczynach.
Czym różni się badanie obserwacyjne od eksperymentu?
W eksperymencie badacz losowo przydziela osoby do warunków, więc grupy różnią się na starcie tylko przypadkowo. W badaniu obserwacyjnym ekspozycję wybierają sami uczestnicy lub okoliczności, dlatego różnice w wyniku mogą wynikać ze zmiennych zakłócających, a nie z ekspozycji.
Jakie są rodzaje badań obserwacyjnych?
Podstawowe to badanie kohortowe (od ekspozycji do wyniku, obserwacja w czasie), kliniczno-kontrolne (od wyniku wstecz do ekspozycji) i przekrojowe (ekspozycja i wynik mierzone jednocześnie). Wszystkie trzy obejmuje lista STROBE.
Jak sprawdzić, czy grupy w badaniu obserwacyjnym są porównywalne?
Policz standaryzowane różnice średnich (SMD) dla ważnych zmiennych mierzonych przed ekspozycją; wartości powyżej około 0.1 wskazują na istotną nierównowagę. Testy istotności się tu nie sprawdzają, bo ich wynik zależy głównie od liczebności próby.
Co to jest obserwacja systematyczna w psychologii?
To metoda zbierania danych, w której wyszkoleni obserwatorzy rejestrują zachowanie według ustalonego klucza kategorii i zasad próbkowania czasu. Wymaga sprawdzenia zgodności obserwatorów, np. kappą Cohena albo ICC, na części materiału kodowanej niezależnie przez dwie osoby.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →PoradnikStatystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C. (2009). Using the standardized difference to compare the prevalence of a binary variable between two groups in observational research. Communications in Statistics – Simulation and Computation, 38(6), 1228–1234. https://doi.org/10.1080/03610910902859574
- Grimes, D. A., & Schulz, K. F. (2002). Bias and causal associations in observational research. The Lancet, 359(9302), 248–252. https://doi.org/10.1016/s0140-6736(02)07451-2
- Hallgren, K. A. (2012). Computing inter-rater reliability for observational data: An overview and tutorial. Tutorials in Quantitative Methods for Psychology, 8(1), 23–34. https://doi.org/10.20982/tqmp.08.1.p023 ● Otwarty dostęp
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
Cytowania BibTeX
@article{austin2009using, author={Austin, Peter C.}, title={{Using the standardized difference to compare the prevalence of a binary variable between two groups in observational research}}, journal={Communications in Statistics – Simulation and Computation}, year={2009}, volume={38}, number={6}, pages={1228--1234}, doi={10.1080/03610910902859574}}@article{grimes2002bias, author={Grimes, David A. and Schulz, Kenneth F.}, title={{Bias and causal associations in observational research}}, journal={The Lancet}, year={2002}, volume={359}, number={9302}, pages={248--252}, doi={10.1016/s0140-6736(02)07451-2}}@article{hallgren2012computing, author={Hallgren, Kevin A.}, title={{Computing inter-rater reliability for observational data: An overview and tutorial}}, journal={Tutorials in Quantitative Methods for Psychology}, year={2012}, volume={8}, number={1}, pages={23--34}, doi={10.20982/tqmp.08.1.p023}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}