Analiza ankiety do pracy dyplomowej: od czego zacząć
Ankieta jest zamknięta, eksport z formularza leży na dysku, a promotor pyta o „wstępne wyniki”. W tym miejscu wiele osób otwiera program statystyczny i zaczyna liczyć to, co akurat podsuwa menu. Tak powstają rozdziały z dwudziestoma tabelami, w których trudno znaleźć odpowiedź na pytanie badawcze. Analiza ankiety ma stałą kolejność i warto się jej trzymać: plan analizy → porządek w bazie → czyszczenie → wyniki skal i ich rzetelność → opis próby → testy hipotez → raport. Każdy krok opiera się na poprzednim, a pominięcie któregoś zwykle wychodzi dopiero przy obronie.
Ten poradnik prowadzi przez wszystkie etapy na jednym przykładzie (dane symulowane). Studentka bada stres akademicki. Ankietę online z metryczką, ośmiopozycyjną skalą stresu (odpowiedzi 1–5, pozycje 3 i 6 sformułowane pozytywnie), sześciopozycyjną skalą wsparcia społecznego (1–7), pytaniem kontrolnym i pytaniem o rozważanie przerwania studiów wypełniło 267 osób. Hipotezy brzmią tak:
- H1: im wyższe wsparcie społeczne, tym niższy stres;
- H2: studenci pracujący zarobkowo odczuwają większy stres niż niepracujący;
- H3: rozważanie przerwania studiów jest częstsze na studiach niestacjonarnych niż stacjonarnych.
Wszystkie liczby w tekście pochodzą z kodu w sekcji Przykład w R. Surowy plik możesz pobrać i przejść całą analizę samodzielnie. Jeśli ankieta jest jeszcze w przygotowaniu, zacznij od poradnika jak zrobić ankietę do pracy dyplomowej i listy najczęstszych błędów w ankietach, bo wielu problemów opisanych niżej nie da się już naprawić po zebraniu danych.
Krok 1. Plan analizy: każde pytanie ankiety ma swoje miejsce
Zanim policzysz cokolwiek, zapisz na jednej stronie, które pytania ankiety służą do sprawdzenia której hipotezy, jaki powstanie z nich wskaźnik i jakim testem go zanalizujesz. Taki plan chroni przed dwoma błędami. Pierwszy to liczenie wszystkiego ze wszystkim i wybieranie istotnych wyników. Drugi to odkrycie po fakcie, że jakiejś zmiennej w ankiecie po prostu nie ma. Plan analizy jest też gotowym szkieletem podrozdziału „Analiza statystyczna” w metodzie.
| Hipoteza | Pytania w ankiecie | Wskaźnik | Analiza | Wielkość efektu |
|---|---|---|---|---|
| H1: wsparcie a stres | wsp1–wsp6, str1–str8 | średnie wyniki dwóch skal | korelacja Pearsona (kontrolnie Spearmana) | r z 95% CI |
| H2: praca a stres | praca (tak/nie), str1–str8 | średni wynik skali stresu | test t Welcha | d Cohena z 95% CI |
| H3: tryb a przerwanie studiów | tryb, przerwa (tak/nie) | tabela 2 × 2 | test chi-kwadrat niezależności | φ z 95% CI |
| Opis próby | metryczka | liczebności, procenty, M, SD | statystyki opisowe | – |
Dobór testu wynika z rodzaju zmiennych, a nie z tego, który test „wyjdzie”. Jeżeli nie masz pewności, który test pasuje do hipotezy, zacznij od pytania, jakiego rodzaju są obie zmienne: ilościowe, porządkowe czy kategorialne. Przy kilku hipotezach testowanych na tych samych danych zastanów się też, czy potrzebujesz poprawki na wielokrotne porównania. Przy trzech hipotezach z osobnymi pytaniami zwykle się jej nie stosuje, ale przy dziesięciu porównaniach jednej zmiennej – już tak.
Krok 2. Eksport i porządek w bazie danych
Surowy eksport z Google Forms czy LimeSurvey zawiera całe treści pytań jako nagłówki, odpowiedzi zapisane słowami i kolumny techniczne. Zanim zaczniesz analizę, nadaj zmiennym krótkie nazwy (str1, wsp4), zamień odpowiedzi tekstowe na liczby według jednego klucza i zapisz ten klucz w książce kodowej. Szczegółową instrukcję, z plikami do pobrania, znajdziesz we wpisie o kodowaniu danych z Google Forms i LimeSurvey.
Trzy zasady oszczędzają najwięcej pracy później:
- Oryginalny eksport zostaw nietknięty. Wszystkie zmiany wykonuj w kopii albo – lepiej – w skrypcie, który zaczyna od surowego pliku. Wtedy każdą decyzję da się odtworzyć i cofnąć.
- Wpisuj surowe odpowiedzi. Pozycje odwrócone odwracaj w nowej zmiennej (
str3r), a nie przez nadpisanie oryginału. Dzięki temu nie odwrócisz ich przypadkiem dwa razy. - Braki zostaw pustą komórką. Kodów typu 99 nie mieszaj z prawdziwymi wartościami skali, bo średnia „zjedzie” w górę bez żadnego ostrzeżenia.
Pytania nietypowe wymagają osobnego kodowania. Pytanie wielokrotnego wyboru rozbij na zmienne 0/1 dla każdej opcji (zob. analiza pytań wielokrotnego wyboru). Odpowiedzi otwarte najpierw kategoryzuj według spisanego klucza (kodowanie odpowiedzi otwartych). Odpowiedź „nie wiem” zakoduj jako osobną kategorię, a nie jako środek skali – wyjaśnia to hasło odpowiedź „nie wiem” i „trudno powiedzieć”. Pytania pominięte przez pytanie filtrujące to brak z założenia („nie dotyczy”), a nie brak odpowiedzi.
Krok 3. Czyszczenie danych: reguły ustalone przed analizą
W ankiecie online zawsze trafiają się wiersze, które nie powinny wejść do analizy: podwójne wysłania, osoby bez zgody, ankiety przerwane po metryczce i odpowiedzi udzielane bez czytania. Czyszczenie danych z ankiety online polega na usunięciu ich według reguł, które spisujesz przed obejrzeniem wyników hipotez. Gdy reguły powstają po fakcie, łatwo nieświadomie usuwać osoby, które „psują” oczekiwany wynik.
Nieuważne odpowiadanie to realny problem. W badaniu Meade’a i Craiga (2012) około 10–12% studentów wypełniających długą ankietę za punkty zaliczeniowe odpowiadało nieuważnie. Autorzy pokazali też, że różne wzorce nieuważności wymagają różnych wskaźników. Przegląd Warda i Meade’a (2023) omawia, jak takiemu odpowiadaniu zapobiegać już w projekcie ankiety, jak je identyfikować oraz jak raportować i usuwać nieuważne odpowiedzi. Czas wypełniania okazał się w badaniu Leinera (2019) najlepszym niereaktywnym wskaźnikiem bezsensownych danych, dlatego warto go zawsze eksportować.
W przykładzie zastosowano pięć reguł w ustalonej kolejności:
- Duplikaty: wiersze z identycznymi odpowiedziami we wszystkich pytaniach (ponowne kliknięcie „Prześlij”) – usunięto 4.
- Brak zgody na udział – 3 osoby; ich odpowiedzi nie mogą być analizowane.
- Ankieta przerwana: odpowiedź na mniej niż 7 z 14 pozycji skal – 7 osób.
- Błąd w pytaniu kontrolnym („Zaznacz odpowiedź 1”) – 12 osób.
- Zbyt krótki czas: poniżej jednej trzeciej mediany czasu (próg 83 s) – 5 osób. Cztery z nich zaznaczyły tę samą odpowiedź we wszystkich pozycjach skali stresu, czyli pokazały wzorzec straightliningu.
Z 267 wierszy eksportu do analizy weszło 236 osób (rysunek 1). Próg czasu jest decyzją badacza, a nie ogólną normą. Opisz go w pracy wraz z uzasadnieniem i, jeśli to możliwe, sprawdź, czy wnioski zmieniają się przy innym progu. Więcej o wskaźnikach szybkości znajdziesz w haśle speeding, a pełną procedurę z kilkoma wskaźnikami – we wpisie o nieuważnych odpowiedziach w ankietach online.
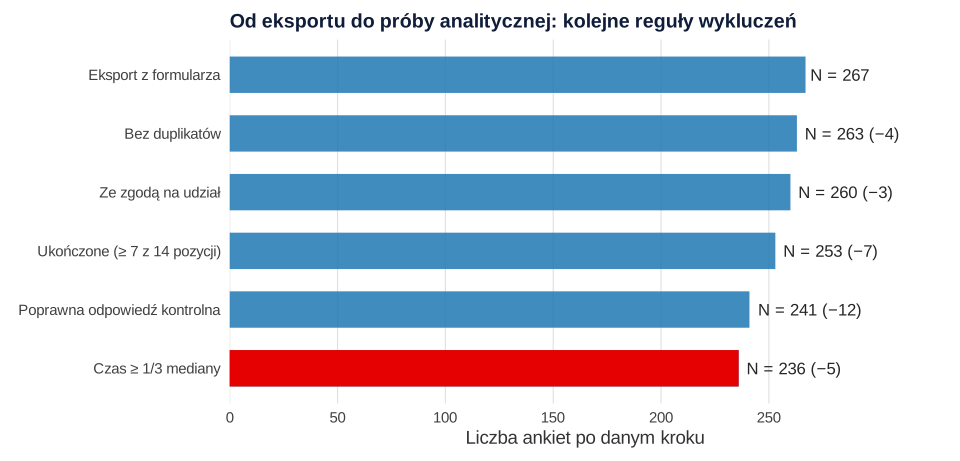
Kolejność reguł wpływa na to, ile osób przypiszesz do każdej z nich, ale nie na końcową liczebność. Zacznij od reguł formalnych (duplikaty, zgoda), a dopiero potem stosuj reguły jakościowe. Taki układ dobrze przenosi się na schemat przepływu uczestników w pracy, a wskaźnik odpowiedzi i odsetek ankiet przerwanych podasz w opisie procedury.
Krok 4. Braki danych i wartości spoza zakresu
Po wykluczeniach przejrzyj zakresy wszystkich zmiennych. W przykładzie jedna osoba wpisała wiek 220 lat. To oczywista literówka, ale nie wiadomo, czy chodziło o 20, czy o 22, więc wartość zamieniono na brak danych zamiast ją zgadywać. Podobnie postępuj z wartościami niemożliwymi na skali (np. 6 na skali 1–5 po błędnym rekodowaniu).
Braki pojedynczych pozycji są w ankietach normalne: w przykładzie 220 osób odpowiedziało na wszystkie 14 pozycji skal, 14 osób pominęło jedną pozycję, a 2 osoby – trzy pozycje skali wsparcia. Ustal z góry, ile pozycji musi mieć osoba, aby policzyć jej wynik skali. W przykładzie przyjęto, że brakować może najwyżej jednej pozycji. Wynik skali stresu policzono więc dla wszystkich 236 osób, a wyniku skali wsparcia nie policzono dla 2 osób. Przy kilku procentach rozproszonych braków taka reguła zwykle wystarcza. Przy większych brakach, zwłaszcza w zmiennych kluczowych dla hipotez, rozważ metody oparte na wszystkich dostępnych danych. Graham (2009) podkreśla, że imputacja wielokrotna i metody największej wiarygodności dają mniej obciążone wyniki niż usuwanie całych przypadków, zwłaszcza gdy mają do dyspozycji zmienne pomocnicze. Typy braków omawia hasło braki danych (MCAR, MAR, MNAR), a praktykę – wpis o imputacji wielokrotnej w R.
Krok 5. Wyniki skal: odwrócenie pozycji i średnia
Skala to kilka pozycji mierzących ten sam konstrukt. Do analizy hipotez potrzebujesz jednego wyniku na osobę, a pojedynczych pozycji nie testujesz osobno. Kolejność jest stała: najpierw odwróć pozycje sformułowane w przeciwnym kierunku (na skali 1–5: 6 − odpowiedź), potem policz wynik.
Czy liczyć sumę, czy średnią? Dla analiz w obrębie jednego badania obie wersje dają te same korelacje i te same wartości testów, ale średnia ma dwie przewagi. Pozostaje w jednostkach skali odpowiedzi (3.27 na skali 1–5 każdy czytelnik od razu umiejscowi) i nie zaniża wyniku osobom, które pominęły pozycję. Jeżeli jednak test ma normy liczone dla sumy, trzymaj się instrukcji autorów. Szerzej piszemy o tym w haśle wynik skali: średnia czy suma.
Zanim połączysz pozycje, popatrz na rozkłady odpowiedzi (rysunek 2). Pozycje odwrócone powinny mieć „lustrzany” rozkład w porównaniu z pozostałymi. Jeśli tak nie jest, respondenci mogli ich nie zrozumieć albo pozycja została źle zakodowana.
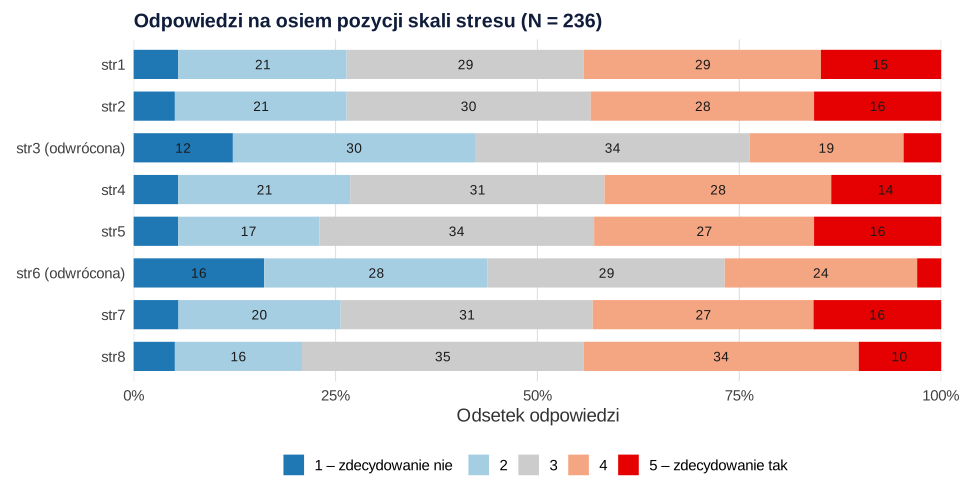
Pojedyncza pozycja skali Likerta to zmienna porządkowa. Opisuj ją rozkładem odpowiedzi albo medianą, a nie średnią z dwoma miejscami po przecinku. Inaczej jest z wynikiem całej skali. Sullivan i Artino (2013) przypominają, że testy parametryczne można stosować do wyników skal Likerta, o ile połączenie pozycji uzasadnisz dowodami rzetelności lub struktury. Norman (2010) pokazuje, że ANOVA, regresja i korelacja są odporne na naruszenia założeń typowe dla takich danych. Przy pozycji str1 w przykładzie wystarczy więc napisać, że 44.3% osób wybrało odpowiedź 4 lub 5 (29.4% i 14.9%).
Krok 6. Rzetelność skal: alfa, omega i korelacje pozycja–skala
Dla każdej skali wielopozycyjnej podaj miarę spójności wewnętrznej obliczoną na Twojej próbie, a nie przepisaną z podręcznika testu. Najczęściej raportuje się alfę Cronbacha. McNeish (2018) wyjaśnia jednak, że alfa zakłada równe ładunki pozycji, a gdy to założenie nie jest spełnione, zwykle zaniża rzetelność. Dlatego coraz częściej podaje się obok niej omegę McDonalda.
W przykładzie skala stresu miała α = .85 i ω = .85, a skala wsparcia α = .87 i ω = .87. Korelacje pozycji z resztą skali stresu wynosiły od .47 (str6r) do .67 (str4). Żadna pozycja nie odstaje więc od pozostałych na tyle, by ją usuwać. Sprawdź też, co dzieje się bez odwrócenia pozycji 3 i 6: alfa spada wtedy do .51. Bardzo niska alfa przy skali, która w literaturze ma dobrą rzetelność, to najczęściej sygnał błędu kodowania, a nie „złej skali”. Szczegóły interpretacji alfy omawia wpis alfa Cronbacha: jak oceniać rzetelność skali, a gotowe zdania i tabele – wzór raportowania alfy Cronbacha.
Krok 7. Opis próby i statystyki opisowe
Opis próby odpowiada na pytanie, kogo naprawdę zbadano. W przykładzie do analizy weszło 236 osób w wieku 19–32 lat (M = 23.34, SD = 2.44; jedna osoba bez danych o wieku). Kobiety stanowiły 68.6% próby (n = 162), mężczyźni 28.0% (n = 66), 6 osób (2.5%) wybrało odpowiedź „inna”, a 2 (0.8%) – „wolę nie odpowiadać”. Na studiach stacjonarnych było 146 osób (61.9%), a pracę zarobkową deklarowało 98 osób (41.5%). Jakie cechy opisać i jak pogrupować kategorie, wyjaśnia wpis jak opisać charakterystykę próby badawczej. Gotowe tabele dla różnych typów badań znajdziesz we wzorze przedstawienia charakterystyki próby.
Dla wyników skal podaj liczebność, średnią, odchylenie standardowe, zakres oraz skośność i kurtozę. To podstawowa statystyka opisowa, która pozwala czytelnikowi ocenić rozkład, zanim zobaczy testy. Rzetelność możesz dołączyć do tej samej tabeli.
Tabela 1
Statystyki opisowe i rzetelność skal stresu i wsparcia społecznego
| Skala | n | M | SD | Zakres | Skośność | Kurtoza | α | ω |
|---|---|---|---|---|---|---|---|---|
| Stres (1–5) | 236 | 3.27 | 0.76 | 1.62–5.00 | 0.01 | −0.90 | .85 | .85 |
| Wsparcie społeczne (1–7) | 234 | 4.71 | 1.12 | 1.33–7.00 | −0.38 | −0.13 | .87 | .87 |
Uwaga. Wyniki skal to średnie odpowiedzi na pozycje; wynik obliczano, gdy brakowało najwyżej jednej pozycji. Kurtoza – nadwyżka względem rozkładu normalnego. α – alfa Cronbacha, ω – omega McDonalda (model jednoczynnikowy). Dane symulowane.
Krok 8. Testy hipotez z wielkością efektu
Każdą hipotezę sprawdzasz testem zapisanym w planie, a wynik raportujesz w trzech częściach: statystyka testu z p, wielkość efektu z przedziałem ufności i jedno zdanie, co to oznacza w języku pytania badawczego.
H1: wsparcie społeczne a stres – korelacja
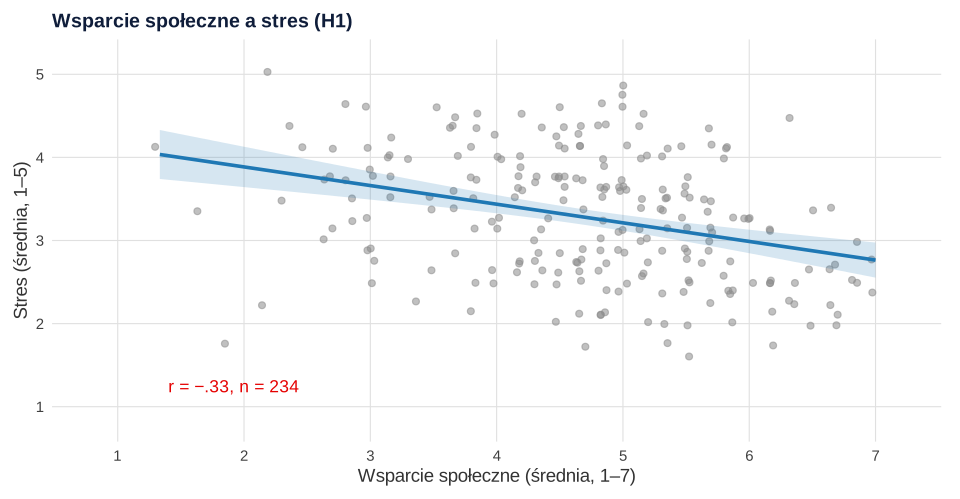
Wyniki obu skal mają rozkłady zbliżone do symetrycznych (tabela 1), a zależność wygląda na liniową (rysunek 3), dlatego zastosowano korelację Pearsona. Wsparcie społeczne korelowało ujemnie ze stresem, r(232) = −.33, 95% CI [−.44, −.21], p < .001. Korelacja Spearmana dała podobny wynik (ρ = −.35), więc wniosek nie zależy od wyboru współczynnika. Hipoteza H1 znalazła potwierdzenie. Pamiętaj jednak, że w schemacie przekrojowym korelacja nie pokazuje kierunku wpływu (zob. korelacja a przyczynowość).
H2: praca zarobkowa a stres – test t Welcha
Do porównania dwóch grup o różnej liczebności użyto testu t Welcha, który nie zakłada równości wariancji. Delacre i in. (2017) zalecają go jako wybór domyślny, bo lepiej kontroluje błąd I rodzaju, a przy równych wariancjach niewiele traci. Osoby pracujące (n = 98, M = 3.37, SD = 0.72) miały nieco wyższy stres niż niepracujące (n = 138, M = 3.21, SD = 0.78). Różnica wynosiła 0.16 punktu, 95% CI [−0.03, 0.36], t(218.50) = 1.64, p = .102, d = 0.22, 95% CI [−0.04, 0.47]. Hipoteza H2 nie znalazła potwierdzenia.
Wynik nieistotny opisz tak samo starannie jak istotny. Przedział ufności dla d obejmuje zarówno zero, jak i efekt bliski średniemu, więc badanie nie rozstrzyga sprawy. Nie wolno z niego wnioskować, że „praca nie ma związku ze stresem”. Jak pisać o takich wynikach, pokazuje wpis hipoteza się nie potwierdziła – co dalej. Lakens (2013) przypomina, że raportowanie wielkości efektu z przedziałem ufności pozwala wykorzystać wynik w kolejnych badaniach i metaanalizach, niezależnie od tego, czy przekroczył próg istotności.
H3: tryb studiów a rozważanie przerwania studiów – chi-kwadrat
Obie zmienne są dychotomiczne, dlatego zastosowano test chi-kwadrat niezależności dla tabeli 2 × 2. Przerwanie studiów rozważało 20.0% osób studiujących niestacjonarnie (18 z 90) i 15.1% studiujących stacjonarnie (22 ze 146). Najmniejsza liczebność oczekiwana wynosiła 15.3, więc warunek stosowania testu był spełniony. Związek okazał się nieistotny, χ²(1) = 0.96, p = .327, φ = .06, 95% CI [.00, .19]. Przy małych liczebnościach oczekiwanych sięgnij po test dokładny Fishera.
Krok 9. Jak opisać analizę ankiety w pracy
W rozdziale metodologicznym opisz przygotowanie danych: reguły wykluczeń z liczbą osób usuniętych na każdym kroku, sposób liczenia wyników skal i postępowanie z brakami. W rozdziale wyników podaj kolejno opis próby, statystyki opisowe z rzetelnością i wyniki hipotez w tej kolejności, w jakiej je postawiono. Poniżej znajdziesz dwa wzory, które możesz dopasować do swoich danych. Więcej gotowych zdań dla innych testów zawiera wpis jak opisać wyniki w stylu APA.
Jeżeli chcesz, żeby ktoś sprawdził Twoją bazę, reguły czyszczenia i dobór testów, zanim oddasz rozdział, zajrzyj do oferty analiz dla studentów. Konsultacja ma sens wtedy, gdy rozumiesz każdy krok i potrafisz go obronić. Pomoc przy analizie nie zastępuje Twojej pracy nad tekstem.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunków. Pobierz plik analiza-ankiet-dane-surowe.csv (surowy eksport, 267 wierszy, dane symulowane), zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – każdy kolejny korzysta z ramki d utworzonej wcześniej.
1. Wczytanie eksportu i reguły wykluczeń
R
ankieta <- read.csv("analiza-ankiet-dane-surowe.csv", encoding = "UTF-8")
str_poz <- paste0("str", 1:8); wsp_poz <- paste0("wsp", 1:6)
nrow(ankieta)                                            # wszystkie wiersze z eksportu

# Kolejne reguły wykluczeń – ustalone przed obejrzeniem wyników
d <- ankieta
d <- d[!duplicated(d[, -(1:2)]), ]                       # 1. duplikaty (te same odpowiedzi wysłane ponownie)
n1 <- nrow(d)
d <- d[d$zgoda == "Tak", ]                               # 2. brak zgody na udział
n2 <- nrow(d)
d$odp <- rowSums(!is.na(d[, c(str_poz, wsp_poz)]))       # liczba odpowiedzi w 14 pozycjach skal
d <- d[d$odp >= 7, ]                                     # 3. ankieta przerwana (mniej niż połowa pozycji)
n3 <- nrow(d)
d <- d[!is.na(d$kontrola) & d$kontrola == 1, ]           # 4. błąd w pytaniu kontrolnym („zaznacz 1”)
n4 <- nrow(d)
prog_czasu <- median(d$czas_s) / 3
szybcy <- d[d$czas_s < prog_czasu, ]
d <- d[d$czas_s >= prog_czasu, ]                         # 5. czas krótszy niż 1/3 mediany
n5 <- nrow(d)
c(surowe = nrow(ankieta), po_duplikatach = n1, po_zgodzie = n2, po_przerwanych = n3,
  po_kontroli = n4, po_czasie = n5)
round(prog_czasu)
# Ilu „szybkich” odpowiadało identycznie w całej skali stresu (straightlining)?
sum(apply(szybcy[, str_poz], 1, function(x) length(unique(na.omit(x))) == 1))

# Wartości spoza zakresu i braki pojedynczych pozycji
summary(d$wiek)
d$wiek[d$wiek < 18 | d$wiek > 80] <- NA                  # 220 lat = literówka → brak danych
table(braki_w_pozycjach = rowSums(is.na(d[, c(str_poz, wsp_poz)])))
Wynik w R
[1] 267
        surowe po_duplikatach     po_zgodzie po_przerwanych    po_kontroli
           267            263            260            253            241
     po_czasie
           236
[1] 83
[1] 4
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
  19.00   22.00   23.00   24.17   24.25  220.00
braki_w_pozycjach
  0   1   3
220  14   2
2. Pozycje odwrócone, wyniki skal i rzetelność
R
library(psych)   # alpha(), omega()

# Pozycje odwrócone: 3 i 6 w skali stresu (1–5)
d$str3r <- 6 - d$str3; d$str6r <- 6 - d$str6
str_k <- c("str1", "str2", "str3r", "str4", "str5", "str6r", "str7", "str8")

# Wynik skali = średnia, jeśli brakuje najwyżej 1 pozycji
wynik <- function(x, min_odp) ifelse(rowSums(!is.na(x)) >= min_odp, rowMeans(x, na.rm = TRUE), NA)
d$stres    <- wynik(d[, str_k], 7)
d$wsparcie <- wynik(d[, wsp_poz], 5)
colSums(is.na(d[, c("stres", "wsparcie")]))

# Rzetelność: alfa Cronbacha i omega (model jednoczynnikowy)
a_s <- alpha(d[, str_k], warnings = FALSE); a_w <- alpha(d[, wsp_poz], warnings = FALSE)
o_s <- suppressWarnings(omega(d[, str_k], nfactors = 1, plot = FALSE))
o_w <- suppressWarnings(omega(d[, wsp_poz], nfactors = 1, plot = FALSE))
round(c(alfa_stres = a_s$total$raw_alpha, omega_stres = o_s$omega.tot,
        alfa_wsparcie = a_w$total$raw_alpha, omega_wsparcie = o_w$omega.tot), 2)
round(a_s$item.stats[, "r.drop", drop = FALSE], 2)        # korelacje pozycja–reszta skali stresu

# Kontrola: co by się stało bez odwrócenia pozycji 3 i 6
round(alpha(d[, str_poz], warnings = FALSE, check.keys = FALSE)$total$raw_alpha, 2)
Wynik w R
   stres wsparcie
       0        2
    alfa_stres    omega_stres  alfa_wsparcie omega_wsparcie
          0.85           0.85           0.87           0.87
      r.drop
str1    0.65
str2    0.66
str3r   0.52
str4    0.67
str5    0.49
str6r   0.47
str7    0.65
str8    0.58
[1] 0.51
3. Charakterystyka próby i statystyki opisowe
R
# Charakterystyka próby
nrow(d)
round(c(M = mean(d$wiek, na.rm = TRUE), SD = sd(d$wiek, na.rm = TRUE), Mdn = median(d$wiek, na.rm = TRUE),
        min = min(d$wiek, na.rm = TRUE), max = max(d$wiek, na.rm = TRUE), braki = sum(is.na(d$wiek))), 2)
proc <- function(x) { t <- table(x); cbind(n = t, proc = round(100 * prop.table(t), 1)) }
proc(d$plec); proc(d$tryb); proc(d$praca)

# Statystyki opisowe wyników skal
opis <- function(x) { x <- x[!is.na(x)]
  c(n = length(x), M = mean(x), SD = sd(x), Mdn = median(x), min = min(x), max = max(x),
    skosnosc = psych::skew(x), kurtoza = psych::kurtosi(x)) }
round(rbind(stres = opis(d$stres), wsparcie = opis(d$wsparcie)), 2)

# Rozkład odpowiedzi na pozycję (pojedyncza pozycja Likerta = częstości, nie średnia)
round(100 * prop.table(table(factor(d$str1, levels = 1:5))), 1)
round(100 * mean(d$str1 >= 4, na.rm = TRUE), 1)                  # odsetek odpowiedzi 4 lub 5
Wynik w R
[1] 236
    M    SD   Mdn   min   max braki
23.34  2.44 23.00 19.00 32.00  1.00
                      n proc
Inna                  6  2.5
Kobieta             162 68.6
Mężczyzna            66 28.0
Wolę nie odpowiadać   2  0.8
                 n proc
niestacjonarne  90 38.1
stacjonarne    146 61.9
      n proc
Nie 138 58.5
Tak  98 41.5
           n    M   SD  Mdn  min max skosnosc kurtoza
stres    236 3.27 0.76 3.25 1.62   5     0.01   -0.90
wsparcie 234 4.71 1.12 4.83 1.33   7    -0.38   -0.13

   1    2    3    4    5
 5.5 20.9 29.4 29.4 14.9
[1] 44.3
4. Testy hipotez H1–H3 z wielkością efektu
R
library(effectsize)   # cohens_d(), phi()

# H1: wsparcie społeczne a stres
k <- complete.cases(d$stres, d$wsparcie)
h1 <- cor.test(d$wsparcie[k], d$stres[k])
round(c(n = sum(k), r = unname(h1$estimate), df = unname(h1$parameter), t = unname(h1$statistic),
        p = h1$p.value, CI_dolna = h1$conf.int[1], CI_gorna = h1$conf.int[2]), 3)
round(cor(d$wsparcie[k], d$stres[k], method = "spearman"), 2)   # kontrola: rho Spearmana

# H2: stres u osób pracujących i niepracujących – test t Welcha
aggregate(stres ~ praca, d, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
h2 <- t.test(stres ~ praca, data = d)                      # domyślnie Welch
round(c(t = unname(h2$statistic), df = unname(h2$parameter), p = h2$p.value,
        roznica = unname(diff(h2$estimate)), CI_dolna = -h2$conf.int[2], CI_gorna = -h2$conf.int[1]), 3)
cohens_d(stres ~ praca, data = d, pooled_sd = FALSE)       # wartość ujemna: Nie < Tak

# H3: tryb studiów a rozważanie przerwania studiów
tab <- table(d$tryb, d$przerwa); tab
round(100 * prop.table(tab, 1), 1)
h3 <- chisq.test(tab, correct = FALSE)
round(h3$expected, 1)
round(c(chi2 = unname(h3$statistic), df = unname(h3$parameter), p = h3$p.value), 3)
phi(tab, adjust = FALSE, alternative = "two.sided")
Wynik w R
       n        r       df        t        p CI_dolna CI_gorna
 234.000   -0.331  232.000   -5.334    0.000   -0.440   -0.211
[1] -0.35
  praca stres.n stres.M stres.SD
1   Nie  138.00    3.21     0.78
2   Tak   98.00    3.37     0.72
       t       df        p  roznica CI_dolna CI_gorna
  -1.644  218.501    0.102    0.162   -0.032    0.357
Cohen's d |        95% CI
-------------------------
-0.22     | [-0.47, 0.04]

- Estimated using un-pooled SD.
                 Nie Tak
  niestacjonarne  72  18
  stacjonarne    124  22

                  Nie  Tak
  niestacjonarne 80.0 20.0
  stacjonarne    84.9 15.1

                   Nie  Tak
  niestacjonarne  74.7 15.3
  stacjonarne    121.3 24.7
 chi2    df     p
0.962 1.000 0.327
Phi  |       95% CI
-------------------
0.06 | [0.00, 0.19]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizie ankiety
- Analiza na surowym eksporcie. Duplikaty, ankiety bez zgody i przerwane zawyżają liczebność i zniekształcają wyniki. Zawsze zaczynaj od reguł wykluczeń i podaj ich wynik w pracy.
- Reguły czyszczenia dobierane do wyników. Jeśli sprawdzasz kilka wersji progu czasu i wybierasz tę, przy której hipoteza „wychodzi”, wynik przestaje być wiarygodny. Ustal reguły wcześniej, a inne warianty pokaż jako analizę wrażliwości.
- Zapomniane pozycje odwrócone. W przykładzie alfa spadła z .85 do .51. Zanim uznasz skalę za nierzetelną, sprawdź klucz.
- Średnia z pojedynczej pozycji Likerta jako główny wynik. Pojedyncze pytanie opisuj rozkładem odpowiedzi. Średnie i testy parametryczne stosuj do wyników całych skal.
- Testowanie każdej pozycji osobno. Osiem testów dla ośmiu pytań skali zamiast jednego testu dla wyniku skali to prosta droga do przypadkowych „istotnych” wyników.
- „Nie wiem” zakodowane jako środek skali. Taka odpowiedź oznacza brak opinii, a nie umiarkowaną zgodę. Zakoduj ją osobno i zdecyduj, jak ją traktujesz w analizie.
- Same wartości p. Bez wielkości efektu i przedziału ufności czytelnik nie wie, czy związek jest silny, czy tylko „istotny”, ani co mówi wynik nieistotny.
- Wnioski przyczynowe z ankiety przekrojowej. Korelacja wsparcia i stresu nie pokazuje, co jest przyczyną. Pisz o związku, a nie o wpływie (zob. rodzaje badań ankietowych i ich konsekwencje dla wniosków).
- Uogólnianie na „wszystkich studentów”. Ankieta rozesłana w mediach społecznościowych to próba wygodna. Opisz, kogo zbadano, i ostrożnie formułuj zasięg wniosków. Źródła respondentów i ich ograniczenia omawia wpis gdzie znaleźć respondentów do ankiety.
Jeżeli przygotowujesz dopiero ankietę, zaplanuj czyszczenie danych już teraz. Dodaj pytanie kontrolne, eksportuj czas wypełniania i przetestuj formularz w badaniu pilotażowym. Pilotaż pokaże też, czy eksport daje się wczytać do programu bez ręcznych poprawek. Odpowiedzi wygenerowane przez modele językowe mogą co najwyżej pomóc we wstępnym przejrzeniu pytań, ale nie zastąpią danych od ludzi – granice takiego podejścia opisujemy we wpisie o syntetycznych respondentach.
Najczęstsze pytania
Od czego zacząć analizę ankiety do pracy licencjackiej?
Od planu analizy: przy każdej hipotezie zapisz, z których pytań ankiety powstaje wskaźnik i jakim testem go sprawdzisz. Potem uporządkuj bazę (nazwy zmiennych, kodowanie, książka kodowa), usuń ankiety według reguł ustalonych przed analizą i policz wyniki skal. Testy hipotez wykonujesz na końcu.
Ile ankiet można usunąć przed analizą danych?
Nie ma jednego dopuszczalnego odsetka – liczy się to, czy reguły (duplikaty, brak zgody, ankiety przerwane, błąd w pytaniu kontrolnym, zbyt krótki czas) ustalono przed obejrzeniem wyników i czy podajesz liczbę osób usuniętych na każdym kroku. Jeśli usuwasz dużą część próby, sprawdź w analizie wrażliwości, czy wnioski zmieniają się przy łagodniejszych regułach.
Jak policzyć wynik skali z kilku pytań w ankiecie?
Najpierw odwróć pozycje sformułowane w przeciwnym kierunku (na skali 1–5: 6 minus odpowiedź), potem policz średnią odpowiedzi na pozycje skali. Ustal z góry, ile pozycji może brakować (np. najwyżej jedna), aby wynik był liczony. Sumę stosuj wtedy, gdy wymaga jej instrukcja testu z normami.
Czy w pracy trzeba podać alfę Cronbacha dla każdej skali z ankiety?
Tak – dla każdej skali wielopozycyjnej podaj rzetelność obliczoną na własnej próbie, najlepiej alfę Cronbacha razem z omegą McDonalda. Pojedynczych pytań i metryczki to nie dotyczy. Bardzo niska alfa przy znanej skali często oznacza nieodwrócone pozycje, więc najpierw sprawdź kodowanie.
Jak opisać nieistotny wynik hipotezy z ankiety?
Podaj statystykę testu, wartość p, wielkość efektu i jej 95% przedział ufności, a potem napisz, że hipoteza nie znalazła potwierdzenia. Nie pisz, że związku „nie ma” – szeroki przedział ufności zwykle oznacza, że badanie nie rozstrzyga sprawy. Omów możliwe przyczyny w dyskusji, np. liczebność próby.
Powiązane hasła
Przeczytaj też
Wyniki ankiety z 30 pytaniami bez 30 testów
Rola każdego pytania, tabela zbiorcza z 95% CI, wynik skali, testy tylko dla hipotez, eksploracja z FDR i gotowy szkic rozdziału wyników.
Czytaj →PoradnikAnaliza ankiety z Google Forms krok po kroku
Od surowego CSV do zdań APA: słownik zmiennych, kontrola jakości, przekodowanie pytań, tabela próby i trzy hipotezy w R.
Czytaj →PoradnikŁączenie kategorii odpowiedzi – kiedy i jak
Likert 5 na 3, „nie wiem”, małe kategorie metryczki, łączenie pod wynik w symulacji i alternatywy: test Fishera, trend, regresja porządkowa – z kodem R.
Czytaj →PoradnikPytania filtrujące i „nie dotyczy” – jaki mianownik
Kody 97/98/99, trzy mianowniki odsetków, tabela z różnymi n i błąd selekcji przy porównaniu grup po filtrze – na eksporcie z Google Forms.
Czytaj →PoradnikDane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →PoradnikNieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Masz dane z ankiety i nie wiesz, od czego zacząć?
Sprawdzimy bazę i reguły czyszczenia, dobierzemy testy do hipotez i wyjaśnimy wyniki tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Graham, J. W. (2009). Missing data analysis: Making it work in the real world. Annual Review of Psychology, 60(1), 549–576. https://doi.org/10.1146/annurev.psych.58.110405.085530
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Leiner, D. J. (2019). Too fast, too straight, too weird: Non-reactive indicators for meaningless data in internet surveys. Survey Research Methods, 13(3), 229–248. https://doi.org/10.18148/srm/2019.v13i3.7403 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Meade, A. W., & Craig, S. B. (2012). Identifying careless responses in survey data. Psychological Methods, 17(3), 437–455. https://doi.org/10.1037/a0028085
- Norman, G. (2010). Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
- Ward, M. K., & Meade, A. W. (2023). Dealing with careless responding in survey data: Prevention, identification, and recommended best practices. Annual Review of Psychology, 74(1), 577–596. https://doi.org/10.1146/annurev-psych-040422-045007 ● Otwarty dostęp
Cytowania BibTeX
@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{graham2009missing, author={Graham, John W.}, title={{Missing data analysis: Making it work in the real world}}, journal={Annual Review of Psychology}, year={2009}, volume={60}, number={1}, pages={549--576}, doi={10.1146/annurev.psych.58.110405.085530}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{leiner2019too, author={Leiner, Dominik Johannes}, title={{Too fast, too straight, too weird: Non-reactive indicators for meaningless data in internet surveys}}, journal={Survey Research Methods}, year={2019}, volume={13}, number={3}, pages={229--248}, doi={10.18148/srm/2019.v13i3.7403}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{meade2012identifying, author={Meade, Adam W. and Craig, S. Bartholomew}, title={{Identifying careless responses in survey data}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={437--455}, doi={10.1037/a0028085}}@article{norman2010likert, author={Norman, Geoff}, title={{Likert scales, levels of measurement and the “laws” of statistics}}, journal={Advances in Health Sciences Education}, year={2010}, volume={15}, number={5}, pages={625--632}, doi={10.1007/s10459-010-9222-y}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}@article{ward2023dealing, author={Ward, M. K. and Meade, Adam W.}, title={{Dealing with careless responding in survey data: Prevention, identification, and recommended best practices}}, journal={Annual Review of Psychology}, year={2023}, volume={74}, number={1}, pages={577--596}, doi={10.1146/annurev-psych-040422-045007}}