Rodzaje badań ankietowych: po co je rozróżniać
„Badanie ankietowe” to w pracy dyplomowej zbyt mało, by opisać schemat. Dwie ankiety z identycznym kwestionariuszem mogą pozwalać na zupełnie inne wnioski. Pierwsza została wysłana imiennie do losowo wybranych studentów z listy uczelni, druga – udostępniona w grupie na portalu społecznościowym. Pierwsza mierzyła te same osoby dwa razy w odstępie roku, druga raz. W metodzie musisz więc powiedzieć, kiedy mierzono, kogo i jak dobrano, jakim kanałem zbierano odpowiedzi i po co – czy celem jest opis populacji, czy sprawdzenie związku między zmiennymi.
Ten poradnik porządkuje rodzaje badań ankietowych według tych czterech osi i dla każdej pokazuje, co z niej wynika dla wniosków. Na końcu znajdziesz symulację, która na liczbach pokazuje, jak błąd pokrycia i autoselekcja zmieniają wynik ankiety, oraz wzór opisu schematu do rozdziału metodologicznego. Jeśli dopiero projektujesz kwestionariusz, zacznij od wpisu jak zrobić ankietę do pracy dyplomowej. Różnicę między ankietą a standaryzowanym kwestionariuszem psychologicznym wyjaśnia hasło kwestionariusz a ankieta.
Wspólną ramą dla tych rozróżnień jest całkowity błąd badania sondażowego (total survey error). Groves i Lyberg (2010) opisują go jako sumę błędów, które pojawiają się na każdym etapie: od tego, kto w ogóle mógł trafić do próby, przez to, kto odpowiedział, po to, jak pytanie zmierzyło konstrukt. Każda z czterech osi odpowiada innemu źródłu błędu.
Oś 1. Czas: badania przekrojowe, panelowe i trendowe
Badanie przekrojowe to jeden pomiar u każdej osoby. Setia (2016) podkreśla, że w takim schemacie przekrojowym ekspozycję i wynik mierzy się jednocześnie. Dobrze nadaje się on więc do szacowania rozpowszechnienia i związków, ale słabo do wnioskowania o przyczynach. To zdecydowanie najczęstszy schemat w pracach dyplomowych: jest tani, szybki i nie wymaga utrzymania kontaktu z respondentami.
Badanie panelowe mierzy te same osoby co najmniej dwukrotnie. Pozwala zobaczyć zmianę wewnątrz osób i kolejność zdarzeń, ale ma swoją cenę: część uczestników odpada między pomiarami, a odpadanie rzadko jest losowe. Ployhart i Vandenberg (2010) zebrali listy zagadnień, które trzeba rozważyć już przy teoretyzowaniu i planowaniu badania podłużnego, oraz omówili kompromisy między metodami analizy zmiany. Liczba i odstępy pomiarów są więc decyzją projektową, a nie szczegółem technicznym. Więcej o tym schemacie mówi hasło schemat podłużny.
Badanie trendowe (powtarzane badanie przekrojowe) zadaje te same pytania różnym próbom z tej samej populacji w kolejnych latach. Pokazuje zmiany na poziomie populacji, np. czy odsetek studentów z objawami wypalenia rośnie, ale nie mówi nic o zmianie u poszczególnych osób. Odmianą jest badanie kohortowe, w którym śledzi się grupę wyróżnioną wspólnym zdarzeniem (np. rocznik rozpoczynający studia w tym samym roku), za każdym razem w nowej próbie z tej grupy albo w panelu.
| Rodzaj | Kto jest mierzony | Na co odpowiada | Główne ryzyko |
|---|---|---|---|
| Przekrojowe | każda osoba raz | rozpowszechnienie, różnice między grupami, korelacje | brak kolejności czasowej; pokusa wniosków przyczynowych |
| Panelowe | te same osoby kilka razy | zmiana u osób, kolejność zmian, stabilność | nielosowe odpadanie uczestników, efekt powtórnego pomiaru |
| Trendowe | nowa próba w każdej edycji | zmiana na poziomie populacji | zmiany w sposobie doboru lub pytaniach między edycjami |
| Kohortowe | grupa z tym samym doświadczeniem | przebieg zjawiska w danej grupie | trudność oddzielenia wieku, okresu i kohorty |
W pracy dyplomowej z jednym pomiarem pisz więc o „związku”, a nie o „wpływie”. Zmienna mierzona tego samego dnia nie może poprzedzać drugiej w czasie, a korelacja nie przesądza o przyczynowości.
Badanie panelowe w pracy dyplomowej: jak połączyć pomiary
Coraz więcej prac magisterskich ma dwa pomiary, np. na początku i na końcu semestru. Taki schemat wymaga kilku decyzji, których nie ma w badaniu przekrojowym.
- Łączenie odpowiedzi tej samej osoby. W anonimowej ankiecie online najprościej poprosić o kod tworzony według stałej reguły (np. dwie pierwsze litery imienia matki, dzień urodzenia, ostatnia cyfra numeru telefonu). Nie zbieraj w tym celu nazwisk ani adresów e-mail w tej samej bazie co odpowiedzi. Zasady opisuje hasło anonimizacja i pseudonimizacja danych, a obowiązki informacyjne – hasło świadoma zgoda i RODO w badaniach.
- Odstęp między pomiarami. Dobierz go do tempa zmiany, której się spodziewasz. Zbyt krótki odstęp sprawia, że respondenci pamiętają swoje odpowiedzi; zbyt długi – że odpada wiele osób.
- Ten sam kwestionariusz. Zmiana brzmienia pytania między pomiarami sprawia, że różnicy nie da się przypisać zmianie u ludzi. Kolejność bloków też zostaw bez zmian, bo odpowiedzi zależą od kontekstu (zob. efekt kolejności pytań).
- Plan na odpadanie. Zaplanuj przypomnienia i zapisz z góry, jak porównasz osoby, które zostały, z tymi, które odpadły. Gotowy wzór takiej tabeli i schematu przepływu uczestników znajdziesz we wzorze przedstawienia charakterystyki próby.
Dwa pomiary to wciąż nie eksperyment. Bez losowego przydziału do warunków zmiana w czasie może mieć wiele przyczyn. Jeśli chcesz porównać grupy objęte i nieobjęte jakimś oddziaływaniem, zajrzyj do hasła schemat eksperymentalny.
Oś 2. Dobór: próby probabilistyczne i nieprobabilistyczne
Druga oś mówi, w jaki sposób osoby z populacji trafiły do badania, a więc na kogo można przenieść wynik uzyskany w próbie. To pytanie o trafność zewnętrzną. Berndt (2020) dzieli metody doboru na probabilistyczne i nieprobabilistyczne i dla każdej podaje zalety i ograniczenia. Granica między tymi grupami jest najważniejsza dla wniosków o populacji.
Dobór probabilistyczny wymaga operatu losowania, czyli listy osób z populacji, oraz znanego, niezerowego prawdopodobieństwa wylosowania każdej z nich. W badaniach studentów takim operatem bywa lista adresów e-mail z dziekanatu. Próba losowa (prosta, warstwowa, zespołowa) pozwala policzyć błąd losowy i margines błędu, bo jej losowość jest zapewniona przez sam schemat.
Dobór nieprobabilistyczny obejmuje dobór wygodny, celowy i metodę kuli śnieżnej, próbę kwotową oraz ochotników z ogłoszenia czy panelu internetowego. Raport grupy zadaniowej AAPOR (Baker i in., 2013) podsumowuje, że wnioskowanie z takich prób zawsze opiera się na założeniach modelowych, które trzeba jawnie opisać. Przejrzystość opisu doboru jest tu ważniejsza niż przy próbach losowych. Cornesse i in. (2020) dodają, że trafność wniosków z prób nieprobabilistycznych zależy całkowicie od tych modeli, natomiast zaufanie do prób losowych uzasadnia sama teoria statystyczna.
Nie znaczy to, że próba wygodna jest bezużyteczna. W pracach dyplomowych to standard i nikt nie oczekuje losowania z rejestru. Konsekwencja jest jednak konkretna: wynik opisowy (odsetek, średnia) dotyczy osób, które odpowiedziały, a jego przeniesienie na populację wymaga dodatkowych argumentów. Hasło reprezentatywność próby wyjaśnia, dlaczego zgodność struktury płci i wieku nie gwarantuje reprezentatywności w zakresie badanej cechy.
Nawet próba losowa traci część zalet, gdy wiele wylosowanych osób nie odpowiada. Groves (2006) pokazuje, że brak odpowiedzi może, ale nie musi, obciążać wyniki. Niski wskaźnik odpowiedzi nie przesądza jeszcze o obciążeniu. Problem pojawia się wtedy, gdy decyzja o udziale wiąże się z badaną cechą. Mechanizm ten opisuje hasło błąd braku odpowiedzi.
Oś 3. Kanał: CAWI, CATI, CAPI, PAPI i badania mieszane
Trzecia oś to tryb zbierania danych. Skróty pochodzą od angielskich nazw:
- CAWI (computer-assisted web interviewing) – ankieta internetowa wypełniana samodzielnie, np. w Google Forms czy LimeSurvey;
- CATI (computer-assisted telephone interviewing) – wywiad telefoniczny, w którym ankieter czyta pytania i zapisuje odpowiedzi w programie;
- CAPI (computer-assisted personal interviewing) – wywiad twarzą w twarz z tabletem lub laptopem;
- PAPI (paper-and-pencil interviewing) – kwestionariusz papierowy, wypełniany samodzielnie (np. w sali wykładowej) albo z ankieterem;
- badanie mieszane (mixed-mode) – kilka trybów w jednym badaniu, np. zaproszenie listowne z linkiem i papierowa wersja dla osób bez internetu.
Tryb wpływa na trzy rzeczy naraz. Pierwsza to kto odpowie. W metaanalizie 114 eksperymentalnych porównań ankiety internetowe miały średnio o około 12 punktów procentowych niższy odsetek odpowiedzi niż inne tryby (Daikeler i in., 2020). Druga to jak szczerze ludzie odpowiadają. W badaniu Kreuter i in. (2008) ankieta internetowa sprzyjała ujawnianiu informacji drażliwych i dawała trafniejsze odpowiedzi niż wywiad telefoniczny. Jednym z wyjaśnień jest to, że obecność ankietera nasila odpowiadanie zgodne z aprobatą społeczną. Trzecia to jakość danych: w ankiecie samodzielnej nikt nie pilnuje uwagi respondenta, więc potrzebujesz pytań kontrolnych i rejestracji czasu. Dillman i in. (2014) poświęcają cały podręcznik temu, jak dopasować projekt ankiety do trybu, by zwiększyć odsetek odpowiedzi i jakość danych.
W pracy dyplomowej zwykle wybierasz CAWI z powodów praktycznych. Pamiętaj tylko, że łączenie trybów (część osób online, część na papierze) wprowadza możliwe różnice wynikające z samego trybu. Jeżeli to robisz, zapisz tryb jako zmienną i sprawdź, czy wyniki od niego zależą.
Oś 4. Cel: opis, wyjaśnianie, ewaluacja, eksperyment
Ostatnia oś decyduje o tym, który z błędów opisanych wyżej jest dla Ciebie najgroźniejszy.
- Badanie opisowe (sondażowe) odpowiada na pytania typu „jaki odsetek studentów…”, „jak często…”. Tu liczy się przede wszystkim dobór i brak odpowiedzi, bo celem jest oszacowanie wartości w populacji. Przy próbie wygodnej odsetek z ankiety trudno obronić jako oszacowanie populacyjne.
- Badanie wyjaśniające (korelacyjne) pyta o związki: czy wsparcie wiąże się ze stresem, czy kobiety i mężczyźni różnią się samooceną. Taki schemat korelacyjny jest mniej wrażliwy na skład próby niż szacowanie odsetków, ale nie jest na niego odporny – pokazuje to symulacja niżej.
- Badanie ewaluacyjne ocenia program, zajęcia czy usługę, często z pomiarem przed i po. Bez grupy porównawczej zmiana może wynikać z wielu przyczyn innych niż sam program.
- Eksperyment ankietowy losowo przydziela respondentów do wersji kwestionariusza, np. w eksperymencie winietowym. Losowy przydział chroni porównanie wersji, nawet gdy sama próba jest wygodna. Wynik dotyczy jednak osób, które wzięły udział, a jego uogólnienie zależy od tego, czy efekt jest podobny w innych grupach.
- Badanie metodologiczne sprawdza samo narzędzie: rzetelność, strukturę czynnikową, normy. Tu dobór ma znaczenie szczególnie przy normach, bo te muszą odnosić się do określonej populacji.
Symulacja: błąd pokrycia i autoselekcja na liczbach
Żeby zobaczyć konsekwencje doboru i kanału, zasymulowano populację 20 000 studentów jednej uczelni (dane symulowane). Każdy ma średni wynik na skali samotności (1–5) i deklarowany czas spędzany w mediach społecznościowych. W populacji średnia samotność wynosi 2.55, wysoki poziom samotności (wynik co najmniej 3.4) ma 8.48% studentów, a korelacja czasu w mediach z samotnością to r = .23. Do studenckich grup w mediach społecznościowych należy 43.2% osób, częściej te spędzające tam więcej czasu (średnio 3.71 h dziennie wobec 2.35 h u osób spoza grup).
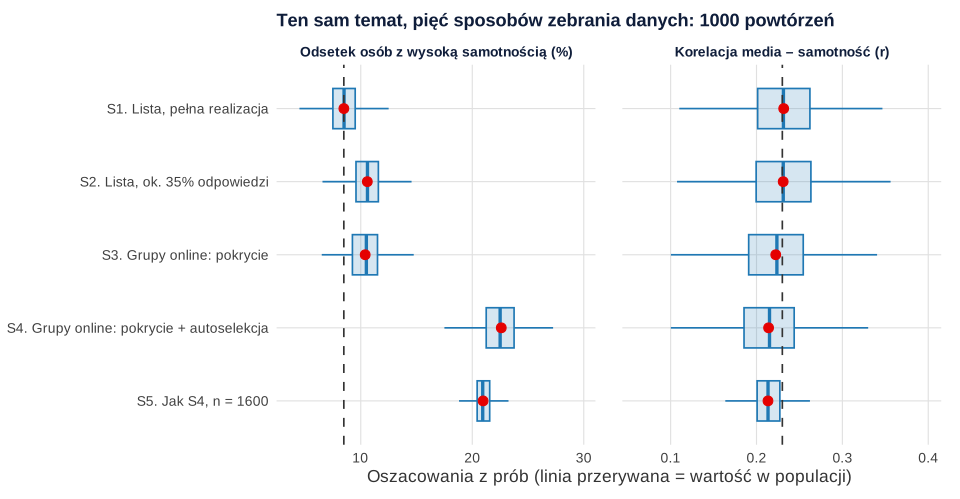
Porównano pięć sposobów zebrania danych, każdy powtórzony 1000 razy:
- S1. Losowanie 400 osób z listy studentów; wszyscy odpowiadają (wzorzec teoretyczny).
- S2. Imienne zaproszenia e-mailem do osób wylosowanych z listy. Odpowiada średnio 34.9%, przy czym osoby bardziej samotne odpowiadają nieco częściej; średnio 400 odpowiedzi.
- S3. Ogłoszenie w grupach studenckich, w którym 400 respondentów wybiera się losowo spośród członków grup. To czysty błąd pokrycia: poza zasięgiem badania zostaje 56.8% populacji.
- S4. Ogłoszenie w grupach z samodzielnym zgłaszaniem się: osoby, dla których temat samotności jest bliski, chętniej klikają w link. Do błędu pokrycia dochodzi więc autoselekcja.
- S5. Jak S4, ale zebrano 1600 osób zamiast 400.
| Schemat | Odsetek z wysoką samotnością (%) | Obciążenie (p.p.) | 95% CI obejmuje prawdę | Średnia samotność | r |
|---|---|---|---|---|---|
| Populacja | 8.48 | – | – | 2.55 | .23 |
| S1. Lista, pełna realizacja | 8.48 | 0.00 | 93.6% | 2.55 | .23 |
| S2. Lista, ok. 35% odpowiedzi | 10.59 | 2.11 | 76.4% | 2.63 | .23 |
| S3. Grupy online: pokrycie | 10.40 | 1.92 | 80.1% | 2.62 | .22 |
| S4. Grupy online: pokrycie + autoselekcja | 22.60 | 14.12 | 0.0% | 2.94 | .21 |
| S5. Jak S4, n = 1600 | 20.97 | 12.49 | 0.0% | 2.91 | .21 |
Z symulacji płyną cztery wnioski.
- Losowanie z pełną realizacją trafia w cel. Średnie oszacowanie odsetka wynosi 8.48%, a 95% przedział ufności obejmuje prawdziwą wartość w 93.6% prób, czyli tak, jak obiecuje teoria.
- Błąd pokrycia i brak odpowiedzi przesuwają wynik, nawet gdy dobór jest losowy w obrębie dostępnej grupy. W S3 przedział ufności obejmuje prawdę już tylko w 80.1% prób, bo z badania wypadają osoby spoza grup, mniej samotne. W S2 osoby samotne nieco chętniej odpowiadają, więc odsetek rośnie do 10.59%.
- Autoselekcja zmienia odsetek najbardziej. W S4 odsetek osób z wysoką samotnością wynosi średnio 22.60%, czyli prawie trzy razy więcej niż w populacji, i żaden przedział ufności nie obejmuje prawdziwej wartości. Bethlehem (2010) dochodzi do podobnego wniosku: o ile problem pokrycia w ankietach internetowych może z czasem maleć, samoselekcja prowadzi do niewiarygodnych oszacowań.
- Większa próba nie naprawia doboru. W S5, przy 1600 osobach, obciążenie odsetka wynosi wciąż 12.49 punktu procentowego. Zmalał tylko rozrzut oszacowań (odchylenie standardowe korelacji spadło z 0.044 do 0.019), więc wynik jest bardziej precyzyjny, ale wokół złej wartości. Dlatego liczebność próby w ankiecie nie zastąpi dobrego doboru.
Korelacja zmieniała się w symulacji niewiele – od .23 do .21. Nie traktuj tego jako reguły. Tutaj o udziale decydowała jedna zmienna (samotność), a selekcja na jednej zmiennej osłabia korelację głównie przez zawężenie jej zakresu. Mercer i in. (2017) opisują, że wielkość obciążenia w próbach nieprobabilistycznych zależy od tego, czy zmienne wpływające na udział da się zmierzyć i uwzględnić. Gdy udział zależy jednocześnie od obu badanych zmiennych, korelacja w próbie może być zawyżona, zaniżona, a nawet mieć odwrotny znak. Związki są zwykle mniej wrażliwe na dobór niż odsetki, ale nie są na niego odporne.
Jak wybrać rodzaj badania do pytania
Zacznij od pytania badawczego, a dopiero potem dobierz schemat. Poniższa tabela pokazuje typowe pytania z prac dyplomowych i minimalny schemat, który na nie odpowiada.
| Pytanie badawcze | Czas | Dobór | Co napisać w ograniczeniach |
|---|---|---|---|
| Jaki odsetek studentów uczelni ma objawy wypalenia? | przekrojowe | losowy z listy, z przypomnieniami | wskaźnik odpowiedzi i porównanie respondentów z populacją |
| Czy wsparcie społeczne wiąże się ze stresem? | przekrojowe | wygodny lub celowy, zróżnicowany | brak kolejności czasowej, ograniczony zasięg uogólnień |
| Czy stres rośnie w trakcie semestru? | panelowe (2–3 pomiary) | dowolny, z kodem łączącym pomiary | odpadanie uczestników, porównanie osób, które zostały i odeszły |
| Czy sposób sformułowania pytania zmienia odpowiedź? | przekrojowe z losowym przydziałem wersji | wygodny | na kim sprawdzono efekt; czy uogólnia się na inne grupy |
| Czy odsetek palących studentów zmienia się z roku na rok? | trendowe | ten sam sposób doboru w każdej edycji | zmiany w kwestionariuszu i doborze między edycjami |
Jeżeli Twoje pytanie wymaga oszacowania populacyjnego, a możesz zebrać tylko próbę wygodną, rozważ przeformułowanie celu na pytanie o związek. Możesz też porównać strukturę próby z danymi o populacji i rozważyć ważenie danych, pamiętając, że wagi korygują tylko cechy, które uwzględniasz. Jak przeprowadzić takie porównanie, pokazuje wpis jak opisać charakterystykę próby badawczej. Rekrutację respondentów omawia osobny poradnik: gdzie znaleźć respondentów do ankiety.
Jak opisać rodzaj badania w pracy
W podrozdziale o schemacie badania nazwij wszystkie cztery osie jednym lub dwoma zdaniami. Potem opisz w procedurze, jak i gdzie rozpowszechniano ankietę. Wzór dla typowej pracy dyplomowej:
Dla badania panelowego dopisz liczbę i odstępy pomiarów, sposób łączenia odpowiedzi tej samej osoby (np. kod tworzony przez respondenta) i liczbę osób w każdym pomiarze. Dla próby losowej podaj operat, sposób losowania, liczbę zaproszeń, przypomnień i wskaźnik odpowiedzi. Kolejne kroki – od surowego eksportu do wyników – opisuje wpis o analizie ankiety do pracy dyplomowej. Jeśli chcesz skonsultować wybór schematu albo zakres wniosków, które możesz wyciągnąć z zebranej próby, sprawdź ofertę dla studentów.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunku. Uruchom oba przepisy po kolei w jednej sesji R – drugi korzysta z populacji utworzonej w pierwszym. Symulacja 5000 prób trwa kilkadziesiąt sekund i nie wymaga dodatkowych pakietów.
1. Symulowana populacja i mechanizmy udziału
R
# Symulowana populacja 20 000 studentów jednej uczelni (dane symulowane)
set.seed(2020)
N <- 20000
media <- round(exp(rnorm(N, log(2.6), 0.5)), 1)           # godziny dziennie w mediach społecznościowych
z_media <- as.numeric(scale(log(media)))
lat <- 0.25 * z_media + rnorm(N, 0, sqrt(1 - 0.25^2))
samotnosc <- pmin(pmax(round(2.55 + 0.62 * lat, 2), 1), 5)  # średnia skali samotności 1–5
pop <- data.frame(media, samotnosc, wysoka = samotnosc >= 3.4)
z_sam <- as.numeric(scale(samotnosc))

# Kto może trafić do próby i kto odpowie
pop$w_grupach  <- rbinom(N, 1, plogis(-0.35 + 1.1 * z_media)) == 1   # członek studenckich grup online (pokrycie)
pop$sklonnosc  <- plogis(-2.6 + 0.6 * z_sam)                         # zainteresowanie tematem → udział z ogłoszenia
pop$odp_list   <- plogis(-0.63 + 0.2 * z_sam)                       # odpowiedź na imienne zaproszenie e-mailem

prawda <- c(M = mean(pop$samotnosc), proc_wysoka = 100 * mean(pop$wysoka), r = cor(pop$media, pop$samotnosc))
round(prawda, 3)
round(c(proc_w_grupach = 100 * mean(pop$w_grupach), poza_grupami = 100 * mean(!pop$w_grupach),
        odp_list = 100 * mean(pop$odp_list)), 1)
# Czym różnią się osoby objęte i nieobjęte ogłoszeniem w grupach
round(sapply(split(pop[, c("media", "samotnosc", "wysoka")], pop$w_grupach), colMeans), 2)
Wynik w R
          M proc_wysoka           r
      2.546       8.480       0.230
proc_w_grupach   poza_grupami       odp_list
          43.2           56.8           34.9
          FALSE TRUE
media      2.35 3.71
samotnosc  2.49 2.62
wysoka     0.07 0.10
2. Pięć schematów zbierania danych, 1000 powtórzeń
R
# 1000 powtórzeń pięciu sposobów zebrania danych z tej samej populacji
schematy <- c("Losowanie z listy, pełna realizacja", "Losowanie z listy, ok. 35% odpowiedzi",
              "Ogłoszenie w grupach: tylko pokrycie", "Ogłoszenie w grupach: pokrycie + autoselekcja",
              "Jak wyżej, ale n = 1600")
jedna_proba <- function(s, n = 400) {
  idx <- switch(s,
    sample(N, n),
    { zapr <- sample(N, round(n / mean(pop$odp_list))); zapr[runif(length(zapr)) < pop$odp_list[zapr]] },
    sample(which(pop$w_grupach), n),
    { g <- which(pop$w_grupach); sample(g, n, prob = pop$sklonnosc[g]) },
    { g <- which(pop$w_grupach); sample(g, 1600, prob = pop$sklonnosc[g]) })
  x <- pop[idx, ]
  m <- mean(x$samotnosc); se_m <- sd(x$samotnosc) / sqrt(nrow(x))
  p <- mean(x$wysoka); se_p <- sqrt(p * (1 - p) / nrow(x))
  c(n = nrow(x), M = m, pokr_M = abs(m - prawda[["M"]]) <= 1.96 * se_m,
    proc = 100 * p, pokr_p = abs(p - prawda[["proc_wysoka"]] / 100) <= 1.96 * se_p,
    r = cor(x$media, x$samotnosc))
}
set.seed(2021)
wyniki <- do.call(rbind, lapply(1:5, function(s)
  data.frame(schemat = schematy[s], t(replicate(1000, jedna_proba(s))))))
podsum <- do.call(rbind, lapply(split(wyniki, factor(wyniki$schemat, levels = schematy)), function(w)
  c(n = mean(w$n), M = mean(w$M), obc_M = mean(w$M) - prawda[["M"]], pokrycie_CI_M = 100 * mean(w$pokr_M),
    proc = mean(w$proc), obc_proc = mean(w$proc) - prawda[["proc_wysoka"]], pokrycie_CI_proc = 100 * mean(w$pokr_p),
    r = mean(w$r), obc_r = mean(w$r) - prawda[["r"]], SD_r = sd(w$r))))
rownames(podsum) <- paste0("S", 1:5)
round(podsum, 3)
round(podsum[, c("M", "proc", "obc_proc", "r")], 2)            # zaokrąglenia do tekstu
Wynik w R
          n     M obc_M pokrycie_CI_M   proc obc_proc pokrycie_CI_proc     r
S1  400.000 2.546 0.000          94.4  8.484    0.004             93.6 0.232
S2  400.266 2.626 0.080          27.4 10.588    2.108             76.4 0.231
S3  400.000 2.622 0.076          31.6 10.396    1.916             80.1 0.222
S4  400.000 2.944 0.399           0.0 22.601   14.121              0.0 0.214
S5 1600.000 2.915 0.369           0.0 20.971   12.491              0.0 0.213
    obc_r  SD_r
S1  0.002 0.047
S2  0.001 0.047
S3 -0.008 0.045
S4 -0.016 0.044
S5 -0.017 0.019
      M  proc obc_proc    r
S1 2.55  8.48     0.00 0.23
S2 2.63 10.59     2.11 0.23
S3 2.62 10.40     1.92 0.22
S4 2.94 22.60    14.12 0.21
S5 2.91 20.97    12.49 0.21
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe); rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy opisie rodzaju badania ankietowego
- „Badanie miało charakter ilościowy” jako jedyny opis schematu. To informacja o rodzaju danych, a nie o schemacie. Dopisz czas, dobór, kanał i cel.
- „Próba reprezentatywna” przy ankiecie z mediów społecznościowych. Zgodność odsetka kobiet z populacją nie czyni próby reprezentatywną. Pisz „próba wygodna” i opisz, gdzie rozpowszechniano link.
- Margines błędu dla próby wygodnej. Wzór na margines błędu zakłada losowanie. Przy autoselekcji przedział ufności mierzy tylko zmienność losową wokół obciążonej wartości – w symulacji nie objął prawdy ani razu.
- „Wpływ” i „przyczyna” w badaniu przekrojowym. Jeden pomiar nie ustala kolejności czasowej. Pisz o związku, a hipotezy przyczynowe przenieś do dyskusji jako możliwe wyjaśnienia.
- Zbieranie „jak największej liczby ankiet” zamiast lepszego doboru. Dodatkowe setki osób z tego samego źródła zmniejszają rozrzut, ale nie obciążenie.
- Pominięcie trybu przy łączeniu źródeł. Jeżeli część osób wypełniła ankietę na papierze, a część online, zapisz to w bazie i sprawdź, czy wyniki się różnią.
- Badanie panelowe bez analizy odpadania. Porównaj osoby, które wzięły udział w obu pomiarach, z tymi, które odpadły – choćby pod względem wyniku z pierwszego pomiaru.
Najczęstsze pytania
Czym różni się badanie panelowe od trendowego?
W badaniu panelowym te same osoby odpowiadają kilka razy, więc widać zmianę u poszczególnych osób. W badaniu trendowym w każdej edycji bada się nową próbę z tej samej populacji, więc widać zmianę na poziomie populacji, ale nie u ludzi. Panel jest bardziej podatny na odpadanie uczestników, badanie trendowe – na zmiany w doborze między edycjami.
Co oznaczają skróty CAWI, CATI, CAPI i PAPI?
To tryby zbierania danych: CAWI – ankieta internetowa wypełniana samodzielnie, CATI – wywiad telefoniczny wspomagany komputerowo, CAPI – wywiad osobisty z tabletem lub laptopem, PAPI – kwestionariusz papierowy. Tryb wpływa na to, kto odpowie, jak szczerze i z jaką starannością.
Czy ankieta udostępniona w mediach społecznościowych może być reprezentatywna?
Zwykle nie. Taka ankieta łączy błąd pokrycia (badanie nie dociera do osób spoza grup) z autoselekcją (zgłaszają się osoby zainteresowane tematem). W pracy nazwij ją próbą wygodną, opisz kanały rozpowszechniania i ostrożnie formułuj zasięg wniosków, zwłaszcza o odsetkach.
Czy większa liczba ankiet zmniejsza błąd autoselekcji?
Nie. Większa próba zmniejsza błąd losowy, czyli rozrzut wyników, ale nie obciążenie wynikające z tego, kto się zgłasza. W symulacji na tej stronie zwiększenie próby z 400 do 1600 osób pozostawiło zawyżenie odsetka o ponad 12 punktów procentowych.
Jak napisać w pracy, jaki był rodzaj badania ankietowego?
Nazwij czas pomiaru (np. przekrojowe), sposób doboru (np. próba wygodna), tryb (np. ankieta internetowa CAWI) i cel (np. badanie korelacyjne), podaj okres i kanały zbierania danych oraz konsekwencje dla wniosków. Gotowy akapit znajdziesz w sekcji z wzorem opisu schematu.
Powiązane hasła
Przeczytaj też
Jak zrobić ankietę do pracy dyplomowej
12 kroków od hipotez do czystych danych: skale, pytania, zgoda, pilotaż, Google Forms czy LimeSurvey, książka kodów, harmonogram i lista kontrolna.
Czytaj →PoradnikGdzie znaleźć respondentów do ankiety?
Uczelnia, grupy tematyczne, kula śnieżna, panele i wymiana ankiet – porównanie kanałów, wzór zaproszenia, liczba zaproszeń i opis próby w pracy.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →Nie wiesz, jaki schemat badania ankietowego wybrać?
Pomożemy dopasować schemat i dobór próby do pytania badawczego oraz ocenić, jakie wnioski uprawnia zebrana próba – tak, abyś umiał(a) je uzasadnić w pracy.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Baker, R., Brick, J. M., Bates, N. A., Battaglia, M., Couper, M. P., Dever, J. A., Gile, K. J., & Tourangeau, R. (2013). Summary report of the AAPOR Task Force on Non-probability Sampling. Journal of Survey Statistics and Methodology, 1(2), 90–143. https://doi.org/10.1093/jssam/smt008
- Berndt, A. E. (2020). Sampling methods. Journal of Human Lactation, 36(2), 224–226. https://doi.org/10.1177/0890334420906850
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x ● Otwarty dostęp
- Cornesse, C., Blom, A. G., Dutwin, D., Krosnick, J. A., De Leeuw, E. D., Legleye, S., Pasek, J., Pennay, D., Phillips, B., Sakshaug, J. W., Struminskaya, B., & Wenz, A. (2020). A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research. Journal of Survey Statistics and Methodology, 8(1), 4–36. https://doi.org/10.1093/jssam/smz041 ● Otwarty dostęp
- Daikeler, J., Bošnjak, M., & Lozar Manfreda, K. (2020). Web versus other survey modes: An updated and extended meta-analysis comparing response rates. Journal of Survey Statistics and Methodology, 8(3), 513–539. https://doi.org/10.1093/jssam/smz008
- Dillman, D. A., Smyth, J. D., & Christian, L. M. (2014). Internet, phone, mail, and mixed-mode surveys: The tailored design method (4th ed.). Wiley. https://doi.org/10.1002/9781394260645
- Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
- Groves, R. M., & Lyberg, L. (2010). Total survey error: Past, present, and future. Public Opinion Quarterly, 74(5), 849–879. https://doi.org/10.1093/poq/nfq065
- Kreuter, F., Presser, S., & Tourangeau, R. (2008). Social desirability bias in CATI, IVR, and web surveys: The effects of mode and question sensitivity. Public Opinion Quarterly, 72(5), 847–865. https://doi.org/10.1093/poq/nfn063 ● Otwarty dostęp
- Mercer, A. W., Kreuter, F., Keeter, S., & Stuart, E. A. (2017). Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference. Public Opinion Quarterly, 81(S1), 250–271. https://doi.org/10.1093/poq/nfw060 ● Otwarty dostęp
- Ployhart, R. E., & Vandenberg, R. J. (2010). Longitudinal research: The theory, design, and analysis of change. Journal of Management, 36(1), 94–120. https://doi.org/10.1177/0149206309352110
- Setia, M. S. (2016). Methodology series module 3: Cross-sectional studies. Indian Journal of Dermatology, 61(3), 261–264. https://doi.org/10.4103/0019-5154.182410 ● Otwarty dostęp
Cytowania BibTeX
@article{baker2013summary, author={Baker, R. and Brick, J. M. and Bates, N. A. and Battaglia, M. and Couper, M. P. and Dever, J. A. and Gile, K. J. and Tourangeau, R.}, title={{Summary report of the AAPOR Task Force on Non-probability Sampling}}, journal={Journal of Survey Statistics and Methodology}, year={2013}, volume={1}, number={2}, pages={90--143}, doi={10.1093/jssam/smt008}}@article{berndt2020sampling, author={Berndt, Andrea E.}, title={{Sampling methods}}, journal={Journal of Human Lactation}, year={2020}, volume={36}, number={2}, pages={224--226}, doi={10.1177/0890334420906850}}@article{bethlehem2010selection, author={Bethlehem, Jelke}, title={{Selection bias in web surveys}}, journal={International Statistical Review}, year={2010}, volume={78}, number={2}, pages={161--188}, doi={10.1111/j.1751-5823.2010.00112.x}}@article{cornesse2020review, author={Cornesse, Carina and Blom, Annelies G. and Dutwin, David and Krosnick, Jon A. and De Leeuw, Edith D. and Legleye, Stéphane and Pasek, Josh and Pennay, Darren and Phillips, Benjamin and Sakshaug, Joseph W. and Struminskaya, Bella and Wenz, Alexander}, title={{A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={1}, pages={4--36}, doi={10.1093/jssam/smz041}}@article{daikeler2020web, author={Daikeler, Jessica and Bošnjak, Michael and Lozar Manfreda, Katja}, title={{Web versus other survey modes: An updated and extended meta-analysis comparing response rates}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={3}, pages={513--539}, doi={10.1093/jssam/smz008}}@book{dillman2014internet, author={Dillman, Don A. and Smyth, Jolene D. and Christian, Leah Melani}, title={{Internet, phone, mail, and mixed-mode surveys: The tailored design method (4th ed.)}}, year={2014}, publisher={Wiley}, doi={10.1002/9781394260645}}@article{groves2006nonresponse, author={Groves, Robert M.}, title={{Nonresponse rates and nonresponse bias in household surveys}}, journal={Public Opinion Quarterly}, year={2006}, volume={70}, number={5}, pages={646--675}, doi={10.1093/poq/nfl033}}@article{groves2010total, author={Groves, Robert M. and Lyberg, Lars}, title={{Total survey error: Past, present, and future}}, journal={Public Opinion Quarterly}, year={2010}, volume={74}, number={5}, pages={849--879}, doi={10.1093/poq/nfq065}}@article{kreuter2008social, author={Kreuter, F. and Presser, S. and Tourangeau, R.}, title={{Social desirability bias in CATI, IVR, and web surveys: The effects of mode and question sensitivity}}, journal={Public Opinion Quarterly}, year={2008}, volume={72}, number={5}, pages={847--865}, doi={10.1093/poq/nfn063}}@article{mercer2017theory, author={Mercer, Andrew W. and Kreuter, Frauke and Keeter, Scott and Stuart, Elizabeth A.}, title={{Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference}}, journal={Public Opinion Quarterly}, year={2017}, volume={81}, number={S1}, pages={250--271}, doi={10.1093/poq/nfw060}}@article{ployhart2010longitudinal, author={Ployhart, Robert E. and Vandenberg, Robert J.}, title={{Longitudinal research: The theory, design, and analysis of change}}, journal={Journal of Management}, year={2010}, volume={36}, number={1}, pages={94--120}, doi={10.1177/0149206309352110}}@article{setia2016methodology, author={Setia, Maninder Singh}, title={{Methodology series module 3: Cross-sectional studies}}, journal={Indian Journal of Dermatology}, year={2016}, volume={61}, number={3}, pages={261--264}, doi={10.4103/0019-5154.182410}}