Zanim zaczniesz: kogo potrzebujesz i ilu?
Post „Potrzebuję 100 osób do ankiety, proszę o wypełnienie!” zbierze odpowiedzi, ale rzadko takie, jakich potrzebujesz. Zanim wybierzesz kanał rekrutacji, odpowiedz na trzy pytania:
- Kto jest Twoją populacją? Wnioski z badania mają dotyczyć konkretnej grupy – np. studentów studiów stacjonarnych, rodziców dzieci w wieku przedszkolnym albo osób pracujących zdalnie.
- Jakie są kryteria włączenia i wyłączenia? Zapisz je i zamień na pytania kwalifikujące na początku ankiety (np. „Czy masz dziecko w wieku 3–6 lat?”). Osoby spoza kryteriów od razu przekieruj na stronę z podziękowaniem, a pozostałe cechy zbierz w metryczce.
- Ilu osób potrzebujesz – razem i w każdej porównywanej grupie? Jeśli porównujesz np. osoby pracujące i niepracujące, zaplanuj kanały, przez które dotrzesz do obu grup.
Od tych odpowiedzi zależy wybór kanału: rodziców przedszkolaków nie znajdziesz na zajęciach z psychologii, a studentów pierwszego roku – w grupie dla rodziców. Upewnij się też, że sama ankieta jest gotowa: przetestowana, z czasem zmierzonym w pilotażu i bez typowych usterek, które opisujemy we wpisie najczęstsze błędy w ankietach. Zaproszenie do wadliwej ankiety marnuje respondentów, których drugi raz już nie poprosisz.
Kanały rekrutacji – porównanie
Każdy kanał daje inną próbę. Tabela zestawia kanały, z których najczęściej korzystają studenci i młodzi badacze, wraz z nazwą doboru, której użyjesz w rozdziale metodologicznym.
| Kanał | Kogo realnie zbierzesz | Koszt i tempo | Główne ryzyko | Nazwa doboru w pracy |
|---|---|---|---|---|
| Uczelnia: zajęcia, wykładowcy, samorząd | Studentów Twojej uczelni, często jednego kierunku | Bezpłatnie; szybko, gdy prowadzący się zgodzą | Jednorodna próba; presja, gdy ankietę przekazuje prowadzący zajęcia | Dobór wygodny |
| Grupy tematyczne i media społecznościowe | Aktywnych członków grup; dobre dla populacji o wspólnym zainteresowaniu (rodzice, gracze, sportowcy) | Posty bezpłatnie, reklamy płatnie; tempo trudne do przewidzenia | Samoselekcja; nadreprezentacja osób aktywnych w sieci | Dobór wygodny; przy grupach wybranych według kryterium – dobór celowy |
| Ogłoszenia, fora, strony i organizacje tematyczne | Populacje trudno dostępne, dla których nie ma listy do losowania | Niski koszt | Niedopokrycie i samoselekcja | Dobór wygodny (tzw. river sampling) |
| Kula śnieżna | Znajomych i znajomych znajomych | Bezpłatnie | Osoby podobne do pierwszych uczestników; łańcuch poleceń może zamrzeć | Metoda kuli śnieżnej |
| Platformy i panele (Prolific, CloudResearch, MTurk, panele komercyjne) | Zróżnicowane, często międzynarodowe próby; filtrowanie według kryteriów | Płatne: wynagrodzenie uczestników i opłata platformy; bardzo szybko | Doświadczeni uczestnicy, nieuważność, boty; różna jakość platform | Dobór nieprobabilistyczny z panelu internetowego, często z kwotami |
| Wymiana ankiet | Studentów i osoby prowadzące własne badania | Bezpłatnie – płacisz czasem na wypełnianie cudzych ankiet | Jednorodność, uczestnicy „wyćwiczeni” w ankietach, pośpiech „za punkty” | Dobór wygodny (serwis wymiany ankiet) |
| Losowanie z listy (np. lista studentów, rejestr) | Populację objętą listą | Czasochłonnie; wymaga zgód i dostępu do listy | Braki odpowiedzi | Próba losowa |
W praktyce prace dyplomowe łączą zwykle dwa–trzy kanały. To dobra strategia, pod warunkiem że zapiszesz, skąd pochodzi każda odpowiedź – na przykład pytaniem na końcu ankiety „Skąd dowiedziałeś(-aś) się o badaniu?” albo osobnym linkiem dla każdego kanału. Ogólny podział badań ankietowych według sposobu rekrutacji i kanału zbierania danych opisujemy we wpisie rodzaje badań ankietowych.
Uczelnia: zajęcia, wykładowcy, samorząd
Dla wielu prac licencjackich i magisterskich to najprostszy kanał. Kilka zasad:
- poproś prowadzących o pięć minut na początku zajęć, a nie na końcu, i wyświetl kod QR z linkiem;
- podkreśl, że udział jest dobrowolny i nie wpływa na zaliczenie – szczególnie gdy ankietę przekazuje osoba prowadząca zajęcia;
- wiadomości do studentów wysyłaj tylko oficjalnymi kanałami (dziekanat, samorząd, system uczelni) i za zgodą;
- zaplanuj kilka kierunków lub lat studiów, żeby próba nie była jednorodna.
Ograniczenie jest oczywiste: wyniki opisują studentów tej uczelni i tych kierunków. Andrade (2021) przypomina, że wyniki uzyskane na próbach wygodnych i celowych można uogólniać tylko na (sub)populację, z której je pobrano, a nie na całą populację. Studenckie pule uczestników nie gwarantują też jakości danych: w porównaniu pięciu źródeł uczestnicy z platform Prolific i CloudResearch częściej niż osoby ze studenckiej puli SONA (a także z MTurk i paneli Qualtrics) zdawali pytania kontrolne, udzielali sensownych odpowiedzi i pracowali na tyle wolno, by przeczytać pozycje (Douglas i in., 2023). Pytanie kontrolne przyda się więc także w ankiecie dla studentów.
Media społecznościowe, grupy tematyczne i ogłoszenia
Grupy na Facebooku, społeczności na Discordzie czy Reddicie, fora i profile tematyczne pozwalają dotrzeć do konkretnych populacji. Przegląd systematyczny 110 badań rekrutujących przez Facebooka pokazał, że koszt pozyskania jednego uczestnika wynosił od 1.36 do 110 USD (średnio 17.48 USD), a większość badań, które oceniały reprezentatywność (86%), uznała próby z Facebooka za podobnie reprezentatywne jak rekrutowane tradycyjnie (Thornton i in., 2016). Darmowy post w grupie nic nie kosztuje, ale jego zasięgu nie da się przewidzieć.
Ten sam mechanizm działa poza mediami społecznościowymi. Skalec-Ruczyńska (2024) opisała, jak przez banery, ogłoszenia, fora, e-maile i strony tematyczne dotrzeć do zawodowych rodzin zastępczych w Polsce – trudno dostępnej populacji, dla której nie ma listy do losowania. Taki dobór (ang. river sampling) jest szybki i tani, ale obciążony niedopokryciem i samoselekcją. Praktyczne zasady:
- wybieraj grupy, w których naturalnie przebywa Twoja populacja – post w grupie „ankiety do prac” trafi głównie do innych studentów zbierających odpowiedzi;
- przeczytaj regulamin grupy i zapytaj administratorów o zgodę;
- w pierwszym zdaniu napisz, kogo szukasz i ile potrwa ankieta;
- odpowiadaj na komentarze i przypomnij o badaniu po kilku dniach, zamiast wklejać post codziennie;
- płatna reklama pozwala wybrać wiek, region i zainteresowania odbiorców, ale nie usuwa samoselekcji – ankietę wypełnią ci, którzy zechcą kliknąć.
Kula śnieżna: znajomi i znajomi znajomych
W metodzie kuli śnieżnej zaczynasz od kilku osób spełniających kryteria („ziaren”), które polecają kolejne, aż do uzyskania zakładanej liczebności lub nasycenia. To popularna strategia w badaniach jakościowych, a jej ograniczeniem są m.in. łańcuchy poleceń, które „zamierają” (Parker i in., 2019). Sprawdza się, gdy populacja jest mała lub ukryta, a jej członkowie się znają – np. osoby z rzadkim doświadczeniem albo pracownicy jednej branży.
W ankiecie ilościowej pamiętaj o dwóch rzeczach: osoby z jednego łańcucha są do siebie podobne, a znajomi, którzy znają Twoje hipotezy, mogą odpowiadać „pod tezę”. Na stronie końcowej poproś o przekazanie linku osobom, które spełniają kryteria, i zapisz, z której fali pochodzi odpowiedź. Różnice między doborem wygodnym, celowym i kulą śnieżną wyjaśniamy w haśle dobór celowy, dobór wygodny i metoda kuli śnieżnej.
Panele badawcze i platformy typu Prolific
Platformy crowdsourcingowe (Prolific, CloudResearch, Amazon Mechanical Turk) i komercyjne panele internetowe płacą uczestnikom za udział. Dają szybki dostęp do dużych i zróżnicowanych prób, ale jakość danych wyraźnie się między nimi różni:
- w dwóch badaniach (N ≈ 4000) porównano platformy (MTurk, CloudResearch, Prolific) i panele (Qualtrics, Dynata): bez filtrów jedynie Prolific zapewniał wysoką jakość we wszystkich miarach – uwagi, rozumienia, uczciwości i rzetelności – z filtrami także CloudResearch, a MTurk wypadał alarmująco słabo nawet z filtrami (Peer i in., 2022);
- w porównaniu Douglas i in. (2023) koszt jednego respondenta wysokiej jakości był najniższy w Prolific (1.90 USD) i CloudResearch (2.00 USD);
- uczestnicy z agregatora paneli Prime Panels byli bardziej zróżnicowani demograficznie i rzadziej znali klasyczne procedury badawcze niż użytkownicy MTurk; autorzy podkreślają, że panele dają nowe możliwości, ale z istotnymi kompromisami (Chandler i in., 2019).
Nowym zagrożeniem są boty oparte na dużych modelach językowych. Westwood (2025) zbudował autonomicznego „syntetycznego respondenta”, który zaliczył 99.8% z 6000 prób standardowych pytań kontrolnych, utrzymywał spójną personę demograficzną i potrafił generować dane „potwierdzające” domyślane hipotezy badacza. W niekontrolowanych badaniach online większość obecnych metod wykrywania jest wobec takich narzędzi nieskuteczna. Im łatwiej zarobić na wypełnianiu ankiety, tym ważniejsze są weryfikacja uczestników, kontrola czasu i spójności odpowiedzi – więcej piszemy o tym w haśle syntetyczni respondenci i we wpisie syntetyczni respondenci (LLM) w badaniach.
Dla studentów płatny panel ma sens, gdy jest budżet (np. grant studencki) i populacja, do której trudno dotrzeć inaczej. Przed zakupem sprawdź, ilu uczestników spełniających Twoje kryteria – np. polskojęzycznych – jest na platformie, i zaplanuj filtry jakości. Komercyjne panele często realizują próbę z kwotami (płeć, wiek, region), ale nadal jest to dobór nieprobabilistyczny – zob. próba kwotowa.
Wymiana ankiet (ankieta za ankietę)
W serwisach i grupach wymiany ankiet wypełniasz ankiety innych osób, a w zamian inni wypełniają Twoją. Takie serwisy działają za granicą, a w Polsce popularne są też grupy „wymiany ankiet” w mediach społecznościowych. Na metodolog.pl prowadzimy serwis Ankieta za ankietę dla pełnoletnich studentów: tworzysz w nim ankietę do swojego badania i wymieniasz się wypełnianiem z innymi użytkownikami, a autor ankiety nie widzi, kto ją wypełnił. Serwis ma też narzędzia do pracy dyplomowej: wyszukiwarkę artykułów, narzędzie do wielkości próby, bibliografię i tabele APA.
Ograniczenia tego kanału trzeba znać – także wtedy, gdy korzystasz z naszego serwisu:
- respondentami są głównie studenci i osoby prowadzące własne badania – podobny wiek, wykształcenie i często kierunek studiów;
- to osoby, które wypełniły już wiele ankiet – znają typowe skale i pytania kontrolne; problem takiej „nie-naiwności” uczestników opisano dotąd w innym kontekście, przy porównaniu MTurk z panelami (Chandler i in., 2019);
- część osób wypełnia ankiety „za punkty”, więc szybko – kontrola czasu i pytanie kontrolne są tu konieczne;
- nie znamy recenzowanych badań, które oceniałyby jakość danych z serwisów wymiany ankiet – nie da się więc podać, jak często takie odpowiedzi są nieuważne ani czym różnią się od odpowiedzi z innych kanałów.
Dlatego wymianę ankiet traktuj jako jeden z kanałów, a nie jedyne źródło danych – chyba że Twoją populacją są właśnie studenci. W pracy nazwij ją wprost („dobór wygodny; część uczestników zrekrutowano w serwisie wymiany ankiet”) i porównaj odpowiedzi z różnych kanałów. Cudze ankiety wypełniaj uważnie – tego samego oczekujesz od innych.
Ilu respondentów potrzebujesz i ile zaproszeń wysłać?
Liczebność wynika z planowanej analizy, a nie z tego, „ile się uda zebrać”. Zacznij od analizy mocy a priori. Dla porównania dwóch grup testem t przy α = .05 i mocy 80% do wykrycia efektu średniego (d = 0.5) potrzeba 64 osób w każdej grupie, czyli 128 razem, a do wykrycia efektu małego (d = 0.3) – 176 w grupie, czyli 352 razem (obliczenia w R poniżej). Jak uzasadnić liczebność w pracy, wyjaśniamy w poradniku dobór liczebności próby.
Potem dolicz straty. Część ankiet odrzucisz: niekompletne, od osób spoza kryteriów, nieuważne. Jeśli zakładasz, że odrzucisz 15%, potrzebujesz 151 ukończonych ankiet zamiast 128 (albo 415 zamiast 352). Gdy zapraszasz osoby z listy, np. e-mailem, liczbę zaproszeń wyznacza spodziewany odsetek odpowiedzi:
| Próba do analizy | Ukończone ankiety (zapas 15%) | Zwrot 10% | Zwrot 20% | Zwrot 30% | Zwrot 44.1% |
|---|---|---|---|---|---|
| 128 osób (d = 0.5) | 151 | 1510 | 755 | 504 | 343 |
| 352 osoby (d = 0.3) | 415 | 4150 | 2075 | 1384 | 942 |
Wartość 44.1% to średni zwrot z metaanalizy ankiet internetowych w opublikowanych badaniach edukacyjnych (Wu i in., 2022). Ponieważ wyższy zwrot wiązał się tam z jasno zdefiniowaną populacją i wcześniejszym kontaktem, przy anonimowych postach w grupach zakładaj raczej niższe wartości i rekrutuj kilkoma kanałami jednocześnie. Przy postach w mediach społecznościowych odsetka odpowiedzi nie da się zresztą policzyć, bo nie wiadomo, ile osób zobaczyło zaproszenie – w pracy podajesz wtedy, ile osób rozpoczęło i ukończyło ankietę.
Ile osób i ile zaproszeń? Kalkulacja w R
Kod liczy liczebność grup z analizy mocy dla testu t (funkcja power.t.test() z pakietu stats), dolicza zapas na wykluczenia i przelicza liczbę ukończonych ankiet na liczbę zaproszeń. Zmień parametry na własne: wielkość efektu, odsetek wykluczeń i spodziewany zwrot.
Od analizy mocy do liczby zaproszeń
R
# 1. Ilu osób potrzebujesz do analizy? Test t dla dwóch grup, alfa = .05, moc = .80
n_grupa <- sapply(c(d_0.5 = 0.5, d_0.3 = 0.3), function(d)
  ceiling(power.t.test(delta = d, sd = 1, sig.level = .05, power = .80)$n))
n_grupa                                     # osób w każdej z dwóch grup
n_analiza <- 2 * n_grupa                    # razem do analizy

# 2. Zapas na wykluczenia (np. 15% ankiet niekompletnych lub nieuważnych)
ukonczone <- ceiling(n_analiza / (1 - 0.15))
ukonczone                                   # tyle ukończonych ankiet zbierz

# 3. Ile zaproszeń przy różnym odsetku odpowiedzi?
odsetki <- c(0.10, 0.20, 0.30, 0.441)
zaproszenia <- outer(ukonczone, odsetki, function(u, r) ceiling(u / r))
dimnames(zaproszenia) <- list(names(ukonczone), paste0(100 * odsetki, "%"))
zaproszenia
Wynik w R
d_0.5 d_0.3
   64   176
d_0.5 d_0.3
  151   415
       10%  20%  30% 44.1%
d_0.5 1510  755  504   343
d_0.3 4150 2075 1384   942
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; symulację z rysunku 1 przeprowadzono w R, a rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Ile osób odpowie? Odsetek odpowiedzi i zachęty
Metaanaliza 1071 wskaźników zwrotu ankiet internetowych z badań edukacyjnych wykazała średni odsetek odpowiedzi 44.1%. Wyższy zwrot wiązał się z jasno zdefiniowaną populacją docelową, wcześniejszym kontaktem i przypomnieniami telefonicznymi – a nie z wysłaniem ankiety do większej liczby osób – natomiast zachęty nie miały istotnego wpływu (Wu i in., 2022). W 114 porównaniach eksperymentalnych ankiety internetowe uzyskiwały średnio o ok. 12 punktów procentowych niższy odsetek odpowiedzi niż inne tryby, a różnicę moderowały m.in. wcześniejsze powiadomienie, sposób rekrutacji, tryb zaproszenia, typ populacji i liczba kontaktów (Daikeler i in., 2020).
A zachęty? Przegląd Cochrane objął 88 badań z randomizacją dotyczących kwestionariuszy elektronicznych. Szanse uzyskania odpowiedzi rosły m.in. przy zachętach pieniężnych (OR = 1.88), niepieniężnych (OR = 1.60), krótszym kwestionariuszu (OR = 1.51) i propozycji udostępnienia wyników (OR = 1.36), choć część strategii dawała w różnych badaniach bardzo różne efekty (Edwards i in., 2023). OR to iloraz szans: wartość 1.36 oznacza, że szanse odpowiedzi były o 36% wyższe. Pozorna sprzeczność z metaanalizą Wu i in. wynika z innego rodzaju dowodów: badania z randomizacją porównują zachęty bezpośrednio, a metaanaliza opublikowanych zwrotów zestawia badania różniące się wieloma cechami naraz.
Co możesz zrobić jako student lub studentka:
- skróć ankietę i podaj czas zmierzony w badaniu pilotażowym;
- zapowiedz badanie – np. na zajęciach tydzień przed wysłaniem linku;
- wyślij jedno–dwa przypomnienia, a nie codzienne wiadomości;
- zaproponuj podsumowanie wyników – opublikowane w miejscu, które wskażesz, bez zbierania adresów e-mail w ankiecie;
- jeśli masz budżet, rozważ drobną zachętę; konkursy i losowania nagród mają własne wymogi prawne i regulaminowe, więc nie ogłaszaj ich bez zgody uczelni.
Wzór zaproszenia do ankiety
Dobre zaproszenie odpowiada na pytania, które zadaje sobie odbiorca: kto pyta, o co, czy to mnie dotyczy, ile to potrwa, co się stanie z moimi danymi. Podaj czas zmierzony w pilotażu, a temat opisz ogólnie, bez zdradzania hipotez. Wiadomość e-mail:
Krótki post do grupy tematycznej (publikuj za zgodą administratorów):
Przypomnienie wysłane po tygodniu:
Próba wygodna: co możesz z niej wnioskować?
Większość ankiet w pracach dyplomowych opiera się na doborze nieprobabilistycznym. Cornesse i in. (2020) podsumowują debatę na ten temat: teoria statystyczna uzasadnia zaufanie do prób losowych, a trafność wnioskowania z prób nieprobabilistycznych zależy całkowicie od modeli, czyli od założeń o tym, kto trafił do próby. Grupa zadaniowa AAPOR stwierdziła, że nie istnieje jedna rama teoretyczna obejmująca wszystkie metody doboru nieprobabilistycznego, że wnioskowanie z takich prób zawsze wymaga założeń modelowych, które trzeba jawnie opisać, i że przejrzystość – opis doboru, zbierania danych i ważenia – jest tu ważniejsza niż przy próbach losowych (Baker i in., 2013).
Najczęstsze złudzenie to przekonanie, że duża liczba odpowiedzi rekompensuje sposób doboru. Rysunek 1 pokazuje symulację: w populacji 200 000 osób w wieku 18–35 lat średni czas w mediach społecznościowych wynosi 2.50 h dziennie (SD = 1.44). W próbie wygodnej szansa zobaczenia i wypełnienia ankiety rośnie z czasem spędzanym w mediach – tak działa rekrutacja przez posty. Dla każdej liczebności wylosowaliśmy po 2000 prób losowych i 2000 prób wygodnych.
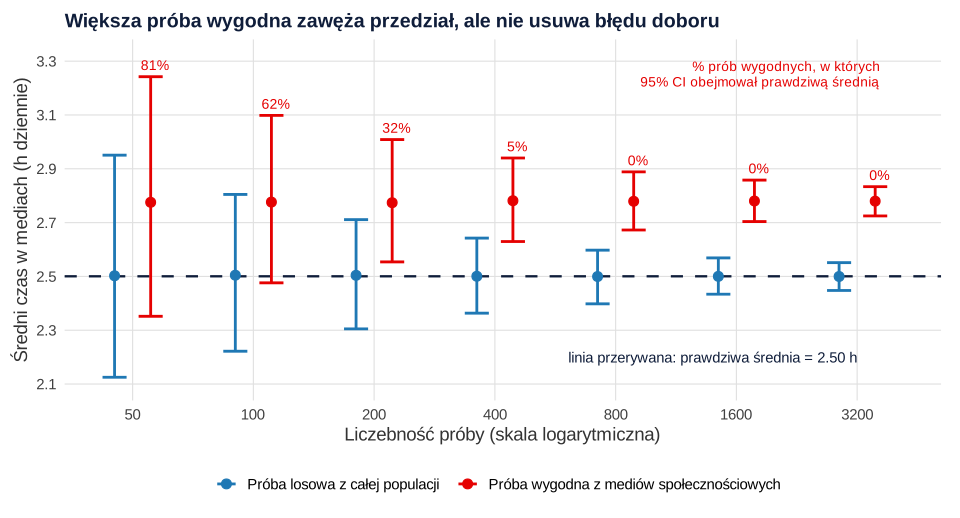
Średnia z prób losowych trafia w prawdziwą wartość przy każdej liczebności, a 95% przedział ufności obejmował ją w około 95% prób. Próby wygodne dawały średnio 2.78 h niezależnie od liczebności. Wraz ze wzrostem próby rozrzut ich oszacowań malał – od 2.35–3.24 h przy 50 osobach do 2.72–2.83 h przy 3200 osobach – ale wokół złej wartości. 95% przedział ufności obejmował prawdziwą średnią w 81% prób 50-osobowych, w 32% prób 200-osobowych i w żadnej próbie liczącej 800 osób lub więcej. Większa próba wygodna daje więcej pewności co do błędnej odpowiedzi.
Taki błąd pojawia się wtedy, gdy udział w badaniu wiąże się z badaną cechą – a zwykle nie wiesz, czy tak jest. Dlatego:
- opisz grupę, z której naprawdę pochodzą Twoi respondenci, i do niej odnoś wnioski;
- porównaj strukturę próby ze znanymi danymi o populacji (np. płeć i wiek studentów z danych uczelni) – więcej w haśle reprezentatywność próby;
- formułuj wnioski ostrożnie: „wśród badanych studentów”, a nie „wśród młodych Polaków”;
- nie nazywaj próby reprezentatywną tylko dlatego, że jest duża lub zróżnicowana.
Jak opisać rekrutację i próbę w pracy
Czytelnik musi móc ocenić, jak powstała próba. Lista kontrolna CHERRIES określa, jakie informacje o badaniu ankietowym prowadzonym przez internet należy raportować, aby można było ocenić sposób (samo)selekcji próby i jej możliwe różnice względem próby „reprezentatywnej” (Eysenbach, 2004). W pracy dyplomowej podaj co najmniej: populację i kryteria włączenia, kanały i okres rekrutacji, ewentualne zachęty, liczbę osób, które rozpoczęły i ukończyły ankietę, kryteria wykluczeń z liczbą wykluczonych osób oraz końcowe N z charakterystyką próby. Wzór akapitu:
Charakterystykę próby przedstaw w tabeli – wzory znajdziesz w poradnikach jak opisać charakterystykę próby i wzór przedstawienia charakterystyki próby, a miejsce tego akapitu w całym rozdziale pokazuje poradnik rozdział metodologiczny pracy magisterskiej. Jak wykryć i opisać wykluczenia nieuważnych odpowiedzi, wyjaśniamy we wpisie nieuważne odpowiedzi w ankietach online.
Etyka i RODO przy rekrutacji
- Informacja i zgoda przed pierwszym pytaniem – cel, czas, dobrowolność, anonimowość, administrator danych, kontakt, prawo do przerwania udziału. Szczegóły opisujemy w haśle świadoma zgoda i RODO w badaniach.
- Nie zbieraj adresów e-mail w tym samym formularzu co odpowiedzi. Jeśli chcesz wysłać wyniki lub przeprowadzić losowanie, użyj osobnego formularza – inaczej ankieta przestaje być anonimowa.
- Nie wysyłaj zaproszeń na adresy zebrane w innym celu (np. z list obecności) – korzystaj z oficjalnych kanałów uczelni lub organizacji.
- Osoby niepełnoletnie wymagają zgody rodziców lub opiekunów i zwykle opinii komisji etycznej. Jeśli badasz dorosłych, dodaj pytanie kwalifikujące o wiek.
- Sprawdź wymogi uczelni – wiele wydziałów wymaga zgody komisji etycznej także dla anonimowych ankiet.
- Szanuj regulaminy grup i nie wysyłaj nieproszonych wiadomości prywatnych.
Najczęstsze błędy przy szukaniu respondentów
- Ankieta „dla wszystkich” – bez kryteriów włączenia nie wiadomo, kogo opisują wyniki.
- Zaniżony czas w zaproszeniu – „2 minuty” przy ankiecie na kwadrans to prosta droga do porzuceń i utraty zaufania.
- Jeden post wklejony do kilkudziesięciu przypadkowych grup – bez zgody administratorów i bez związku z populacją.
- Ankieta wysłana wyłącznie znajomym, którzy znają temat i hipotezy pracy.
- Nazywanie próby z internetu „reprezentatywną” – liczebność nie usuwa błędu doboru (rysunek 1).
- Brak pytania kontrolnego i kontroli czasu – szczególnie ryzykowny w panelach płatnych i w wymianie ankiet.
- „Odsetek odpowiedzi” bez mianownika – przy postach w mediach społecznościowych podaj liczbę rozpoczętych i ukończonych ankiet, a nie wymyślony odsetek.
- Zmiana kryteriów w trakcie zbierania danych („brakuje mi mężczyzn, więc przyjmę każdego”) bez opisu w pracy.
Lista kontrolna rekrutacji
- Populacja i kryteria włączenia zapisane; pytania kwalifikujące na początku ankiety.
- Liczebność wyznaczona analizą mocy, z zapasem na wykluczenia; plan liczby zaproszeń.
- Ankieta po pilotażu: czas zmierzony, pytania sprawdzone na telefonie (zob. jak zrobić ankietę do pracy dyplomowej).
- Wybrane dwa–trzy kanały pasujące do populacji; zgody administratorów, prowadzących lub uczelni.
- Zaproszenie z informacją, kto prowadzi badanie, kogo szukasz, ile potrwa ankieta i jak chronisz dane.
- Pytanie o źródło zaproszenia albo osobne linki dla kanałów.
- Pytanie kontrolne, rejestrowanie czasu wypełniania, plan kryteriów wykluczeń.
- Jedno–dwa przypomnienia zaplanowane w kalendarzu.
- Prowadzony na bieżąco rejestr: ile osób rozpoczęło, ukończyło i zostało wykluczonych.
- W pracy: nazwa doboru, opis kanałów i ograniczenia uogólniania.
Najczęstsze pytania
Gdzie najłatwiej znaleźć respondentów do ankiety do pracy licencjackiej?
Najszybciej zwykle przez własną uczelnię (zajęcia, samorząd, prowadzący) i tematyczne grupy w mediach społecznościowych – o ile pasują do Twojej populacji. Najpierw określ, kogo potrzebujesz i ilu, a dopiero potem wybierz kanał; próba złożona ze „wszystkich, którzy klikną” rzadko pasuje do hipotez.
Ile osób powinno wypełnić ankietę?
Tyle, ile wynika z analizy mocy dla planowanej analizy – np. do wykrycia średniego efektu (d = 0.5) w porównaniu dwóch grup testem t potrzeba 64 osób w każdej grupie. Do tego dolicz zapas na ankiety odrzucone (niekompletne, nieuważne), np. 15%, co daje 151 ukończonych ankiet.
Czy wymiana ankiet (ankieta za ankietę) jest w porządku metodologicznie?
Może być pomocniczym źródłem odpowiedzi, ale daje próbę wygodną złożoną głównie ze studentów i osób, które same prowadzą badania. Nie znamy recenzowanych badań jakości danych z takich serwisów, więc w pracy opisz ten kanał wprost, dodaj pytanie kontrolne i nie uogólniaj wyników poza podobną grupę.
Jaki jest odsetek odpowiedzi w ankietach internetowych?
W metaanalizie 1071 wskaźników z opublikowanych badań edukacyjnych średni odsetek odpowiedzi wyniósł 44.1% (Wu i in., 2022), a w porównaniach eksperymentalnych ankiety internetowe uzyskiwały średnio o ok. 12 punktów procentowych mniej odpowiedzi niż inne tryby (Daikeler i in., 2020). Przy postach w mediach społecznościowych odsetka nie da się policzyć, bo nie wiadomo, ile osób zobaczyło zaproszenie.
Jak zachęcić ludzi do wypełnienia ankiety?
Skróć ankietę, uczciwie podaj czas, zapowiedz badanie wcześniej, wyślij jedno–dwa przypomnienia i zaproponuj podsumowanie wyników. W badaniach z randomizacją szanse odpowiedzi zwiększały m.in. zachęty pieniężne i niepieniężne, krótszy kwestionariusz i propozycja udostępnienia wyników (Edwards i in., 2023).
Czy próba z Facebooka jest reprezentatywna?
W sensie statystycznym zwykle nie – to próba wygodna z samoselekcją. W przeglądzie 110 badań rekrutujących przez Facebooka większość badań oceniających reprezentatywność uznała ją za podobną jak przy rekrutacji tradycyjnej (Thornton i in., 2016), ale nie zwalnia Cię to z opisu kanału i ograniczeń. Wnioski odnoś do grupy podobnej do zbadanej.
Powiązane hasła
Przeczytaj też
Jak zrobić ankietę do pracy dyplomowej
12 kroków od hipotez do czystych danych: skale, pytania, zgoda, pilotaż, Google Forms czy LimeSurvey, książka kodów, harmonogram i lista kontrolna.
Czytaj →PoradnikNajczęstsze błędy w ankietach
Pytania dwa w jednym, złe kafeterie, wielkie macierze i brak „nie dotyczy” – przykłady źle/dobrze z audytów ankiet i lista kontrolna przed startem.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Andrade, C. (2021). The inconvenient truth about convenience and purposive samples. Indian Journal of Psychological Medicine, 43(1), 86–88. https://doi.org/10.1177/0253717620977000 ● Otwarty dostęp
- Baker, R., Brick, J. M., Bates, N. A., Battaglia, M., Couper, M. P., Dever, J. A., Gile, K. J., & Tourangeau, R. (2013). Summary report of the AAPOR Task Force on Non-probability Sampling. Journal of Survey Statistics and Methodology, 1(2), 90–143. https://doi.org/10.1093/jssam/smt008
- Chandler, J., Rosenzweig, C., Moss, A. J., Robinson, J., & Litman, L. (2019). Online panels in social science research: Expanding sampling methods beyond Mechanical Turk. Behavior Research Methods, 51(5), 2022–2038. https://doi.org/10.3758/s13428-019-01273-7 ● Otwarty dostęp
- Cornesse, C., Blom, A. G., Dutwin, D., Krosnick, J. A., De Leeuw, E. D., Legleye, S., Pasek, J., Pennay, D., Phillips, B., Sakshaug, J. W., Struminskaya, B., & Wenz, A. (2020). A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research. Journal of Survey Statistics and Methodology, 8(1), 4–36. https://doi.org/10.1093/jssam/smz041 ● Otwarty dostęp
- Daikeler, J., Bošnjak, M., & Lozar Manfreda, K. (2020). Web versus other survey modes: An updated and extended meta-analysis comparing response rates. Journal of Survey Statistics and Methodology, 8(3), 513–539. https://doi.org/10.1093/jssam/smz008
- Douglas, B. D., Ewell, P. J., & Brauer, M. (2023). Data quality in online human-subjects research: Comparisons between MTurk, Prolific, CloudResearch, Qualtrics, and SONA. PLOS ONE, 18(3), Article e0279720. https://doi.org/10.1371/journal.pone.0279720 ● Otwarty dostęp
- Edwards, P. J., Roberts, I., Clarke, M. J., DiGuiseppi, C., Woolf, B., & Perkins, C. (2023). Methods to increase response to postal and electronic questionnaires. Cochrane Database of Systematic Reviews, 2023(11), Article MR000008. https://doi.org/10.1002/14651858.MR000008.pub5 ● Otwarty dostęp: pełny tekst
- Eysenbach, G. (2004). Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES). Journal of Medical Internet Research, 6(3), Article e34. https://doi.org/10.2196/jmir.6.3.e34 ● Otwarty dostęp
- Parker, C., Scott, S., & Geddes, A. (2019). Snowball sampling. In P. Atkinson, S. Delamont, A. Cernat, J. W. Sakshaug, & R. A. Williams (Eds.), SAGE Research Methods Foundations. SAGE Publications. https://doi.org/10.4135/9781526421036831710 ● Otwarty dostęp: pełny tekst
- Peer, E., Rothschild, D., Gordon, A., Evernden, Z., & Damer, E. (2022). Data quality of platforms and panels for online behavioral research. Behavior Research Methods, 54(4), 1643–1662. https://doi.org/10.3758/s13428-021-01694-3 ● Otwarty dostęp
- Skalec-Ruczyńska, A. (2024). Studying hard-to-reach populations applications using river sampling, the case of foster families. Ask: Research and Methods, 32(1), 1–28. https://doi.org/10.18061/ask.v32i1.0004 ● Otwarty dostęp
- Thornton, L., Batterham, P. J., Fassnacht, D. B., Kay-Lambkin, F., Calear, A. L., & Hunt, S. (2016). Recruiting for health, medical or psychosocial research using Facebook: Systematic review. Internet Interventions, 4, 72–81. https://doi.org/10.1016/j.invent.2016.02.001 ● Otwarty dostęp
- Westwood, S. J. (2025). The potential existential threat of large language models to online survey research. Proceedings of the National Academy of Sciences, 122(47), Article e2518075122. https://doi.org/10.1073/pnas.2518075122 ● Otwarty dostęp
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, Article 100206. https://doi.org/10.1016/j.chbr.2022.100206 ● Otwarty dostęp
Cytowania BibTeX
@article{andrade2021inconvenient, author={Andrade, Chittaranjan}, title={{The inconvenient truth about convenience and purposive samples}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={1}, pages={86--88}, doi={10.1177/0253717620977000}}@article{baker2013summary, author={Baker, R. and Brick, J. M. and Bates, N. A. and Battaglia, M. and Couper, M. P. and Dever, J. A. and Gile, K. J. and Tourangeau, R.}, title={{Summary report of the AAPOR Task Force on Non-probability Sampling}}, journal={Journal of Survey Statistics and Methodology}, year={2013}, volume={1}, number={2}, pages={90--143}, doi={10.1093/jssam/smt008}}@article{chandler2019online, author={Chandler, Jesse and Rosenzweig, Cheskie and Moss, Aaron J. and Robinson, Jonathan and Litman, Leib}, title={{Online panels in social science research: Expanding sampling methods beyond Mechanical Turk}}, journal={Behavior Research Methods}, year={2019}, volume={51}, number={5}, pages={2022--2038}, doi={10.3758/s13428-019-01273-7}}@article{cornesse2020review, author={Cornesse, Carina and Blom, Annelies G. and Dutwin, David and Krosnick, Jon A. and De Leeuw, Edith D. and Legleye, Stéphane and Pasek, Josh and Pennay, Darren and Phillips, Benjamin and Sakshaug, Joseph W. and Struminskaya, Bella and Wenz, Alexander}, title={{A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={1}, pages={4--36}, doi={10.1093/jssam/smz041}}@article{daikeler2020web, author={Daikeler, Jessica and Bošnjak, Michael and Lozar Manfreda, Katja}, title={{Web versus other survey modes: An updated and extended meta-analysis comparing response rates}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={3}, pages={513--539}, doi={10.1093/jssam/smz008}}@article{douglas2023data, author={Douglas, Benjamin D. and Ewell, Patrick J. and Brauer, Markus}, title={{Data quality in online human-subjects research: Comparisons between MTurk, Prolific, CloudResearch, Qualtrics, and SONA}}, journal={PLOS ONE}, year={2023}, volume={18}, number={3}, eid={e0279720}, doi={10.1371/journal.pone.0279720}}@article{edwards2023methods, author={Edwards, Philip James and Roberts, Ian and Clarke, Mike J. and DiGuiseppi, Carolyn and Woolf, Benjamin and Perkins, Chloe}, title={{Methods to increase response to postal and electronic questionnaires}}, journal={Cochrane Database of Systematic Reviews}, year={2023}, volume={2023}, number={11}, eid={MR000008}, doi={10.1002/14651858.mr000008.pub5}}@article{eysenbach2004improving, author={Eysenbach, Gunther}, title={{Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES)}}, journal={Journal of Medical Internet Research}, year={2004}, volume={6}, number={3}, eid={e34}, doi={10.2196/jmir.6.3.e34}}@incollection{parker2019snowball, author={Parker, C. and Scott, S. and Geddes, A.}, title={{Snowball sampling}}, booktitle={SAGE Research Methods Foundations}, year={2019}, publisher={SAGE Publications}, doi={10.4135/9781526421036831710}}@article{peer2022data, author={Peer, Eyal and Rothschild, David and Gordon, Andrew and Evernden, Zak and Damer, Ekaterina}, title={{Data quality of platforms and panels for online behavioral research}}, journal={Behavior Research Methods}, year={2022}, volume={54}, number={4}, pages={1643--1662}, doi={10.3758/s13428-021-01694-3}}@article{skalecruczynska2024studying, author={Skalec-Ruczyńska, Agata}, title={{Studying hard-to-reach populations applications using river sampling, the case of foster families}}, journal={Ask: Research and Methods}, year={2024}, volume={32}, number={1}, pages={1--28}, doi={10.18061/ask.v32i1.0004}}@article{thornton2016recruiting, author={Thornton, Louise and Batterham, Philip J. and Fassnacht, Daniel B. and Kay-Lambkin, Frances and Calear, Alison L. and Hunt, Sally}, title={{Recruiting for health, medical or psychosocial research using Facebook: Systematic review}}, journal={Internet Interventions}, year={2016}, volume={4}, pages={72--81}, doi={10.1016/j.invent.2016.02.001}}@article{westwood2025potential, author={Westwood, Sean J.}, title={{The potential existential threat of large language models to online survey research}}, journal={Proceedings of the National Academy of Sciences}, year={2025}, volume={122}, number={47}, eid={e2518075122}, doi={10.1073/pnas.2518075122}}@article{wu2022response, author={Wu, Meng-Jia and Zhao, Kelly and Fils-Aime, Francisca}, title={{Response rates of online surveys in published research: A meta-analysis}}, journal={Computers in Human Behavior Reports}, year={2022}, volume={7}, eid={100206}, doi={10.1016/j.chbr.2022.100206}}