Na czym polega problem nieuważnych odpowiedzi?
Nieuważne odpowiedzi (ang. careless responding, także insufficient effort responding, w skrócie C/IE) to odpowiedzi udzielane bez czytania pytań albo bez wysiłku potrzebnego, żeby odpowiedzieć zgodnie z prawdą. Respondent klika jedną kolumnę w całej tabeli, zaznacza odpowiedzi na chybił trafił albo przelatuje przez ankietę w kilkadziesiąt sekund. Curran (2016) podkreśla, że problem dotyczy każdego zbierania danych samoopisowych, a zwłaszcza badań online – czyli większości ankiet do prac licencjackich i magisterskich.
Skala zjawiska nie jest marginalna. Meade i Craig (2012) oszacowali, że ok. 10–12% studentów wypełniających długą ankietę za punkty zaliczeniowe odpowiadało nieuważnie. W próbie z platformy crowdsourcingowej (N = 394) Brühlmann i in. (2020) stwierdzili jakąś formę nieuważnego odpowiadania aż u 45.9% uczestników, a wykluczenie tych osób zwiększyło wielkość efektu w eksperymencie zawartym w ankiecie. Huang i in. (2012) pokazali z kolei, że usunięcie osób odpowiadających bez wysiłku poprawiało właściwości psychometryczne skal. Nieuważność uczestników jest więc realnym zagrożeniem dla wniosków z badania (Maniaci i Rogge, 2014).
Nieuważność ma różne postacie. Meade i Craig (2012) odróżniają wzorzec losowy od nielosowego i pokazują, że każdy wymaga innych wskaźników. W praktyce spotkasz najczęściej trzy wzorce:
- straightlining – identyczne albo prawie identyczne odpowiedzi w baterii pytań z tą samą skalą (Kim i in., 2019); definicję i proste wskaźniki znajdziesz w haśle straightlining i nieuważne odpowiedzi;
- odpowiedzi losowe – zaznaczanie czegokolwiek, bez związku z treścią pozycji;
- speeding – odpowiadanie zbyt szybko, żeby przeczytać pytanie. Zhang i Conrad (2014) stwierdzili, że skłonność do bardzo szybkiego odpowiadania wiązała się m.in. z młodszym wiekiem oraz z częstszym straightliningiem w pytaniach tabelarycznych.
Osobnym, nowym problemem są boty oparte na dużych modelach językowych. Westwood (2025) zbudował autonomicznego „syntetycznego respondenta”, który zaliczył 99.8% z 6000 prób standardowych pytań kontrolnych i utrzymywał spójną personę demograficzną. Wskaźniki opisane w tym wpisie wykrywają ludzi, którzy się nie starają – nie chronią przed takimi botami. Czym są syntetyczni respondenci i do czego (nie) nadają się w badaniach, opisujemy we wpisie syntetyczni respondenci (LLM) w badaniach.
Najpierw zapobiegaj: co zrobić przed zebraniem danych
Ward i Meade (2023) w przeglądzie badań nad nieuważnym odpowiadaniem omawiają, jak mu zapobiegać, jak je identyfikować, raportować i usuwać z danych. Zacznij od zapobiegania – najtańsze do wyczyszczenia są dane, które w ogóle nie powstały. Przed uruchomieniem ankiety:
- skróć ankietę – usuń pytania, których nie użyjesz w analizie (zob. jak zrobić ankietę do pracy dyplomowej);
- dziel duże tabele pytań na mniejsze bloki – w długiej tabeli najłatwiej o klikanie jednej kolumny;
- dodaj pozycje odwrócone – nie zapobiegają nieuwadze, ale sprawiają, że straightlining staje się wewnętrznie sprzeczny i łatwiejszy do wykrycia;
- wpleć dwa–trzy pytania kontrolne w tabele, w różnych częściach ankiety;
- włącz zapis czasu spędzonego na każdej stronie, jeśli program ankietowy na to pozwala (np. LimeSurvey); jak wyeksportować i zakodować takie dane, pokazujemy w poradniku dane z Google Forms i LimeSurvey do SPSS i R;
- rozważ krótkie ostrzeżenie na początku, że odpowiedzi będą sprawdzane pod kątem staranności – Huang i in. (2012) badali ostrzeżenia właśnie jako sposób zapobiegania;
- zapisz regułę wykluczeń w prerejestracji albo w planie analiz, zanim zobaczysz dane.
Problemy z narzędziem najlepiej wychwycić w badaniu pilotażowym – zobaczysz w nim także realne czasy wypełniania, które przydadzą się do ustalenia progu „zbyt szybko”. Typowe usterki samych kwestionariuszy (zbyt długie tabele, brak pytań kontrolnych, niejasne instrukcje) opisujemy w tekście o najczęstszych błędach w ankietach; ankietę możesz też przed wysłaniem poddać audytowi AI, który sprawdza m.in. pytania kontrolne i pozycje odwrócone.
Wskaźniki nieuważności – przegląd
Literatura proponuje kilkanaście wskaźników. Curran (2016) zebrał techniki wykrywania C/IE z różnych subdyscyplin psychologii i sformułował praktyczne rekomendacje, a Meade i Craig (2012) porównali pytania kontrolne, wskaźniki spójności odpowiedzi, analizę wielowymiarowych obserwacji odstających, czas odpowiedzi i samoocenę staranności. Najważniejsze wskaźniki policzysz w R kilkoma liniami kodu – bez dodatkowych pakietów. Wskaźniki oparte na samych odpowiedziach (longstring, IRV, D², synonimy i antonimy, spójność parzysto-nieparzystą) oblicza też pakiet careless (Yentes i Wilhelm, 2023).
| Wskaźnik | Jak go policzyć | Co wykrywa | Ograniczenia |
|---|---|---|---|
| Pytania kontrolne | Liczba błędnych odpowiedzi na pozycje z poleceniem („zaznacz…”) | Każdy rodzaj nieuwagi | Jedno pytanie to za mało; uważni też się mylą; boty LLM je zaliczają |
| Czas odpowiedzi | Sekundy na pozycję albo indeks względnej szybkości | Speeding | Wymaga zapisu czasu stron; długi czas nie dowodzi uwagi |
| Longstring | Najdłuższa seria identycznych odpowiedzi | Straightlining | Nie wykrywa losowego klikania ani wzorów typu „zygzak” |
| IRV | Odchylenie standardowe odpowiedzi jednej osoby | Straightlining (niskie IRV) | Wysokie IRV słabo odróżnia odpowiedzi losowe od uważnych |
| D² Mahalanobisa | Odległość profilu odpowiedzi od środka danych | Odpowiedzi losowe, nietypowe profile | Nie wykrywa straightliningu blisko środka skali; nietypowy ≠ nieuważny |
| Synonimy i antonimy psychometryczne | Korelacja w obrębie osoby dla par silnie skorelowanych pozycji | Odpowiedzi niespójne, losowe | Potrzebuje wielu par pozycji |
| Spójność parzysto-nieparzysta | Korelacja połówek wielu skal w obrębie osoby | Odpowiedzi niespójne | Potrzebuje wielu skal |
| Samoocena staranności | Pytanie typu „Czy Twoje odpowiedzi nadają się do analizy?” | Osoby, które same przyznają się do nieuwagi | Zależy od szczerości respondenta |
Pytania kontrolne
Pytanie kontrolne (ang. attention check) ma znaną poprawną odpowiedź, np. „Aby sprawdzić uwagę, zaznacz w tym wierszu »zdecydowanie się nie zgadzam«”. Oppenheimer i in. (2009) pokazali, że uczestnicy nieczytający instrukcji zwiększają szum w danych, a uwzględnienie instrukcyjnej kontroli manipulacji (IMC) może zwiększyć moc statystyczną i rzetelność zbioru danych. Berinsky i in. (2014) zastrzegają jednak, że jedno takie pytanie nie wystarcza, a zdawanie go wiąże się z cechami respondentów – dlatego wykluczenie wszystkich, którzy je oblali, ogranicza możliwość uogólniania wyników. Rodzaje pytań kontrolnych i gotowe brzmienia zebraliśmy w haśle pytanie kontrolne (attention check).
Czas odpowiedzi
Leiner (2019) stwierdził, że nieuważne odpowiedzi najlepiej identyfikował czas wypełniania kwestionariusza, i zaproponował indeks względnej szybkości wypełniania do rutynowego czyszczenia danych – porównuje on tempo osoby z typowym tempem w próbie. Najprostsza miara to średni czas na pozycję:
W przykładzie użyjemy progu 2 s na pozycję. Taki próg sprawdź na danych z pilotażu – przy długich, trudnych pozycjach może być za niski. Pamiętaj też o asymetrii: bardzo krótki czas jest silnym sygnałem nieuwagi, ale długi czas niczego nie dowodzi (ankieta mogła być otwarta w tle). Leiner (2019) zauważył ponadto, że testowane przez niego wskaźniki niereaktywne nie pozwalały wykryć celowego fałszowania odpowiedzi – nieuważność to inny problem niż odpowiadanie pod aprobatę społeczną.
Longstring
Longstring licz na odpowiedziach surowych (przed rekodowaniem), w kolejności, w jakiej respondent widział pozycje. W baterii 20 pozycji z pozycjami odwróconymi uważna osoba rzadko podaje tę samą odpowiedź więcej niż kilka razy z rzędu. Uniwersalnego progu nie ma – zależy od długości baterii i od tego, czy pozycje są jednorodne.
IRV – zmienność odpowiedzi w obrębie osoby
IRV (ang. intra-individual response variability) to zwykłe odchylenie standardowe odpowiedzi jednej osoby i na k pozycji (x̄i – średnia jej odpowiedzi). Wartości bliskie 0 oznaczają brak zróżnicowania, czyli straightlining. Bardzo wysokie IRV bywa sygnałem losowego klikania, ale – jak zobaczysz w przykładzie – trudno je odróżnić od dużej zmienności uważnych osób, które zgadzają się z jednymi pozycjami, a z odwróconymi nie.
Odległość Mahalanobisa D²
Tu xi to wektor odpowiedzi osoby, x̄ – wektor średnich pozycji, a S – macierz kowariancji pozycji. Odległość Mahalanobisa mierzy, jak nietypowy jest cały profil odpowiedzi, z uwzględnieniem korelacji między pozycjami. Osoba odpowiadająca losowo łamie strukturę korelacji (np. zgadza się jednocześnie z pozycją i z jej odwrotnością), więc jej D² rośnie. Przy wielowymiarowej normalności D² ma w przybliżeniu rozkład χ² z liczbą stopni swobody równą liczbie pozycji; jako próg zwykle przyjmuje się wartość krytyczną dla p < .001. Duże D² oznacza wielowymiarową obserwację odstającą, a ta nie zawsze jest nieuważna – czasem to po prostu nietypowa, ale szczera osoba.
Synonimy psychometryczne i spójność parzysto-nieparzysta
Te wskaźniki sprawdzają, czy osoba odpowiada spójnie na pozycje, które w całej próbie są ze sobą silnie powiązane. Synonimy psychometryczne to pary pozycji o wysokiej dodatniej korelacji w próbie; dla każdej osoby liczy się korelację między odpowiedziami na pierwsze i drugie pozycje z tych par. Antonimy to pary o silnej korelacji ujemnej – po przekodowaniu pozycji odwróconych stają się synonimami, więc w praktyce wystarczy jeden wskaźnik. Spójność parzysto-nieparzysta (nazywana też indywidualną rzetelnością) dzieli każdą skalę na pozycje parzyste i nieparzyste, liczy średnie obu połówek i koreluje je w obrębie osoby między skalami. Huang i in. (2012) zarekomendowali antonimy psychometryczne i indywidualną rzetelność – obok czasu odpowiedzi – jako wskaźniki o wysokiej swoistości i umiarkowanej czułości. Oba wymagają jednak wielu par pozycji albo wielu skal, co dobrze widać w przykładzie poniżej.
Przykład: ankieta online N = 400 z 8% nieuważnych
Żeby zobaczyć, co który wskaźnik wykrywa, przygotowaliśmy symulowaną ankietę, w której wiemy, kto odpowiadał nieuważnie – w prawdziwych danych tej wiedzy nie masz. Ankieta mierzy cztery cechy: stres, wsparcie społeczne, satysfakcję z życia i samotność. Każdą mierzy pięć pozycji na skali Likerta 1–5, z czego dwie są odwrócone. Pozycje 1–10 są na pierwszej stronie ankiety, a 11–20 na drugiej. W tabelach umieszczono dwa pytania kontrolne: „zaznacz »zdecydowanie się nie zgadzam«” (strona 1) i „zaznacz »raczej się zgadzam«” (strona 2). Program ankietowy zapisał czas, który podzieliliśmy przez liczbę pozycji.
Spośród 400 osób 368 odpowiadało uważnie, a 32 (8.0%) – nieuważnie: 12 stosowało straightlining (jedna odpowiedź na stronę, z rzadkimi odstępstwami), 12 odpowiadało losowo, a 8 klikało zbyt szybko, najczęściej w środek skali. Dane możesz pobrać jako plik CSV i powtórzyć analizę z kodem z sekcji Przykład w R.
Rysunek 1 pokazuje rozkłady trzech prostych wskaźników. Kolory oznaczają grupy znane z symulacji, czerwone linie – przyjęte progi.
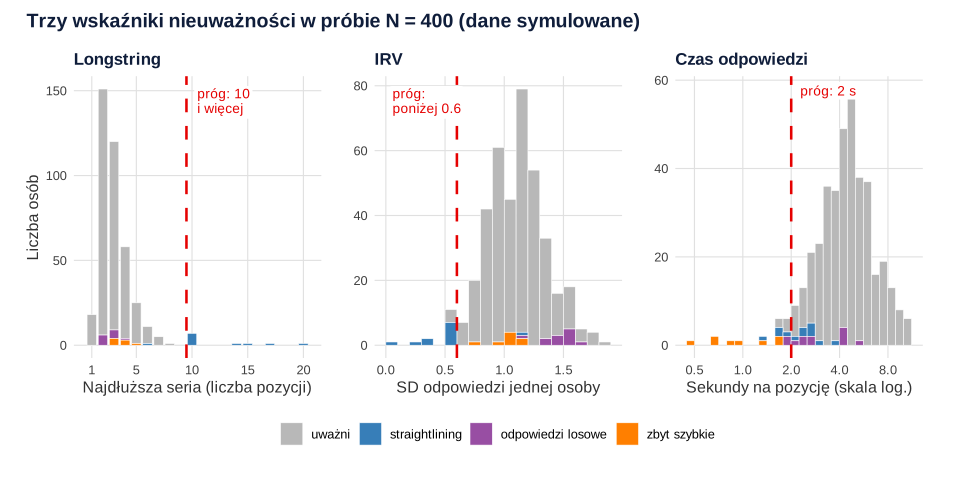
Co widać na rysunku 1:
- Longstring oddziela straightlining niemal idealnie. U uważnych osób najdłuższa seria wynosiła najwyżej 8 (mediana 3), a próg „10 i więcej” oznaczył 11 z 12 osób stosujących straightlining i nikogo innego.
- Niskie IRV (poniżej 0.6) także oznaczyło 11 z 12 osób ze straightliningiem, ale przy okazji 4 uważne. Wysokie IRV nie pomaga: u osób odpowiadających losowo IRV wynosiło od 1.14 do 1.64, a u uważnych – od 0.55 do 1.82.
- Czas poniżej 2 s na pozycję wykrył wszystkich 8 respondentów klikających zbyt szybko (mediana 0.85 s), 4 osoby ze straightliningiem i 2 odpowiadające losowo – ale również 5 osób uważnych (mediana czasu wśród wszystkich uważnych wynosiła 4.60 s).
Rysunek 2 przedstawia odległość Mahalanobisa policzoną dla wszystkich 20 pozycji. Wartość krytyczna χ²(20) dla p < .001 wynosi 45.31.
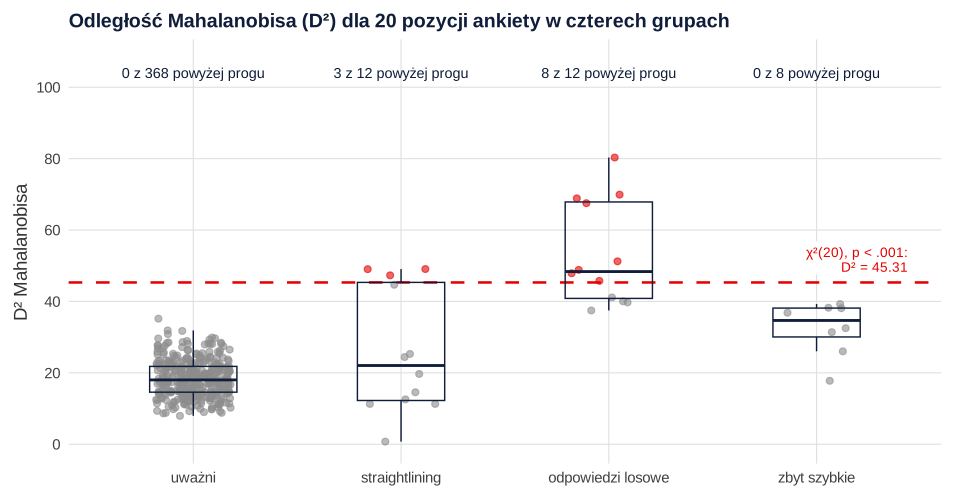
D² dobrze wychwytuje odpowiedzi losowe: powyżej progu znalazło się 8 z 12 takich osób (mediana D² = 48.37), a z grupy uważnej – nikt (maksimum 35.17). Straightlining wypada inaczej: próg przekroczyły tylko 3 z 12 osób, bo profil złożony z tej samej odpowiedzi (np. samych „czwórek”) leży stosunkowo blisko środka danych. Osoby klikające szybko, głównie w środek skali, miały podwyższone D² (mediana 34.68), ale żadna nie przekroczyła progu. To dokładnie ten wniosek, który sformułowali Meade i Craig (2012): wzorce losowe i nielosowe wymagają różnych wskaźników.
Tabela poniżej zbiera wyniki wszystkich siedmiu wskaźników. Synonimy psychometryczne policzyliśmy z 25 par pozycji o r > .50, a spójność parzysto-nieparzystą – z czterech skal.
| Wskaźnik i próg | Straightlining (n = 12) | Losowe (n = 12) | Zbyt szybkie (n = 8) | Uważni oznaczeni (n = 368) |
|---|---|---|---|---|
| Oba pytania kontrolne błędnie | 8 | 10 | 4 | 0 |
| Longstring ≥ 10 | 11 | 0 | 0 | 0 |
| D² > 45.31 | 3 | 8 | 0 | 0 |
| Czas < 2 s na pozycję | 4 | 2 | 8 | 5 |
| IRV < 0.6 | 11 | 0 | 0 | 4 |
| Synonimy psychometryczne < 0 lub brak zmienności | 1 | 6 | 4 | 27 |
| Spójność parzysto-nieparzysta < 0 lub brak zmienności | 11 | 4 | 6 | 31 |
| Reguła główna (cztery pierwsze kryteria łącznie) | 12 | 12 | 8 | 5 |
| Którykolwiek z siedmiu wskaźników | 12 | 12 | 8 | 53 |
Wskaźniki spójności wypadły w tym przykładzie słabo: synonimy psychometryczne oznaczyły 27 uważnych osób, a spójność parzysto-nieparzysta – 31. Powód jest prosty: przy czterech krótkich skalach korelacja w obrębie osoby opiera się na kilku punktach i bywa przypadkowa. Te wskaźniki lepiej sprawdzają się w długich kwestionariuszach z wieloma skalami; w typowej ankiecie do pracy dyplomowej traktuj je pomocniczo.
Reguła wykluczeń: jak ją ustalić
Żaden wskaźnik nie wykrywa wszystkiego, więc w praktyce łączy się kilka. Dobra reguła wykluczeń:
- łączy wskaźniki o różnych mechanizmach (pytania kontrolne, czas, longstring, D²),
- używa progów o wysokiej swoistości – lepiej przeoczyć kilka osób, niż usunąć wiele uważnych,
- jest zapisana przed analizą danych, najlepiej w prerejestracji,
- jest stosowana bez zaglądania do wyników testów hipotez – inaczej czyszczenie danych staje się formą p-hackingu.
W przykładzie przyjęliśmy regułę główną: osoba jest wykluczana, jeśli błędnie odpowiedziała na oba pytania kontrolne, miała serię co najmniej 10 identycznych odpowiedzi, D² > 45.31 albo średnio mniej niż 2 s na pozycję. Reguła wykluczyła 37 osób (9.2%): wszystkie 32 osoby nieuważne i 5 uważnych, które wypełniały ankietę bardzo szybko. Dla porównania: usunięcie każdego, kogo oznaczył którykolwiek z siedmiu wskaźników, wykluczyłoby 85 osób, w tym 53 uważne (14.4% uważnych). Z kolei reguła „co najmniej jeden błąd w pytaniach kontrolnych” usunęłaby 28 uważnych osób (7.6%), którym raz zdarzyła się pomyłka.
| Sytuacja w danych | Co zrobić |
|---|---|
| Jedno z kilku pytań kontrolnych błędnie | Nie wykluczaj automatycznie; sprawdź pozostałe wskaźniki. W przykładzie pojedynczy błąd popełniło 7.6% uważnych osób. |
| Wszystkie (lub prawie wszystkie) pytania kontrolne błędnie | Wyklucz, jeśli tak zapisano w regule; podaj liczbę takich osób. |
| Seria identycznych odpowiedzi obejmuje co najmniej połowę baterii z pozycjami odwróconymi | Wyklucz – takie odpowiedzi są wewnętrznie sprzeczne. |
| Długa seria w jednorodnej skali bez pozycji odwróconych | Sprawdź treść pozycji: skrajny, ale spójny pogląd też daje długą serię. |
| D² powyżej wartości krytycznej χ²(k) dla p < .001 | Obejrzyj profil odpowiedzi; wyklucz, gdy wygląda na losowy, zostaw – gdy to nietypowa, ale spójna osoba. |
| Czas wyraźnie poniżej realistycznego minimum | Wyklucz; próg ustal na podstawie pilotażu i długości pozycji. |
| Eksperyment: niezaliczona kontrola manipulacji zadana po manipulacji | Nie wykluczaj; analizuj wszystkie osoby przydzielone do warunków (Aronow i in., 2019). |
| Podejrzenie botów (np. identyczne odpowiedzi otwarte, seria zgłoszeń w krótkim czasie) | Kontroluj kanał rekrutacji; same pytania kontrolne nie wystarczą (Westwood, 2025). |
Uwaga na eksperymenty
W badaniu eksperymentalnym nie wykluczaj osób na podstawie kontroli manipulacji zadanej po przydziale do warunku. Aronow i in. (2019) wykazali, że takie wykluczanie może prowadzić do poważnego obciążenia oszacowań efektów eksperymentalnych, i zalecają analizę bez odrzucania tych osób oraz zmiany w projekcie badania. Jeśli chcesz odsiewać nieuważnych uczestników, umieść pytania kontrolne przed manipulacją eksperymentalną – wtedy decyzja o wykluczeniu nie może zależeć od warunku, do którego trafiła osoba.
Jak nieuważni respondenci zniekształcają wyniki
W przykładzie interesuje nas korelacja Pearsona stresu z satysfakcją z życia oraz rzetelność skali stresu. Przy 8% nieuważnych korelacja w pełnej próbie wyniosła r = −.42, po zastosowaniu reguły głównej także r = −.42, a w grupie uważnej (znanej tylko w symulacji) r = −.43. Wyraźniej zmieniła się rzetelność: alfa Cronbacha skali stresu wzrosła z .825 do .853 (u samych uważnych: .855), a omega McDonalda – z .826 do .853.
Jedna próba to za mało, żeby ocenić skalę problemu. Rysunek 3 pokazuje wyniki 300 powtórzeń symulacji dla każdego udziału nieuważnych respondentów – od 0% do 30%.
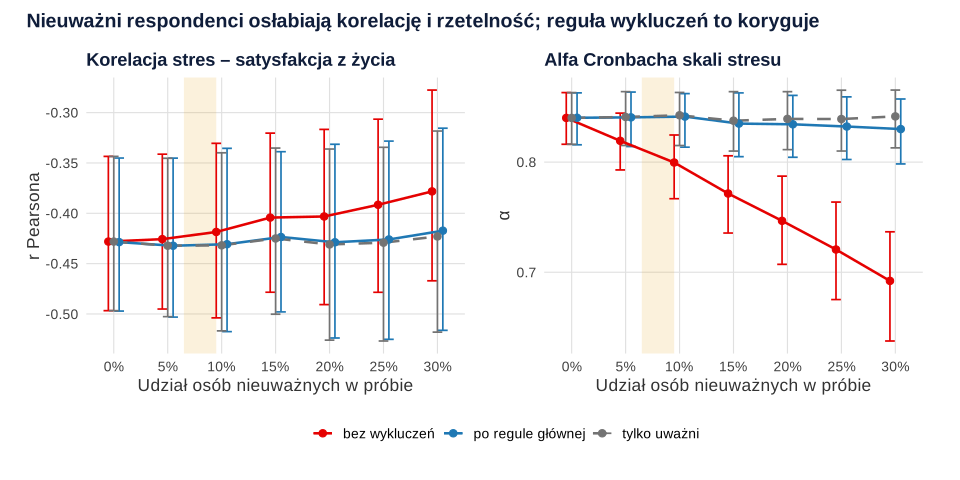
Bez czyszczenia korelacja słabnie powoli – z −.43 przy braku nieuważnych do −.38 przy ich 30-procentowym udziale – za to alfa Cronbacha spada wyraźnie: z .84 do .69. Po zastosowaniu reguły obie wartości pozostają blisko wyników samych uważnych osób (przy 30% nieuważnych: r = −.42, α = .83). Nieuważne odpowiedzi działają więc głównie jak szum: zaniżają rzetelność i osłabiają związki, tym bardziej, im jest ich więcej. W ankietach bez pozycji odwróconych straightlining może też sztucznie zawyżać korelacje między skalami – ta sama odpowiedź „przechodzi” wtedy przez wszystkie skale naraz.
Nadgorliwe czyszczenie też szkodzi
Przesadna reguła daje odwrotny efekt. Wykluczenie każdego, kogo oznaczył którykolwiek wskaźnik (85 osób), dało α = .870 i r = −.45 – więcej niż wśród wszystkich uważnych osób (α = .855, r = −.43). Usuwając uważnych respondentów o mniej spójnych odpowiedziach, sztucznie „poprawiamy” rzetelność i siłę związków. Do tego, jak zauważają Berinsky i in. (2014), osoby niezdające pytań kontrolnych różnią się cechami od pozostałych, więc zbyt agresywne wykluczanie zawęża populację, do której możesz uogólniać wyniki (zob. reprezentatywność próby).
Analiza wrażliwości i opis w pracy (APA)
Każda reguła wykluczeń jest decyzją badacza, więc pokaż, czy wnioski od niej zależą. Berinsky i in. (2014) zalecają raportowanie wyników warunkowo dla różnych poziomów uwagi respondentów – najprościej w formie tabeli analizy wrażliwości, takiej jak poniżej.
Tabela 1
Korelacja stresu z satysfakcją z życia i rzetelność skali stresu przy różnych regułach wykluczania nieuważnych respondentów
| Reguła wykluczeń | N | r | 95% CI | α | ω |
|---|---|---|---|---|---|
| Bez wykluczeń | 400 | −.42 | [−.49, −.33] | .83 | .83 |
| Pytania kontrolne: co najmniej 1 błąd | 341 | −.42 | [−.50, −.32] | .86 | .86 |
| Pytania kontrolne: 2 błędy | 378 | −.43 | [−.51, −.34] | .84 | .84 |
| Reguła główna (prerejestrowana) | 363 | −.42 | [−.50, −.33] | .85 | .85 |
| Którykolwiek z siedmiu wskaźników | 315 | −.45 | [−.53, −.36] | .87 | .87 |
Uwaga. Przed wykluczeniami N = 400. r – korelacja Pearsona średnich wyników skal stresu i satysfakcji z życia (we wszystkich wariantach p < .001); α – alfa Cronbacha, ω – omega McDonalda pięciopozycyjnej skali stresu. Reguła główna: błędna odpowiedź na oba pytania kontrolne, seria co najmniej 10 identycznych odpowiedzi, D² > 45.31 (χ²(20), p < .001) lub średnio mniej niż 2 s na pozycję.
W rozdziale z metodą (albo na początku wyników) opisz, ilu respondentów wykluczono i dlaczego. Przykładowy opis dla danych z tego wpisu:
Lista kontrolna – co powinno się znaleźć w pracy:
- wskaźniki i progi oraz informacja, kiedy je ustalono (przed zebraniem danych czy po nim);
- brzmienie i miejsce pytań kontrolnych w ankiecie;
- liczba wykluczonych osób – łącznie i dla każdego kryterium, z informacją, ile osób spełniło kilka kryteriów;
- liczebność próby przed czyszczeniem i po nim;
- wyniki kluczowych analiz bez wykluczeń (analiza wrażliwości) – w tekście, tabeli albo aneksie;
- osobno: sposób postępowania z brakami danych, który jest kolejnym krokiem czyszczenia (zob. braki danych MCAR, MAR i MNAR oraz poradnik braki danych i imputacja wielokrotna w R).
Gotową tabelę rzetelności skal przygotujesz według wzoru z hasła tabela rzetelności skal w APA.
Przykład w R
Trzy przepisy: wskaźniki nieuważności liczone własnymi funkcjami, reguła wykluczeń z analizą wrażliwości oraz kod, którym wygenerowaliśmy dane. Wszystkie liczby w tekście, tabelach i na rysunkach pochodzą z tego kodu. Pierwszy przepis wymaga pliku nieuwazne-odpowiedzi-dane.csv (do pobrania tutaj) w katalogu roboczym R.
1. Wskaźniki nieuważności – własne funkcje
R
dane <- read.csv("nieuwazne-odpowiedzi-dane.csv")
X    <- as.matrix(dane[, sprintf("p%02d", 1:20)])      # odpowiedzi surowe 1–5, w kolejności z ankiety
odwr <- rep(c(FALSE, TRUE, FALSE, TRUE, FALSE), 4)     # pozycje odwrócone
Xr   <- X; Xr[, odwr] <- 6 - Xr[, odwr]                 # odpowiedzi po rekodowaniu
skala <- rep(1:4, each = 5)                            # 1 stres, 2 wsparcie, 3 satysfakcja, 4 samotność

longstring <- function(x) max(rle(x)$lengths)          # najdłuższa seria identycznych odpowiedzi
irv        <- function(x) sd(x)                        # zmienność odpowiedzi jednej osoby
dane$longstring <- apply(X, 1, longstring)
dane$irv        <- apply(X, 1, irv)
dane$D2         <- mahalanobis(X, colMeans(X), cov(X)) # odległość Mahalanobisa (20 pozycji)

# synonimy psychometryczne: pary pozycji o r > .50 w całej próbie, korelacja w obrębie osoby
R <- cor(Xr); R[lower.tri(R, diag = TRUE)] <- NA
pary <- which(R > .50, arr.ind = TRUE)
dane$synonimy <- apply(Xr, 1, function(x) suppressWarnings(cor(x[pary[, 1]], x[pary[, 2]])))

# spójność parzysto-nieparzysta: średnie połówek każdej skali, korelacja w obrębie osoby
nieparz <- rep(c(TRUE, FALSE, TRUE, FALSE, TRUE), 4)
dane$parz_nieparz <- apply(Xr, 1, function(x) suppressWarnings(
  cor(tapply(x[nieparz], skala[nieparz], mean), tapply(x[!nieparz], skala[!nieparz], mean))))

dane$bledy_kontrolne <- (dane$iri1 != 1) + (dane$iri2 != 4)   # 0, 1 lub 2 błędy
nrow(pary)                                                    # liczba par synonimów
aggregate(cbind(longstring, irv, D2, synonimy, parz_nieparz, czas_na_poz, bledy_kontrolne) ~ typ,
          data = dane, FUN = function(v) round(median(v, na.rm = TRUE), 2), na.action = na.pass)
Wynik w R
[1] 25
             typ longstring  irv    D2 synonimy parz_nieparz czas_na_poz
1         losowe        2.5 1.50 48.37     0.02         0.18        2.80
2 straightlining       10.0 0.51 22.06     0.12        -0.96        2.35
3        szybkie        3.5 1.10 34.68     0.00        -0.44        0.85
4         uwazni        3.0 1.12 18.02     0.49         0.85        4.60
  bledy_kontrolne
1             2.0
2             2.0
3             1.5
4             0.0
2. Flagi, reguła wykluczeń i analiza wrażliwości
R
kryt_D2 <- qchisq(.999, df = 20)                        # próg D² dla p < .001 i 20 pozycji
flagi <- with(dane, data.frame(
  kontrolne    = bledy_kontrolne == 2,
  longstring   = longstring >= 10,
  D2           = D2 > kryt_D2,
  czas         = czas_na_poz < 2,
  irv_niska    = irv < 0.6,
  synonimy     = is.na(synonimy) | synonimy < 0,
  parz_nieparz = is.na(parz_nieparz) | parz_nieparz < 0))
round(kryt_D2, 2)
sapply(flagi, function(f) tapply(f, dane$typ, sum))      # ile osób z każdej grupy oznaczył wskaźnik
glowna <- with(flagi, kontrolne | longstring | D2 | czas) # reguła zapisana w prerejestracji
table(dane$typ, glowna)

library(psych)
wyniki <- function(zostaw) {                             # korelacja stres–satysfakcja oraz α i ω skali stresu
  x <- Xr[zostaw, skala == 1]
  test <- cor.test(rowMeans(x), rowMeans(Xr[zostaw, skala == 3]))
  l <- fa(x, nfactors = 1)$loadings
  c(N = sum(zostaw), r = unname(test$estimate), CI = test$conf.int,
    alfa = alpha(x)$total$raw_alpha, omega = sum(l)^2 / (sum(l)^2 + sum(1 - l^2)))
}
warianty <- list("bez wykluczeń"        = rep(TRUE, nrow(dane)),
                 "kontrolne: 1+ błąd"   = dane$bledy_kontrolne == 0,
                 "kontrolne: 2 błędy"   = !flagi$kontrolne,
                 "reguła główna"        = !glowna,
                 "wszystkie wskaźniki"  = !apply(flagi, 1, any))
round(t(sapply(warianty, wyniki)), 3)
Wynik w R
[1] 45.31
               kontrolne longstring D2 czas irv_niska synonimy parz_nieparz
losowe                10          0  8    2         0        6            4
straightlining         8         11  3    4        11        1           11
szybkie                4          0  0    8         0        4            6
uwazni                 0          0  0    5         4       27           31
                glowna
                 FALSE TRUE
  losowe             0   12
  straightlining     0   12
  szybkie            0    8
  uwazni           363    5
                      N      r    CI1    CI2  alfa omega
bez wykluczeń       400 -0.416 -0.494 -0.331 0.825 0.826
kontrolne: 1+ błąd  341 -0.416 -0.500 -0.324 0.855 0.856
kontrolne: 2 błędy  378 -0.427 -0.506 -0.341 0.843 0.844
reguła główna       363 -0.421 -0.503 -0.333 0.853 0.853
wszystkie wskaźniki 315 -0.448 -0.532 -0.355 0.870 0.870
3. Skąd dane? Symulacja ankiety
R
# Symulacja ankiety online: 4 skale po 5 pozycji (1–5), N = 400, w tym 32 osoby nieuważne
library(MASS)
set.seed(11)                                            # parametry kwestionariusza
skale  <- rep(c("stres", "wsparcie", "satysfakcja", "samotnosc"), each = 5)
odwr   <- rep(c(FALSE, TRUE, FALSE, TRUE, FALSE), 4)    # pozycje 2 i 4 każdej skali są odwrócone
lambda <- runif(20, .72, .88)                           # ładunki pozycji
przes  <- runif(20, -.4, .4)                            # różna „trudność” pozycji
R_lat  <- matrix(c(  1, -.30, -.50,  .45,
                   -.30,    1,  .40, -.50,
                   -.50,  .40,    1, -.45,
                    .45, -.50, -.45,    1), 4, 4)        # korelacje cech ukrytych
set.seed(2026)                                          # odpowiedzi osób
n <- c(uwazni = 368, straightlining = 12, losowe = 12, szybkie = 8)
eta <- mvrnorm(n[1], rep(0, 4), R_lat)
uw <- sapply(1:20, function(j) {
  y <- lambda[j] * eta[, match(skale[j], unique(skale))] + rnorm(n[1], 0, sqrt(1 - lambda[j]^2))
  if (odwr[j]) y <- -y
  as.integer(cut(y + przes[j], c(-Inf, -1.3, -0.45, 0.45, 1.3, Inf)))
})
sl <- t(replicate(n[2], {        # jedna odpowiedź na stronę (pozycje 1–10 i 11–20), czasem drobna zmiana
  x <- rep(sample(2:5, 2, replace = TRUE, prob = c(.15, .35, .30, .20)), each = 10)
  zm <- runif(20) < .05
  pmin(5, pmax(1, x + zm * sample(c(-1, 1), 20, replace = TRUE)))
}))
los  <- matrix(sample(1:5, n[3] * 20, replace = TRUE), n[3])    # odpowiedzi losowe
p_sz <- c(.1, .2, .4, .2, .1)                                   # szybkie klikanie, najczęściej środek skali
sz   <- matrix(sample(1:5, n[4] * 20, replace = TRUE, prob = p_sz), n[4])
X <- rbind(uw, sl, los, sz); colnames(X) <- sprintf("p%02d", 1:20)
typ <- rep(names(n), n)
# dwa pytania kontrolne w tabelach: „zaznacz 1” (strona 1) i „zaznacz 4” (strona 2)
kontrolne <- function(popr, w_tabeli) {
  k <- length(typ)
  ifelse(typ == "uwazni", ifelse(runif(k) < .97, popr, sample(setdiff(1:5, popr), k, TRUE)),
  ifelse(typ == "straightlining", w_tabeli,
  ifelse(typ == "losowe", sample(1:5, k, TRUE), sample(1:5, k, TRUE, prob = p_sz))))
}
iri1 <- kontrolne(1, X[, 8]); iri2 <- kontrolne(4, X[, 17])
czas <- exp(rnorm(length(typ), log(c(uwazni = 4.5, straightlining = 1.9, losowe = 2.8, szybkie = 1.0)[typ]),
                  c(uwazni = .35, straightlining = .40, losowe = .40, szybkie = .30)[typ]))
dane <- data.frame(typ, X, iri1, iri2, czas_na_poz = round(czas, 1))[sample(sum(n)), ]
dane <- data.frame(id = 1:sum(n), dane, row.names = NULL)
write.csv(dane, "nieuwazne-odpowiedzi-dane.csv", row.names = FALSE)
table(dane$typ)
Wynik w R
        losowe straightlining        szybkie         uwazni
            12             12              8            368
To samo w pakiecie careless: funkcje longstring(), irv(), mahad(), psychsyn() i evenodd() (Yentes i Wilhelm, 2023); własne funkcje pozwalają jednak dokładnie zobaczyć, co liczy każdy wskaźnik. Więcej o samym środowisku – w haśle R (język programowania).
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Wskaźniki nieuważności w SPSS
W SPSS większość wskaźników policzysz bez programowania:
- IRV: Przekształcenia → Oblicz wartości, zmienna docelowa
irv, wyrażenieSD(p01 TO p20)(pozycje muszą stać obok siebie w zbiorze, w kolejności z ankiety). - D² Mahalanobisa: Analiza → Regresja → Liniowa; jako zmienną zależną wstaw dowolną zmienną, np. numer respondenta, jako niezależne – 20 pozycji; w oknie Zapisz zaznacz Odległości: Mahalanobisa. Program doda zmienną
MAH_1; prawdopodobieństwo policzysz wyrażeniem1 - CDF.CHISQ(MAH_1, 20)i oznaczysz osoby z wartością poniżej .001. - Czas na pozycję: podziel czas strony przez liczbę pozycji (Oblicz wartości).
- Pytania kontrolne: zlicz błędy wyrażeniem
(iri1 <> 1) + (iri2 <> 4). - Longstring: w menu nie ma takiej funkcji – potrzebna jest krótka pętla w składni (
VECTORiLOOP) albo obliczenie w R na danych wyeksportowanych z SPSS.
Osoby do wykluczenia oznacz zmienną 0/1 i użyj jej w Dane → Wybierz obserwacje, zamiast fizycznie usuwać wiersze – łatwiej wtedy powtórzyć analizę bez wykluczeń. Ogólne wskazówki dotyczące opracowania danych z ankiety znajdziesz w poradniku analiza ankiety do pracy dyplomowej.
Najczęstsze błędy przy czyszczeniu danych z ankiety
- Reguła ustalana po obejrzeniu wyników. Gdy badacz wybiera kryteria, które „poprawiają” wynik, czyszczenie danych zamienia się w p-hacking. Zapisz reguły z góry i trzymaj się ich.
- Jedno pytanie kontrolne jako jedyne kryterium. Jedno pytanie nie wystarcza (Berinsky i in., 2014), a pojedyncza pomyłka zdarza się uważnym osobom.
- Automatyczne usuwanie każdej obserwacji odstającej w D². Nietypowy profil nie musi oznaczać nieuwagi – obejrzyj odpowiedzi, zanim wykluczysz osobę.
- Longstring liczony po rekodowaniu albo w innej kolejności niż w ankiecie. Wskaźnik ma sens tylko na surowych odpowiedziach, w kolejności widzianej przez respondenta.
- Wykluczanie na podstawie kontroli manipulacji zadanej po manipulacji – obciąża oszacowanie efektu eksperymentalnego (Aronow i in., 2019).
- Nadgorliwość. Usuwanie osób oznaczonych przez którykolwiek wskaźnik zawyża rzetelność i siłę związków (tabela 1) oraz zawęża możliwość uogólniania wyników.
- Przekonanie, że pytania kontrolne chronią przed botami. Syntetyczny respondent oparty na LLM zaliczał je niemal zawsze (Westwood, 2025).
- Brak informacji o wykluczeniach w pracy. Recenzent musi wiedzieć, ile osób usunięto, według jakich kryteriów i czy wyniki od tego zależą.
Najczęstsze pytania
Jak wykryć nieuważne odpowiedzi w ankiecie?
Połącz kilka wskaźników, bo każdy wychwytuje inny wzorzec: pytania kontrolne (każdy rodzaj nieuwagi), czas odpowiedzi (zbyt szybkie wypełnianie), longstring i niskie IRV (straightlining) oraz odległość Mahalanobisa (odpowiedzi losowe). W naszym przykładzie reguła łącząca cztery takie kryteria wykryła wszystkie 32 nieuważne osoby, a z 368 uważnych wykluczyła 5.
Ile osób można wykluczyć z badania za nieuważne odpowiedzi?
Nie ma limitu procentowego – liczy się reguła ustalona przed zebraniem danych. Odsetek nieuważnych bywa spory: Meade i Craig (2012) oszacowali go na ok. 10–12% wśród studentów wypełniających długą ankietę. Gdy wykluczasz bardzo wiele osób, sprawdź, czy reguła nie jest zbyt ostra, i pokaż wyniki bez wykluczeń.
Czy usuwać respondentów, którzy nie zaliczyli pytania kontrolnego?
Nie na podstawie jednego błędu: pojedyncza pomyłka zdarza się uważnym osobom (w naszym przykładzie 7.6% uważnych), a jedno pytanie nie wystarcza do oceny uwagi (Berinsky i in., 2014). Bezpieczniej wykluczać osoby, które oblały wszystkie pytania kontrolne albo spełniają inne kryteria. W eksperymencie nie wykluczaj na podstawie kontroli manipulacji zadanej po manipulacji (Aronow i in., 2019).
Co to jest longstring i IRV?
Longstring to długość najdłuższej serii identycznych, następujących po sobie odpowiedzi osoby – wysoka wartość wskazuje na straightlining. IRV to odchylenie standardowe odpowiedzi jednej osoby; wartości bliskie 0 oznaczają brak zróżnicowania. W R policzysz je jedną linią: max(rle(x)$lengths) i sd(x).
Jaki próg odległości Mahalanobisa przyjąć przy czyszczeniu ankiety?
Zwykle wartość krytyczną rozkładu χ² z liczbą stopni swobody równą liczbie pozycji, dla p < .001 – dla 20 pozycji to 45.31 (w R: qchisq(.999, df = 20)). Przekroczenie progu oznacza nietypowy profil odpowiedzi, a nie automatycznie nieuwagę, dlatego obejrzyj odpowiedzi osoby przed decyzją.
Jak opisać wykluczenie respondentów w pracy?
Podaj kryteria i progi, moment ich ustalenia (najlepiej przed zebraniem danych), liczbę wykluczonych osób – łącznie i dla każdego kryterium – oraz liczebność próby po czyszczeniu. Dodaj analizę wrażliwości, czyli wyniki kluczowych analiz bez wykluczeń. Gotowy wzór opisu znajdziesz w sekcji o raportowaniu.
Powiązane hasła
Przeczytaj też
Dane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →PoradnikBraki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikNajczęstsze błędy w ankietach
Pytania dwa w jednym, złe kafeterie, wielkie macierze i brak „nie dotyczy” – przykłady źle/dobrze z audytów ankiet i lista kontrolna przed startem.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Aronow, P. M., Baron, J., & Pinson, L. (2019). A note on dropping experimental subjects who fail a manipulation check. Political Analysis, 27(4), 572–589. https://doi.org/10.1017/pan.2019.5
- Berinsky, A. J., Margolis, M. F., & Sances, M. W. (2014). Separating the shirkers from the workers? Making sure respondents pay attention on self-administered surveys. American Journal of Political Science, 58(3), 739–753. https://doi.org/10.1111/ajps.12081
- Brühlmann, F., Petralito, S., Aeschbach, L. F., & Opwis, K. (2020). The quality of data collected online: An investigation of careless responding in a crowdsourced sample. Methods in Psychology, 2, Article 100022. https://doi.org/10.1016/j.metip.2020.100022 ● Otwarty dostęp
- Curran, P. G. (2016). Methods for the detection of carelessly invalid responses in survey data. Journal of Experimental Social Psychology, 66, 4–19. https://doi.org/10.1016/j.jesp.2015.07.006 ● Otwarty dostęp: pełny tekst
- Huang, J. L., Curran, P. G., Keeney, J., Poposki, E. M., & DeShon, R. P. (2012). Detecting and deterring insufficient effort responding to surveys. Journal of Business and Psychology, 27(1), 99–114. https://doi.org/10.1007/s10869-011-9231-8
- Kim, Y., Dykema, J., Stevenson, J., Black, P., & Moberg, D. P. (2019). Straightlining: Overview of measurement, comparison of indicators, and effects in mail–web mixed-mode surveys. Social Science Computer Review, 37(2), 214–233. https://doi.org/10.1177/0894439317752406
- Leiner, D. J. (2019). Too fast, too straight, too weird: Non-reactive indicators for meaningless data in internet surveys. Survey Research Methods, 13(3), 229–248. https://doi.org/10.18148/srm/2019.v13i3.7403 ● Otwarty dostęp
- Maniaci, M. R., & Rogge, R. D. (2014). Caring about carelessness: Participant inattention and its effects on research. Journal of Research in Personality, 48, 61–83. https://doi.org/10.1016/j.jrp.2013.09.008
- Meade, A. W., & Craig, S. B. (2012). Identifying careless responses in survey data. Psychological Methods, 17(3), 437–455. https://doi.org/10.1037/a0028085
- Oppenheimer, D. M., Meyvis, T., & Davidenko, N. (2009). Instructional manipulation checks: Detecting satisficing to increase statistical power. Journal of Experimental Social Psychology, 45(4), 867–872. https://doi.org/10.1016/j.jesp.2009.03.009 ● Otwarty dostęp: pełny tekst
- Ward, M. K., & Meade, A. W. (2023). Dealing with careless responding in survey data: Prevention, identification, and recommended best practices. Annual Review of Psychology, 74(1), 577–596. https://doi.org/10.1146/annurev-psych-040422-045007 ● Otwarty dostęp
- Westwood, S. J. (2025). The potential existential threat of large language models to online survey research. Proceedings of the National Academy of Sciences, 122(47), Article e2518075122. https://doi.org/10.1073/pnas.2518075122 ● Otwarty dostęp
- Yentes, R., & Wilhelm, F. (2023). careless: Procedures for computing indices of careless responding (Version 1.2.2) [R package]. https://doi.org/10.32614/CRAN.package.careless ● Otwarty dostęp
- Zhang, C., & Conrad, F. (2014). Speeding in web surveys: The tendency to answer very fast and its association with straightlining. Survey Research Methods, 8(2), 127–135. https://doi.org/10.18148/srm/2014.v8i2.5453 ● Otwarty dostęp
Cytowania BibTeX
@article{aronow2019note, author={Aronow, Peter M. and Baron, Jonathon and Pinson, Lauren}, title={{A note on dropping experimental subjects who fail a manipulation check}}, journal={Political Analysis}, year={2019}, volume={27}, number={4}, pages={572--589}, doi={10.1017/pan.2019.5}}@article{berinsky2014separating, author={Berinsky, Adam J. and Margolis, Michele F. and Sances, Michael W.}, title={{Separating the shirkers from the workers? Making sure respondents pay attention on self-administered surveys}}, journal={American Journal of Political Science}, year={2014}, volume={58}, number={3}, pages={739--753}, doi={10.1111/ajps.12081}}@article{bruhlmann2020quality, author={Brühlmann, Florian and Petralito, Serge and Aeschbach, Lena F. and Opwis, Klaus}, title={{The quality of data collected online: An investigation of careless responding in a crowdsourced sample}}, journal={Methods in Psychology}, year={2020}, volume={2}, eid={100022}, doi={10.1016/j.metip.2020.100022}}@article{curran2016methods, author={Curran, Paul G.}, title={{Methods for the detection of carelessly invalid responses in survey data}}, journal={Journal of Experimental Social Psychology}, year={2016}, volume={66}, pages={4--19}, doi={10.1016/j.jesp.2015.07.006}}@article{huang2012detecting, author={Huang, Jason L. and Curran, Paul G. and Keeney, Jessica and Poposki, Elizabeth M. and DeShon, Richard P.}, title={{Detecting and deterring insufficient effort responding to surveys}}, journal={Journal of Business and Psychology}, year={2012}, volume={27}, number={1}, pages={99--114}, doi={10.1007/s10869-011-9231-8}}@article{kim2019straightlining, author={Kim, Yujin and Dykema, Jennifer and Stevenson, John and Black, Penny and Moberg, D. Paul}, title={{Straightlining: Overview of measurement, comparison of indicators, and effects in mail–web mixed-mode surveys}}, journal={Social Science Computer Review}, year={2019}, volume={37}, number={2}, pages={214--233}, doi={10.1177/0894439317752406}}@article{leiner2019too, author={Leiner, Dominik Johannes}, title={{Too fast, too straight, too weird: Non-reactive indicators for meaningless data in internet surveys}}, journal={Survey Research Methods}, year={2019}, volume={13}, number={3}, pages={229--248}, doi={10.18148/srm/2019.v13i3.7403}}@article{maniaci2014caring, author={Maniaci, Michael R. and Rogge, Ronald D.}, title={{Caring about carelessness: Participant inattention and its effects on research}}, journal={Journal of Research in Personality}, year={2014}, volume={48}, pages={61--83}, doi={10.1016/j.jrp.2013.09.008}}@article{meade2012identifying, author={Meade, Adam W. and Craig, S. Bartholomew}, title={{Identifying careless responses in survey data}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={437--455}, doi={10.1037/a0028085}}@article{oppenheimer2009instructional, author={Oppenheimer, Daniel M. and Meyvis, Tom and Davidenko, Nicolas}, title={{Instructional manipulation checks: Detecting satisficing to increase statistical power}}, journal={Journal of Experimental Social Psychology}, year={2009}, volume={45}, number={4}, pages={867--872}, doi={10.1016/j.jesp.2009.03.009}}@article{ward2023dealing, author={Ward, M. K. and Meade, Adam W.}, title={{Dealing with careless responding in survey data: Prevention, identification, and recommended best practices}}, journal={Annual Review of Psychology}, year={2023}, volume={74}, number={1}, pages={577--596}, doi={10.1146/annurev-psych-040422-045007}}@article{westwood2025potential, author={Westwood, Sean J.}, title={{The potential existential threat of large language models to online survey research}}, journal={Proceedings of the National Academy of Sciences}, year={2025}, volume={122}, number={47}, eid={e2518075122}, doi={10.1073/pnas.2518075122}}@misc{yentes2023careless, author={Yentes, Richard and Wilhelm, Francisco}, title={{careless: Procedures for computing indices of careless responding (R package version 1.2.2) [Computer software]}}, year={2023}, doi={10.32614/cran.package.careless}}@article{zhang2014speeding, author={Zhang, Chan and Conrad, Frederick}, title={{Speeding in web surveys: The tendency to answer very fast and its association with straightlining}}, journal={Survey Research Methods}, year={2014}, volume={8}, number={2}, pages={127--135}, doi={10.18148/srm/2014.v8i2.5453}}