Co to jest wartość krytyczna?
Wartość krytyczna (ang. critical value) to próg statystyki testowej, który oddziela obszar odrzucenia hipotezy zerowej od obszaru, w którym nie ma podstaw do jej odrzucenia. Wyznacza się ją z trzech informacji: rozkładu statystyki przy prawdziwej H0 (z, t, F albo χ²), poziomu istotności α i kierunku testu. Formalnie jest to kwantyl tego rozkładu – w dwustronnym teście t przy α = .05 granicami są kwantyle rzędu .025 i .975.
Obszar „za” wartością krytyczną to obszar krytyczny, czyli obszar odrzucenia. Jego pole pod krzywą rozkładu przy prawdziwej H0 wynosi dokładnie α. Reguła „odrzucam H0, gdy statystyka wpada w obszar krytyczny” myli się więc – w długiej serii badań, w których H0 jest prawdziwa – w odsetku α przypadków; to błąd I rodzaju. Takie decyzyjne ujęcie testu, z ryzykiem błędów ustalonym z góry, wywodzi się z pracy Neymana i Pearsona (1933) o wyborze najefektywniejszego testu hipotez statystycznych.
Wartość krytyczna należy do planu analizy, a nie do wyników: znasz ją, zanim zbierzesz dane. Każdy test statystyczny zamienia dane w jedną liczbę i porównuje ją z tym progiem – albo, równoważnie, liczy wartość p i porównuje ją z α.
Od czego zależy wartość krytyczna?
- Od poziomu istotności α. Im mniejsze α, tym dalej od zera leży granica: w dwustronnym teście z wynosi 1.960 przy α = .05, 2.576 przy α = .01 i 2.807 przy α = .005. Poziom α = .005 zaproponowali Benjamin i in. (2018) jako domyślny próg dla twierdzeń o nowych odkryciach. Lakens i in. (2018) odpowiadają, że zamiast jednego uniwersalnego progu badacz powinien wybrać α i jawnie uzasadnić ten wybór.
- Od kierunku testu. Test dwustronny dzieli α na dwa ogony (z = ±1.960), a jednostronny umieszcza całe α w jednym, z góry wskazanym ogonie (z = 1.645). Kiedy wolno to zrobić, wyjaśniamy w haśle test jednostronny i dwustronny.
- Od rozkładu i stopni swobody. Rozkład t, opisany przez Studenta (1908), ma grubsze ogony niż rozkład normalny, więc w małych próbach próg jest wyższy: 2.571 przy 5 stopniach swobody, 2.042 przy 30 i 1.984 przy 100. Wartości krytyczne F i χ² zależą od stopni swobody jeszcze silniej.
Tabela zbiera najczęściej potrzebne wartości. Policzyliśmy je w R funkcjami qnorm(), qt(), qf() i qchisq(), które zastępują tablice statystyczne z podręczników. Wiersze t dotyczą testu dwustronnego, a wiersze F i χ² – prawego ogona rozkładu.
| Rozkład | α = .10 | α = .05 | α = .01 | α = .005 |
|---|---|---|---|---|
| z, test dwustronny | 1.645 | 1.960 | 2.576 | 2.807 |
| z, test jednostronny | 1.282 | 1.645 | 2.326 | 2.576 |
| t(5) | 2.015 | 2.571 | 4.032 | 4.773 |
| t(10) | 1.812 | 2.228 | 3.169 | 3.581 |
| t(30) | 1.697 | 2.042 | 2.750 | 3.030 |
| t(100) | 1.660 | 1.984 | 2.626 | 2.871 |
| F(1, 30) | 2.881 | 4.171 | 7.562 | 9.180 |
| F(2, 57) | 2.398 | 3.159 | 4.998 | 5.823 |
| F(3, 96) | 2.142 | 2.699 | 3.992 | 4.554 |
| χ²(1) | 2.706 | 3.841 | 6.635 | 7.879 |
| χ²(2) | 4.605 | 5.991 | 9.210 | 10.597 |
| χ²(4) | 7.779 | 9.488 | 13.277 | 14.860 |
Jedna zależność ułatwia czytanie tabeli: wartość krytyczna F(1, df) to kwadrat dwustronnej wartości t(df). Na przykład 2.042² = 4.171, czyli dokładnie tyle, ile wynosi F(1, 30) przy α = .05 – test F z jednym stopniem swobody w liczniku jest odpowiednikiem dwustronnego testu t.
Wartość krytyczna t a stopnie swobody
Rysunek 1 pokazuje, dlaczego liczba stopni swobody ma znaczenie. Ten sam wynik t = 2.10 porównano z rozkładem t o 10 i o 100 stopniach swobody – tak jak w teście t dla jednej próby z grupą 11 i 101 osób.
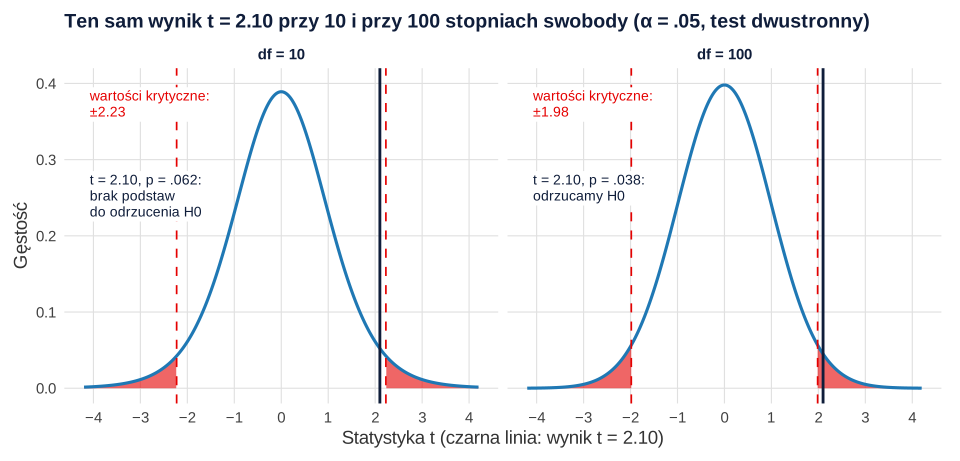
Przy 10 stopniach swobody wynik 2.10 nie sięga wartości krytycznej 2.228 (p = .062), a przy 100 – przekracza 1.984 (p = .038). Grubsze ogony w małych próbach biorą się stąd, że w mianowniku statystyki t stoi odchylenie standardowe szacowane z tych samych danych. Przy prawdziwej H0 skrajne wartości t zdarzają się więc częściej i próg musi leżeć dalej od zera. Kto przy 10 stopniach swobody użyje progu 1.96 z rozkładu normalnego, ten w rzeczywistości testuje na poziomie α = .078, a nie .05. Porównanie kształtu rozkładu t i rozkładu normalnego znajdziesz w haśle test t Studenta.
Wartości krytyczne F i χ²: tylko prawy ogon
Statystyki F (w ANOVA i regresji) oraz χ² (np. w teście niezależności) nie mogą być ujemne: F to iloraz wariancji, a χ² – suma kwadratów rozbieżności. Z hipotezą zerową kłócą się tylko duże wartości, dlatego całe α leży w prawym ogonie (rysunek 2).
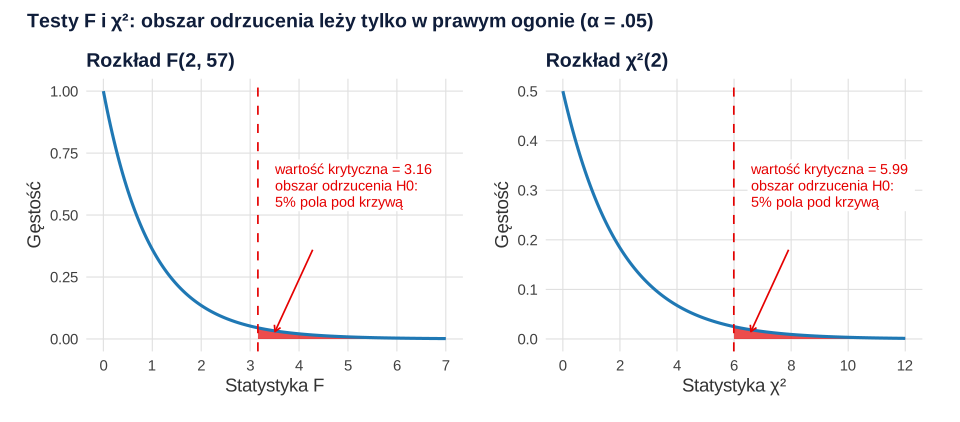
Dla jednoczynnikowej ANOVA z trzema grupami po 20 osób (F(2, 57)) wartość krytyczna wynosi 3.159, a dla testu χ² w tabeli 2 × 3 (2 stopnie swobody) – 5.991. Jednego ogona nie należy mylić z testem jednostronnym: hipotezy testów F i χ² są niekierunkowe, a α się w nich nie dzieli na pół.
Przykład: decyzja dwiema drogami
Trzydzieści osób studiujących wypełniło skalę poczucia własnej skuteczności (10–40 punktów; M = 29.90, SD = 4.19), a po semestrze napisało egzamin ze statystyki (0–100 punktów; M = 60.47, SD = 12.32; dane symulowane). Korelacja Pearsona wyniosła r = .43. Czy jest istotna przy α = .05 w teście dwustronnym? Statystyką testu jest t z n − 2 = 28 stopniami swobody:
Decyzję można podjąć na trzy równoważne sposoby:
- Statystyka a wartość krytyczna: |t| = 2.51 ≥ tkr(28) = 2.048, więc odrzucamy H0.
- Współczynnik a krytyczne r: tę samą granicę można wyrazić w jednostkach korelacji: rkr = tkr / √(tkr² + df) = 2.048 / √(2.048² + 28) = .361. Przy 30 osobach istotna jest więc każda korelacja o wartości bezwzględnej co najmniej .361 – stąd tablice „krytycznych r” w starszych podręcznikach.
- Wartość p a α: p = .018, czyli mniej niż .05.
Wszystkie trzy drogi prowadzą do tej samej decyzji, bo opierają się na tym samym rozkładzie i tym samym α. Sama decyzja nie mówi jednak, jak silny jest związek w populacji: 95% przedział ufności dla r wynosi [.08, .68], więc obejmuje zarówno związek bardzo słaby, jak i silny (zob. estymacja przedziałowa). Dane są korelacyjne, więc nie pozwalają też stwierdzić, że poczucie skuteczności poprawia wyniki egzaminu.
Wartość krytyczna a wartość p
Dla tego samego testu, α i kierunku zawsze zachodzi: |t| ≥ tkr wtedy i tylko wtedy, gdy p ≤ α. Obie drogi różnią się jednak tym, ile mówią o wyniku.
| Cecha | Wartość krytyczna | Wartość p |
|---|---|---|
| Kiedy ją znasz | Przed zebraniem danych – wynika z α, kierunku testu i df | Po analizie danych |
| Co porównujesz | Statystykę testową z progiem | p z α |
| Co mówi | Tylko, po której stronie progu leży wynik | Jak bardzo dane są niezgodne z H0 w ramach przyjętego modelu |
| Gdzie się przydaje | Przedziały ufności, analiza mocy, tablice | Raportowanie wyników |
| Co podajesz w pracy | Zwykle nic | Dokładną wartość, np. p = .018 |
Wartość krytyczna przydaje się poza samym testem. Z niej buduje się przedział ufności (oszacowanie ± wartość krytyczna × błąd standardowy), a moc testu to prawdopodobieństwo, że statystyka przekroczy wartość krytyczną, gdy prawdziwa jest hipoteza alternatywna.
Nie jest natomiast granicą między prawdą a fałszem. Oświadczenie Amerykańskiego Towarzystwa Statystycznego podkreśla, że wnioski naukowe nie powinny zależeć wyłącznie od tego, czy wynik przekroczył próg (Wasserstein i Lazar, 2016). Wynik t = 2.10 przy 100 stopniach swobody i wynik leżący tuż poniżej progu niosą niemal tę samą informację o danych. Dlatego obok decyzji podawaj wielkość efektu i przedział ufności.
Jak opisać wynik w pracy (APA)
W stylu APA wartości krytycznej zwykle się nie podaje. W podrozdziale o analizie danych napisz, jaki poziom istotności przyjęto i czy testy były jedno-, czy dwustronne. W wynikach podaj statystykę, stopnie swobody, dokładną wartość p i wielkość efektu z przedziałem ufności. Nawet jeśli decyzja opierała się na tablicach, dokładne p odczytaj z programu.
Jeśli mimo to podajesz wartość krytyczną (np. w ćwiczeniu z tablic), zapisz ją razem ze stopniami swobody, poziomem α i kierunkiem testu: tkr(28) = 2.05 dla α = .05, test dwustronny. Gotowe zdania dla innych analiz znajdziesz w poradniku Jak opisać wyniki w stylu APA – gotowe zdania.
Przykład w R
Kod liczy wartości krytyczne rozkładów z, t, F i χ² oraz podejmuje decyzję w przykładzie z korelacją na dwa sposoby: przez wartość krytyczną i przez wartość p. Liczby w tekście i w tabeli pochodzą z tego kodu.
Wartości krytyczne i decyzja w teście korelacji
R
# Wartości krytyczne dla α = .05
qnorm(0.975)                        # z, test dwustronny
qt(0.975, df = c(10, 30, 100))      # t, test dwustronny
qf(0.95, df1 = 2, df2 = 57)         # F – tylko prawy ogon
qchisq(0.95, df = c(1, 2, 4))       # chi-kwadrat – tylko prawy ogon

# Przykład: poczucie własnej skuteczności a wynik egzaminu, n = 30
set.seed(15)
n <- 30
skutecznosc <- pmin(pmax(round(rnorm(n, 29, 5)), 10), 40)   # skala 10–40
egzamin <- pmin(pmax(round(55 + 1.1 * (skutecznosc - 29) + rnorm(n, 0, 12)), 0), 100)   # 0–100 pkt
wynik <- cor.test(skutecznosc, egzamin)
t_obs <- unname(wynik$statistic)
t_kr <- qt(0.975, df = n - 2)            # wartość krytyczna t(28)
r_kr <- t_kr / sqrt(t_kr^2 + n - 2)      # ta sama granica w jednostkach r
round(c(r = unname(wynik$estimate), t = t_obs, t_kr = t_kr, r_kr = r_kr, p = wynik$p.value), 3)
c(decyzja_wartosc_krytyczna = abs(t_obs) >= t_kr, decyzja_p = wynik$p.value <= 0.05)
round(wynik$conf.int, 2)                 # 95% przedział ufności dla r
Wynik w R
[1] 1.959964
[1] 2.228139 2.042272 1.983972
[1] 3.158843
[1] 3.841459 5.991465 9.487729
    r     t  t_kr  r_kr     p
0.428 2.506 2.048 0.361 0.018
decyzja_wartosc_krytyczna                 decyzja_p
                     TRUE                      TRUE
[1] 0.08 0.68
attr(,"conf.level")
[1] 0.95
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Próg 1.96 przy małej próbie – dla średnich i różnic średnich właściwy jest rozkład t; przy 10 stopniach swobody próg 1.96 daje rzeczywiste α = .078 zamiast .05.
- Jednostronna wartość krytyczna w teście dwustronnym – próg 1.645 zamiast 1.960 podwaja ryzyko fałszywego alarmu, z .05 do .10.
- Dzielenie α na pół w testach F i χ² – ich obszar odrzucenia leży tylko w prawym ogonie, więc wartość krytyczną odczytuj dla całego α.
- Złe stopnie swobody – np. n zamiast n − 2 przy korelacji albo df testu Studenta zamiast df testu Welcha (zob. stopnie swobody).
- Zmiana α lub kierunku testu po obejrzeniu wyniku – przesuwanie progu tak, by wynik „przeszedł”, to odmiana p-hackingu.
- Przekroczenie progu jako dowód – wynik w obszarze krytycznym nie dowodzi, że H0 jest fałszywa ani że efekt jest duży. Greenland i in. (2016) zebrali 25 typowych błędnych interpretacji testów, wartości p i przedziałów ufności.
Najczęstsze pytania
Co to jest wartość krytyczna?
Wartość krytyczna to próg statystyki testowej (np. t, F albo χ²), od którego zaczyna się obszar odrzucenia hipotezy zerowej. Wyznacza się ją z rozkładu statystyki przy prawdziwej H0, poziomu istotności α i kierunku testu. Jeśli statystyka jest równa wartości krytycznej albo bardziej od niej skrajna, odrzucasz H0.
Jak obliczyć wartość krytyczną t?
Potrzebujesz α, kierunku testu i liczby stopni swobody. W R dla testu dwustronnego wpisz qt(1 - alfa/2, df), np. qt(0.975, 28) daje 2.048, a dla jednostronnego qt(1 - alfa, df). W tablicach rozkładu t odczytaj wiersz z liczbą stopni swobody i kolumnę dla α.
Ile wynosi wartość krytyczna dla α = .05?
To zależy od rozkładu i kierunku testu. Dla z wynosi 1.960 w teście dwustronnym i 1.645 w jednostronnym. Dla t w teście dwustronnym: 2.228 przy 10 stopniach swobody, 2.042 przy 30 i 1.984 przy 100. Dla χ²(1) wynosi 3.841, a dla F(2, 57) – 3.159.
Czym różni się wartość krytyczna od wartości p?
Wartość krytyczna to próg dla statystyki testowej, znany przed analizą; wartość p to prawdopodobieństwo wyniku co najmniej tak skrajnego jak zaobserwowany, gdy H0 jest prawdziwa. Obie drogi dają tę samą decyzję: |t| ≥ tkr wtedy i tylko wtedy, gdy p ≤ α. Wartość p niesie jednak więcej informacji, dlatego to ją podaje się w pracy.
Dlaczego wartość krytyczna t jest większa niż 1.96?
Bo rozkład t ma grubsze ogony niż rozkład normalny – w mianowniku statystyki t stoi odchylenie standardowe szacowane z próby. Im mniej stopni swobody, tym wyższy próg: 2.571 przy 5, 2.228 przy 10 i 1.984 przy 100. Wraz ze wzrostem df wartość krytyczna t zbliża się do 1.96.
Czy wartość krytyczną trzeba podawać w pracy?
Zwykle nie. W stylu APA podaje się statystykę, stopnie swobody, dokładne p i wielkość efektu z przedziałem ufności, np. r(28) = .43, 95% CI [.08, .68], p = .018. W części metodologicznej napisz natomiast, jaki poziom α przyjęto i czy testy były dwustronne.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wartość p: co naprawdę oznacza i jak ją poprawnie interpretować
Wartość p bez mitów: definicja, interpretacja, typowe błędy oraz sposób raportowania wraz z wielkością efektu i przedziałem ufności.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Benjamin, D. J., Berger, J. O., Johannesson, M., Nosek, B. A., Wagenmakers, E.-J., Berk, R., Bollen, K. A., Brembs, B., Brown, L., Camerer, C., Cesarini, D., Chambers, C. D., Clyde, M., Cook, T. D., De Boeck, P., Dienes, Z., Dreber, A., Easwaran, K., Efferson, C., . . . Johnson, V. E. (2018). Redefine statistical significance. Nature Human Behaviour, 2(1), 6–10. https://doi.org/10.1038/s41562-017-0189-z ● Otwarty dostęp
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Lakens, D., Adolfi, F. G., Albers, C. J., Anvari, F., Apps, M. A. J., Argamon, S. E., Baguley, T., Becker, R. B., Benning, S. D., Bradford, D. E., Buchanan, E. M., Caldwell, A. R., Van Calster, B., Carlsson, R., Chen, S.-C., Chung, B., Colling, L. J., Collins, G. S., Crook, Z., . . . Zwaan, R. A. (2018). Justify your alpha. Nature Human Behaviour, 2(3), 168–171. https://doi.org/10.1038/s41562-018-0311-x ● Otwarty dostęp: pełny tekst
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694–706), 289–337. https://doi.org/10.1098/rsta.1933.0009 ● Otwarty dostęp
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
Cytowania BibTeX
@article{benjamin2018redefine, author={Benjamin, Daniel J. and Berger, James O. and Johannesson, Magnus and Nosek, Brian A. and Wagenmakers, Eric-Jan and Berk, Richard and Bollen, Kenneth A. and Brembs, Björn and Brown, Lawrence and Camerer, Colin and Cesarini, David and Chambers, Christopher D. and Clyde, Merlise and Cook, Thomas D. and De Boeck, Paul and Dienes, Zoltan and Dreber, Anna and Easwaran, Kenny and Efferson, Charles and others}, title={{Redefine statistical significance}}, journal={Nature Human Behaviour}, year={2018}, volume={2}, number={1}, pages={6--10}, doi={10.1038/s41562-017-0189-z}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{lakens2018justify, author={Lakens, Daniël and Adolfi, Federico G. and Albers, Casper J. and Anvari, Farid and Apps, Matthew A. J. and Argamon, Shlomo E. and Baguley, Thom and Becker, Raymond B. and Benning, Stephen D. and Bradford, Daniel E. and Buchanan, Erin M. and Caldwell, Aaron R. and Van Calster, Ben and Carlsson, Rickard and Chen, Sau-Chin and Chung, Bryan and Colling, Lincoln J. and Collins, Gary S. and Crook, Zander and others}, title={{Justify your alpha}}, journal={Nature Human Behaviour}, year={2018}, volume={2}, number={3}, pages={168--171}, doi={10.1038/s41562-018-0311-x}}@article{neyman1933problem, author={Neyman, Jerzy and Pearson, Egon S.}, title={{On the problem of the most efficient tests of statistical hypotheses}}, journal={Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character}, year={1933}, volume={231}, number={694–706}, pages={289--337}, doi={10.1098/rsta.1933.0009}}@article{student1908probable, author={{Student}}, title={{The probable error of a mean}}, journal={Biometrika}, year={1908}, volume={6}, number={1}, pages={1--25}, doi={10.1093/biomet/6.1.1}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}