Co to są stopnie swobody?
Stopnie swobody (ang. degrees of freedom, df, czasem ν) to liczba niezależnych informacji, które zostają do oszacowania zmienności po uwzględnieniu ograniczeń nałożonych przez model – najczęściej po oszacowaniu parametrów z tych samych danych. Najprostsza intuicja: jeśli wiesz, że średnia pięciu wyników wynosi 20, to cztery z nich mogą być dowolne, ale piąty jest już wyznaczony, bo suma musi wynosić 100. Swobodnie mogą się zmieniać tylko cztery wartości.
W najprostszym przypadku – jednej próbie, z której liczymy średnią – daje to df = n − 1. Dlatego właśnie wariancję z próby dzieli się przez n − 1, a nie przez n. Stopnie swobody wyznaczają też, z którym rozkładem t, F lub χ² porównuje się statystykę testową, a więc od nich zależą wartość krytyczna i wartość p.
Dlaczego tracimy stopień swobody? Symulacja
Odchylenia od średniej z próby zawsze sumują się do zera, więc ostatnie z nich nie niesie nowej informacji. Co więcej, średnia z próby leży „najbliżej” własnych danych: suma kwadratów odchyleń od M nigdy nie jest większa niż suma kwadratów odchyleń od prawdziwej średniej populacji μ. Sprawdziliśmy to na 10 000 próbach po 5 osób z populacji wyników testu o μ = 100 i σ = 15 (rysunek 1).
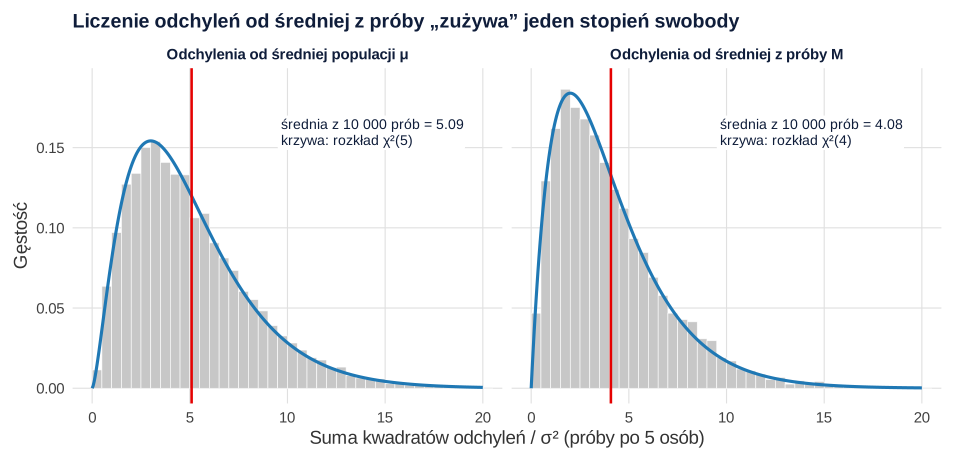
Gdy odchylenia liczymy od μ, ich suma kwadratów (podzielona przez σ²) wynosi średnio 5.09 – tyle, ile jest obserwacji – i ma rozkład χ² z 5 stopniami swobody. Gdy liczymy je od M, średnia spada do 4.08, a rozkład to χ² z 4 stopniami swobody. W każdej z 10 000 prób suma kwadratów od M była nie większa niż od μ. Oszacowanie średniej z tych samych danych „zużywa” jeden stopień swobody, a dzielenie przez n − 1 to rekompensuje (zob. też estymacja punktowa). W bardziej złożonych modelach każdy kolejny oszacowany parametr – średnia kolejnej grupy, współczynnik regresji – zabiera następny stopień swobody.
Stopnie swobody w najczęstszych testach
| Analiza | Stopnie swobody | Przykład |
|---|---|---|
| Test t dla jednej próby | n − 1 | 25 osób → 24 |
| Test t dla prób zależnych | liczba par − 1 | 30 par pomiarów → 29 |
| Test t dla prób niezależnych (Studenta) | n1 + n2 − 2 | 20 + 20 osób → 38 |
| Test Welcha | wzór Welcha–Satterthwaite’a (zwykle ułamkowe) | 20 + 20 osób, SD 5.23 i 8.75 → 31.05 |
| Korelacja Pearsona | n − 2 | 60 osób → 58 |
| ANOVA jednoczynnikowa | k − 1 oraz N − k | 3 grupy po 20 osób → 2 i 57 |
| ANOVA z powtarzanymi pomiarami | k − 1 oraz (k − 1)(n − 1); po poprawce mnożone przez ε̂ | 3 pomiary, 25 osób → 2 i 48 |
| Chi-kwadrat niezależności | (liczba wierszy − 1)(liczba kolumn − 1) | tabela 3 × 2 → 2 |
| Chi-kwadrat zgodności | k − 1 (liczba kategorii − 1) | 4 kategorie → 3 |
| Regresja wieloraka | test F modelu: p oraz n − p − 1; test t współczynnika: n − p − 1 | 3 predyktory, 60 osób → 3 i 56 |
Dwie pozycje wymagają komentarza. W teście Welcha stopnie swobody liczy się ze wzoru, który uwzględnia wariancje i liczebności obu grup:
Welch (1947) uogólnił w ten sposób problem Studenta na sytuację, w której wariancje w populacjach są różne. Im bardziej różnią się wariancje (i liczebności) grup, tym mniej stopni swobody – w przykładzie 31.05 zamiast 38. Delacre i in. (2017) zalecają test Welcha jako domyślny, bo lepiej kontroluje błąd I rodzaju przy nierównych wariancjach.
W ANOVA z powtarzanymi pomiarami, gdy naruszone jest założenie sferyczności, oba df mnoży się przez oszacowanie poprawki ε (Greenhouse–Geissera albo Huynha–Feldta). Huynh i Feldt (1976) pokazali, że oszacowanie poprawki Boxa jest silnie obciążone, gdy prawdziwe ε nie jest małe, i zaproponowali mniej obciążony estymator. Dlatego w wynikach takiej analizy zobaczysz ułamkowe stopnie swobody – oba df pomnożone przez ε̂.
Dlaczego stopnie swobody mają znaczenie?
Stopnie swobody wybierają rozkład odniesienia. Rozkład t, który opisał Student (1908), przy małej liczbie stopni swobody ma grubsze ogony niż rozkład normalny, a rozkład χ² zmienia nie tylko szerokość, ale i położenie – jego średnia równa się liczbie stopni swobody (rysunek 2).
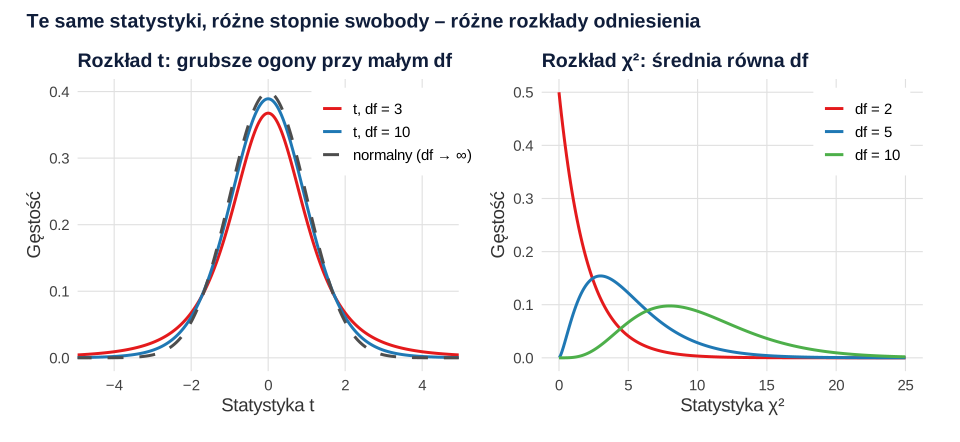
Konsekwencje są bezpośrednie. Ten sam wynik t = 2.20 daje p = .115 przy 3 stopniach swobody, p = .052 przy 10 i p = .030 przy 100. Wynik χ² = 7.35 przy 2 stopniach swobody oznacza p = .025, ale przy 10 stopniach swobody byłby zupełnie typowy (p = .692). Dlatego statystyka testowa bez stopni swobody jest dla czytelnika nieczytelna – a błędnie podane df podważają wiarygodność całego wyniku. Porównanie rozkładu t z normalnym szerzej omawiamy w haśle test t Studenta.
Gdzie znaleźć stopnie swobody w wydruku?
Przykład: 60 osób studiujących uczyło się słówek jedną z trzech metod (fiszki, mapy myśli, powtarzanie; po 20 osób), a potem napisało test (0–50 punktów; dane symulowane). Kod w sekcji „Przykład w R” wykonuje na tych danych pięć analiz. Stopnie swobody znajdziesz w wydruku R tak:
t.test()– w wierszu ze statystyką:t = 2.5213, df = 31.047, p-value = 0.01704. Domyślnie R liczy test Welcha, stąd ułamkowe df; z opcjąvar.equal = TRUEotrzymasz df = 38.summary(aov())– w kolumnieDf: 2 w wierszu czynnika i 57 w wierszuResiduals.chisq.test()–X-squared = 7.35, df = 2.summary(lm())– w końcowych wierszach:on 56 degrees of freedom(df reszt, używane też w testach t współczynników) iF-statistic: 3.262 on 3 and 56 DF.
W programie SPSS stopnie swobody są w kolumnie „df”. W tabeli testu t dla prób niezależnych są dwa wiersze: „Equal variances assumed” (wariant Studenta) i „Equal variances not assumed” (wariant Welcha, z ułamkowym df) – podaj df z tego wiersza, z którego bierzesz t i p.
Jak zapisać stopnie swobody w APA
Zasady zapisu liczb i wyników statystycznych opisuje rozdział 6 podręcznika APA (American Psychological Association, 2020). W praktyce: stopnie swobody podajesz w nawiasie zaraz po symbolu statystyki; przy F – dwie liczby (międzygrupowe i wewnątrzgrupowe), przy χ² – df i liczebność próby, a ułamkowe df testu Welcha lub df po poprawce sferyczności – z dwoma miejscami dziesiętnymi.
| Analiza | Zapis |
|---|---|
| Test Welcha | t(31.05) = 2.52, p = .017 |
| ANOVA jednoczynnikowa | F(2, 57) = 4.52, p = .015 |
| Chi-kwadrat niezależności | χ²(2, N = 60) = 7.35, p = .025 |
| Korelacja Pearsona | r(58) = .36, p = .005 |
| Regresja wieloraka (model) | F(3, 56) = 3.26, p = .028 |
Do każdego wyniku dodaj wielkość efektu z przedziałem ufności. Gotowe zdania dla innych analiz znajdziesz w poradniku Jak opisać wyniki w stylu APA – gotowe zdania.
Przykład w R
Kod wykonuje pięć analiz na jednym zbiorze danych i pokazuje, gdzie w wydruku R pojawiają się stopnie swobody; sprawdza też wzór Welcha „ręcznie”. Liczby w tekście i w tabeli zapisu APA pochodzą z tego kodu.
Stopnie swobody w teście t, ANOVA, chi-kwadrat, korelacji i regresji
R
set.seed(41)
grupa <- factor(rep(c("fiszki", "mapy", "powtarzanie"), each = 20))   # metoda nauki, 3 × 20 osób
motywacja <- round(pmin(pmax(rnorm(60, 4.5, 1.1), 1), 7), 1)           # skala 1–7
godziny <- round(pmin(pmax(rnorm(60, 6, 2), 0), 15))                   # godziny nauki w tygodniu
lek <- round(pmin(pmax(rnorm(60, 25, 6), 10), 40))                     # lęk egzaminacyjny (10–40)
wynik <- round(pmin(pmax(c(33, 31, 28)[grupa] + 2.2 * (motywacja - 4.5) + 0.5 * (godziny - 6) -
                         0.1 * (lek - 25) + rnorm(60, 0, c(4.5, 5.5, 8)[grupa]), 0), 50))   # test (0–50)
zaliczenie <- factor(ifelse(wynik >= 30, "tak", "nie"))

# 1. Test t: fiszki a powtarzanie – wariant Studenta (df = n1 + n2 − 2) i Welcha
fisz <- wynik[grupa == "fiszki"]; powt <- wynik[grupa == "powtarzanie"]
round(c(M_fiszki = mean(fisz), SD_fiszki = sd(fisz), M_powt = mean(powt), SD_powt = sd(powt)), 2)
t.test(fisz, powt, var.equal = TRUE)$parameter
t.test(fisz, powt)
v1 <- var(fisz) / 20; v2 <- var(powt) / 20
(v1 + v2)^2 / (v1^2 / 19 + v2^2 / 19)                                  # df Welcha ze wzoru

# 2. ANOVA jednoczynnikowa: df = k − 1 oraz N − k
summary(aov(wynik ~ grupa))

# 3. Chi-kwadrat niezależności, tabela 3 × 2: df = (3 − 1)(2 − 1)
chisq.test(table(grupa, zaliczenie))

# 4. Korelacja (df = n − 2) i regresja z trzema predyktorami (df = 3 i n − 3 − 1)
kor <- cor.test(wynik, motywacja)
round(c(r = unname(kor$estimate), df = unname(kor$parameter), p = kor$p.value), 3)
summary(lm(wynik ~ motywacja + godziny + lek))

# 5. Ten sam wynik t = 2.20 przy 3, 10 i 100 stopniach swobody
round(2 * pt(-2.20, df = c(3, 10, 100)), 3)
Wynik w R
 M_fiszki SD_fiszki    M_powt   SD_powt
    35.65      5.23     29.90      8.75
df
38

	Welch Two Sample t-test

data:  fisz and powt
t = 2.5213, df = 31.047, p-value = 0.01704
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
  1.099069 10.400931
sample estimates:
mean of x mean of y
    35.65     29.90

[1] 31.04733
            Df Sum Sq Mean Sq F value Pr(>F)
grupa        2  415.6  207.82   4.524  0.015 *
Residuals   57 2618.1   45.93
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

	Pearson's Chi-squared test

data:  table(grupa, zaliczenie)
X-squared = 7.35, df = 2, p-value = 0.02535

     r     df      p
 0.357 58.000  0.005

Call:
lm(formula = wynik ~ motywacja + godziny + lek)

Residuals:
    Min      1Q  Median      3Q     Max
-17.185  -4.840   1.031   4.244  14.590

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  25.9193     5.5374   4.681 1.86e-05 ***
motywacja     2.5237     0.8167   3.090  0.00311 **
godziny      -0.1778     0.4430  -0.401  0.68966
lek          -0.1907     0.1878  -1.015  0.31425
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 6.791 on 56 degrees of freedom
Multiple R-squared:  0.1488,	Adjusted R-squared:  0.1032
F-statistic: 3.262 on 3 and 56 DF,  p-value: 0.02801

[1] 0.115 0.052 0.030
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Liczebność zamiast stopni swobody – „t(60)” przy 60 osobach w dwóch grupach to błąd; dla testu Studenta df = 58.
- Jedna liczba przy F – zapis „F(2) = 4.52” jest niepełny; podaj df międzygrupowe i wewnątrzgrupowe: F(2, 57).
- Niezgodne df i statystyka – df Studenta (38) obok t i p z testu Welcha (df = 31.05) albo df zaokrąglone do liczby całkowitej.
- Brak poprawki df przy naruszeniu sferyczności – po zastosowaniu poprawki Greenhouse’a–Geissera podaj poprawione, ułamkowe df.
- χ² bez liczebności albo z df = N – w teście niezależności df zależą od liczby kategorii, a nie od liczby osób.
- Przenoszenie intuicji „n − 1” do każdego modelu – w SEM stopnie swobody to różnica między liczbą informacji w macierzy kowariancji a liczbą szacowanych parametrów (zob. identyfikacja modelu SEM).
Najczęstsze pytania
Co to są stopnie swobody?
Stopnie swobody (df) to liczba niezależnych informacji, które zostają do oszacowania zmienności po oszacowaniu parametrów z tych samych danych. Jeśli średnia pięciu wyników wynosi 20, swobodnie mogą się zmieniać tylko cztery z nich – piąty jest wyznaczony. Dlatego w jednej próbie df = n − 1.
Jak obliczyć stopnie swobody w teście t?
W teście t dla jednej próby df = n − 1, dla prób zależnych – liczba par minus 1, a dla prób niezależnych (wariant Studenta) – n1 + n2 − 2, np. 20 + 20 − 2 = 38. W teście Welcha df liczy się ze wzoru Welcha–Satterthwaite’a i zwykle jest ułamkowe (w naszym przykładzie 31.05).
Ile wynoszą stopnie swobody w ANOVA?
Jednoczynnikowa ANOVA ma dwie liczby df: międzygrupowe k − 1 i wewnątrzgrupowe N − k. Przy trzech grupach po 20 osób to 2 i 57, a wynik zapisujesz jako F(2, 57) = 4.52.
Jak obliczyć stopnie swobody w teście chi-kwadrat?
W teście niezależności df = (liczba wierszy − 1) × (liczba kolumn − 1), np. dla tabeli 3 × 2 df = 2. W teście zgodności df = liczba kategorii − 1. Stopnie swobody nie zależą tu od liczby osób, dlatego w APA podaje się osobno N: χ²(2, N = 60) = 7.35.
Skąd biorą się niecałkowite stopnie swobody, np. w teście Welcha?
Bo df Welcha liczy się ze wzoru, który uwzględnia wariancje i liczebności obu grup, a nie same liczebności. Im bardziej różnią się wariancje, tym mniej stopni swobody – w przykładzie 31.05 zamiast 38. W APA podaj df z dwoma miejscami dziesiętnymi: t(31.05) = 2.52.
Gdzie znaleźć stopnie swobody w SPSS i R?
W SPSS – w kolumnie „df” tabel wyników (w teście t dla prób niezależnych w tym wierszu, z którego bierzesz t i p). W R – jako df = … w wydruku t.test() i chisq.test(), w kolumnie Df tabeli ANOVA oraz w zdaniach „on 56 degrees of freedom” i „on 3 and 56 DF” w podsumowaniu regresji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Welch, B. L. (1947). The generalization of 'Student's' problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{huynh1976estimation, author={Huynh, Huynh and Feldt, Leonard S.}, title={{Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs}}, journal={Journal of Educational Statistics}, year={1976}, volume={1}, number={1}, pages={69--82}, doi={10.3102/10769986001001069}}@article{student1908probable, author={{Student}}, title={{The probable error of a mean}}, journal={Biometrika}, year={1908}, volume={6}, number={1}, pages={1--25}, doi={10.1093/biomet/6.1.1}}@article{welch1947generalization, author={Welch, B. L.}, title={{The generalization of 'Student's' problem when several different population variances are involved}}, journal={Biometrika}, year={1947}, volume={34}, number={1–2}, pages={28--35}, doi={10.1093/biomet/34.1-2.28}}