Co to jest dominanta?
Dominanta (inaczej moda albo modalna; ang. mode; w polskich podręcznikach oznaczana Mo lub D) to wartość, która w zbiorze danych występuje najczęściej. Razem ze średnią i medianą należy do miar tendencji centralnej – podstawowych narzędzi statystyki opisowej – ale odpowiada na inne pytanie. Nie mówi, gdzie leży środek wyników, tylko jaka odpowiedź padała najczęściej.
To jedyna miara tendencji centralnej, którą da się wyznaczyć dla danych na skali nominalnej, takich jak kierunek studiów, forma terapii czy odpowiedź wybrana z kafeterii (Manikandan, 2011). Przy danych porządkowych uzupełnia medianę. Przy ilościowych służy głównie do opisu kształtu rozkładu, bo wskazuje jego szczyt. Manikandan (2011) zauważa, że jako samodzielne podsumowanie danych dominanta pojawia się rzadko, najczęściej przy opisie rozkładów z dwoma szczytami.
Jak wyznaczyć dominantę?
Policz, ile razy występuje każda wartość, i wybierz tę o największej liczebności. Możliwe są trzy sytuacje (Manikandan, 2011):
- jedna wartość jest najczęstsza – rozkład jest jednomodalny i ma jedną dominantę;
- kilka wartości ma tę samą, największą liczebność – rozkład ma kilka dominant i trzeba podać wszystkie;
- każda wartość występuje tylko raz – dominanty nie ma. Zdarza się to w małych próbach i przy pomiarach z dużą dokładnością.
O rozkładzie dwumodalnym mówi się też wtedy, gdy ma on dwa wyraźne szczyty różnej wysokości: wyższy to dominanta główna, a niższy – drugorzędna (Manikandan, 2011). W rozkładzie normalnym dominanta, mediana i średnia się pokrywają. W rozkładzie skośnym dominanta leży w miejscu największego skupienia wyników, a mediana – między dominantą a średnią (Manikandan, 2011).
Dominanta w szeregu rozdzielczym
Gdy dane są pogrupowane w przedziały, najpierw wskazuje się przedział modalny (o największej liczebności), a dominantę szacuje się wzorem interpolacyjnym:
gdzie x0 to dolna granica przedziału modalnego, h – jego szerokość, nm – liczebność tego przedziału, a nm−1 i nm+1 – liczebności przedziałów sąsiednich. W przykładzie z rysunku 2 (czas snu 80 osób w przedziałach 1-godzinnych) najliczniejszy jest przedział [7, 8) z 30 osobami, a sąsiednie mają 14 i 7 osób:
Przykład: najczęstsza odpowiedź w ankiecie
Dwustu studentów odpowiedziało na pytanie „Z czego najczęściej korzystasz, przygotowując się do egzaminu?” (jedna odpowiedź; dane symulowane).
| Odpowiedź | n | % |
|---|---|---|
| Notatki z zajęć (dominanta) | 76 | 38.0 |
| Materiały wideo | 47 | 23.5 |
| Czat AI | 38 | 19.0 |
| Podręcznik | 30 | 15.0 |
| Nauka w grupie | 9 | 4.5 |
Dominantą są notatki z zajęć. Zawsze podawaj ją razem z odsetkiem: sama nazwa kategorii nie mówi, czy wybrało ją 38% osób, czy 90%.
Ten przykład pokazuje też, czym dominanta różni się od średniej. W pliku danych kategorie są zwykle zakodowane liczbami 1–5. Przy kolejności z ankiety średnia kodów wynosi 2.37, a przy kodach nadanych alfabetycznie (tak działa automatyczne rekodowanie) – 3.06. Mediana kodów zmienia się z 2 na 4. Dominanta za każdym razem wskazuje tę samą kategorię: notatki z zajęć, raz z kodem 1, raz z kodem 4. Tylko dominanta nie zależy od tego, jakie liczby przypiszesz kategoriom, dlatego to ona – razem z rozkładem odsetków – opisuje dane nominalne. Rozkład odpowiedzi najlepiej pokazać na wykresie słupkowym.
Rozkład dwumodalny: gdy średnia i mediana wprowadzają w błąd
Dominanta jest najbardziej potrzebna wtedy, gdy rozkład ma dwa szczyty. W kolejnym przykładzie 240 studentów oceniło na skali od 0 do 10 pomysł obowiązkowej obecności na wykładach.
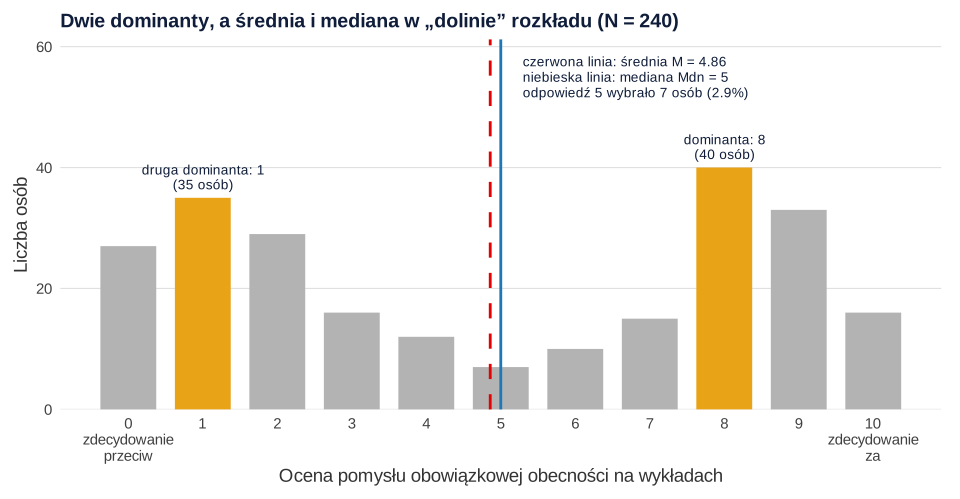
Średnia wynosi M = 4.86 (SD = 3.50), a mediana Mdn = 5. Oba wyniki sugerują umiarkowane, „środkowe” nastawienie. Tymczasem odpowiedź 5 wybrało tylko 7 osób (2.9%), a odpowiedzi od 4 do 6 – 12.1%. Aż 37.9% osób zaznaczyło 0–2, a 37.1% – 8–10. Rozkład ma dwie dominanty: główną 8 (40 osób, 16.7%) i drugorzędną 1 (35 osób, 14.6%). Grupa jest spolaryzowana, a „przeciętny student” z wynikiem 5 prawie nie istnieje.
Skośność tego rozkładu wynosi 0.00 – jest on symetryczny, a mimo to bardzo daleki od normalnego. Kurtoza jest silnie ujemna (−1.60), jak w rozkładach, w których wyniki skupiają się w dwóch miejscach, a nie wokół środka. Von Hippel (2005) pokazuje, że w rozkładach wielomodalnych zawodzi podręcznikowa reguła wiążąca położenie średniej i mediany ze skośnością. Nie jest to też ciekawostka: Micceri (1989) wśród cech, którymi 440 dużych rozkładów wyników testów i miar psychometrycznych odbiegało od normalności, wymienia właśnie wielomodalność. Dlatego przed podaniem M (SD) zawsze obejrzyj rozkład – na histogramie albo, przy kilku możliwych odpowiedziach, na wykresie słupkowym. Gdy widzisz dwa szczyty, podaj obie dominanty z odsetkami i sprawdź, czy nie odpowiadają one podgrupom, np. rocznikom albo kierunkom, które warto opisać osobno.
Dominanta dla danych ciągłych: szczyt krzywej gęstości
Przy danych ciągłych, np. czasie mierzonym z dokładnością do 0.1 h, dominanta surowych wartości jest przypadkowa. W przykładzie 80 osób podało czas snu przed egzaminem (43 różne wartości). Najczęstszy wynik, 4.9 h, wystąpił 5 razy, ale cztery inne wartości (7.1, 7.5, 7.6 i 7.9 h) – po 4 razy. Wystarczy jedna osoba więcej z wynikiem 7.9 h, by pojawiła się druga „dominanta”, odległa od pierwszej o 3 godziny.
Rozsądniej szukać szczytu rozkładu: przedziału modalnego (wyżej: 7.41 h) albo maksimum krzywej gęstości. Silverman (1981) zaproponował badanie liczby dominant w populacji właśnie za pomocą jądrowego estymatora gęstości. Rysunek 2 pokazuje jednak, że liczba i położenie szczytów zależą od szerokości pasma, czyli stopnia wygładzenia.
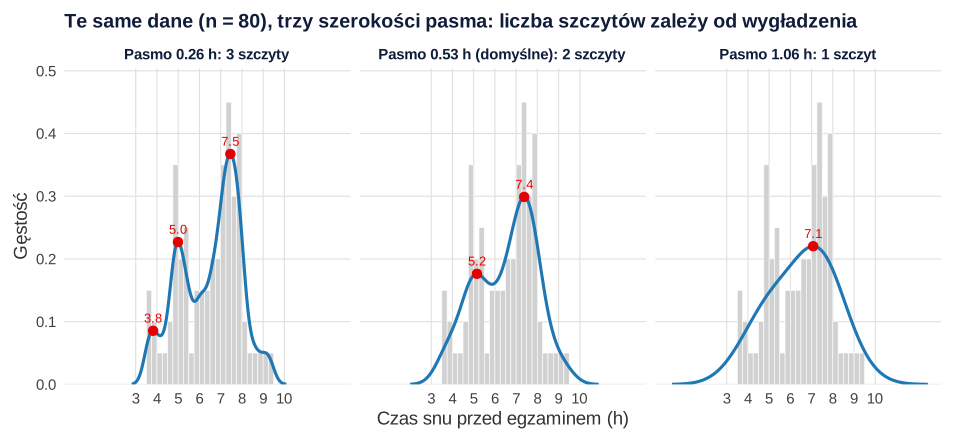
Przy wąskim paśmie (0.26 h) krzywa ma trzy szczyty, przy domyślnym (0.53 h) dwa – przy 5.2 i 7.4 h – a przy szerokim (1.06 h) jeden, przy 7.1 h. Do oceny dwumodalności stosuje się też wskaźniki. Współczynnik dwumodalności BC łączy skośność G1 i kurtozę G2:
Wartości powyżej 5/9 ≈ .556 sugerują dwumodalność, ale BC rośnie także przy silnej skośności, więc skośny rozkład z jednym szczytem może przekroczyć próg. Pfister i in. (2013) radzą dlatego łączyć BC z testem dip Hartigana i oglądać rozkład. Freeman i Dale (2013) porównali w symulacjach BC, statystykę dip i różnicę AIC. Wykrycie dwumodalności zależało bardziej od odległości między podgrupami niż od ich proporcji, a skośność zawyżała wskazania miar. Oceny z rysunku 1 dają BC = .698, a czas snu – BC = .471, czyli poniżej progu, choć domyślna krzywa gęstości ma dwa szczyty. Wniosek: dominantę danych ciągłych traktuj opisowo i zawsze podawaj, jak ją wyznaczono (szerokość przedziału albo pasma).
Jak opisać dominantę w pracy (APA)
Średnią w tekście zapisuje się jako M, a medianę jako Mdn; dominantę najlepiej opisać słowami. Przy danych nominalnych podaj kategorię z liczebnością i odsetkiem, a przy rozkładzie dwumodalnym – obie dominanty i powód, dla którego średnia nie wystarcza:
Opis zmiennych nominalnych w charakterystyce próby omawiamy w poradniku jak opisać charakterystykę próby, a całą analizę odpowiedzi z kwestionariusza – w poradniku o analizie ankiety.
Przykład w R
W R nie ma wbudowanej funkcji do dominanty, a funkcja mode() zwraca typ danych. Kod definiuje własną funkcję, która przy remisie zwraca wszystkie dominanty, i odtwarza liczby z tej strony. W SPSS dominantę zaznaczysz w menu Analiza → Opis statystyczny → Częstości → Statystyki → Dominanta (Analyze → Descriptive Statistics → Frequencies → Statistics → Mode). Gdy dominant jest kilka, SPSS pokazuje tylko najmniejszą z adnotacją Multiple modes exist, więc zawsze sprawdź tabelę częstości.
Dominanta, rozkład dwumodalny i szczyty gęstości
R
library(psych)   # skew(), kurtosi()

# dominanta = wartość (kategoria) o największej liczebności; przy remisie zwraca wszystkie
dominanta <- function(x) { t <- table(x); names(t)[t == max(t)] }

# 1. Pytanie nominalne: źródło przygotowania do egzaminu (N = 200)
set.seed(11)
zrodlo <- sample(c("Notatki z zajęć", "Materiały wideo", "Czat AI", "Podręcznik", "Nauka w grupie"),
                 200, replace = TRUE, prob = c(.31, .24, .20, .16, .09))
sort(table(zrodlo), decreasing = TRUE)
dominanta(zrodlo)
mode(zrodlo)                       # uwaga: to typ danych w R, a nie dominanta!

# 2. Ocena 0–10 z dwoma szczytami (N = 240)
set.seed(12)
grupa <- sample(c("przeciw", "za", "neutralni"), 240, replace = TRUE, prob = c(.46, .44, .10))
ocena <- ifelse(grupa == "przeciw", rnorm(240, 1.6, 1.3),
                ifelse(grupa == "za", rnorm(240, 8.4, 1.3), rnorm(240, 5, 1.2)))
ocena <- pmin(pmax(round(ocena), 0), 10)
table(ocena)
c(M = round(mean(ocena), 2), Mdn = median(ocena))
n <- length(ocena); G1 <- skew(ocena, type = 2); G2 <- kurtosi(ocena, type = 2)
round((G1^2 + 1) / (G2 + 3 * (n - 1)^2 / ((n - 2) * (n - 3))), 3)   # współczynnik BC

# 3. Dane ciągłe: czas snu przed egzaminem (h), n = 80
set.seed(13)
g <- rbinom(80, 1, 0.4)
sen <- round(ifelse(g == 1, rnorm(80, 5.0, 0.7), rnorm(80, 7.3, 0.7)), 1)
dominanta(sen)                                         # „dominanta” surowych wartości
hist(sen, breaks = 3:10, right = FALSE, plot = FALSE)$counts   # przedziały 1-godzinne
szczyty <- function(x, adjust = 1) {                   # szczyty krzywej gęstości
  d <- density(x, adjust = adjust)
  round(d$x[which(diff(sign(diff(d$y))) == -2) + 1], 2)
}
sapply(c(0.5, 1, 2), \(a) paste(szczyty(sen, a), collapse = ", "))
Wynik w R
zrodlo
Notatki z zajęć Materiały wideo         Czat AI      Podręcznik  Nauka w grupie
             76              47              38              30               9
[1] "Notatki z zajęć"
[1] "character"
ocena
 0  1  2  3  4  5  6  7  8  9 10
27 35 29 16 12  7 10 15 40 33 16
   M  Mdn
4.86 5.00
[1] 0.698
[1] "4.9"
[1]  4 12 11 14 30  7  2
[1] "3.82, 4.99, 7.46" "5.16, 7.38"       "7.07"
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; skośność i kurtozę policzono w pakiecie psych, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Funkcja
mode()w R – zwraca typ danych („numeric”, „character”), a nie dominantę. Użyjtable()albo własnej funkcji. - Jedna dominanta z programu przy kilku równie częstych wartościach – SPSS pokazuje najmniejszą z nich, a funkcja MODE.SNGL w Excelu jedną; wszystkie zwraca MODE.MULT.
- Dominanta surowych wartości ciągłych – zależy od przypadku; użyj przedziału modalnego albo szczytu krzywej gęstości i podaj szerokość przedziału lub pasma.
- Sam kod liczbowy zamiast kategorii – zapis „Mo = 4” nic nie mówi bez etykiety i odsetka.
- Opis spolaryzowanego rozkładu samą średnią – przy dwóch szczytach M i Mdn mogą wskazywać odpowiedź, której prawie nikt nie wybrał.
- Traktowanie dwóch szczytów jako dowodu na dwie grupy – dwumodalność bywa artefaktem wygładzenia albo skośności (Pfister i in., 2013); sprawdź kilka szerokości pasma i podgrupy wyróżnione teoretycznie.
Najczęstsze pytania
Co to jest dominanta w statystyce?
Dominanta (moda, modalna) to wartość, która występuje w danych najczęściej. Dla danych nominalnych, np. kierunku studiów, jest to najliczniejsza kategoria – i jedyna miara tendencji centralnej, jaką można dla nich podać. W rozkładach ilościowych dominanta wskazuje szczyt rozkładu.
Jak obliczyć dominantę?
Policz, ile razy występuje każda wartość, i wybierz tę o największej liczebności. W przykładzie z tej strony najczęściej wybierano notatki z zajęć (76 z 200 osób, 38.0%). Dla danych pogrupowanych w przedziały wskaż przedział modalny i użyj wzoru interpolacyjnego. W R zacznij od table(x) – funkcja mode() zwraca typ danych, a nie dominantę.
Czy może być kilka dominant?
Tak. Jeśli dwie lub więcej wartości mają tę samą, największą liczebność, rozkład jest dwu- albo wielomodalny i trzeba podać wszystkie dominanty. Uważaj na programy: SPSS przy kilku dominantach pokazuje najmniejszą z nich, a funkcja MODE.SNGL w Excelu – tylko jedną. Jeśli każda wartość występuje raz, dominanty nie ma.
Czym różni się dominanta od mediany i średniej?
Dominanta to wartość najczęstsza, mediana – wynik środkowy po uporządkowaniu, a średnia – suma wyników podzielona przez ich liczbę. W rozkładzie normalnym wszystkie trzy są równe. W rozkładzie skośnym dominanta leży w szczycie rozkładu, a mediana między dominantą a średnią. Przy rozkładzie dwumodalnym średnia i mediana mogą wypaść tam, gdzie prawie nie ma wyników.
Kiedy podawać dominantę?
Przy zmiennych nominalnych (zawsze z odsetkiem), przy pytaniach ankietowych, w których liczy się najczęstsza odpowiedź, oraz przy rozkładach z dwoma szczytami, gdy średnia i mediana opisują rzadką odpowiedź. Przy zmiennych ilościowych o rozkładzie z jednym szczytem zwykle wystarczy średnia albo mediana z miarą rozproszenia.
Jak obliczyć dominantę w SPSS?
Wybierz Analiza → Opis statystyczny → Częstości, przenieś zmienną, kliknij Statystyki i zaznacz Dominanta. Zostaw włączone tabele częstości: jeśli dominant jest kilka, SPSS pokaże tylko najmniejszą z adnotacją Multiple modes exist, a pozostałe znajdziesz w tabeli.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza ankiety do pracy licencjackiej i magisterskiej
Analiza ankiety do pracy dyplomowej: przygotowanie bazy, kodowanie pytań, skale, testy, modele i raport wyników do licencjatu lub magisterki.
Czytaj →PoradnikJak opisać charakterystykę próby badawczej?
Co uwzględnić w tekście i tabeli, jak dobrać miary opisowe oraz jak nie ukryć problemów z selekcją i brakami danych.
Czytaj →PoradnikStatystyka do pracy licencjackiej: analiza krok po kroku
Jak zaplanować analizę statystyczną do pracy licencjackiej, przygotować ankietę i bazę danych oraz otrzymać wyniki, które da się obronić.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Freeman, J. B., & Dale, R. (2013). Assessing bimodality to detect the presence of a dual cognitive process. Behavior Research Methods, 45(1), 83–97. https://doi.org/10.3758/s13428-012-0225-x ● Otwarty dostęp
- Manikandan, S. (2011). Measures of central tendency: Median and mode. Journal of Pharmacology and Pharmacotherapeutics, 2(3), 214–215. https://doi.org/10.4103/0976-500X.83300 ● Otwarty dostęp: pełny tekst
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Pfister, R., Schwarz, K. A., Janczyk, M., Dale, R., & Freeman, J. B. (2013). Good things peak in pairs: A note on the bimodality coefficient. Frontiers in Psychology, 4, Article 700. https://doi.org/10.3389/fpsyg.2013.00700 ● Otwarty dostęp
- Silverman, B. W. (1981). Using kernel density estimates to investigate multimodality. Journal of the Royal Statistical Society: Series B (Methodological), 43(1), 97–99. https://doi.org/10.1111/j.2517-6161.1981.tb01155.x
- von Hippel, P. T. (2005). Mean, median, and skew: Correcting a textbook rule. Journal of Statistics Education, 13(2). https://doi.org/10.1080/10691898.2005.11910556 ● Otwarty dostęp
Cytowania BibTeX
@article{freeman2013assessing, author={Freeman, Jonathan B. and Dale, Rick}, title={{Assessing bimodality to detect the presence of a dual cognitive process}}, journal={Behavior Research Methods}, year={2013}, volume={45}, number={1}, pages={83--97}, doi={10.3758/s13428-012-0225-x}}@article{manikandan2011median, author={Manikandan, S.}, title={{Measures of central tendency: Median and mode}}, journal={Journal of Pharmacology and Pharmacotherapeutics}, year={2011}, volume={2}, number={3}, pages={214--215}, doi={10.4103/0976-500x.83300}}@article{micceri1989unicorn, author={Micceri, Theodore}, title={{The unicorn, the normal curve, and other improbable creatures}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={156--166}, doi={10.1037/0033-2909.105.1.156}}@article{pfister2013good, author={Pfister, Roland and Schwarz, Katharina A. and Janczyk, Markus and Dale, Rick and Freeman, Jonathan B.}, title={{Good things peak in pairs: A note on the bimodality coefficient}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={700}, doi={10.3389/fpsyg.2013.00700}}@article{silverman1981using, author={Silverman, Bernard W.}, title={{Using kernel density estimates to investigate multimodality}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1981}, volume={43}, number={1}, pages={97--99}, doi={10.1111/j.2517-6161.1981.tb01155.x}}@article{vonhippel2005mean, author={von Hippel, Paul T.}, title={{Mean, median, and skew: Correcting a textbook rule}}, journal={Journal of Statistics Education}, year={2005}, volume={13}, number={2}, doi={10.1080/10691898.2005.11910556}}